Next-Concept Modeling tạo văn bản nhanh gấp 31 lần
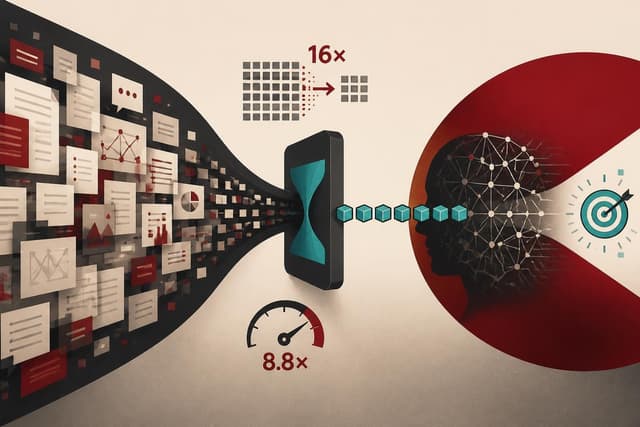
Nhóm nghiên cứu tại Stanford công bố phương pháp Next-Concept Modeling (NCM) trên arXiv, kết hợp VQ-VAE đa tỉ lệ và transformer để sinh văn bản theo hai giai đoạn thô đến mịn. Cách tiếp cận này đạt chất lượng tương đương các mô hình diffusion ngôn ngữ mạnh nhất nhưng nhanh hơn 10 đến 31 lần tùy bộ dữ liệu.
Các mô hình diffusion ngôn ngữ (DLM) vốn được xem là hướng đi hứa hẹn để tăng tốc sinh văn bản nhờ khả năng lấy mẫu song song. Tuy nhiên, chất lượng của chúng giảm nhanh khi số bước lấy mẫu ít đi, mỗi bước lại phải xử lý toàn bộ chuỗi và cần rất nhiều lượt duyệt dữ liệu để đạt chất lượng tốt. Một nhóm tác giả vừa công bố trên arXiv phương pháp Next-Concept Modeling (NCM) nhằm khắc phục những hạn chế này.
Bài báo mang mã arXiv:2610.14162, thuộc lĩnh vực Xử lý ngôn ngữ tính toán (cs.CL), đồng thời liên quan đến Trí tuệ nhân tạo (cs.AI) và Học máy (cs.LG), được gửi lên ngày 9/10/2026. Nhóm tác giả gồm Hermann Kumbong, Ishan S. Khare, Iddah Mlauzi, Andrew Woen, Charles Ding, E. Kelly Buchanan, Simran Arora, Azalia Mirhoseini và Christopher Ré.
Hai giai đoạn, từ thô đến mịn
NCM là một khung làm việc hai giai đoạn theo hướng thô đến mịn (coarse-to-fine):
- Một VQ-VAE dư lượng đa tỉ lệ (multiscale residual VQ-VAE) mã hóa văn bản thành một hệ thống phân cấp các mã rời rạc (discrete codes).
- Một transformer sinh ra từng tầng một, dự đoán song song toàn bộ các mã trong cùng một tầng.
Cách chia tầng này cho phép mô hình tạo ra bản phác thảo thô trước, rồi bổ sung chi tiết ở các tầng sau, thay vì phải dự đoán từng token tuần tự như mô hình tự hồi quy (autoregressive) hay phải duyệt lại toàn bộ chuỗi ở mọi bước như diffusion.
Kết quả thực nghiệm
Ở cùng quy mô tham số, nhóm tác giả báo cáo các kết quả sau:
- Trên LM1B, NCM đạt perplexity sinh văn bản (generative perplexity) tốt hơn baseline DLM mạnh nhất, đồng thời chạy nhanh hơn 21 lần.
- Trên OpenWebText, NCM cạnh tranh với DLM mạnh nhất và chạy nhanh hơn 10 lần.
- Trên XSum, NCM đạt chỉ số ROUGE-L ngang với DLM mạnh nhất và nhanh hơn 31 lần.
- Trên bài toán suy luận Sudoku, NCM vượt qua cả baseline tự hồi quy và diffusion ở mọi mức độ khó, với số lần đánh giá hàm (function evaluations) ít hơn.
Việc giảm mạnh số lần đánh giá hàm có ý nghĩa quan trọng khi suy luận (inference) đang trở thành phần chi phí chủ đạo trong vận hành mô hình ngôn ngữ.
Góc nhìn
Với các kỹ sư và doanh nghiệp đang vận hành mô hình ngôn ngữ, con số nhanh hơn 10 đến 31 lần ở chất lượng tương đương là tín hiệu đáng chú ý về chi phí suy luận. Nếu hướng tiếp cận này được hiện thực hóa hiệu quả trong mã nguồn mở, nó có thể mở ra lựa chọn mới cho các tác vụ cần tốc độ như tóm tắt hàng loạt hay sinh văn bản theo lô.
Tuy vậy, cần lưu ý rằng kết quả trên mới được công bố trong phạm vi bài báo nghiên cứu, chưa có thông tin về khả năng triển khai thực tế hay mức tiêu thụ bộ nhớ. Các đội kỹ thuật nên theo dõi phần mã nguồn và đánh giá độc lập trước khi tính đến việc thay thế kiến trúc tự hồi quy hiện có.
Nguồn: arxiv.org · Quy trình biên tập