NVIDIA chính thức mang lập trình GPU native lên Rust
NVIDIA công bố hai dự án cuda-oxide và cutile-rs, cho phép viết trực tiếp nhân GPU (kernel) bằng Rust và biên dịch native sang PTX. Đây là bước tiến quan trọng khi phần lớn hạ tầng hệ thống AI đang chuyển dịch sang Rust để tận dụng khả năng phát hiện lỗi tại thời điểm biên dịch mà vẫn giữ hiệu năng cao.
NVIDIA vừa công bố đang đẩy mạnh việc lập trình GPU trực tiếp bằng Rust. Trong khi CUDA C++ và CUDA Python đã là những bộ công cụ trưởng thành, đạt chuẩn doanh nghiệp, hãng này sẽ phát triển và hoàn thiện CUDA Rust từ nay đến năm 2027 và xa hơn nữa.
Vì sao lại là Rust?
Tầng hệ thống của AI bao gồm công cụ suy luận (inference engine), hạ tầng phục vụ (serving infrastructure), trình điều khiển (driver) và môi trường chạy của agent. Tất cả những thành phần này thay đổi liên tục khi mô hình và kỹ thuật mới xuất hiện. Ngày càng nhiều phần trong đó được viết bằng Rust — ngôn ngữ giúp bắt được cả một lớp lỗi ngay ở thời điểm biên dịch mà không phải đánh đổi hiệu năng.
NVIDIA cũng đang tham gia vào xu hướng này:
- Trình điều khiển Nova Linux được viết bằng Rust
- NVIDIA Dynamo xây dựng trên lõi Rust
- NVTX đã có Rust binding
Tuy nhiên, nhân GPU (kernel) vẫn là ngoại lệ. Bạn có thể khởi chạy kernel từ Rust, nhưng bản thân kernel thường phải viết bằng ngôn ngữ khác. NVIDIA CUDA Rust ra đời để lấp khoảng trống đó: kernel GPU có thể được viết bằng Rust và biên dịch native sang PTX, thay vì chỉ là lớp bọc quanh mã nguồn từ nơi khác.
Hai hướng tiếp cận: SIMT và Tile
NVIDIA cung cấp hai hướng sử dụng Rust, tương ứng với hai hướng của chính CUDA:
- SIMT: Mô hình mà bạn đã quen thuộc khi viết CUDA C++ hoặc numba-cuda. Bạn mô tả một luồng (thread) làm gì, rồi khởi chạy hàng nghìn luồng như vậy.
- Tile: Mô hình lập trình mới hơn, cũng có mặt trong C++ và Python. Bạn mô tả một khối dữ liệu (tile) làm gì, và trình biên dịch Tile IR sẽ lo phần còn lại.
Lời khuyên từ NVIDIA: khi chọn nền tảng để xây dựng, hãy bắt đầu với Tile trước. Trình biên dịch sẽ quyết định cách ánh xạ tile lên từng kiến trúc, nhờ đó mã nguồn của bạn không bị gắn chặt với lựa chọn kiến trúc cụ thể. Chỉ chuyển sang SIMT khi bạn cần kiểm soát chi tiết hoặc muốn tự quản lý bộ nhớ và luồng.
Việc chọn ngôn ngữ là câu hỏi tách biệt với việc chọn mô hình. Hãy dùng giao diện CUDA phù hợp nhất với hệ thống bạn đang có. Hai dự án dưới đây dành cho trường hợp hệ thống đó là Rust.
Hướng SIMT: cuda-oxide
cuda-oxide là một backend sinh mã tùy chỉnh cho rustc. Nó chặn quá trình biên dịch, đưa các hàm #[kernel] đi qua Rust MIR, framework Pliron IR của cộng đồng, rồi qua LLVM IR để hạ xuống PTX, đồng thời chuyển mọi thứ khác cho backend tiêu chuẩn.
Yêu cầu hệ thống gồm: Linux, GPU có compute capability 8.0 trở lên, CUDA toolkit 12.x trở lên, clang kèm header libclang, và toolchain nightly được ghim phiên bản. Lệnh cargo oxide doctor sẽ kiểm tra toàn bộ các điều kiện này.
Cài đặt rồi tạo dự án mẫu:
cargo +nightly-2026-04-03 install --git https://github.com/NVlabs/cuda-oxide.git cargo-oxide
cargo oxide new vecadd_demo
cd vecadd_demo
cargo oxide doctor
cargo oxide run
Lần chạy đầu tiên sẽ mất khá lâu vì phải build backend sinh mã; các lần sau dùng lại cache.
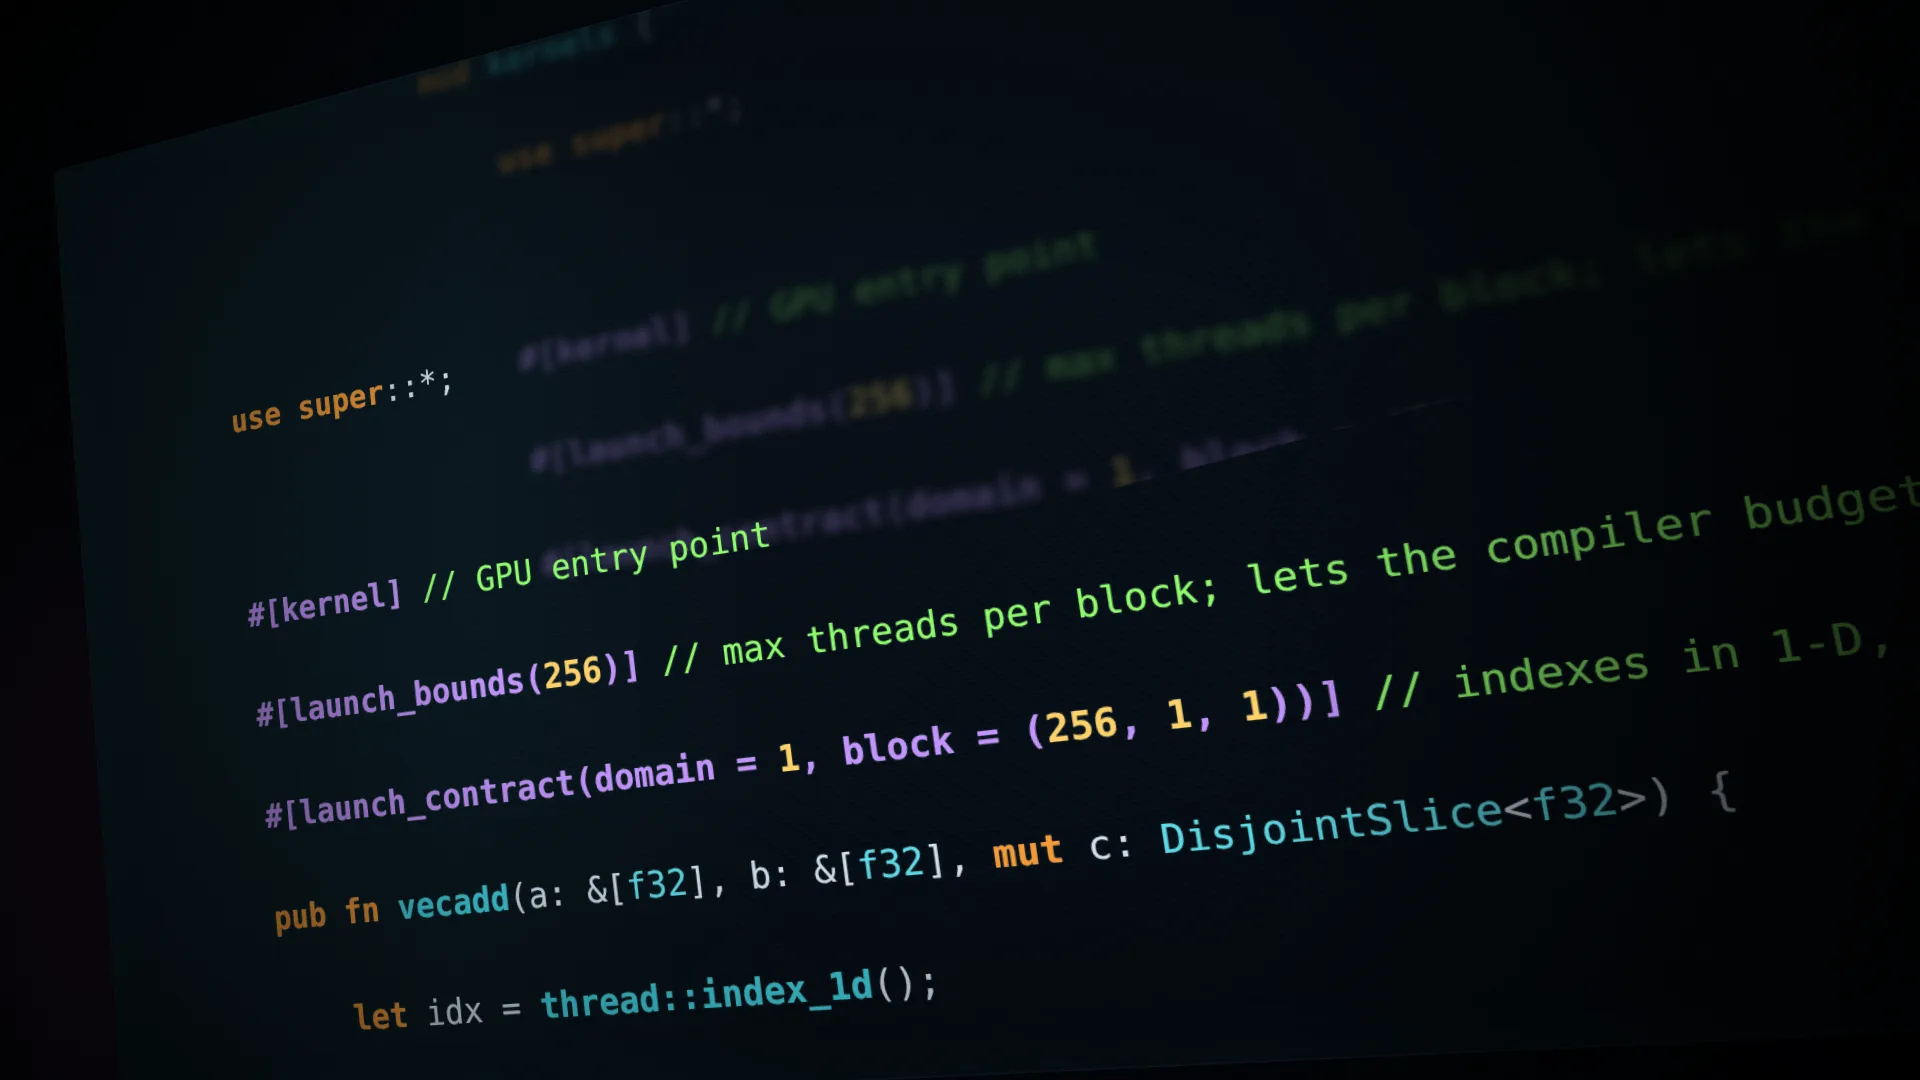
Điểm đáng chú ý trong chương trình mẫu là chữ ký của kernel, bởi nó mang toàn bộ lập luận về an toàn bộ nhớ:
avàblà slice chia sẻ thông thường, mọi luồng đều đọc đượcclàDisjointSlice— kiểu dữ liệu trao cho mỗi luồng quyền truy cập độc quyền vào đúng phần tử của nó
Kiểu DisjointSlice tồn tại vì &mut [f32] không phù hợp: mọi luồng sẽ cần cùng một &mut, điều mà Rust từ chối một cách chính xác. DisjointSlice chia nhỏ borrow có thể thay đổi đó thành từng phần riêng cho mỗi luồng.
Ngoài ra, việc khởi chạy được kiểm tra thay vì tin tưởng. Thuộc tính #[launch_contract] khai báo rằng kernel này đánh chỉ số theo một chiều với khối 256 luồng. Hàm prepare_vecadd xác thực cấu hình khởi chạy của bạn dựa trên khai báo đó và giới hạn thực tế của thiết bị, rồi trả về một bằng chứng mà phương thức khởi chạy an toàn yêu cầu.
Những kernel không có contract chỉ phơi ra các phương thức khởi chạy unsafe thô, bởi một LaunchConfig trơ trọi không nói lên điều gì về kernel mà nó đang chạy.
Hướng Tile: cutile-rs
cutile-rs hoạt động ở tầng cao hơn một bậc. Bạn thực hiện tính toán trên các tile thay vì trên từng số vô hướng. Mỗi khối tile chạy thân kernel một lần như một luồng logic duy nhất trên một tensor con, và trình biên dịch quyết định bao nhiêu luồng GPU thực sự đứng sau.
Macro #[cutile::module] nhúng AST của kernel vào binary host và JIT-biên dịch nó thông qua CUDA Tile IR khi kernel được gọi lần đầu.
Yêu cầu nhẹ hơn hướng SIMT: GPU có compute capability 8.0 trở lên, CUDA 13.3, Rust stable 1.89 trở lên, và Linux — không cần toolchain nightly, không cần LLVM riêng.
Vì cutile đã được publish, không cần clone về:
cargo new vecadd_demo
cd vecadd_demo
cargo add cutile
Điểm thú vị nhất ở phía host là dòng .partition([128]), nó làm ba việc cùng lúc:
- Hiện thực hóa tính độc quyền: mỗi tile sở hữu khối 128 phần tử của riêng nó, không tile nào khác chạm được vào
- Cố định hình học khởi chạy: 1.024 chia cho 128 cho ra lưới 8 tile
- Cung cấp tham số B (độ rộng tile), vốn không bao giờ được viết tại điểm gọi vì bộ khởi chạy đọc độ rộng tile từ partition
Đó cũng là lý do vì sao một đầu ra &mut bắt buộc phải được partition trước khi truyền vào.
Và hãy để ý điều mà lệnh khởi chạy trả về: hàm add bạn gọi trên host là một bộ khởi chạy do macro sinh ra, không phải hàm thiết bị ở trên. Nó nhận quyền sở hữu cả ba tensor và trả chúng lại dưới dạng tuple khi GPU xong việc. Không có gì chạy cho đến khi .sync_on(&stream) được gọi — mọi thứ trước đó chỉ là mô tả lười (lazy), được ghi lại chứ không được gửi đi. Cả chương trình là một chuỗi với duy nhất một điểm đồng bộ.
Trình biên dịch bắt được gì?
Cả hai kernel đưa ra cùng một khẳng định về bộ nhớ: đầu vào chia sẻ, đầu ra chỉ thuộc về một người ghi duy nhất. Chúng chỉ khác nhau ở tầng mà khẳng định đó được đưa ra.
Điều này quan trọng vì hàng nghìn luồng cùng chạm vào các buffer mà không có thứ tự đảm bảo. Khi hai luồng truy cập cùng một địa chỉ và một trong đó đang ghi, thứ tự sẽ quyết định kết quả. Những lỗi kiểu này hiếm khi tái hiện theo yêu cầu, và chúng vượt qua được kiểm thử trước khi thất bại trong môi trường sản xuất.
Với hướng SIMT, việc truyền buffer đầu ra của kernel như một trong các đầu vào của chính nó sẽ không biên dịch được:
error[E0502]: cannot borrow `c_dev` as mutable because it is also borrowed as immutable
Tương tự, lỗi aliasing ở phía Tile cũng không biên dịch được:
error[E0382]: use of moved value: `z`
Cả hai ví dụ đều bắt được lỗi aliasing kinh điển ngay ở thời điểm biên dịch, nhưng vạch ranh giới ở những chỗ khác nhau. cuda-oxide kiểm tra từng lệnh gọi khởi chạy. Còn cutile-rs để quyền sở hữu đi theo các tensor xuyên qua ranh giới khởi chạy — đây là khẳng định mạnh hơn trong hai cách.
Tile không cho bạn bộ nhớ chia sẻ hay chỉ số luồng để làm sai, bởi trình biên dịch sở hữu cả hai. Một khối tile là một luồng logic duy nhất, nên không có luồng nào để bạn gây tranh chấp. Đó là điều khiến nó an toàn theo thiết kế — và cũng chính là thứ bạn đánh đổi. SIMT giữ lại quyền kiểm soát đó, và hiện tại bộ nhớ chia sẻ ở hướng này vẫn cần unsafe. Bộ nhớ chia sẻ là nền tảng của các kernel SIMT tốc độ cao, nên việc làm cho con đường đó an toàn đang là công việc được tích cực triển khai.
Hiện trạng các dự án
Cả hai dự án đều ở giai đoạn đầu và chưa sẵn sàng cho môi trường sản xuất:
- cuda-oxide đang ở giai đoạn alpha sớm
- cutile-rs tiến xa hơn, đã publish trên crates.io và đang được dùng ngoài NVIDIA trong Grout (inference engine của HuggingFace) và mistral.rs
Độ phủ còn chưa đầy đủ và các API sẽ còn thay đổi. Rust trên GPU không phải điều mới — đã có những công trình tốt trong lĩnh vực này ra đời trước và vẫn tiếp tục song hành, như Rust-GPU, rust-cuda, CubeCL. Điều mới là năng lực kỹ thuật mà NVIDIA đang đầu tư phía sau, cùng một định hướng rõ ràng về nơi nó sẽ đi tới.
Điều bạn có thể làm ngay hôm nay
- Chạy ví dụ SIMT: dùng
cargo oxide newrồicargo oxide runtrong cuda-oxide - Chạy ví dụ Tile: clone cutile-rs rồi chạy
cargo run -p cutile-examples --example hello_world - Đọc tài liệu: sách cuda-oxide và tài liệu cuTile Rust
- Đọc bài báo khoa học: "Fearless Concurrency on the GPU"
- Báo lỗi: cho nhóm phát triển biết điều gì hỏng và còn thiếu gì
- Tham gia thảo luận: GitHub Discussions trên cả hai repo, hoặc Discord của cuda-oxide
- Dự hội thảo: Melih Elibol sẽ trình bày "Fearless Concurrency on the GPU" tại RustConf 2026, từ 8 đến 11 tháng 9 tại Montréal
Đây là giai đoạn đầu, mã nguồn mở, và những gì bạn xây dựng lúc này sẽ định hình nên bước tiếp theo.
Lời kết dành cho cộng đồng Rust
NVIDIA bày tỏ mong muốn đồng hành cùng cộng đồng Rust trong việc nâng tầm lập trình GPU native bằng Rust. Các dự án như rust-cuda, rust-gpu và cudarc đã tiên phong trong việc kết hợp GPU với Rust, và những người đứng sau chúng — bao gồm đội ngũ tại VectorWare — vẫn tiếp tục định hình cách NVIDIA suy nghĩ về công việc của chính mình.
Đối với lập trình viên Việt Nam, đây là thời điểm đáng để quan tâm: Rust đang trở thành kỹ năng ngày càng giá trị trong các dự án AI hạ tầng, và việc NVIDIA chính thức đầu tư vào CUDA Rust mở ra cơ hội học hỏi, đóng góp vào các dự án mã nguồn mở còn non trẻ này — nơi đóng góp của bạn lúc này có sức ảnh hưởng lớn hơn nhiều so với khi hệ sinh thái đã chín muồi.