
NVIDIA công bố Auto Ontology, lớp ngữ cảnh dữ liệu mã nguồn mở cho các tác tử AI
Auto Ontology của NVIDIA tạo lớp ngữ cảnh từ siêu dữ liệu doanh nghiệp, giúp tác tử AI hiểu ý nghĩa và nguồn gốc của dữ liệu trước khi truy vấn. Dự án hỗ trợ nhiều cách tích hợp và triển khai, nhưng thông tin kết nối cơ sở dữ liệu được lưu dưới dạng văn bản thuần nếu không cấu hình Vault.
NVIDIA giới thiệu Auto Ontology, thư viện mã nguồn mở giúp tạo lớp ngữ cảnh cho các tác tử AI khi làm việc với dữ liệu doanh nghiệp. Công cụ kết nối siêu dữ liệu từ nhiều hệ thống, thống nhất cách diễn giải các chỉ số và cung cấp thông tin về nguồn gốc dữ liệu, nhằm giảm nguy cơ tác tử đưa ra câu trả lời nhanh nhưng sai.
Auto Ontology được phát hành theo giấy phép Apache 2.0. Dự án hiện chưa tiếp nhận đóng góp từ bên ngoài nhóm duy trì.
Tạo ngữ cảnh để tác tử hiểu dữ liệu doanh nghiệp
Tác tử AI có thể tìm tài liệu và truy vấn cơ sở dữ liệu, nhưng cần thêm ngữ cảnh đáng tin cậy để biết dữ liệu nằm ở đâu, có ý nghĩa gì, nên được sử dụng thế nào và bắt nguồn từ đâu. Auto Ontology xây dựng lớp ngữ cảnh này từ siêu dữ liệu doanh nghiệp, kết nối các định nghĩa hiện có và cung cấp thông tin cho những hệ thống tác tử thông qua MCP, dòng lệnh và API.
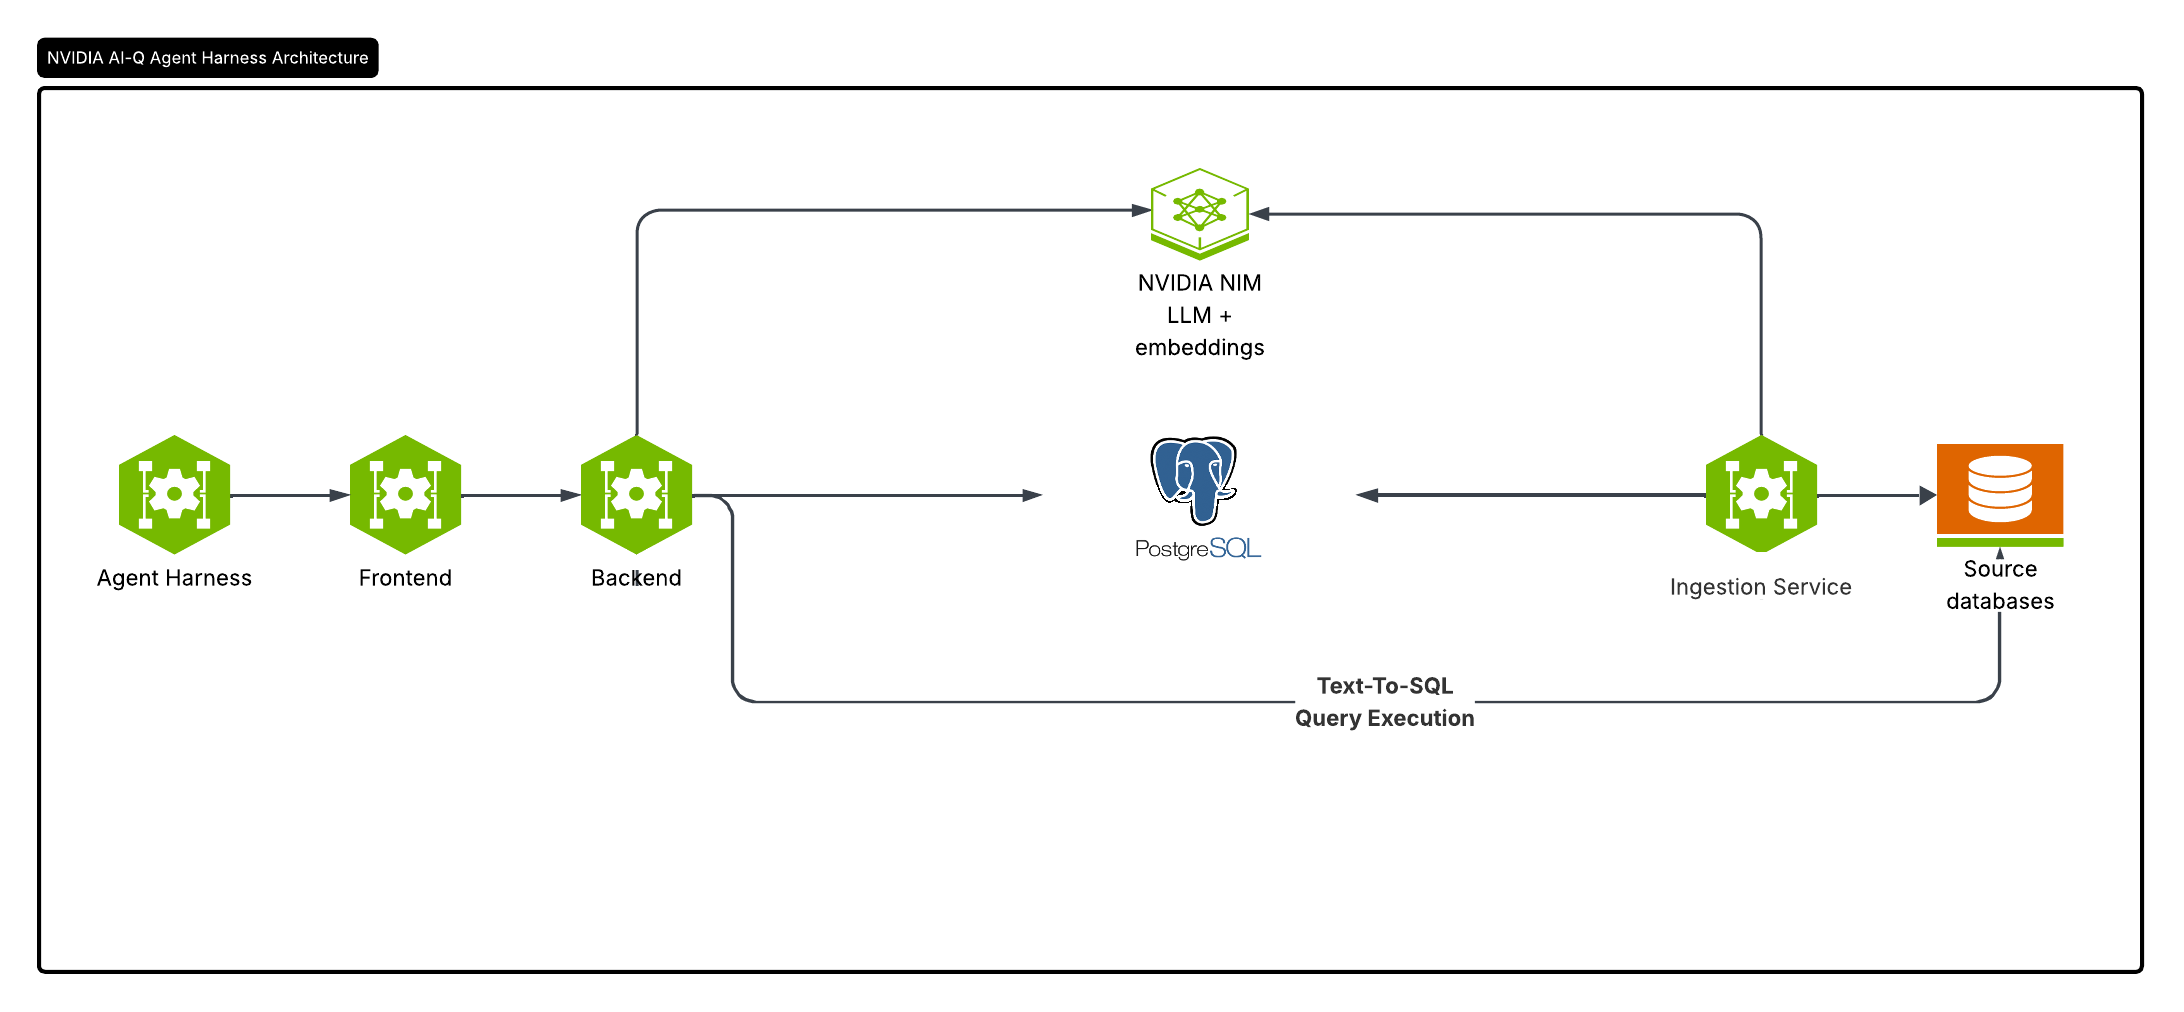 Sơ đồ kiến trúc Auto Ontology
Nền tảng hỗ trợ các bước chính:
- Khám phá: Tạo bản thể doanh nghiệp từ siêu dữ liệu, kết nối các bản thể và mô hình ngữ nghĩa sẵn có, đồng thời xây dựng đồ thị tri thức phù hợp cho AI.
- Định hướng: Cung cấp ý nghĩa nghiệp vụ đáng tin cậy cho chỉ số, thực thể và mối quan hệ; đối chiếu các định nghĩa không nhất quán giữa các hệ thống.
- Kiểm chứng: So sánh truy vấn được tạo với định nghĩa đã được xác nhận và thông tin truy vết nguồn gốc; đính kèm xuất xứ dữ liệu vào mỗi câu trả lời.
- Cung cấp: Đưa ngữ cảnh đến các hệ thống tác tử thông qua MCP, giao diện dòng lệnh (CLI) và API.
- Cải thiện: Ghi nhận các chỉnh sửa đã xác nhận và cách sử dụng để cập nhật bản thể theo thời gian.
Dự án bổ sung cho các mô hình ngữ nghĩa mà khách hàng đang sử dụng, thay vì thay thế chúng. Với dữ liệu có cấu trúc, Auto Ontology hỗ trợ truy vấn bằng ngôn ngữ tự nhiên: chuyển câu hỏi thành SQL rồi thực thi trên các cơ sở dữ liệu đã kết nối, với suy luận do NVIDIA NIM cung cấp.
Thành phần và triển khai
Lớp bản thể và danh mục dữ liệu được lưu trong PostgreSQL, cùng với pgvector để lưu trữ véc-tơ. Các thành phần chính gồm giao diện web dùng Next.js 16, React 19, TypeScript và Tailwind CSS 4; dịch vụ nền dùng FastAPI và Python 3.12 trở lên; cùng một tiến trình riêng để nạp dữ liệu bảng và tạo dữ liệu nhúng.
Hệ thống có xác thực và phân quyền theo vai trò (RBAC), giao diện để trò chuyện, phân tích, quản lý danh mục dữ liệu và thiết lập. Doanh nghiệp có thể triển khai bằng Docker Compose cho môi trường cục bộ hoặc dùng biểu đồ Helm trên Kubernetes. Các nguồn dữ liệu được hỗ trợ gồm Databricks, PostgreSQL, Snowflake và DuckDB.
Auto Ontology sử dụng các điểm cuối NVIDIA NIM được lưu trữ trên dịch vụ API của NVIDIA hoặc các bản NIM tự lưu trữ. Cấu hình mặc định nêu trong dự án gồm mô hình trò chuyện và truy vấn nvidia/nemotron-3-nano-30b-a3b, mô hình nhúng nvidia/nemotron-3-embed-1b và mô hình xếp hạng lại nvidia/llama-nemotron-rerank-vl-1b-v2. Các điểm cuối và mô hình có thể được điều chỉnh bằng biến môi trường; việc sử dụng cần khóa API NVIDIA.
Tích hợp với tác tử và quản lý truy cập
Máy chủ MCP cho phép các hệ thống tác tử như Cursor và Claude Desktop truy vấn dữ liệu qua Auto Ontology. API cũng hỗ trợ mã thông báo dành cho tập lệnh, sổ tay lập trình và tác vụ định kỳ. Mã thông báo chỉ được hiển thị một lần khi tạo; hệ thống chỉ lưu bản băm SHA-256. Mỗi mã thông báo thừa hưởng quyền của người dùng sở hữu, có thể bị thu hồi ngay và không thể tự tạo mã thông báo mới.
Với hội thoại qua API, ứng dụng có thể gửi mã định danh cuộc trò chuyện để tiếp tục trao đổi. Dịch vụ nền tải tối đa năm lượt trao đổi gần nhất đã hoàn tất, giới hạn trong 12.000 ký tự, rồi viết lại câu hỏi phụ thuộc ngữ cảnh thành câu hỏi độc lập trước khi xử lý. Các câu hỏi độc lập được giữ nguyên.
Tài liệu dự án lưu ý cổng FastAPI là ranh giới dịch vụ nội bộ đáng tin cậy, không nên công khai ra Internet: danh tính được chuyển tiếp qua một tiêu đề mà FastAPI không tự xác minh. Kết nối cơ sở dữ liệu cũng cần được cấu hình cẩn thận. Nếu thêm kết nối qua giao diện mà không bật HashiCorp Vault, thông tin đăng nhập, bao gồm mật khẩu, được lưu dưới dạng văn bản thuần trong PostgreSQL. Vault bị tắt theo mặc định; cấu hình chưa đầy đủ sẽ bị bỏ qua và hệ thống quay lại lưu thông tin theo cách này.
Dự án có kho mã đánh giá SQL cho các bộ đo chuẩn như BIRD. Tuy nhiên, NVIDIA cho biết hiện không nhận đóng góp bên ngoài; các báo cáo liên quan đến bảo mật cần theo quy trình được mô tả trong tài liệu của dự án.
Góc nhìn
Với nhóm xây dựng tác tử phân tích dữ liệu, Auto Ontology hướng đến một vấn đề thực tế: mô hình cần hiểu định nghĩa nghiệp vụ và nguồn gốc dữ liệu, không chỉ có khả năng viết truy vấn. Việc kết nối danh mục và bản thể hiện có cũng có thể giúp doanh nghiệp tận dụng các mô hình ngữ nghĩa đã đầu tư.
Khi thử nghiệm, đội ngũ kỹ thuật cần chú ý cấu hình bảo mật ngay từ đầu, đặc biệt là lưu trữ thông tin kết nối và không công khai cổng FastAPI. Đây là những điều kiện quan trọng để triển khai công cụ an toàn trong môi trường có dữ liệu doanh nghiệp.
Nguồn: github.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Tại sao AI doanh nghiệp thường trả lời sai một cách tự tin? Lớp ngữ cảnh (Context Layer) là giải pháp then chốt
02 tháng 6, 2026
Tác tử AI cần danh tính riêng trước khi cần một cổng kết nối
31 tháng 8, 2026

Công nghệ
Von: Nền tảng AI kết hợp nhiều mô hình lớn để cách mạng hóa đội ngũ bán hàng và vận hành doanh thu
21 tháng 4, 2026