Nvidia dùng hồi quy tuyến tính để chuyển KV cache giữa các mô hình
Nhóm nghiên cứu của Nvidia đề xuất kỹ thuật chuyển KV cache giữa các mô hình (cross-model KV cache transfer) bằng hồi quy tuyến tính. Cách này giúp hệ thống AI đa mô hình tránh phải tính lại toàn bộ ngữ cảnh khi đổi mô hình, nhanh hơn 2,7 đến 25 lần và giữ tới 98% độ chính xác của mô hình đích.
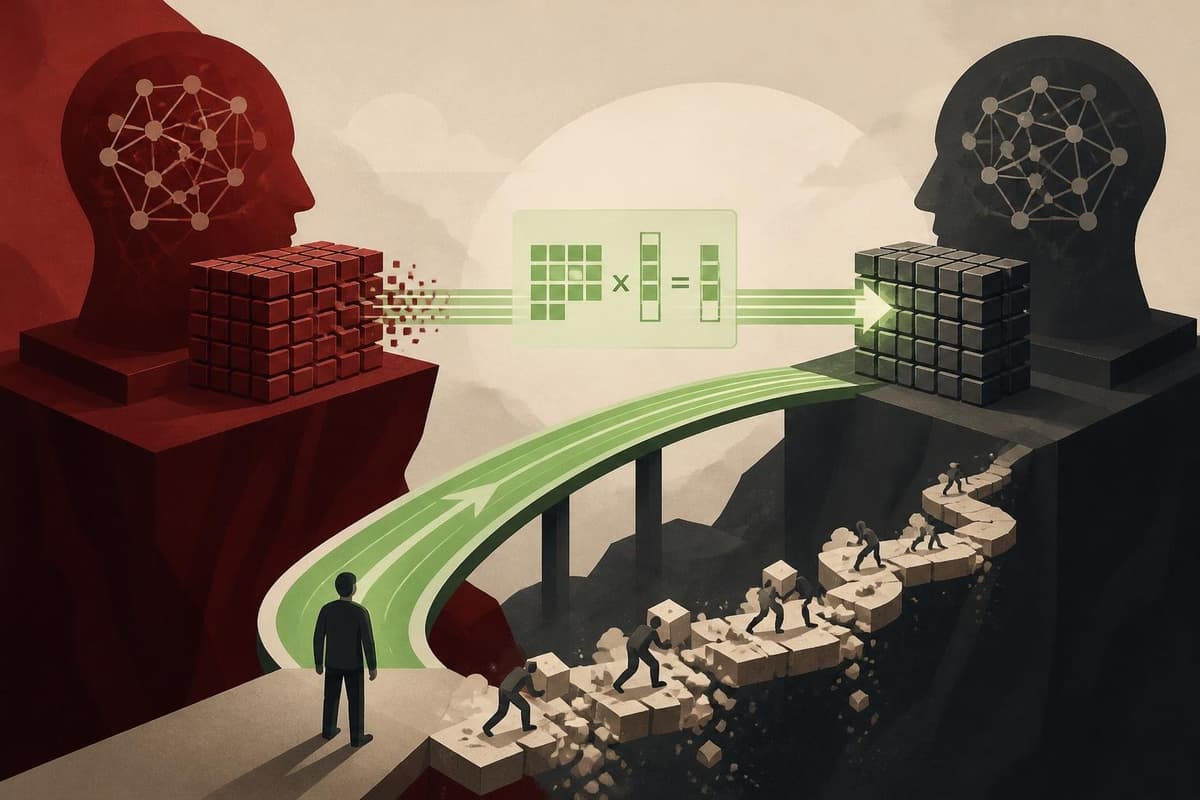
Trong hệ thống AI dạng tác tử (agentic AI), việc chuyển một tác vụ từ mô hình nhỏ sang mô hình lớn, hoặc ngược lại, luôn kèm một khoản chi phí ẩn. Mô hình nhận việc phải tính lại toàn bộ hội thoại từ đầu, làm tăng thời gian xử lý và chi phí tính toán.
Nhóm nghiên cứu của Nvidia đã công bố một kỹ thuật chuyển KV cache giữa các mô hình. Thay vì tính lại ngữ cảnh, hệ thống ánh xạ trực tiếp vùng nhớ đã tính sẵn của mô hình nguồn sang định dạng mà mô hình đích mong đợi.
Vì sao đổi mô hình giữa phiên lại tốn kém
Khi nhận một câu lệnh, mô hình ngôn ngữ lớn (LLM) phải chạy giai đoạn prefill: lượt lan truyền xuôi đầu tiên tính khóa và giá trị cho toàn bộ token đầu vào, rồi nạp vào bộ nhớ đệm KV cache (bộ nhớ đệm khóa - giá trị).
Sau đó mô hình chuyển sang giai đoạn decode, đọc từ KV cache để sinh từng token tiếp theo. Nhờ vậy nó không phải đánh giá lại toàn bộ lịch sử hội thoại cho mỗi token mới.
Với hội thoại nhiều lượt hoặc phiên tác tử kéo dài, ngữ cảnh phình dần. Chi phí prefill tỉ lệ thuận với cả kích thước mô hình lẫn độ dài đầu vào. Nếu KV cache bị vô hiệu hóa, độ trễ tăng mạnh.
KV cache bị vô hiệu hóa mỗi khi hệ thống đổi mô hình giữa phiên, chẳng hạn đẩy một bước suy luận phức tạp sang mô hình lớn, hoặc hạ xuống mô hình nhỏ để tiết kiệm chi phí. Các mô hình khác kiến trúc nên nhận dữ liệu đệm theo định dạng khác nhau.
Kết quả là mô hình nhận phải trả lại toàn bộ chi phí prefill từ đầu.
Ánh xạ bộ nhớ mà không làm lại từ đầu
Kỹ thuật chuyển KV cache có lợi theo cả hai hướng. Chuyển từ nhỏ lên lớn nâng chất lượng đầu ra: mô hình nhỏ xử lý phần thường ngày, khi gặp bài toán suy luận khó thì ánh xạ bộ nhớ sang mô hình lớn và chạy tiếp.
Chuyển từ lớn xuống nhỏ lại giảm chi phí. Mô hình lớn xử lý phần nặng như đọc một system prompt khổng lồ hay tổng hợp một file PDF dày ở đầu phiên. Xong việc, KV cache được ánh xạ xuống mô hình nhỏ hơn, rẻ hơn để phục vụ các lượt hội thoại nhanh tiếp theo.
Các hướng giải quyết trước đây vướng hai hạn chế: cần huấn luyện dựa trên gradient đắt đỏ, hoặc ràng buộc kiến trúc quá chặt. Nghiên cứu lần này chỉ xét các cặp mô hình cùng họ như Qwen, Llama hay Ministral, vốn dùng chung tokenizer, dữ liệu huấn luyện và kiến trúc lõi nhưng khác kích thước và độ sâu.
Phát hiện chính: KV cache giữa các mô hình có cấu trúc tuyến tính đáng kể. Có thể ánh xạ bằng đại số đơn giản, không cần huấn luyện mạng nơ-ron nặng.
Thử nghiệm từ Qwen3 14 tỉ tham số sang bản 32 tỉ tham số cho thấy hồi quy tuyến tính từ một lớp nguồn sang một lớp đích khôi phục được 56% phương sai ở phần khóa và 32% ở phần giá trị. Khi gộp nhiều lớp nguồn, hai con số này lên 79% và 65%.
Nhóm nghiên cứu thiết kế một bộ ánh xạ dạng đóng, chạy riêng cho từng đầu chú ý (attention head), gồm ba phần:
- Hồi quy ridge theo đầu chú ý: dùng một tập hiệu chỉnh nhỏ vài trăm chuỗi văn bản để khớp đường thẳng phù hợp nhất cho từng đầu chú ý, thay vì huấn luyện học sâu.
- Chọn lớp nguồn xuyên lớp: vì số lớp hai mô hình khác nhau, bộ ánh xạ đánh giá và chọn những lớp nguồn dự báo tốt nhất cho từng lớp đích.
- Ánh xạ trong không gian nội dung: trước khi chuyển dữ liệu, bộ ánh xạ gỡ mã hóa RoPE (Rotary Position Embedding), cơ chế xoay dữ liệu theo vị trí để mô hình hiểu thứ tự token. Nhờ vậy nó áp dụng được cho chuỗi dài hơn dữ liệu huấn luyện.
Kết quả thử nghiệm
Nhóm nghiên cứu đánh giá trên sáu họ mô hình có KV khớp (matched-KV), tức cùng số đầu KV và cùng số chiều mỗi đầu. Các họ gồm Qwen3, Llama 3.1 và Ministral 3, kích thước từ 3 tỉ đến 70 tỉ tham số, trong đó có cú nhảy 8,8 lần từ Llama 3.1 8B lên 70B.
Bộ kiểm thử gồm năm bài đo độ chính xác (ARC-Challenge, HellaSwag, WinoGrande, MMLU, GSM8K), độ hỗn loạn (perplexity) trên WikiText-2 và bài hội thoại nhiều lượt CoQA. Tập hiệu chỉnh chỉ có 500 chuỗi, mỗi chuỗi 1.024 token.
Với bốn trong sáu cặp, bộ ánh xạ tuyến tính giữ được 73% đến 98% độ chính xác prefill độc lập của mô hình đích. Cặp Llama 3.1 8B lên 70B giữ 72,8%.
Tốc độ nhanh hơn 2,7 đến 25 lần so với tính lại. Chuyển KV cache 32.768 token từ Qwen3 14B sang bản 32B mất 278 mili giây, trong khi prefill lại mất gần 7 giây.
Độ trôi độ chính xác qua 10 lượt hội thoại rất nhỏ, nên hệ thống không sụp dần trong các phiên tác tử dài.
Hai cấu hình Ministral lại xuống cấp rõ rệt, do hồi quy tuyến tính không ngoại suy được ra ngoài dữ liệu hiệu chỉnh. Nhóm nghiên cứu thay bằng perceptron đa lớp (MLP) hai lớp ẩn, mỗi lớp 1.024 đơn vị, huấn luyện trên cùng dữ liệu. Cách này tốn thêm chi phí huấn luyện nhưng kéo độ chính xác trở lại trên 90%.
Góc nhìn
Với các nhóm đang dựng hệ thống đa mô hình, kết quả này gợi ý một hướng tiết kiệm: không cần huấn luyện thêm mạng nơ-ron lớn, chỉ cần một tập hiệu chỉnh nhỏ và phép hồi quy. Chi phí hạ tầng cho phần đệm bộ nhớ có thể giảm đáng kể.
Tuy nhiên kỹ thuật mới dừng ở các cặp cùng họ mô hình. Doanh nghiệp dùng nhiều nhà cung cấp khác nhau sẽ chưa áp dụng được ngay, và cần theo dõi các thử nghiệm mở rộng sang cặp khác họ.
Nguồn: venturebeat.com · Quy trình biên tập