
On-Policy Self-Distillation: Hướng đi mới giúp AI học liên tục mà không quên kiến thức cũ
On-Policy Self-Distillation (OPSD) đang nổi lên như một phương pháp hứa hẹn giải quyết bài toán học liên tục (continual learning) của các mô hình nền tảng: giúp AI tiếp thu kỹ năng mới mà gần như không quên đi những gì đã học. Dù kết quả thực nghiệm rất khả quan, phương pháp này vẫn đối mặt với hai hạn chế lớn là suy giảm tính đa dạng của đầu ra và chưa áp dụng được cho các mô hình suy luận (thinking models).
On-Policy Self-Distillation: Hướng đi mới giúp AI học liên tục mà không quên kiến thức cũ
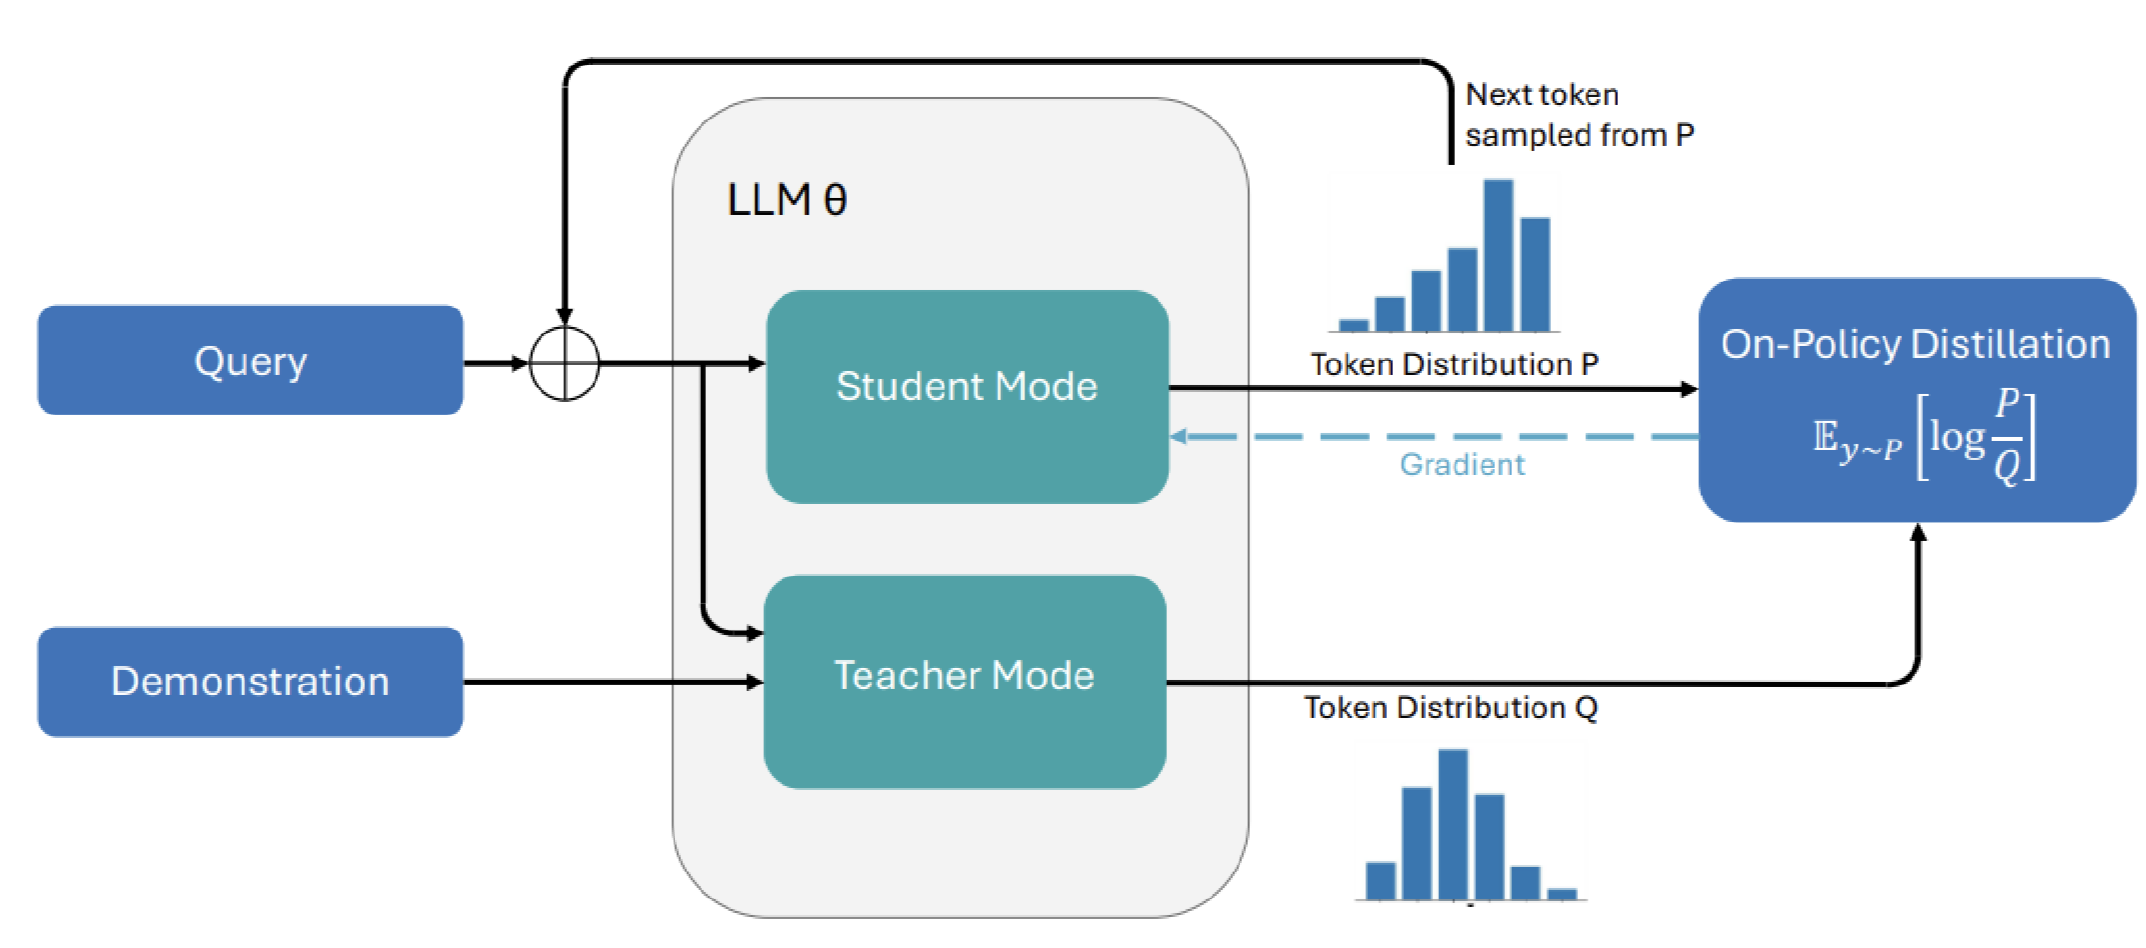
On-Policy Self-Distillation (OPSD) đang tạo nên làn sóng lớn trong giới nghiên cứu học máy. Dù dựa trên những nền tảng lý thuyết đã có từ lâu, các bài báo đầu tiên về chủ đề này chỉ mới xuất hiện vào cuối tháng 1/2026 — và chỉ trong vài tháng đã có hàng chục công trình tiếp nối. Đây được xem là một trong những hướng tiếp cận tiềm năng nhất để giải bài toán "học cái mới mà không mất cái cũ" của các mô hình ngôn ngữ lớn.
 Minh họa quá trình huấn luyện mô hình trí tuệ nhân tạo
Vì sao học liên tục lại khó đến vậy?
Các mô hình nền tảng (foundation model) ngày nay được tiền huấn luyện (pre-training) trên khối lượng dữ liệu khổng lồ với chi phí tính toán cực lớn. Đây là giai đoạn mô hình hình thành năng lực và kiến thức nền tảng. Tiếp đó là hậu huấn luyện (post-training) — dạy mô hình biết cách vận dụng những gì đã học cho một mục đích cụ thể, chẳng hạn tuân thủ chỉ dẫn tốt hơn hay giải toán khó.
Tuy nhiên, với nhiều tác vụ phức tạp hoặc đặc thù, ta vẫn cần huấn luyện thêm. Việc tiền huấn luyện một mô hình riêng từ đầu là bất khả thi về chi phí. Giải pháp thay thế là tinh chỉnh (fine-tuning) trên mô hình nền. Nhưng chính ở đây xuất hiện vấn đề nan giải: catastrophic forgetting — hiện tượng mô hình quên cách xử lý các tác vụ cũ khi học tác vụ mới.
Bản chất vấn đề nằm ở cơ chế học: khi huấn luyện, ta dần "kéo" trọng số của mô hình ra khỏi trạng thái của mô hình nền. Nếu đưa vào quá nhiều dữ liệu mới — hoặc một lượng nhỏ dữ liệu nhưng phân phối lệch quá xa (out-of-distribution) so với những gì mô hình từng thấy — ta có thể kéo mạnh đến mức phá vỡ khả năng thực hiện các tác vụ trước đó. Ngưỡng "quá nhiều" này thường nhỏ hơn nhiều so với sức chịu đựng của con người.
Học liên tục (continual learning) là khả năng mô hình học liên tục từ một dòng dữ liệu biến thiên, gần như vô tận, mà không bị quên kiến thức cũ. Làm đúng, mô hình có thể tiếp thu vô số kỹ năng mới mà không đánh đổi đáng kể năng lực sẵn có.
Sự quan tâm đến học liên tục đã tăng vọt trong năm qua. Các mô hình mở (open-weight) ngày càng mạnh, kết hợp với các phương pháp hậu huấn luyện mới, đã mở ra thời điểm mà học liên tục thực sự khả thi cho nhiều bài toán thực tế hơn bao giờ hết.
Tự chưng cất: Ý tưởng cốt lõi
Chưng cất tri thức (knowledge distillation) là kỹ thuật quen thuộc: dùng một mô hình lớn, phức tạp làm "giáo viên" để huấn luyện một mô hình "học trò" bắt chước đầu ra của nó. Đây là kỹ thuật hiệu quả và phổ biến, dù gần đây thường bị nhắc đến với hàm ý tiêu cực trong các cáo buộc "tấn công chưng cất".
Tự chưng cất (self-distillation) xoay chuyển cách làm này: thay vì dùng một mô hình khác mạnh hơn làm giáo viên, cả giáo viên và học trò đều là bản sao của cùng một mô hình. Khác biệt duy nhất là giáo viên được tiếp cận thông tin đặc quyền (privileged information) và tham số của nó được cập nhật theo cách hơi khác. Chính điều này giúp giảm hiện tượng quên thảm họa.
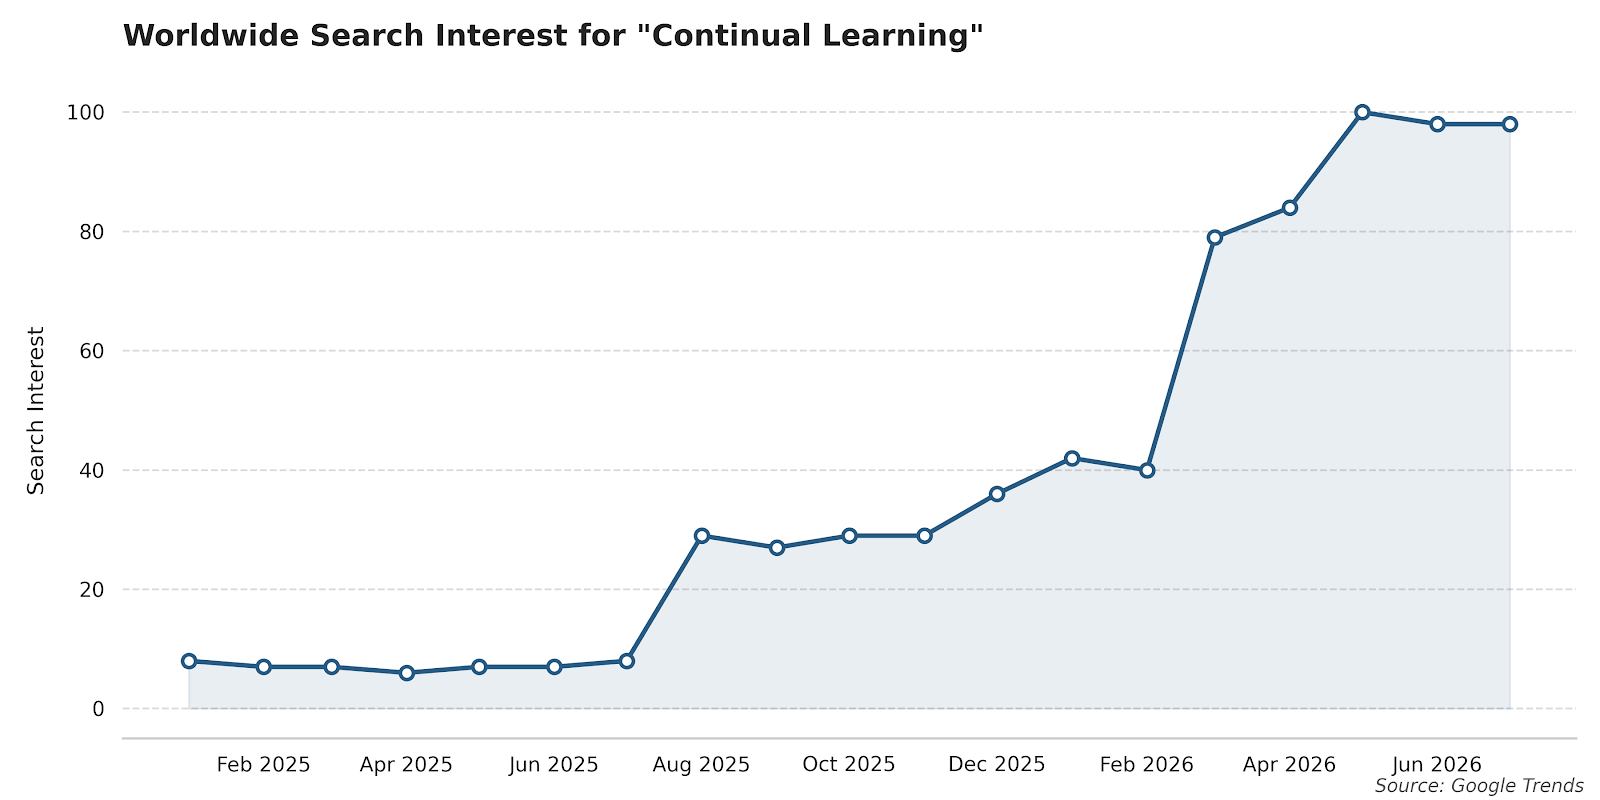
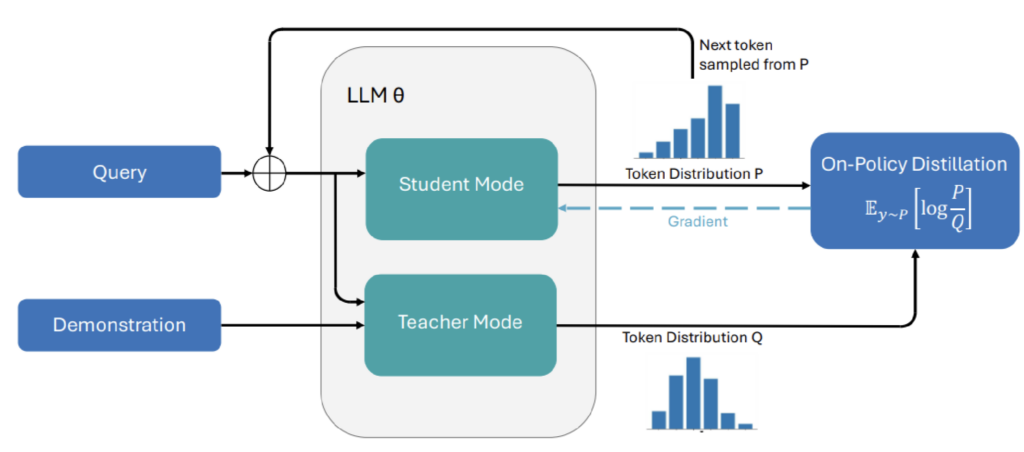
OPSD nói chung và khung SDFT (Self-Distillation Fine-Tuning) nói riêng đều áp dụng tự chưng cất. Trong SDFT, giáo viên được cung cấp bản trình diễn mẫu của chuyên gia (expert demonstration) cho mỗi truy vấn. Với các câu hỏi trắc nghiệm hóa học lấy từ bộ SciKnowEval, giáo viên nhận được đáp án đúng kèm lời giải thích ngắn gọn cách suy ra. Cả học trò và giáo viên đều là Qwen-2.5-7B-Instruct, còn các bản trình diễn chuyên gia do GPT-4o mạnh hơn nhiều tạo ra.
 Sơ đồ kiến trúc của khung SDFT
Với mỗi token học trò tạo ra, cả hai mô hình đều đưa ra phân phối xác suất cho token tiếp theo. Mục tiêu huấn luyện là tối thiểu hóa phân kỳ KL ngược (reverse KL divergence) giữa hai phân phối này. Giáo viên không thực sự sinh token — nó chỉ đóng vai trò cung cấp phân phối tham chiếu.
Có ba cách cập nhật tham số giáo viên:
- Đóng băng hoàn toàn: Giáo viên không tiến bộ cùng học trò, dẫn đến kết quả dưới mức tối ưu.
- Cập nhật y hệt học trò: Làm giảm độ ổn định huấn luyện, tạo ra hiện tượng "buồng vang" khiến sai lệch nhỏ bị khuếch đại.
- Cập nhật trung bình động (EMA): Tham số giáo viên là trung bình động lũy thừa của tham số học trò — đây là lựa chọn của SDFT và hầu hết các khung OPSD.
Vì sao dùng chính mô hình làm giáo viên lại hiệu quả?
Thoạt nghe có vẻ phản trực giác: dùng một mô hình biểu đạt mạnh hơn làm giáo viên chẳng phải tốt hơn sao? Câu trả lời nằm ở catastrophic forgetting. Một giáo viên mạnh hơn có thể giúp học trò giỏi hơn ở tác vụ mới, nhưng đồng thời có thể làm suy giảm năng lực mà học trò đã được tiền huấn luyện. Khi cả hai là cùng một mô hình, giáo viên lệch khỏi học trò ít hơn nhiều so với một mô hình lớn hơn. Nói cách khác, giáo viên tự chưng cất "kéo" trọng số học trò nhẹ nhàng và có mục tiêu hơn, nhưng vẫn dạy được điều cần học.
Shenfeld và cộng sự đã cung cấp bằng chứng thực nghiệm cho thấy SDFT đạt kết quả hậu huấn luyện xuất sắc, gần như loại bỏ hoàn toàn hiện tượng quên thảm họa.
Yếu tố then chốt thứ hai: On-Policy
Khi huấn luyện mô hình ngôn ngữ, bản thân mô hình đóng vai trò chính sách (policy) trong bối cảnh học tăng cường (RL). Có hai loại phương pháp RL dựa trên chính sách: on-policy và off-policy.
- On-policy: Các mẫu dùng để huấn luyện được tạo ra ngay trong thời gian thực bởi chính mô hình đang học.
- Off-policy: Mô hình học từ dữ liệu được tạo sẵn và lưu trữ từ trước.
Tinh chỉnh có giám sát (SFT) tiêu chuẩn bản chất là off-policy. Trong khi đó, các nghiên cứu trước đây của Shenfeld và cộng sự cho thấy RL on-policy đặc biệt phù hợp với hậu huấn luyện: các mô hình được huấn luyện bằng RL on-policy đạt hiệu năng tương đương trên tác vụ mới so với SFT, nhưng quên ít hơn.
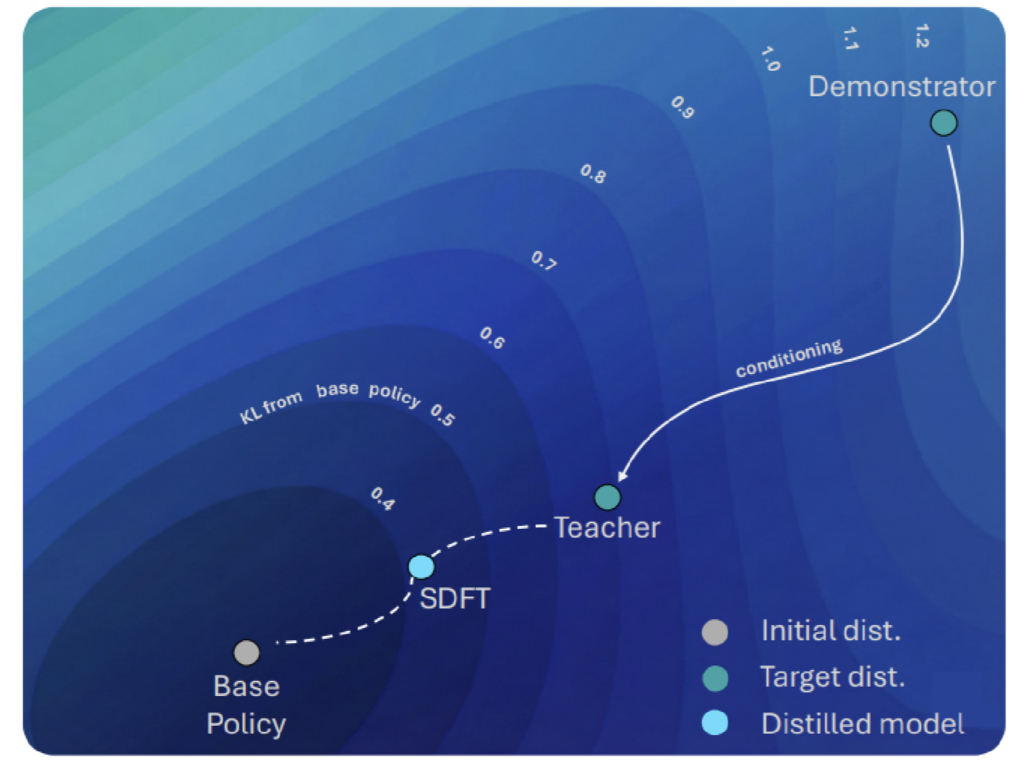
Nguyên nhân là xu hướng cố hữu của RL on-policy: nó có khuynh hướng hội tụ về những chính sách có phân kỳ KL tối thiểu so với chính sách nền của mô hình trước khi tinh chỉnh. Vì chỉ được huấn luyện trên những đầu ra do chính mình tạo ra, mô hình chủ yếu điều chỉnh lại xác suất của những câu trả lời mà nó vốn đã có khả năng sinh ra, thay vì gán xác suất cho những đầu ra lệch xa chính sách nền. Điều này khác với SFT, nơi tập dữ liệu bên ngoài có thể khiến mô hình bắt chước những mẫu hình mà chính sách nền không hề có.
Có thể có vô số chính sách thực hiện tốt một tác vụ mới, nhưng RL on-policy dường như luôn chọn những chính sách gần với chính sách nền hơn về mặt KL. Sự tương đồng giữa lập luận ủng hộ RL on-policy và lập luận ủng hộ tự chưng cất khiến hai cơ chế này cộng hưởng, giảm quên mạnh hơn nhờ kết hợp cả hai — và đó chính là SDFT.
 So sánh mức độ lệch phân kỳ KL giữa mô hình nền và mô hình sau huấn luyện
Bằng chứng thực nghiệm đáng chú ý
Shenfeld và cộng sự huấn luyện mô hình trên ba tác vụ rất khác nhau, lần lượt từng tác vụ một, mỗi lần bằng SFT và bằng SDFT để so sánh.
- SFT thể hiện hiện tượng quên thảm họa điển hình: độ chính xác trên các tác vụ khác giảm xuống dưới cả mức cơ sở của mô hình trước huấn luyện. Mọi tiến bộ đạt được khi tập trung vào một tác vụ đều nhanh chóng bị xóa sổ khi chuyển sang tác vụ kế tiếp.
- SDFT không chỉ giữ nguyên hiệu năng cơ sở trước khi huấn luyện cho từng tác vụ, mà còn duy trì ổn định mức cải thiện theo từng tác vụ, không có sụt giảm đáng kể trên tác vụ đầu tiên dù đã qua hàng trăm bước huấn luyện cho hai tác vụ còn lại. Thậm chí, SDFT còn đạt độ chính xác cao hơn SFT trên mỗi tác vụ mới.
Nghiên cứu của Zhao và cộng sự tập trung vào hiệu năng tác vụ mới và hiệu quả token, so sánh OPSD với GRPO (một phương pháp RL đã được khẳng định) và SFT. Kết quả cho thấy:
- OPSD cải thiện đáng kể hiệu quả token so với GRPO, cần ít token hơn nhiều trong 100 bước huấn luyện, đồng thời vượt trội rõ rệt trên các bộ đánh giá AIME24, AIME25 và HMMT25.
- Nguyên nhân có thể là OPSD tận dụng toàn bộ bản trình diễn chuyên gia, trong khi GRPO chỉ dùng đáp án cuối cùng để so sánh nhị phân — một sự bất đối xứng thông tin lớn.
- Khi kéo dài lên 500 bước, lợi thế của OPSD so với GRPO thu hẹp đáng kể, đặc biệt trên các mô hình lớn hơn (Qwen-3-8B, Qwen-3-4B). GRPO thậm chí còn vượt OPSD trên HMMT25 với Qwen-3-8B. Tuy nhiên, khoảng cách vẫn rõ rệt trên mô hình nhỏ Qwen-3-1.7B, và OPSD vẫn dễ dàng vượt SFT trên mọi tiêu chí.
Nhưng đây chưa phải "viên đạn bạc"
OPSD đầy hứa hẹn, nhưng không phải không có hạn chế. Có hai lo ngại chính đã được giới nghiên cứu nêu ra.
Suy giảm tính đa dạng của đầu ra
Nicolicioiu và cộng sự chỉ ra hiện tượng mất đa dạng đầu ra ở các mô hình được huấn luyện theo cơ chế OPSD khi bản trình diễn được lấy mẫu từ chính đầu ra của mô hình — gọi là SDSD (Self-Distillation with Sampled Demonstrations). Nhóm nghiên cứu đo hai dạng đa dạng:
- Đa dạng chức năng (functional): mức độ mà các lần thử bổ sung giúp mô hình thực sự giải được bài toán. Thước đo là độ dốc của đường cong pass@k.
- Đa dạng ngữ nghĩa (semantic): mức độ khác biệt về chiến lược giải quyết giữa các đầu ra.
Kết quả cho thấy mô hình huấn luyện bằng SDSD có cả hai dạng đa dạng đều thấp hơn so với GRPO. Đường cong pass@k gần như phẳng hoàn toàn trên nhiều bộ đánh giá: nghĩa là nếu mô hình không giải được bài ngay lần đầu, gần như chắc chắn nó cũng không giải được ở lần thử thứ 64. Điều này khiến mô hình kém phù hợp cho các ứng dụng như tác vụ agent đơn giản hay chứng minh định lý toán học — nơi người ta thường sinh nhiều lời giải rồi chọn ra phương án tốt nhất bằng mô hình giám khảo.
Nguyên nhân được lý giải là thiên lệch tích lũy trong quá trình huấn luyện, cùng xu hướng mode-seeking (tìm kiếm đỉnh phân phối) của RL on-policy — dẫn đến hành vi "càng có khả năng thì càng dễ xảy ra" (likely-get-likelier). Tình trạng này càng trầm trọng vì giáo viên ưu ái quá mức những lời giải giống với bản trình diễn mà nó được cung cấp.
Chưa áp dụng được cho mô hình suy luận
Một câu hỏi quan trọng khác là liệu kết quả của các bài báo đầu tiên có thể lặp lại trên thinking models (mô hình suy luận) hay không. Các thí nghiệm kể trên đều được thực hiện trên mô hình instruct (không suy luận sâu). Trong khi đó, thinking models đã chứng minh năng lực vượt trội ở các tác vụ lập luận khó.
Đáng tiếc, Kaur và cộng sự cho thấy OPSD không tổng quát hóa được sang thinking models, ít nhất là không trực tiếp. Thí nghiệm với năm thinking model trên AIME24, AIME25 và HMMT25 cho thấy OPSD làm giảm chỉ số avg@16 (độ chính xác trung bình trên 16 lần sinh) ở mọi mô hình và mọi bộ đánh giá — thường hơn 5 điểm và đôi khi gần 10 điểm. Giả thuyết được đưa ra: tín hiệu của giáo viên tại các điểm uốn trong chuỗi suy luận có thể chặn khả năng tự sửa lỗi của học trò trước khi nó kịp từ bỏ một hướng giải sai.
Kết luận
OPSD có thể tách thành hai thành phần then chốt: tự chưng cất và RL on-policy. Mỗi thành phần đóng góp riêng vào việc giảm quên thảm họa, và khi kết hợp, chúng cộng hưởng để tạo ra SDFT — một khung hậu huấn luyện giúp mô hình học kỹ năng mới mà gần như bảo toàn năng lực cũ.
Dù vậy, với người theo dõi công nghệ AI tại Việt Nam, cần nhìn nhận OPSD một cách cân bằng: kết quả thực nghiệm rất ấn tượng, nhưng phương pháp này vẫn còn hai rào cản lớn là suy giảm tính đa dạng đầu ra do thiên lệch tích lũy, và sự suy giảm hiệu năng trên thinking models. Đây cũng là những hướng nghiên cứu mở trong thời gian tới, hứa hẹn tiếp tục làm thay đổi cách chúng ta hậu huấn luyện các mô hình nền tảng.


