
Postgres không chậm — ổ cứng của bạn mới là vấn đề
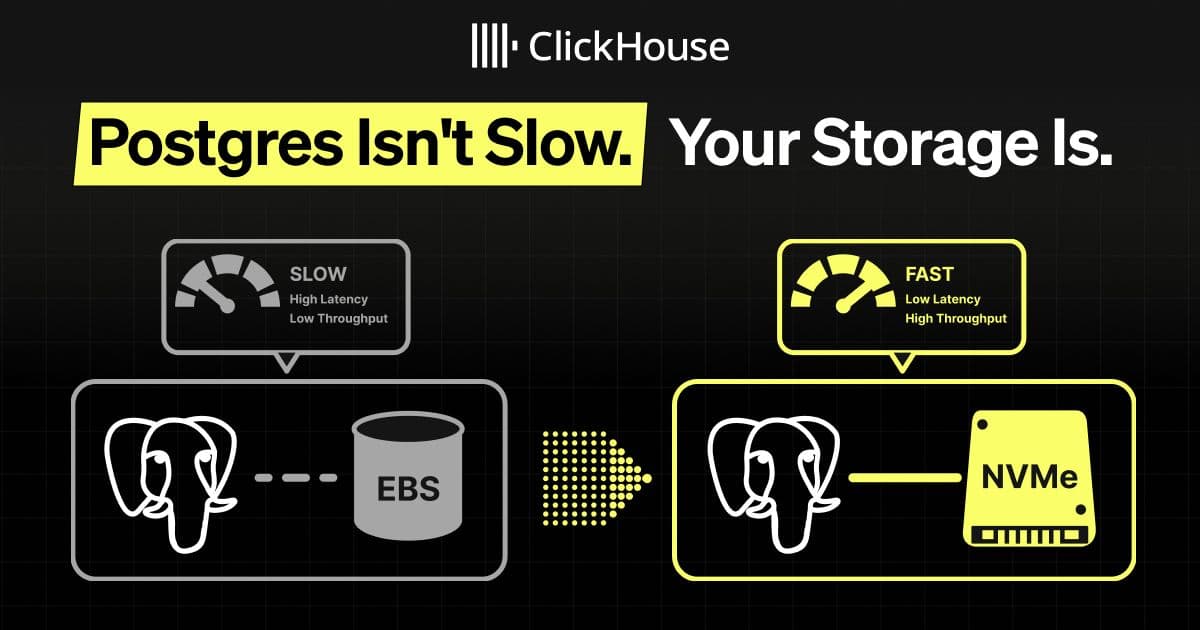
Bài nói tại POSETTE 2026 của Sai Srirampur chỉ ra rằng nhiều vấn đề hiệu năng của PostgreSQL như nạp dữ liệu chậm, độ trễ đọc thất thường hay vacuum tụt hậu đều bắt nguồn từ tầng lưu trữ. Benchmark trên cùng khối lượng 3,3 tỷ dòng cho thấy NVMe cục bộ đạt tốc độ cao gấp 9,24 lần so với EBS gp3, đồng thời mở ra kiến trúc vận hành an toàn cho môi trường production.
Postgres không chậm — ổ cứng của bạn mới là vấn đề
Khi cơ sở dữ liệu PostgreSQL phình to tới hàng trăm gigabyte hoặc hàng terabyte, rất nhiều vấn đề hiệu năng bắt đầu xuất hiện cùng lúc. Tại hội nghị POSETTE 2026, kỹ sư Sai Srirampur đã trình bày bài nói "Postgres Isn't Slow. Your Storage Is." nhằm chứng minh rằng nguyên nhân gốc rễ thường nằm ở tầng lưu trữ chứ không phải ở bản thân PostgreSQL. Bài viết này tóm tắt lại phần benchmark và kiến trúc vận hành được đề xuất.
Năm triệu chứng quen thuộc khi mở rộng quy mô
Có năm dấu hiệu thường xuất hiện khi một workload PostgreSQL đạt tới hàng trăm gigabyte hoặc hàng terabyte và phải chạy với độ đồng thời cao.
- Nạp dữ liệu chậm: các pipeline nhiều lệnh UPDATE và UPSERT từng hoàn thành trong vài giây nay kéo dài thành vài phút.
- Độ trễ đọc thất thường: phần lớn truy vấn vẫn nhanh, nhưng một số ít đột ngột chậm hẳn, khiến độ trễ P95 nhảy từ mili giây lên giây.
- VACUUM tụt hậu: khi lượng UPDATE và UPSERT tăng, autovacuum không theo kịp và độ phình bảng tích tụ từ gigabyte lên terabyte.
- Checkpoint chậm hơn: checkpoint kéo dài và cạnh tranh tài nguyên I/O, CPU với workload chính, biến một thao tác vô hình thành những đợt tăng vọt độ trễ định kỳ.
- Độ trễ logical replication: khi dữ liệu được truyền sang Kafka hay ClickHouse, việc giải mã WAL chậm dần và replication slot ngày càng phình to.
Vì sao các triệu chứng này đều liên quan tới lưu trữ
Khi tập dữ liệu làm việc vượt quá dung lượng bộ nhớ mà PostgreSQL và page cache của hệ điều hành có thể giữ, lượng dữ liệu phải đọc từ đĩa tăng lên. Trên ổ cứng chậm, chi phí và hàng đợi của những lần đọc này đẩy cả độ trễ trung bình lẫn độ trễ đuôi lên cao.
Điểm mấu chốt là các truy vấn của ứng dụng và những tác vụ bảo trì nền dùng chung một ngân sách lưu trữ. Ghi heap và index, đồng bộ WAL, checkpoint, VACUUM và cả việc tràn bộ nhớ của logical decoding đều tranh nhau băng thông, IOPS và dung lượng hàng đợi. Khi tầng lưu trữ chạm trần, các thao tác bắt đầu làm chậm lẫn nhau — và đó là cách một ổ cứng chậm trở thành nguyên nhân gốc của nhiều vấn đề tưởng như chẳng liên quan gì tới nhau.
Điểm mạnh của NVMe cục bộ không nằm ở việc loại bỏ hoàn toàn I/O, mà ở chỗ giảm mạnh chi phí của nó: từ mức mili giây trên lưu trữ gắn qua mạng xuống còn vài chục micro giây. Cache miss, ghi WAL và I/O bảo trì vẫn diễn ra, nhưng chúng không còn ảnh hưởng lớn tới toàn hệ thống.
Benchmark: NVMe cục bộ so với EBS
Để cô lập biến số lưu trữ, nhóm tác giả dùng tám cụm PostgreSQL giống hệt nhau: bốn cụm dùng NVMe instance-store và bốn cụm dùng EBS gp3 cấu hình cơ bản 3.000 IOPS. Mỗi cụm chạy trên instance m6id.4xlarge với 16 vCPU, 64 GiB RAM và 16 GiB shared_buffers.
 So sánh độ trễ giữa Postgres trên EBS và NVMe cục bộ
Khối dữ liệu thử nghiệm là bảng pgbench_accounts nặng 482 GiB với 3,3 tỷ dòng. Mỗi cụm chạy cùng một workload UPDATE ngẫu nhiên với độ đồng thời cao trong năm phút, gồm 64 client và 16 worker thread. Sự khác biệt duy nhất giữa hai nhóm chính là loại lưu trữ.
Kết quả rất rõ ràng:
- Các cụm NVMe đạt trung vị 16.030 TPS, so với 1.734 TPS trên EBS — chênh lệch 9,24 lần.
- Độ trễ giao dịch trung vị giảm từ 36,9 ms xuống 4,0 ms.
- VACUUM trên 10 GB dữ liệu phình hoàn thành trong 366 giây thay vì 964 giây.
- Xử lý 10 GB tồn đọng logical replication mất 139 giây thay vì 238 giây.
Cần lưu ý rằng kết quả này chỉ đúng với workload và cấu hình lưu trữ cụ thể trong thử nghiệm. Phía EBS dùng gp3 cấu hình cơ bản ở 3.000 IOPS, nên một thiết lập EBS khác nhiều khả năng sẽ cho kết quả khác.
Lý giải khoảng cách
Để hiểu vì sao chênh lệch lớn đến vậy, hãy nhìn vào 37 ms độ trễ giao dịch trên EBS được phân bổ ra sao.
- Đọc page tốn khoảng 19 ms trên EBS, so với 0,3 ms trên NVMe.
- WAL fsync lúc commit tốn thêm 11 ms trên EBS, so với 1,5 ms trên NVMe.
- Chi phí khóa và scheduler khoảng 5 ms, so với 0,2 ms trên NVMe.
- Riêng công việc CPU gần như tương đương, khoảng 2 ms ở cả hai trường hợp.
Nói cách khác, phần lớn độ trễ tăng thêm trên EBS đến từ việc chờ lưu trữ, chứ không phải PostgreSQL phải làm nhiều việc CPU hơn.
Ảnh chụp pg_stat_activity giữa chừng cũng cho thấy điều tương tự: trong 64 backend, có 29 backend trên EBS đang chờ ở trạng thái IO:DataFileRead, so với 9 trên NVMe — tức khoảng 45% so với 14%.
Điểm thú vị là profile CPU lại cho ra một quan sát ngược trực giác. Trong khoảng 240 giây đo đạc, máy NVMe tích lũy 2.253 CPU-giây (khoảng 9,4 nhân bận rộn), còn máy EBS chỉ tích lũy 251 CPU-giây (khoảng một nhân bận rộn).
 Profile CPU của Postgres trên NVMe và EBS
Máy EBS thực chất dành phần lớn thời gian nằm ngoài CPU để chờ lưu trữ, còn máy NVMe giữ được nhiều năng lực CPU làm việc hữu ích hơn. Đó là lý do thông lượng cao hơn hẳn: cache miss và ghi WAL vẫn xảy ra, nhưng chúng hoàn tất nhanh hơn nhiều.
Vấn đề độ bền dữ liệu
Sau phần hiệu năng là câu hỏi hiển nhiên: NVMe instance-store gắn liền với vòng đời của máy, nên dữ liệu cục bộ sẽ biến mất khi node chết. Liệu PostgreSQL có thể kết hợp độ trễ của NVMe với mức sẵn sàng và khả năng phục hồi đạt chuẩn production?
Câu trả lời ngắn gọn là có, với điều kiện độ bền được đảm bảo ở cấp cụm thay vì ở từng node PostgreSQL riêng lẻ.
Kiến trúc chạy NVMe trong production
Chạy PostgreSQL trên NVMe cục bộ trong production nghĩa là phải thiết kế xoay quanh loại lưu trữ nhanh nhưng gắn chặt với vòng đời máy. Mất một node là mất bản sao dữ liệu cục bộ trên node đó, ổ instance-store không thể snapshot qua API của EBS, và dung lượng khả dụng phụ thuộc vào loại instance được chọn.
Kiến trúc được đề xuất giải quyết ba yêu cầu chính: sao chép cơ sở dữ liệu để dịch vụ sống sót khi mất node, duy trì backup và dữ liệu phục hồi bên ngoài từng máy, và quy hoạch dung lượng theo NVMe có sẵn trên mỗi loại instance.
Sẵn sàng cao với hai standby
Mô hình đầu tiên là synchronous replication dựa trên quorum với hai standby. Với cấu hình kiểu ANY 1 (standby1, standby2), giao dịch có thể commit ngay khi một trong hai standby xác nhận đã ghi bền WAL, thay vì phải chờ cả hai. Đặt các node ở nhiều availability zone khác nhau giúp chống lại sự cố mất cả một AZ.
Backup liên tục lên object storage
Để đảm bảo độ bền ngoài các node cơ sở dữ liệu, những công cụ mã nguồn mở như WAL-G có thể cung cấp base backup vật lý và lưu trữ WAL liên tục. Với tốc độ truyền WAL thấp, kiến trúc này có thể nhắm tới RPO tính bằng giây và hỗ trợ khôi phục theo thời điểm trong cửa sổ lưu trữ. Backup và WAL nên được đặt ở miền lỗi riêng biệt, kèm thêm một bản sao ở vùng khác nếu kế hoạch phục hồi cần chống cả sự cố mất toàn vùng.
Backup là nền tảng của phục hồi
Base backup và WAL lưu trữ không chỉ là cơ chế ứng cứu khẩn cấp: cùng một lịch sử phục hồi đó còn phục vụ khôi phục theo thời điểm, tạo nhánh cô lập, thay đổi kích thước triển khai, gieo dữ liệu cho read replica và phục hồi sau thảm họa.
Backup và replication giải quyết hai bài toán khác nhau. Trong kiến trúc được trình bày, standby đảm bảo chuyển đổi dự phòng nhanh, còn backup bảo vệ trước hỏng dữ liệu, sai sót của người vận hành và sự cố toàn cụm. Cả hai con đường phục hồi đều cần được kiểm thử định kỳ.
Ví dụ từ thực tế
Mô hình này không chỉ mang tính lý thuyết. Bài nói dẫn ra các ví dụ công khai từ Instacart, đơn vị từng chia sẻ việc dùng PostgreSQL trên NVMe cho workload tìm kiếm nhạy cảm với độ trễ, và Datadog, nơi cũng thảo luận về các instance PostgreSQL dùng NVMe cục bộ. Công thức lặp lại khá nhất quán: lưu trữ cục bộ để đạt hiệu năng, sao chép đồng bộ để đảm bảo sẵn sàng, và base backup cùng WAL lưu trữ độc lập để phục hồi.
Điểm mấu chốt
Bài nói khép lại bằng một gợi ý mang tính chẩn đoán: khi PostgreSQL có dấu hiệu ngừng mở rộng, hãy kiểm tra cơ sở dữ liệu và tầng lưu trữ cùng lúc. Nạp dữ liệu chậm, độ trễ đọc thất thường, áp lực vacuum, checkpoint gây gián đoạn và replication lag đều có thể là tín hiệu cho thấy tầng lưu trữ đã chạm giới hạn.
Kết luận thực tế hẹp hơn tiêu đề một chút: NVMe cục bộ có thể giảm mạnh chi phí I/O cho các workload bị nghẽn ở tầng lưu trữ, nhưng đi kèm một mô hình vận hành hoàn toàn khác. Kiến trúc phù hợp dùng replication theo quorum để đảm bảo sẵn sàng, cùng base backup và WAL lưu trữ độc lập để phục hồi.
Với các đội ngũ vận hành PostgreSQL quy mô lớn tại Việt Nam — đặc biệt những hệ thống dùng EBS gp3 mặc định trên cloud — đây là lời nhắc đáng cân nhắc: trước khi tối ưu truy vấn hay tăng cấu hình máy chủ, hãy đo lại tầng lưu trữ. Rất có thể nút thắt thật sự nằm ở đó.
Bài viết liên quan
Công nghệ
TinyJS: Khi bạn chỉ cần một ứng dụng desktop thật nhỏ gọn
12 tháng 10, 2026
Công nghệ
Xcode 27.2 chuyển sang định dạng JSON cho cấu hình dự án, tối ưu cho AI agent
12 tháng 10, 2026
Công nghệ
Dự án đưa game PS2 lên trình duyệt bằng cách biên dịch lại sang WebAssembly, không cần trình giả lập
12 tháng 10, 2026