Cảnh báo: Tham số recovery_prefetch của Postgres có thể gây sập hệ thống production
Một phân tích thực tế cho thấy tham số recovery_prefetch trong PostgreSQL có thể biến các thao tác đọc tuần tự lớn thành hàng loạt lệnh đọc ngẫu nhiên 8KB, khuếch đại IOPS tới 16 lần trên bản replica. Khi kết hợp với synchronous replication, điều này có thể khiến các replica tụt lại hàng giờ và gây gián đoạn toàn bộ hệ thống ghi.
Cảnh báo: Tham số recovery_prefetch của Postgres có thể gây sập hệ thống production
Cộng đồng PostgreSQL đang xôn xao trước một phân tích kỹ thuật chỉ ra rằng tham số recovery_prefetch — vốn được kỳ vọng giúp tăng tốc quá trình phục hồi WAL trên các bản standby — lại có thể trở thành nguyên nhân gây gián đoạn dịch vụ nghiêm trọng. Vấn đề nằm ở việc khuếch đại IOPS đọc kết hợp với cơ chế synchronous replication, biến một sự cố mạng tạm thời thành tình trạng treo ghi kéo dài hàng giờ.
Vấn đề ẩn mình suốt nhiều năm
Câu chuyện bắt đầu từ những quan sát "âm thầm" trong môi trường production mà phải đến khi nhìn thật kỹ người ta mới phát hiện ra. Trên thực tế, dấu hiệu đã xuất hiện từ lâu: từ năm 2021, khi tính năng này còn đang phát triển, Stephen Frost đã từng nêu nghi vấn trên mailing list của PostgreSQL. Đến tháng 3/2025, Michael Zhilin (Postgres Pro) tiếp tục báo cáo rõ ràng từ thực địa. Tuy nhiên, cả hai ý kiến đều chưa nắm được bức tranh đầy đủ.
Để hiểu vấn đề, cần nắm ba bối cảnh quan trọng:
- Full Page Images (FPI/FPW) gần như phổ biến: Dù tốn kém hiệu năng, đây là cách duy nhất để PostgreSQL chống lại hiện tượng "torn writes" khi hệ điều hành khởi động lại. Phần lớn các triển khai production của bản community OSS đều bật tính năng này.
- Synchronous replication ngày càng phổ biến: Với công nghệ OSS, chỉ có hai cách chống mất dữ liệu khi phần cứng hỏng — sao chép ở tầng lưu trữ (DRBD hoặc storage độc quyền đắt tiền) hoặc sao chép ở tầng database bằng synchronous replication. Cách thứ hai là lựa chọn tiêu chuẩn trên Kubernetes và phần cứng phổ thông.
- Điểm chưa từng được chẩn đoán: Vấn đề của recovery_prefetch không chỉ liên quan đến FPI. Khi bản primary thực hiện I/O tuần tự lớn, recovery_prefetch biến các thao tác này thành hàng loạt lệnh đọc ngẫu nhiên 8KB. Với cùng số byte đọc, IOPS trên replica có thể bị khuếch đại tới 16 lần.
 Minh họa về khuếch đại IOPS trên Postgres standby
Tại sao lại thành sự cố sập hệ thống?
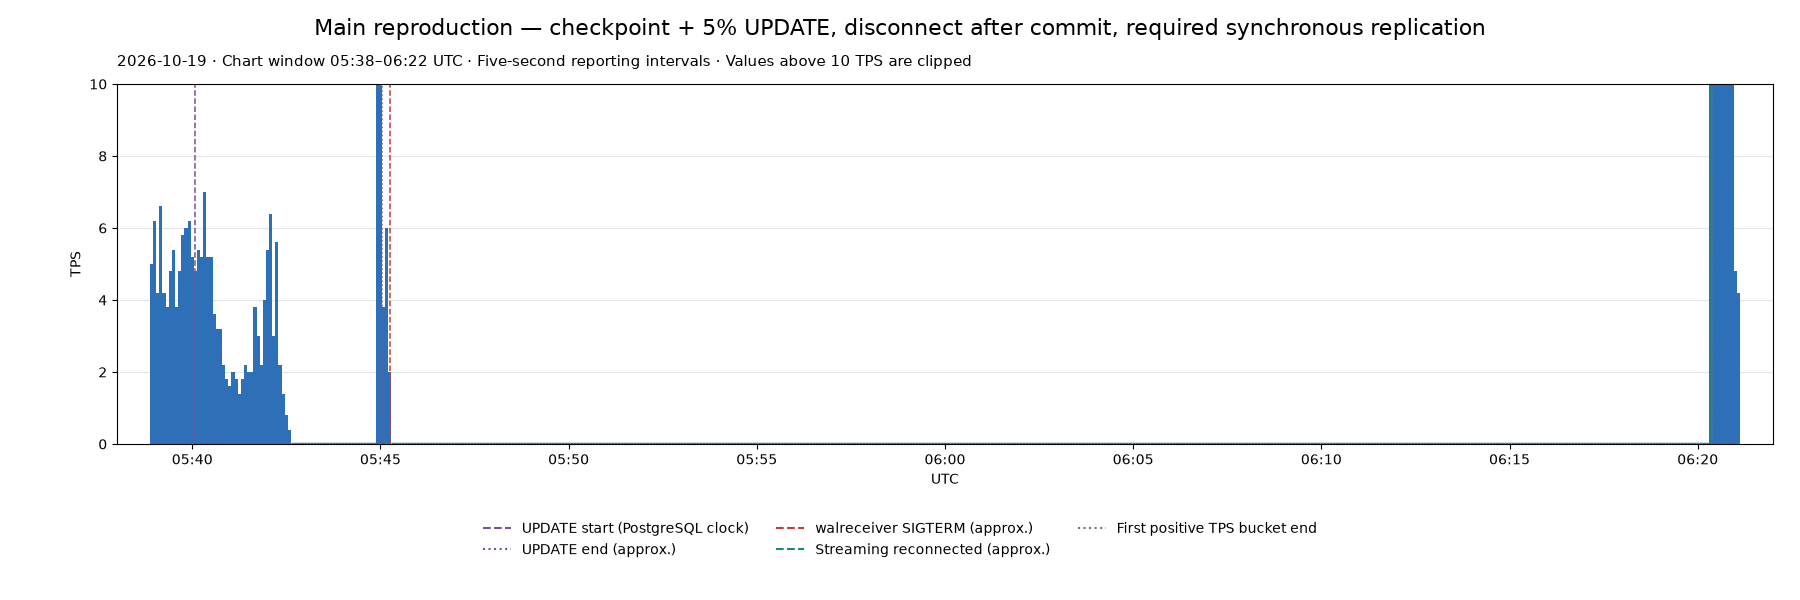
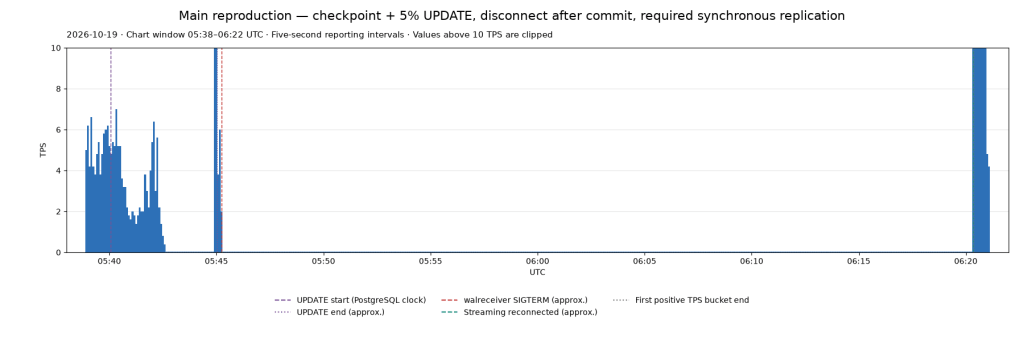
Chính sự kết hợp giữa khuếch đại IOPS đọc và thiết kế synchronous replication của PostgreSQL đã biến recovery_prefetch thành "sát thủ" gây gián đoạn. Tác giả phân tích cho biết việc tái hiện lỗi này khá dễ dàng khi đã nắm được các bước — anh đã công bố một repo GitHub để tái hiện sự cố một cách nhất quán.
Công thức gây sự cố đơn giản là "đủ xui": một sự cố mạng làm gián đoạn streaming replication đúng lúc diễn ra đợt ghi dữ liệu lớn. Bản thân lệnh VACUUM cũng có thể tạo ra hoạt động ghi đủ mạnh để kích hoạt tình huống này.
Cơ chế treo hệ thống nằm ở hai điểm cốt lõi:
- Synchronous replication: Hệ thống phụ thuộc vào ít nhất một standby khỏe mạnh, nếu không sẽ không thể nhận ghi. Mục tiêu là đảm bảo mọi giao dịch đã nằm trên máy khác trước khi commit.
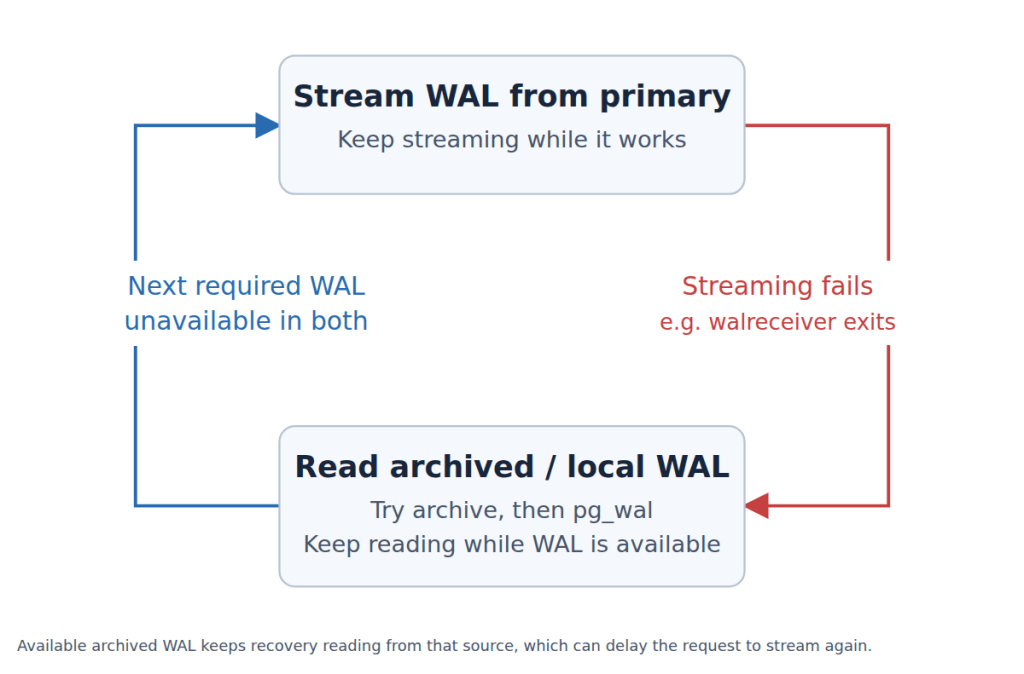
- Máy trạng thái của standby: Khi một standby chuyển sang chế độ khôi phục WAL, nó sẽ không quay lại streaming cho đến khi bắt kịp hoàn toàn. Mã nguồn liên quan nằm trong
src/backend/access/transam/xlogrecovery.c.
Khi một đợt ghi lớn kết hợp với khuếch đại IOPS khiến tất cả replica tụt lại nghiêm trọng, database có thể mất hàng giờ mới bắt đầu streaming trở lại. Trong suốt thời gian đó, primary bị chặn hoàn toàn khả năng ghi.
Bức tranh số liệu rất rõ ràng
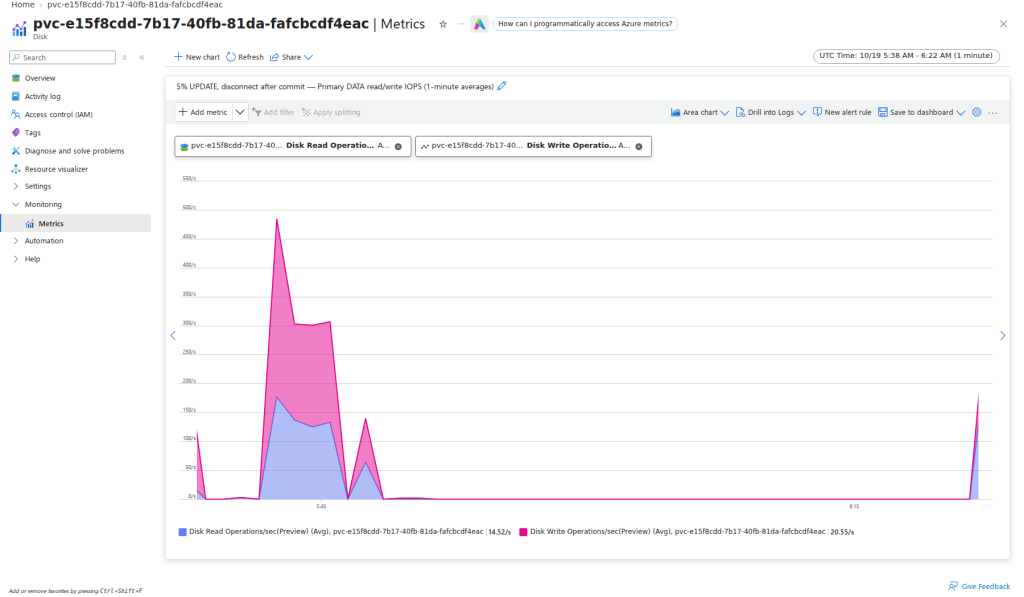
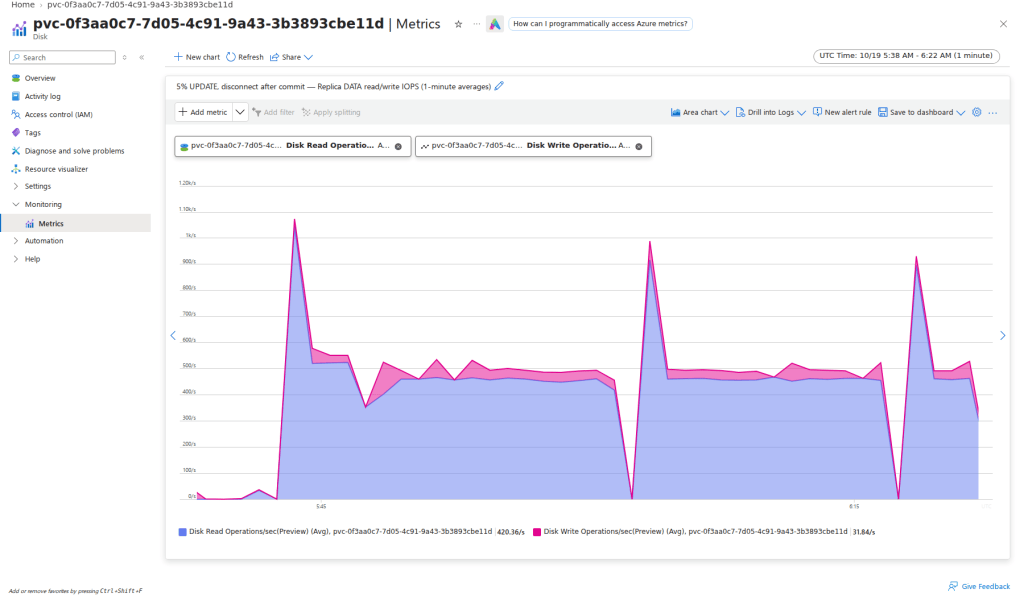
Các biểu đồ đo đạc cho thấy sự khác biệt chóng mặt: trong khi primary chỉ chạy quanh mức khoảng 300 IOPS, bản replica/standby bị đẩy lên sát giới hạn 500 IOPS trong suốt 40 phút. Điều đáng chú ý là số byte thực tế đọc từ đĩa ở cả hai bên gần như tương đương — vấn đề hoàn toàn nằm ở cách chia nhỏ thao tác đọc.
 Thống kê đĩa của primary quanh mức 300 IOPS
 Thống kê đĩa của replica chạm giới hạn 500 IOPS
Khi tắt recovery_prefetch (trong khi vẫn giữ FPW bật), kết quả thay đổi rõ rệt: vẫn có khoảng dừng trong lúc UPDATE, nhưng không còn tình trạng dừng dài sau khi UPDATE kết thúc. Không có đợt bùng nổ IOPS đọc, và standby gần như bắt kịp ngay — áp dụng xong đợt cập nhật 5% trong chưa đầy 10 phút.
Bài học cho người vận hành Postgres
Tác giả đang nghiêng về phương án tắt recovery_prefetch trên toàn bộ hệ thống, nhưng vẫn chờ hướng thảo luận từ cộng đồng. Anh cho rằng lợi ích của tham số này khá mơ hồ khi FPW vốn được bật mặc định.
Kết nối giữa WAL sender và WAL receiver trong synchronous replication là cực kỳ quan trọng — primary không thể nhận ghi nếu thiếu nó. Nhưng nó cũng rất mong manh: nếu kết nối biến mất, primary chỉ có thể ngồi chờ và chặn toàn bộ ghi, hy vọng một standby sẽ kết nối lại sớm.
Từ đó, tác giả gợi ý nên cân nhắc dùng hai standby kết hợp quorum commit (ANY 1). Dù chi phí vận hành tăng lên vì phải chạy ba replica thay vì hai, độ bền vững của database được cải thiện đáng kể.
Một trường hợp liên quan khác cũng được chia sẻ nhân dịp này, trên PostgreSQL 18.x: sau khi khởi động lại hệ điều hành, standby không bao giờ khởi động lại walreceiver vì với recovery_min_apply_delay = '7d', mọi dữ liệu cần thiết đã có sẵn trong pg_wal cục bộ. Trong khi đó, pg_wal trên primary tiếp tục phình to do bị replication slot giữ lại. Không có cách nào buộc walreceiver khởi động ngoài việc chờ đợi.
 Sơ đồ các tiến trình trong logic restore và replay của standby
Lời khuyên cho các đội vận hành tại Việt Nam
Với các doanh nghiệp Việt Nam đang chạy PostgreSQL trên hạ tầng cloud hoặc Kubernetes với synchronous replication, đây là lúc nên rà soát lại cấu hình:
- Kiểm tra xem recovery_prefetch có đang được bật không và đo lường IOPS thực tế trên các replica trong những đợt ghi lớn.
- Cân nhắc tắt recovery_prefetch nếu hệ thống đã bật FPW — đây là khuyến nghị đang được tác giả ủng hộ.
- Đánh giá lại kiến trúc replication, đặc biệt là số lượng standby và cơ chế quorum commit.
- Theo dõi sát các tham số liên quan đến phục hồi có độ trễ như
recovery_min_apply_delay, vì chúng có thể gây ra những hành vi bất ngờ đúng vào thời điểm nhạy cảm nhất.
Câu chuyện này là lời nhắc nhở quen thuộc trong thế giới vận hành cơ sở dữ liệu: những tham số tưởng như vô hại, được bật để "tăng hiệu năng", đôi khi lại chính là mắt xích yếu nhất trong chuỗi tin cậy của hệ thống.