
Stacking có thực sự đánh bại mô hình tốt nhất của bạn?
Stacking chỉ phát huy tác dụng khi các mô hình cơ sở mắc những lỗi khác nhau. Khi các mô hình tương quan cao, lợi ích gần như biến mất trong khi chi phí huấn luyện tăng vọt. Đáng chú ý hơn, bình chọn đơn giản (voting) có thể còn kém hơn cả mô hình đơn lẻ tốt nhất.
Stacking có thực sự đánh bại mô hình tốt nhất của bạn?
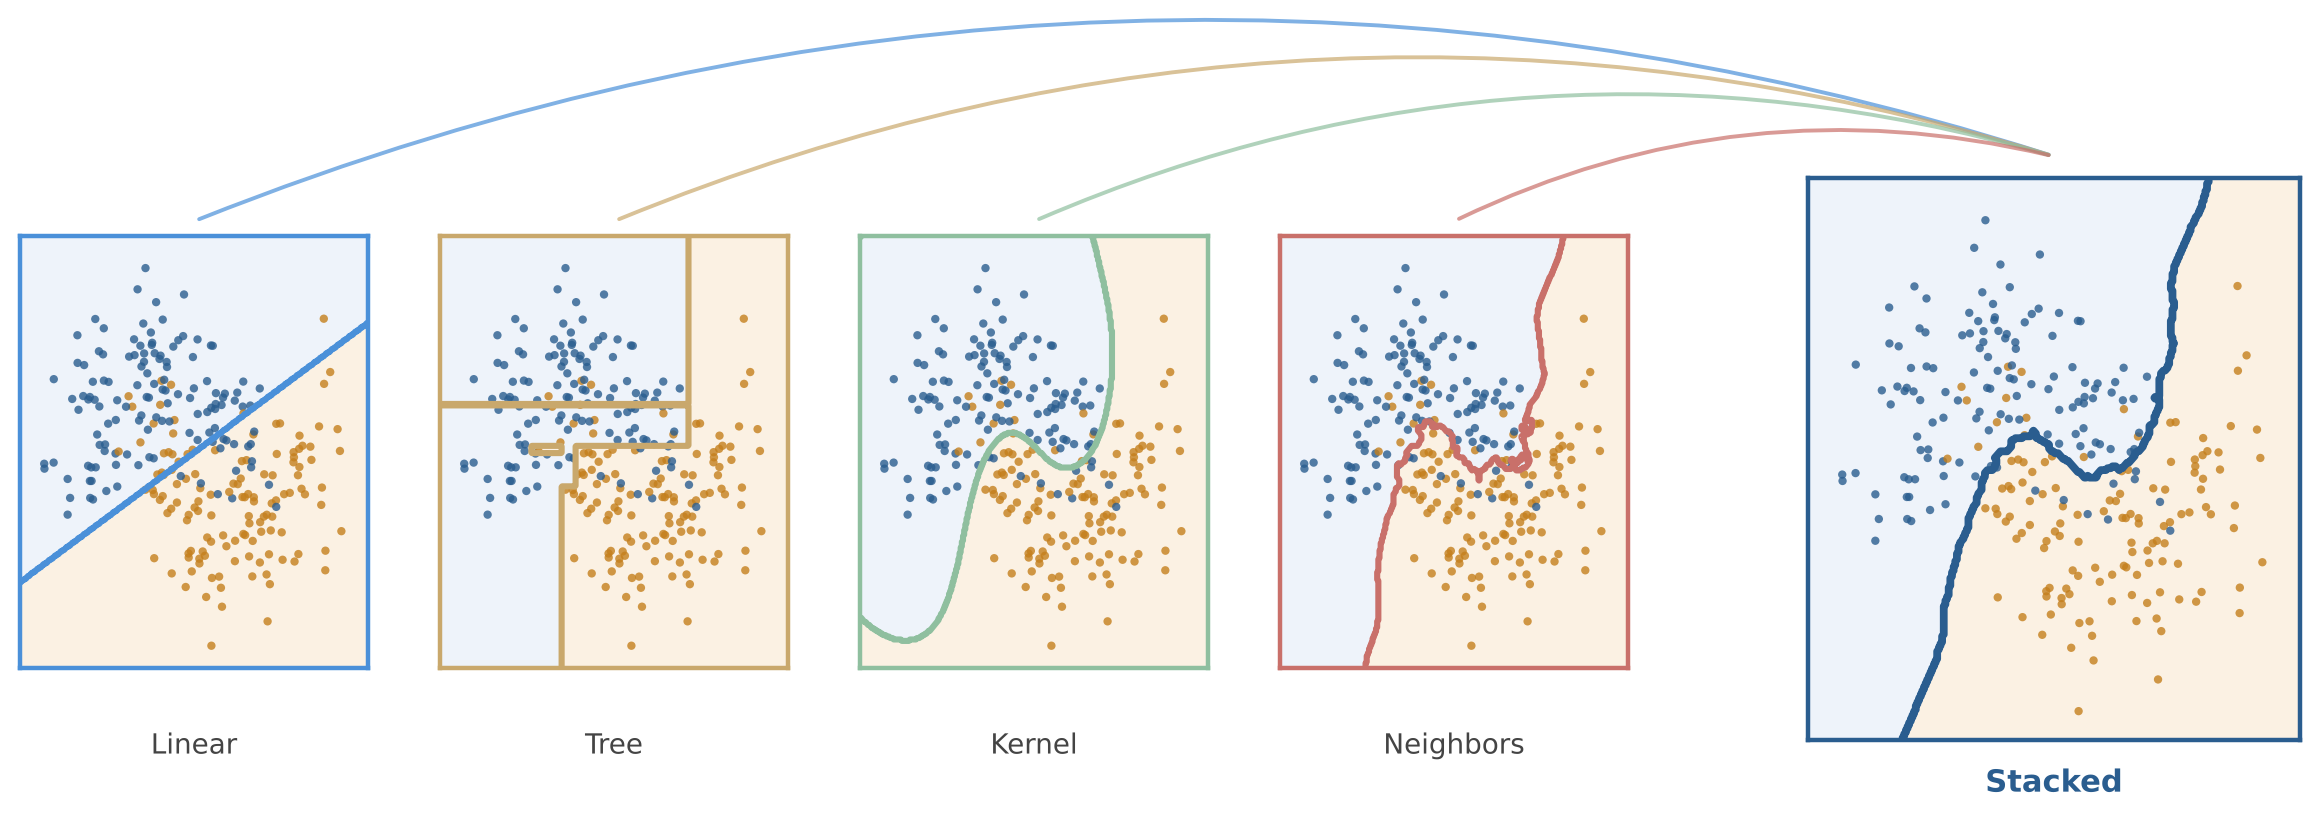
Trong cộng đồng học máy, việc kết hợp nhiều mô hình (ensemble) gần như đã trở thành một tín điều: xếp chồng một vài mô hình, đưa dự đoán của chúng vào một meta-model để học cách kết hợp, và bạn thường sẽ vượt qua bất kỳ mô hình đơn lẻ nào trong nhóm. Nhưng cơ chế đằng sau điều này cụ thể hơn nhiều so với những gì người ta thường nghĩ.
 Minh họa mô hình học máy và ensemble
Cơ sở lý thuyết của stacking
Stacking hoạt động dựa trên một nguyên lý rất rõ ràng: nó phát huy tác dụng khi các mô hình cơ sở mắc những loại lỗi khác nhau. Nếu mô hình A làm đúng những gì mô hình B làm sai, meta-model có thể học cách tin tưởng mỗi mô hình ở nơi chúng thực sự đáng tin.
Ngược lại, nếu tất cả các mô hình cơ sở đều mắc cùng một loại lỗi, sẽ không có gì bổ trợ để kết hợp, và stacking gần như không mang lại lợi ích gì.
Đây là một tuyên bố có thể kiểm chứng và có thể bác bỏ — không chỉ là "stacking thì tốt", mà cụ thể hơn: lợi ích của stacking tỉ lệ thuận với mức độ khác biệt trong cách các mô hình cơ sở mắc lỗi.
Thiết lập thí nghiệm
Tác giả đã xây dựng hai điều kiện trên cùng một bộ dữ liệu: một điều kiện được thiết kế để stacking có không gian phát huy, và một điều kiện được thiết kế để triệt tiêu không gian đó.
Bộ dữ liệu: Bài toán phân loại nhị phân tổng hợp (2.000 mẫu, 20 đặc trưng, có nhiễu và chồng lấn lớp thực tế). Dữ liệu tổng hợp được chọn để có thể kiểm soát trực tiếp mức độ đa dạng của các mô hình cơ sở.
Phương pháp đánh giá: Cross-validation phân tầng 5-fold lặp lại 3 lần (tổng cộng 15 fold), thay vì chia train/test một lần — đây là cách khắc phục hạn chế của các benchmark trước đó khi con số từ một lần chia có thể dao động quá mức.
Điều kiện 1 — các mô hình cơ sở đa dạng (đúng theo lý thuyết stacking):
- Hồi quy logistic (tuyến tính)
- Cây quyết định (chia theo trục)
- SVM (dựa trên kernel, ranh giới quyết định hoàn toàn khác)
- K-nearest-neighbors (dựa trên instance, không có ranh giới tường minh)
Điều kiện 2 — các mô hình cơ sở tương quan cao (đi ngược lại lý thuyết stacking):
- Random forest
- Gradient boosting
- Extra-trees
Ba biến thể này đều dựa trên cùng một ý tưởng nền tảng (ensemble cây), nên có xu hướng đồng thuận với nhau cao hơn nhiều so với nhóm đa dạng.
Kết quả thực tế
| Điều kiện | Mô hình đơn tốt nhất | Voting ensemble | Stacking ensemble |
|---|---|---|---|
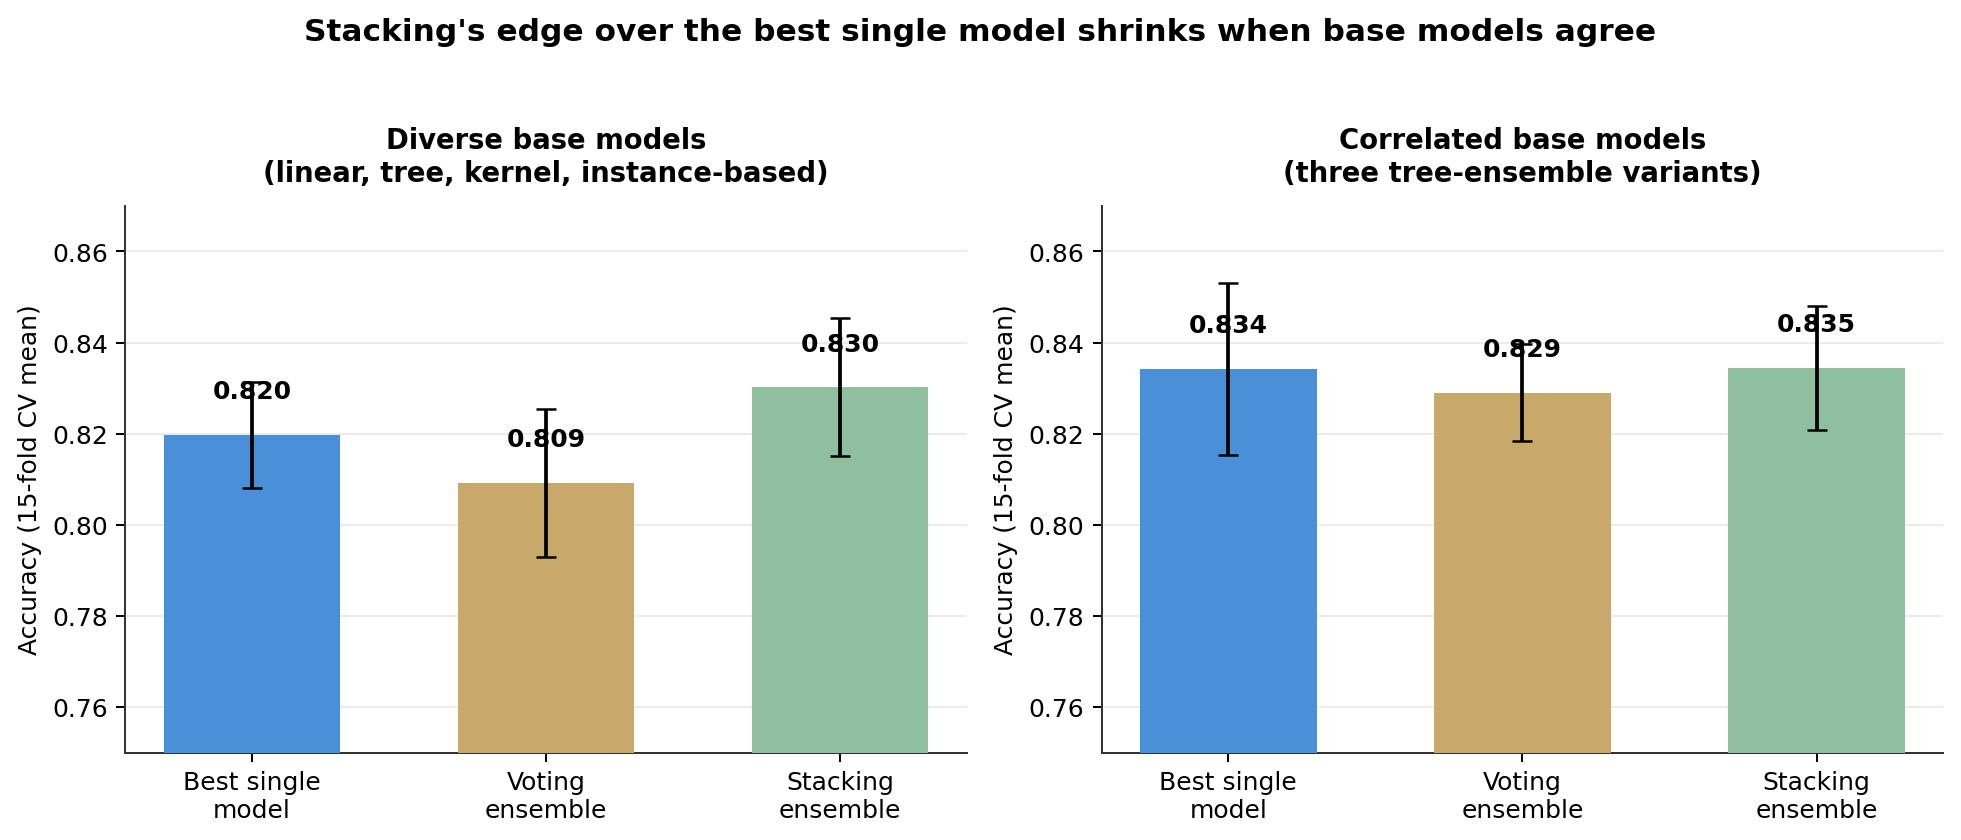
| Cơ sở đa dạng | 0.820 (SVC) | 0.809 | 0.830 |
| Cơ sở tương quan | 0.834 (ExtraTrees) | 0.829 | 0.835 |
Trong điều kiện đa dạng, stacking đã chứng minh được giá trị: 0.830 so với 0.820 của mô hình đơn tốt nhất — một khoảng cách thực sự có ý nghĩa khi sai số chuẩn (±0.015 và ±0.012) hầu như không chồng lấn.
Trong điều kiện tương quan, lợi thế của stacking gần như biến mất: 0.835 so với 0.834 — chênh lệch 0.1 điểm hoàn toàn bị nuốt chửng bởi độ lệch chuẩn (±0.014 và ±0.019). Đây chính là dự đoán của lý thuyết được xác nhận trực tiếp: không có đa dạng lỗi, không có lợi ích từ stacking.
Điều bất ngờ: voting còn thua cả mô hình đơn
Đây là kết quả ít trực giác nhất. Voting — phép lấy trung bình đơn thuần — kém hơn mô hình đơn tốt nhất trong cả hai điều kiện: 0.809 so với 0.820, và 0.829 so với 0.834.
Lý do rất cụ thể: voting lấy trung bình có trọng số bằng nhau cho mọi mô hình cơ sở. Nó không có cơ chế nào để giảm trọng số của một mô hình thực sự yếu hơn trong nhóm — nó chỉ đơn thuần lấy trung bình tất cả, kể cả mô hình đang kéo cả nhóm xuống.
Meta-model của stacking thì ngược lại: nó học được mức độ tin cậy nên dành cho mỗi mô hình cơ sở, dựa trên việc mô hình nào thực sự đáng tin trên những loại ví dụ nào. Đó chính là lý do stacking không gặp chung số phận với voting.
Chi phí — mặt còn lại của cuốn sổ
| Điều kiện | Mô hình đơn tốt nhất | Voting ensemble | Stacking ensemble |
|---|---|---|---|
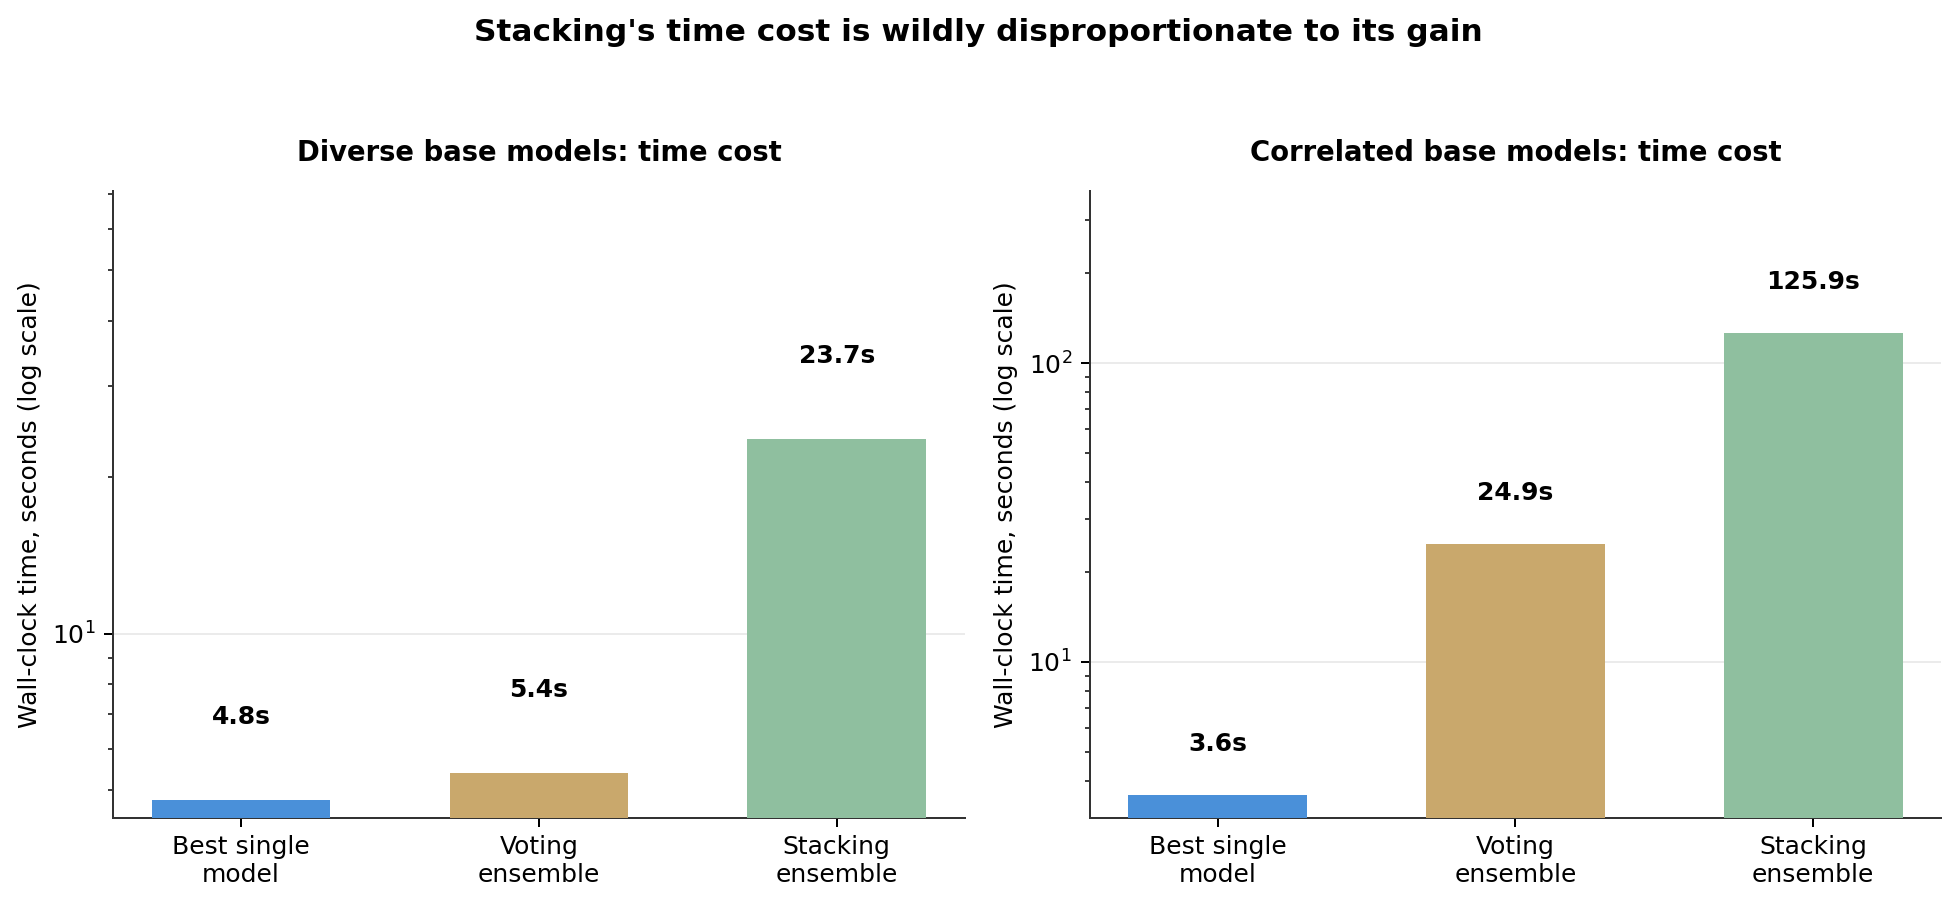
| Cơ sở đa dạng | 4.8s (SVC) | 5.4s | 23.7s |
| Cơ sở tương quan | 3.6s (ExtraTrees) | 24.9s | 125.9s |
Ở điều kiện đa dạng, 23.7 giây cho mức tăng 1 điểm chính xác là một đánh đổi hợp lý trong hầu hết bối cảnh thực tế.
Nhưng ở điều kiện tương quan, câu chuyện khác hẳn: 125.9 giây — gấp khoảng 35 lần thời gian huấn luyện của mô hình đơn — cho một chênh lệch 0.1 điểm không thể phân biệt về mặt thống kê so với 0. Trong một pipeline huấn luyện lại thường xuyên, đây là chi phí thực tế lặp đi lặp lại để đổi lấy... không gì cả.
 Biểu đồ so sánh hiệu năng và chi phí các phương pháp ensemble
Khung ra quyết định thực tế
Trước khi chọn stacking thay vì mô hình đơn tốt nhất, hãy tự hỏi ba câu:
- Các mô hình cơ sở có thực sự mắc những loại lỗi khác nhau, hay chỉ khác tên? Ba biến thể ensemble cây nghe có vẻ đa dạng nhưng thường không đa dạng theo cách thực sự quan trọng. Hãy kiểm tra tương quan giữa dự đoán (hoặc lỗi) của các mô hình cơ sở trước — chỉ một dòng code, và nó dự đoán trực tiếp stacking sẽ giúp được bao nhiêu.
- Mức tăng độ chính xác (nếu có) có lớn hơn nhiễu giữa các fold không? Một lần chia train/test sẽ vui vẻ báo cáo một "chiến thắng" của stacking mà thực chất chỉ là nhiễu. Hãy cross-validate và xem cả độ phân tán, không chỉ giá trị trung bình.
- Chi phí huấn luyện lại stack so với mô hình đơn, ở tần suất huấn luyện thực tế của bạn, là bao nhiêu? 126 giây một lần thì không đáng kể. 126 giây mỗi đêm suốt một năm, cho một lợi ích nằm trong ngưỡng nhiễu, là chi phí đáng gọi tên rõ ràng thay vì trả theo mặc định.
Kết luận
"Stacking đánh bại mô hình đơn tốt nhất" chỉ đúng trong một điều kiện cụ thể và có thể kiểm tra: sự đa dạng thực sự trong cách các mô hình cơ sở mắc lỗi.
Phát hiện thú vị và có tính ứng dụng cao hơn ở đây không phải là stacking so với mô hình đơn nói chung, mà là việc voting ngây thơ có thể còn kém hơn cả mô hình cá nhân tốt nhất của bạn, ngay cả khi stacking — dùng đúng cùng những mô hình cơ sở đó — thì không.
Kết hợp mô hình không phải là miễn phí, và lấy trung bình không đồng nghĩa với kết hợp khéo léo. Khả năng học hỏi "tin ai, khi nào" của meta-model đang làm công việc thực sự mà một phép trung bình đơn giản không thể thay thế.
Bài viết liên quan

Công nghệ
Strands Decider: Vì sao không dùng encoder? So sánh encoder và decoder trong phân loại văn bản
14 tháng 10, 2026
Công nghệ
Graphicle: Công cụ Rust hợp nhất đồ thị mã nguồn và bộ nhớ cho AI lập trình
14 tháng 10, 2026
Công nghệ
Character.ai phá sản: Khi kinh tế học của AI không còn hoạt động
14 tháng 10, 2026