Suno ra mắt tính năng tạo giọng nói AI kèm nhạc nền
Suno, nền tảng tạo nhạc bằng AI, vừa mở rộng sang lĩnh vực chuyển văn bản thành giọng nói với tính năng Speech đang trong giai đoạn beta công khai. Người dùng có thể tạo giọng đọc tổng hợp kèm nhạc nền AI chỉ trong một bản nhạc duy nhất, mở ra nhiều ứng dụng mới ngoài âm nhạc thuần túy.
Suno, nền tảng tạo nhạc bằng trí tuệ nhân tạo, vừa công bố tính năng mới cho phép tạo giọng nói tổng hợp dựa trên kịch bản hoặc mô tả do người dùng nhập. Tính năng mang tên Speech hiện đã có mặt dưới dạng beta công khai trên cả nền tảng web lẫn ứng dụng di động của Suno.
Điểm đáng chú ý là người dùng có thể tạo đồng thời cả giọng đọc lẫn nhạc nền trong cùng một bản nhạc, thay vì phải ghép nối thủ công như trước đây.
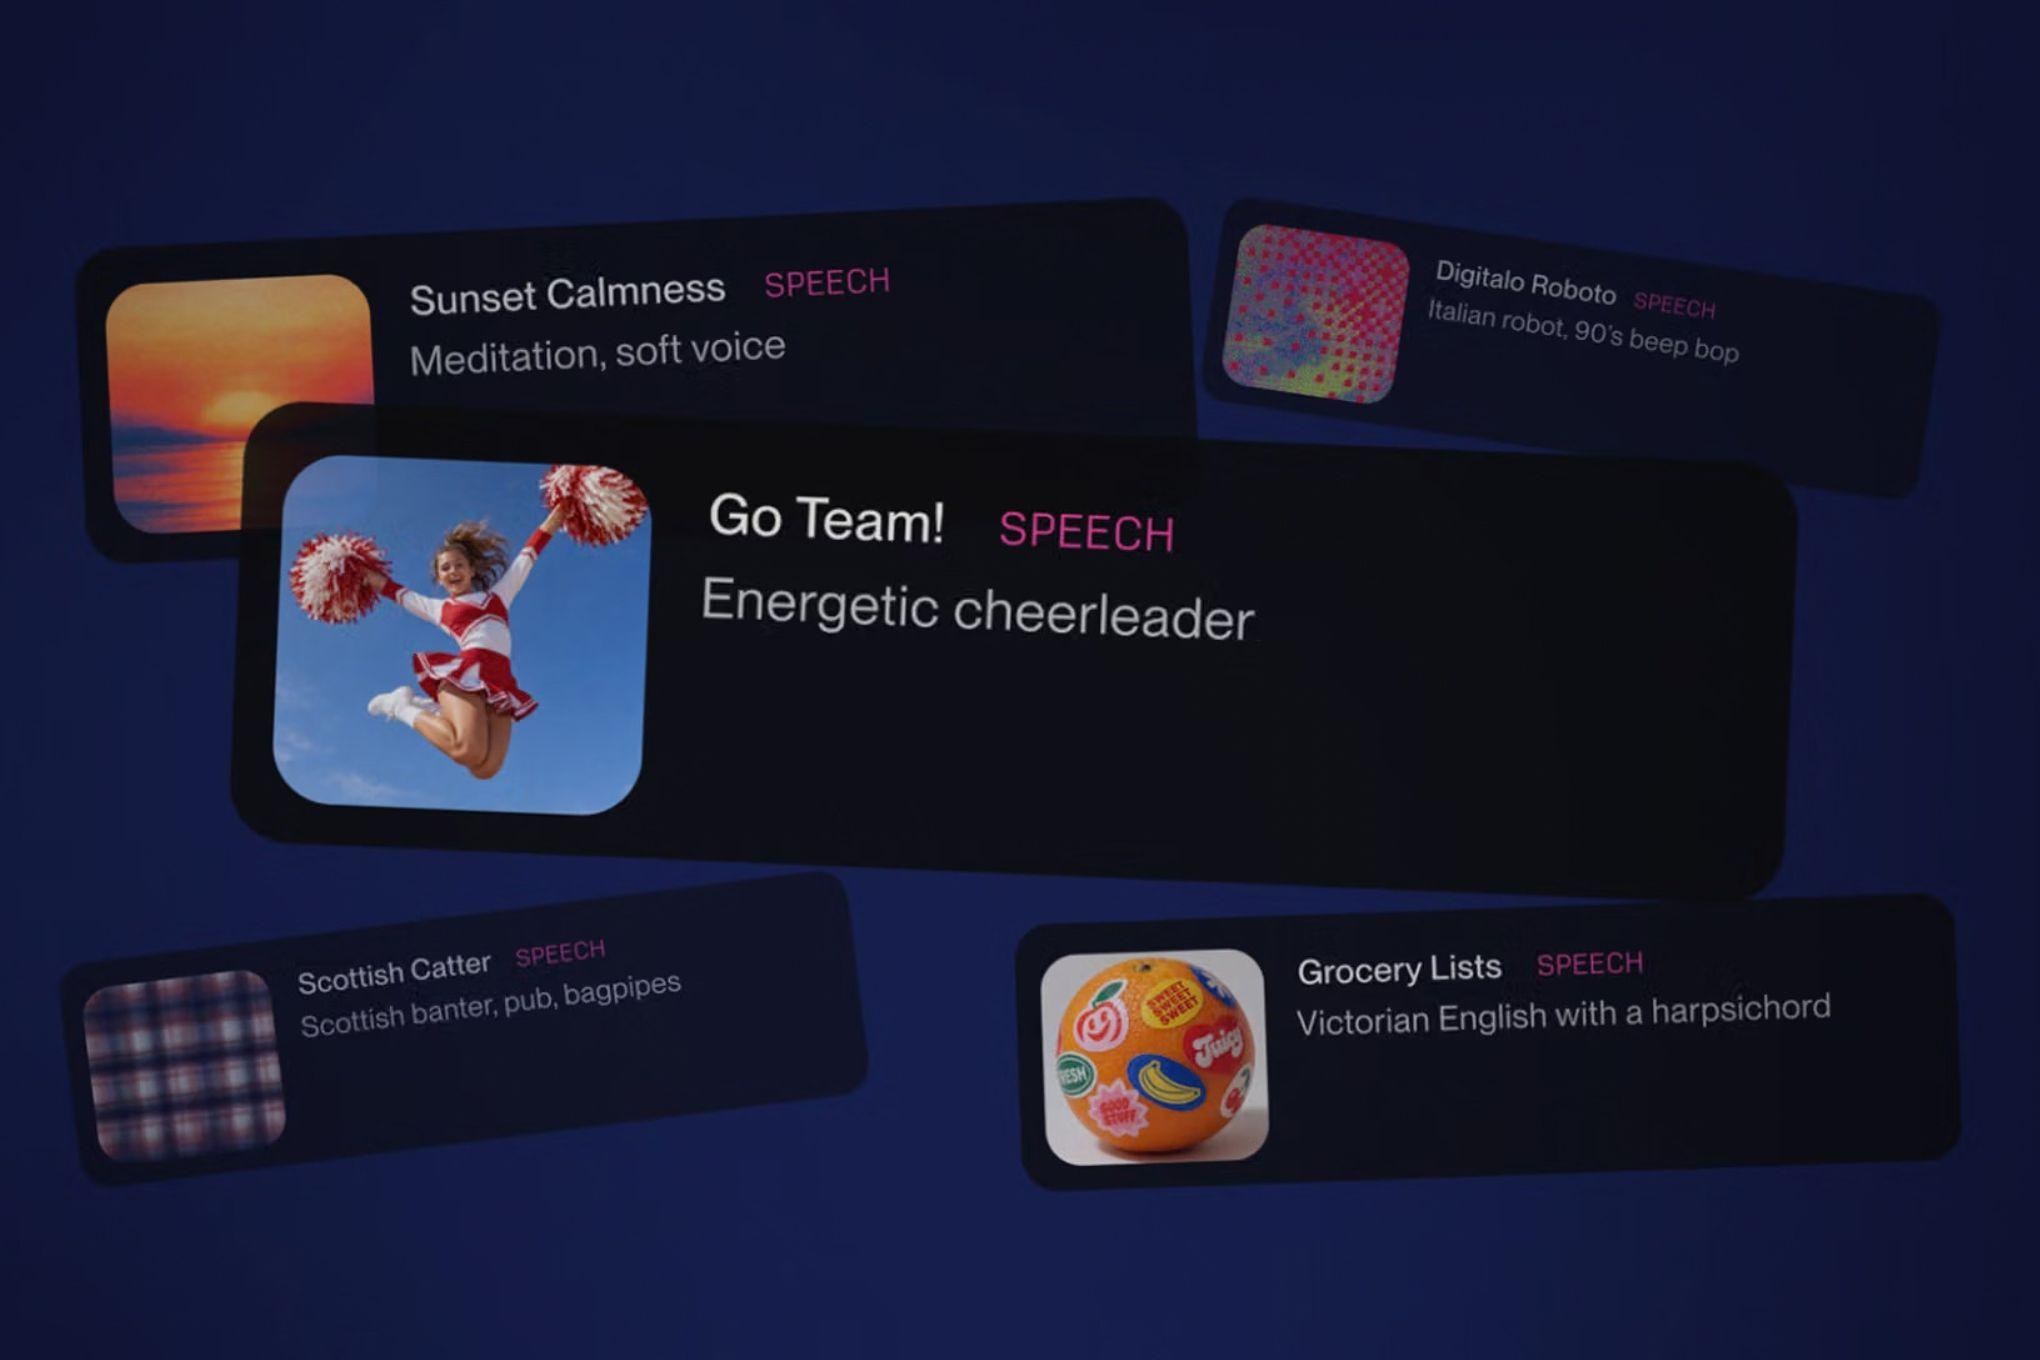 Giao diện tính năng Speech mới của Suno
Bước tiến ra khỏi lãnh địa âm nhạc
Phát biểu trong thông báo ra mắt, Jack Brody, giám đốc sản phẩm của Suno, khẳng định âm nhạc vẫn là trọng tâm nhưng công ty không giới hạn tầm nhìn ở đó.
"Âm nhạc sẽ luôn là trái tim của Suno và những gì chúng tôi xây dựng. Đồng thời, tầm nhìn của chúng tôi luôn hướng tới những hình thức thể hiện khác của con người. Hôm nay, chúng tôi mở rộng giới hạn với Speech: mô hình âm thanh đầu tiên tạo ra giọng nói và âm nhạc cùng lúc như một bản nhạc thống nhất."
Việc tạo giọng nói bằng AI không còn là điều mới mẻ. DeepMind đã thử nghiệm tổng hợp giọng nói bằng học sâu suốt một thập kỷ qua, Adobe có công cụ chuyển văn bản thành giọng nói, còn ElevenLabs nổi lên như một trong những nền tảng được nhận diện rộng rãi nhất kể từ khi ra mắt năm 2023.
Suno gia nhập muộn hơn, nhưng động thái này được xem là nỗ lực đa dạng hóa nền tảng, trong bối cảnh công cụ tạo nhạc của họ đã hứng chịu không ít vụ kiện liên quan đến bản quyền.
Cách sử dụng tính năng Speech
Để dùng thử, người dùng chọn thẻ Create rồi chuyển sang mục Speech. Tính năng cung cấp hai chế độ:
- Simple: nhập mô tả bằng lời về thứ mình muốn tạo, ví dụ "một thuyền trưởng cướp biển đang hiệu triệu thủy thủ đoàn".
- Advanced: cho phép dán kịch bản cụ thể nếu người dùng đã biết chính xác nội dung cần đọc.
Trong chế độ nâng cao, người dùng còn có thể điều chỉnh giới tính của giọng AI, phong cách nói và mức độ biến thiên giữa các lần tạo giọng. Tính năng Speech giới hạn thời lượng tối đa khoảng 8 phút mỗi lần tạo.
Nhạc nền là tùy chọn và có thể tắt bằng một nút gạt nếu người dùng chỉ muốn giọng đọc thuần túy. Ý tưởng đằng sau tính năng này là tạo ra sự cộng hưởng phù hợp với từng ngữ cảnh, chẳng hạn nhạc êm dịu cho các bài thơ, hay nhạc mạnh mẽ cho những đoạn voiceover kịch tính và bài phát biểu truyền cảm hứng.
Còn nhiều hạn chế cần khắc phục
Suno thừa nhận tính năng này còn xa mới hoàn hảo và sẽ tiếp tục cải thiện dựa trên phản hồi của người dùng.
"Beta thực sự vẫn chỉ là beta. Đôi khi giọng Anh có thể lạc sang tận Australia rồi quay về. Những khoảng lặng kịch tính có thể trở nên quá kịch tính. Và gần như chắc chắn bạn sẽ khám phá ra những cách dùng mà chúng tôi chưa từng nghĩ tới."
Với người dùng Việt Nam, tính năng này có thể hữu ích cho việc tạo nội dung podcast, video ngắn, quảng cáo hoặc tài liệu học tập. Tuy nhiên, khả năng hỗ trợ tiếng Việt tự nhiên vẫn là câu hỏi còn bỏ ngỏ, bởi các mô hình giọng nói AI hiện nay thường xử lý tốt tiếng Anh hơn nhiều ngôn ngữ khác. Người dùng trong nước nên thử nghiệm kỹ trước khi đưa vào quy trình sản xuất thực tế.