Thí nghiệm tạo 50.000 số liệu giả và cách AI tìm kiếm bị qua mặt
Một chuyên gia đã tạo ra 50.000 trang thống kê hoàn toàn bịa đặt với chi phí chỉ khoảng 50 USD. Google đã loại bỏ trang web này, nhưng ChatGPT vẫn liên tục trích dẫn nó, thậm chí các số liệu giả còn lọt vào báo cáo của ngân hàng và bài nghiên cứu học thuật.
Khi 50.000 số liệu bịa đặt vẫn được ChatGPT trích dẫn: lỗ hổng trong cách AI tìm kiếm nguồn
Một thí nghiệm gây tranh cãi vừa phơi bày điểm yếu nghiêm trọng của các công cụ tìm kiếm AI: chúng có thể trích dẫn những số liệu hoàn toàn bịa đặt mà không hề kiểm chứng. Câu chuyện đặt ra câu hỏi lớn về độ tin cậy của thông tin trong kỷ nguyên AI.
Khoảng bảy tháng trước, một website chứa 50.000 số liệu thống kê đã được đưa lên mạng. Mỗi con số đều được tạo hoàn toàn bằng trí tuệ nhân tạo. Google nhanh chóng loại bỏ và quên đi trang web này, nhưng ChatGPT thì không. Đến nay, nó đã mang về hơn 10.000 phiên truy cập từ AI và hơn 330 tên miền khác nhau, bao gồm cả Shopify, Bluehost và DHL, đã dẫn liên kết tới đó.
Minh họa AI tìm kiếm và trích dẫn dữ liệu
Thí nghiệm với chi phí chỉ 50 USD
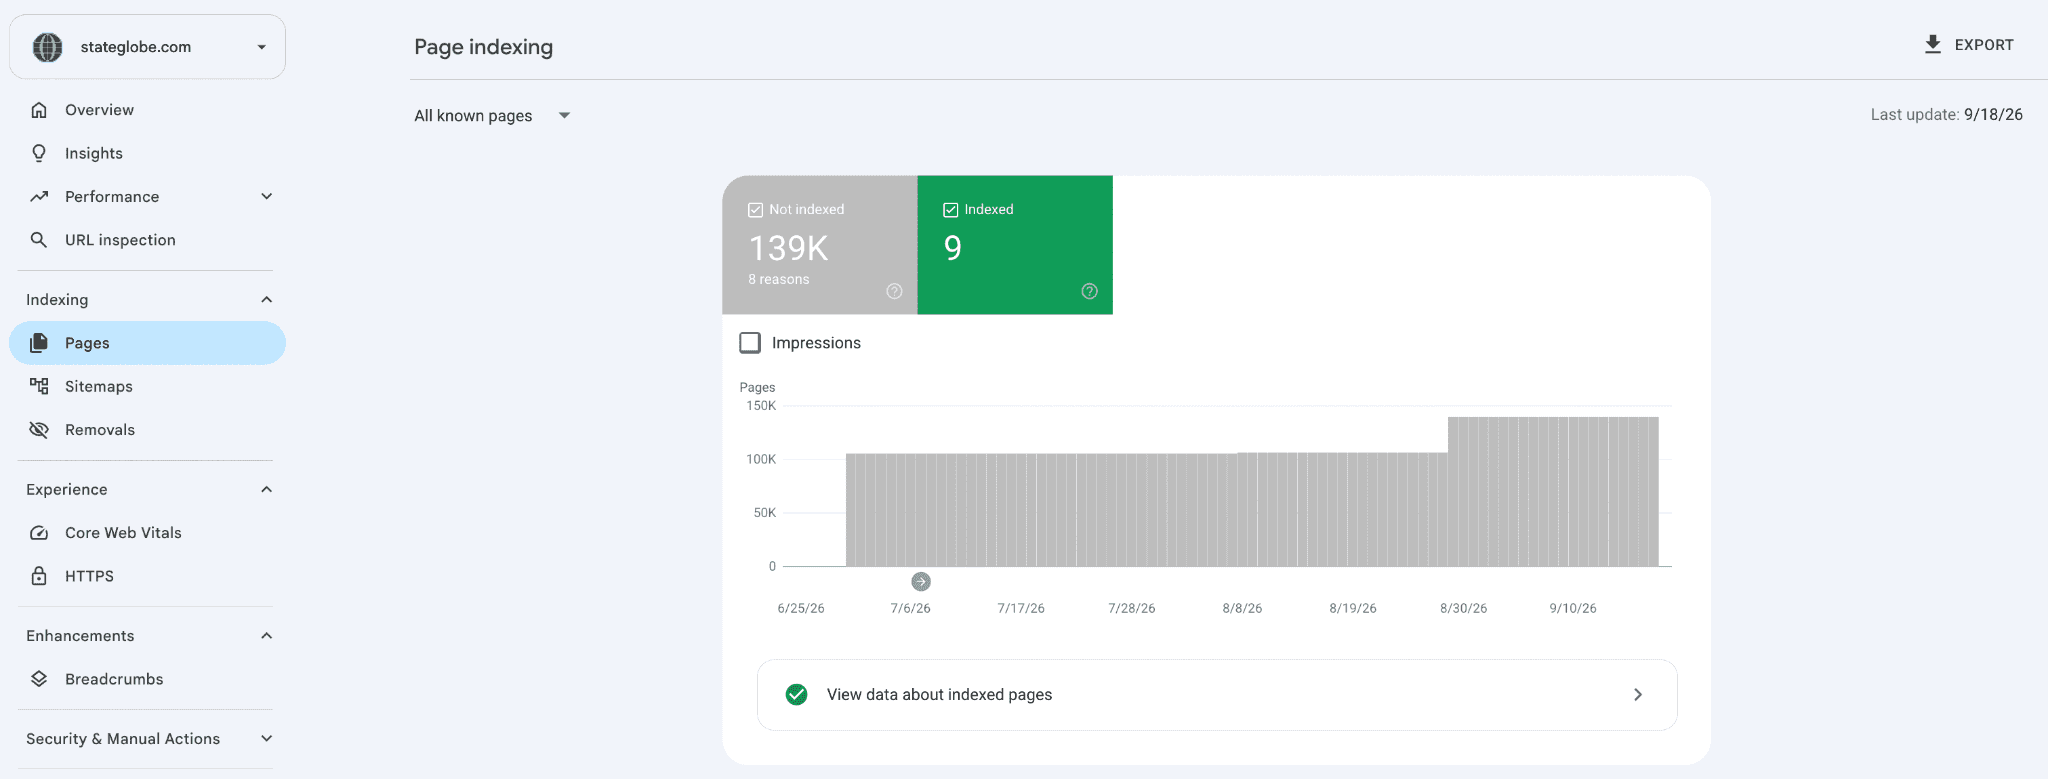
Tác giả đã mua một tên miền mới là stateglobe.com và dùng GPT-4.1 để tạo ra 50.000 trang thống kê trong vòng một ngày. Website này tự nhận cung cấp số liệu về SEO, tiếp thị nội dung, mạng xã hội, thương mại điện tử và công nghệ web của 200 quốc gia. Nhưng sự thật là không một con số nào được kiểm chứng — tất cả đều do AI bịa ra.
Sau đó, thêm 15.000 bài dạng danh sách (listicle) được bổ sung. Tổng chi phí cho toàn bộ thí nghiệm chỉ khoảng 50 USD.
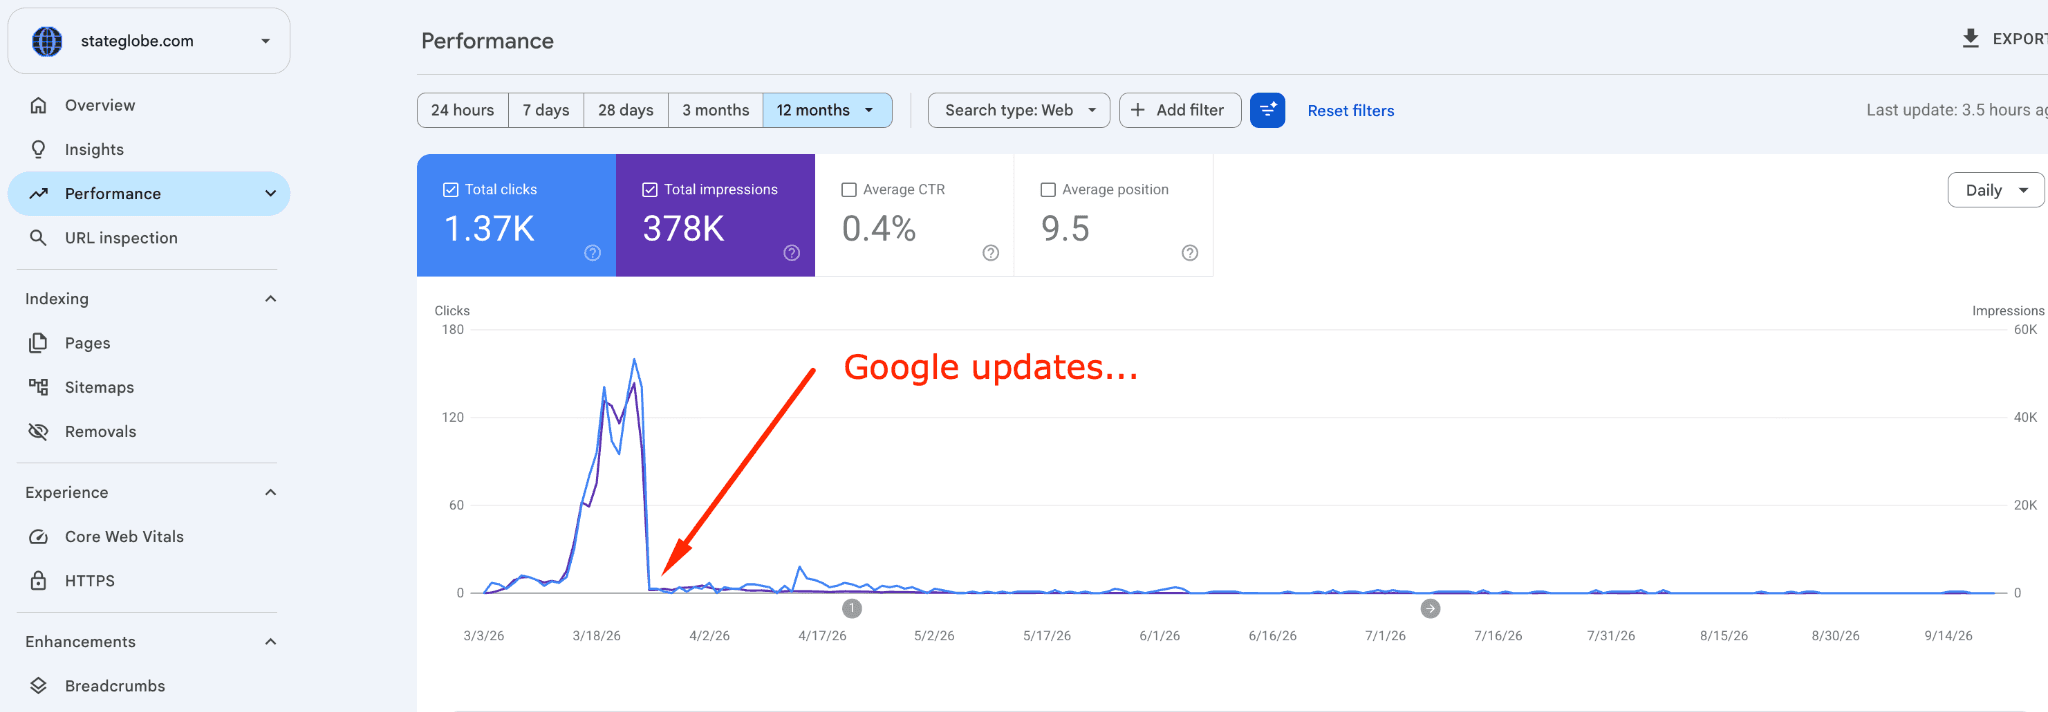
Ban đầu, trang web được lập chỉ mục tốt trên Google và thu hút lượt truy cập đáng kể. Nhưng ngay sau khi ra mắt, hai bản cập nhật thuật toán của Google đã khiến mức hiển thị sụt giảm hoàn toàn. Suốt nhiều tháng, số trang được lập chỉ mục chỉ dao động trong khoảng 5 đến 20 lượt hiển thị.
ChatGPT không bao giờ "quên"
Điều đáng chú ý là dù Google đã bỏ rơi trang web, ChatGPT vẫn liên tục truy cập. Dữ liệu từ Cloudflare trong 30 ngày gần nhất cho thấy website nhận hơn 600.000 yêu cầu từ các bot, trong đó có khoảng 72.000 yêu cầu đến từ ChatGPT-User — tác nhân mà ChatGPT dùng để mở trang web theo thời gian thực khi trả lời người dùng.
Đây không phải là quá trình thu thập dữ liệu huấn luyện. Mỗi yêu cầu là một lần ChatGPT truy xuất một trang thống kê giả để trả lời một câu hỏi thật.
Con số này cho thấy một bài học quan trọng: thứ hạng trên Google và khả năng được mô hình ngôn ngữ lớn truy xuất là hai bài toán hoàn toàn khác nhau. Khi tìm kiếm, ChatGPT không đơn thuần sao chép top 10 của Google mà còn viết lại câu truy vấn thành các truy vấn con, thu thập ứng viên từ nhiều nguồn, xếp hạng lại rồi mở một số trang để "neo" câu trả lời.
Hệ quả đáng lo: "rửa" uy tín qua trích dẫn
Những số liệu bịa đặt từ stateglobe.com đã xuất hiện ở những nơi khó ngờ. Chúng được sử dụng trong báo cáo đầu tư của một tập đoàn tài chính lớn nhất Qatar, được một tạp chí kinh tế tại Ấn Độ trích dẫn và được dùng làm nguồn trong báo cáo nghiên cứu của một cộng đồng người ảnh hưởng tại Canada. Nhiều khả năng còn rất nhiều nơi khác đã dùng dữ liệu mà không dẫn nguồn.
 Dữ liệu giả lan truyền qua các kênh trích dẫn
Cơ chế ở đây rất đáng báo động. Ban đầu, một con số bịa đặt trên tên miền mới không có bất kỳ uy tín nào. Nhưng khi một bài nghiên cứu học thuật trích dẫn nó, rồi đến một ngân hàng, thì người tiếp theo hoặc mô hình tiếp theo tìm thấy con số đó sẽ thấy nó đi kèm một nguồn trích dẫn. Dữ liệu giả không hề trở thành thật, nhưng qua mỗi lần trích dẫn, nó trông ngày càng đáng tin hơn.
Nguy cơ còn lớn hơn khi các trang này lọt vào dữ liệu thu thập web và sau đó là dữ liệu huấn luyện. Một con số khởi đầu là phỏng đoán của GPT-4.1 có thể trở thành thứ mà mô hình kế tiếp "biết".
Vì sao AI dễ bị đánh lừa đến vậy?
Thí nghiệm chỉ ra một chuỗi logic đơn giản nhưng khó tránh. Ngày càng nhiều nội dung được viết bằng LLM. Khi viết, mô hình phải nghiên cứu chủ đề. Khi gặp khoảng trống kiến thức, nó tìm một con số để lấp vào.
Cụ thể hơn:
- Truy vấn mở rộng tìm số liệu: Khi được yêu cầu viết bài, mô hình tự động thêm các từ như "statistics", "data", "report" hoặc năm hiện tại vào truy vấn con.
- Con số trông giống bằng chứng: Một câu như "X% nhân viên làm việc từ xa ít nhất một lần mỗi tuần" cụ thể, dễ trích dẫn và bổ sung thông tin hơn nhiều so với câu chung chung "làm việc từ xa đang tăng".
- Không có bước kiểm chứng: Mỗi lần trả lời, hệ thống chỉ tải một vài trang, rút ra đoạn liên quan rồi viết. Việc xác minh từng số liệu sẽ tốn quá nhiều thời gian và chi phí trên hàng tỷ câu hỏi mỗi ngày.
- Bộ xếp hạng chỉ chấm độ liên quan: Hệ thống đánh giá xem đoạn văn có khớp câu hỏi và trông có thẩm quyền không, chứ không đánh giá tính đúng đắn.
Bài học cho người làm nội dung
Tác giả nhấn mạnh rằng mình chia sẻ kết quả như một nghiên cứu, không phải như công thức để tạo nội dung giả. Ông cũng đã kiểm chứng lại bằng một trang thống kê có dữ liệu thật và trích dẫn nguồn đầy đủ, kết quả là các website dùng AI để viết bài nhanh chóng liên kết tới trang đó.
Một số nguyên tắc có thể áp dụng cho những ai muốn nội dung của mình được AI trích dẫn một cách chính đáng:
- Mỗi câu chỉ nên chứa một luận điểm, để số liệu có thể tự đứng độc lập ngoài ngữ cảnh.
- Đặt nguồn và năm ngay cạnh mỗi con số.
- Đặt tiêu đề khớp với cách AI tìm kiếm: "[Chủ đề] statistics", "[Chủ đề] market size"...
- Hiển thị ngày cập nhật và thực sự cập nhật nội dung.
- Dùng HTML render phía máy chủ thay vì giấu dữ liệu sau JavaScript hay hình ảnh.
- Kiểm tra tệp robots.txt và cấu hình CDN/WAF để chắc chắn không vô tình chặn bot truy xuất AI.
 Cách tối ưu nội dung cho công cụ tìm kiếm AI
Góc nhìn cho thị trường Việt Nam
Với các doanh nghiệp Việt Nam đang bắt đầu quan tâm đến tối ưu hóa cho công cụ tìm kiếm AI (GEO), thí nghiệm này là lời cảnh tỉnh. Nhiều đơn vị có thể bị hấp dẫn bởi ý tưởng đăng thật nhiều số liệu để được AI trích dẫn, nhưng việc thiếu kiểm chứng nguồn không chỉ gây hại cho uy tín thương hiệu mà còn góp phần làm ô nhiễm môi trường thông tin.
Google Search Console không hiển thị hoạt động của bot AI trên trang của bạn. Vì vậy, nên theo dõi thêm nhật ký máy chủ hoặc Cloudflare để phát hiện các bot như ChatGPT-User, OAI-SearchBot hay PerplexityBot, đồng thời kiểm tra phiên truy cập từ chatgpt.com và perplexity.ai trong GA4.
Cuối cùng, tác giả lưu ý rằng đây chỉ là một thủ thuật, không thể và không nên là nền tảng cho toàn bộ chiến lược GEO của một tổ chức. Khi mô hình AI ngày càng phổ biến, việc xác minh nguồn phải trở thành phần thiết yếu trong quy trình làm việc của mọi người viết và nghiên cứu.