
Thử nghiệm 4 cách cấp bộ nhớ cho trợ lý AI: Cách hiển nhiên nhất lại tốn kém nhất
Một thử nghiệm nhỏ so sánh bốn cách cấp bộ nhớ cho trợ lý AI đã hé lộ điều bất ngờ: nhồi toàn bộ lịch sử trò chuyện vào mỗi câu lệnh tốn kém gấp 20 đến 31 lần so với truy xuất, nhưng lại không làm tốt hơn. Đáng chú ý, GPT-4o mini trả lời đúng 97% câu hỏi nhưng chỉ hoàn thành 58% tác vụ khi có đầy đủ ngữ cảnh.
Thử nghiệm 4 cách cấp bộ nhớ cho trợ lý AI: Cách hiển nhiên nhất lại tốn kém nhất
Có một câu hỏi tưởng chừng đơn giản nhưng lại ám ảnh giới phát triển trợ lý AI: nếu một mô hình có thể nhắc lại một sự kiện, liệu nó có thực sự sử dụng sự kiện đó khi hành động? Một thử nghiệm nhỏ với bốn thiết kế bộ nhớ khác nhau đã cho thấy câu trả lời không hề đơn giản — và cách làm hiển nhiên nhất lại là cách tốn kém nhất mà chẳng mang lại kết quả tốt hơn.
DolphinBench và câu hỏi về bộ nhớ thực chiến
Hầu hết các bài kiểm tra bộ nhớ hiện nay chỉ hỏi trợ lý một câu về quá khứ, chẳng hạn "Sam thích quán cà phê nào?". Các tác giả của DolphinBench cho rằng cách kiểm tra này quá dễ, bởi chính câu hỏi đã gợi ý rằng cần tra cứu một sự kiện nào đó.
DolphinBench tiếp cận theo hướng khác: nó giao cho trợ lý một tác vụ cụ thể, ví dụ đặt món cà phê, rồi kiểm tra xem trợ lý có dùng đúng thông tin hay không. Benchmark này mô phỏng ba người, mỗi người có khoảng 500.000 token lịch sử trò chuyện và 200 tác vụ riêng. Mỗi tác vụ đều được kiểm tra hai chiều: trợ lý phải vượt qua khi có lịch sử liên quan và thất bại khi thiếu nó. Kết quả cũng phải báo cáo cả chi phí lẫn thời gian, không chỉ độ chính xác.
DolphinBench được công bố bởi Mem0 — một công ty bán hệ thống bộ nhớ — và trong bài công bố, cấu hình của Mem0 đứng đầu với 70,67% tác vụ hoàn thành đúng.
Điều đó đặt ra bài toán thực tế cho bất kỳ ai đang xây dựng trợ lý AI: nếu nó nhắc lại được một sự kiện, liệu nó có dùng sự kiện đó khi hành động? Và mỗi cách cấp bộ nhớ tốn bao nhiêu?
Thử nghiệm nhỏ với bốn thiết kế bộ nhớ
Để tìm câu trả lời, tác giả đã xây dựng một thử nghiệm thu nhỏ. Nhân vật chính là Dana Whitfield, một quản lý dự án hư cấu với một năm lịch sử trò chuyện, khoảng 40.000 token. Trợ lý sau đó thực hiện 30 tác vụ cần một hoặc hai sự kiện từ lịch sử đó, đồng thời trả lời 30 câu hỏi đơn giản về chính những sự kiện ấy.
Bốn thiết kế bộ nhớ được thử nghiệm:
- Không bộ nhớ: trợ lý chỉ thấy yêu cầu hiện tại.
- Toàn bộ lịch sử: nhồi cả 40.000 token vào mỗi câu lệnh.
- Tóm tắt cuộn: một mô hình đọc lịch sử theo 11 bước và liên tục viết lại một bản tóm tắt khoảng 1.000 từ.
- Truy xuất (retrieval): lịch sử được chia thành 184 đoạn khoảng 1.200 ký tự, mỗi đoạn chuyển thành một embedding; với mỗi yêu cầu, 5 đoạn gần nhất về mặt ngữ nghĩa sẽ được đưa vào câu lệnh.
 Minh họa bốn thiết kế bộ nhớ cho trợ lý AI
Hai mô hình được dùng là GPT-4o mini của OpenAI và Claude Haiku 4.5 của Anthropic. Mỗi tác vụ chạy 3 lần cho mỗi thiết kế, riêng "toàn bộ lịch sử" chỉ chạy 2 lần vì tốn kém nhất — tổng cộng 1.260 lượt chạy.
Khi trả lời giỏi không đồng nghĩa với hành động đúng
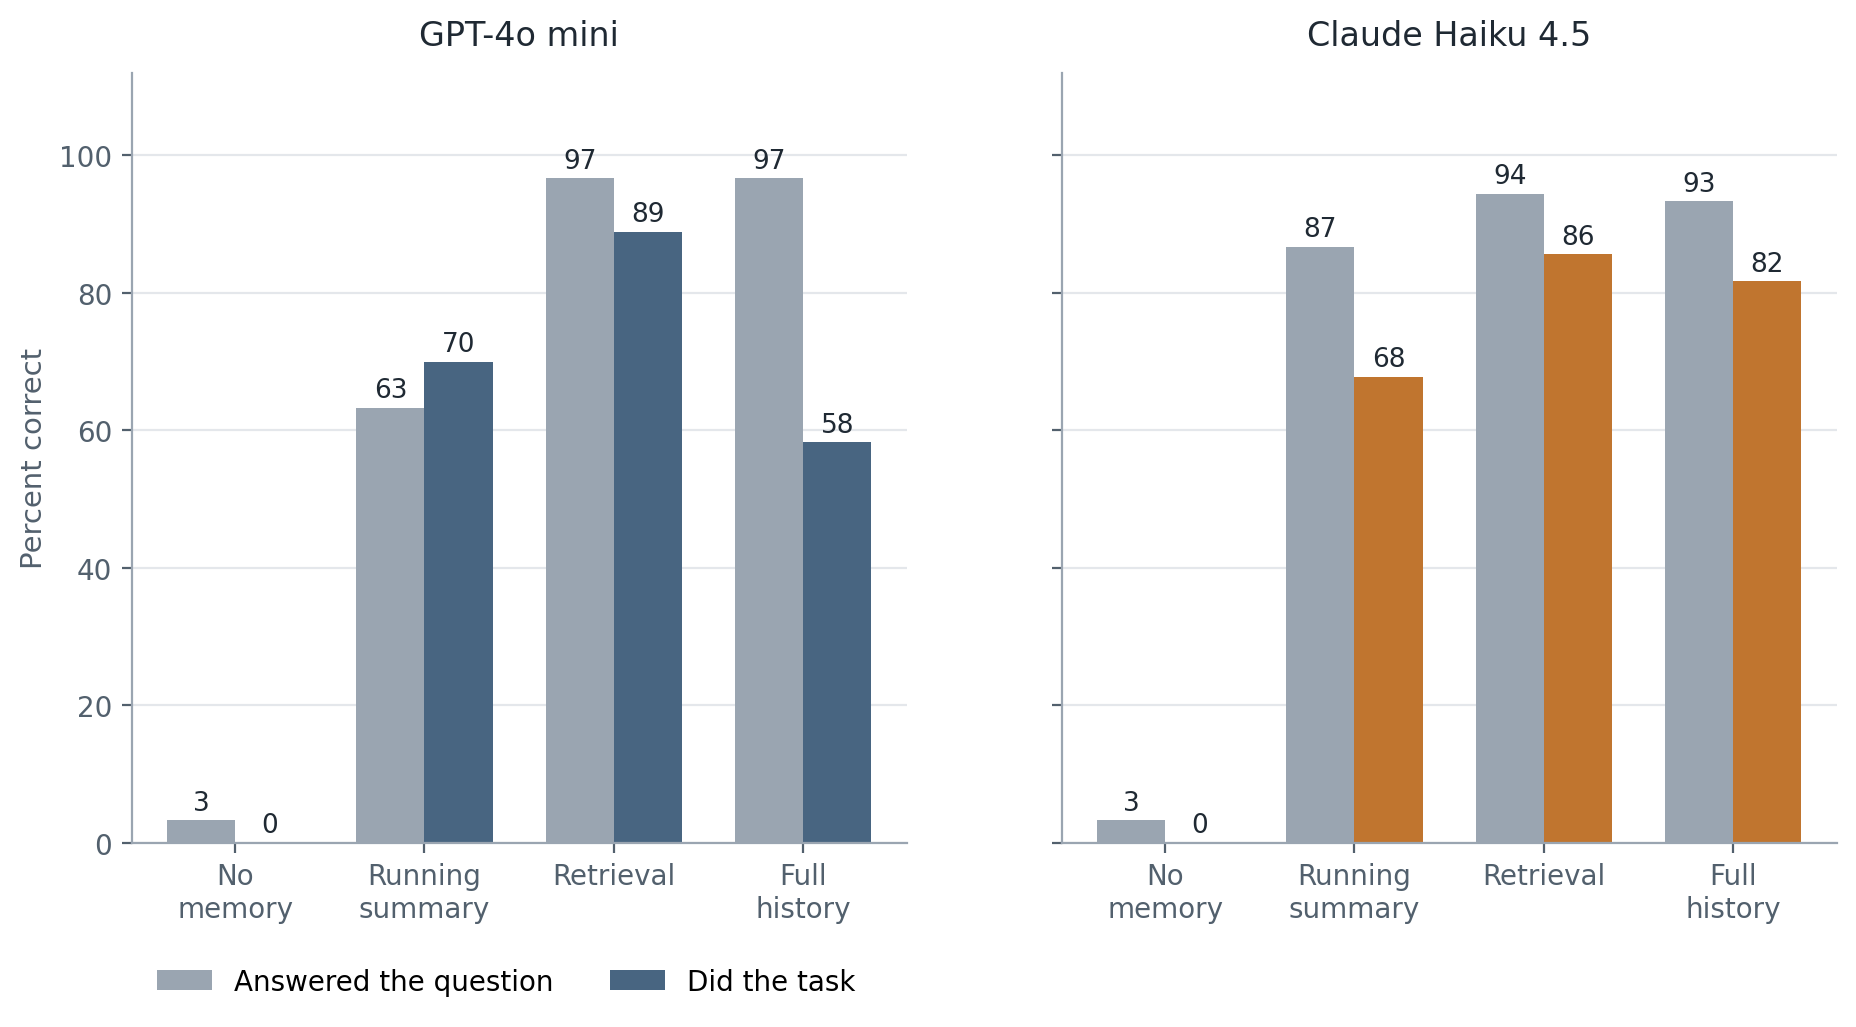
Kết quả gây bất ngờ nhất đến từ GPT-4o mini khi có toàn bộ lịch sử: mô hình trả lời đúng 97% câu hỏi nhưng chỉ hoàn thành đúng 58% tác vụ. Trong khi đó, phương pháp truy xuất rẻ hơn nhiều lại đạt 89% tác vụ.
Bảng kết quả tổng hợp cho thấy sự tách biệt rõ rệt giữa hai khả năng:
| Thiết kế bộ nhớ | Mini, tác vụ đúng | Mini, câu hỏi đúng | Haiku, tác vụ đúng | Haiku, câu hỏi đúng |
|---|---|---|---|---|
| Không bộ nhớ | 0,0% | 3,3% | 0,0% | 3,3% |
| Tóm tắt cuộn | 70,0% | 63,3% | 67,8% | 86,7% |
| Truy xuất | 88,9% | 96,7% | 85,6% | 94,4% |
| Toàn bộ lịch sử | 58,3% | 96,7% | 81,7% | 93,3% |
Khi không có bộ nhớ, không tác vụ nào vượt qua trên cả hai mô hình — nghĩa là các tác vụ thực sự cần bộ nhớ. Mini đoán bừa trong cả 90 lượt chạy và mọi phỏng đoán đều sai hoặc thiếu giá trị. Haiku thì đặt câu hỏi thay vì hành động trong 72/90 lượt, dù đã được lệnh không bao giờ được hỏi lại.
Chi phí: bài toán không nằm ở độ chính xác
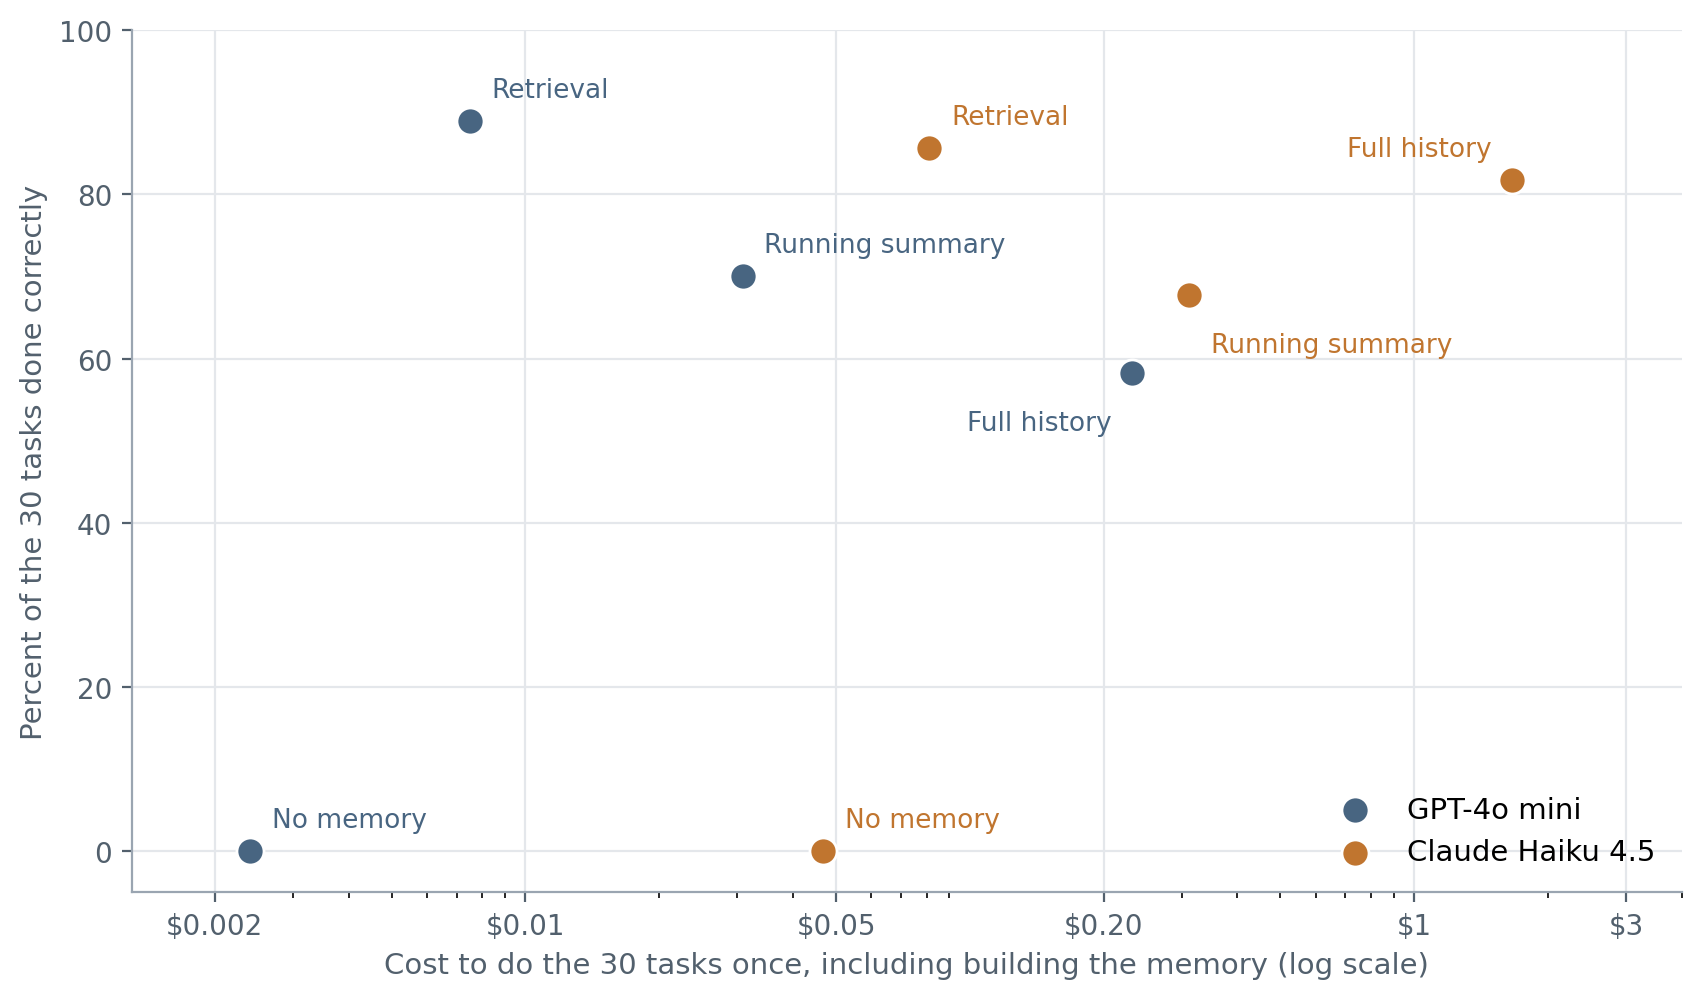
Chi phí kể một câu chuyện hoàn toàn khác. Để hoàn thành 30 tác vụ một lần, bao gồm cả chi phí xây dựng bộ nhớ:
| Thiết kế bộ nhớ | Mini, chi phí 30 tác vụ | Haiku, chi phí 30 tác vụ | Mini, giây/tác vụ | Haiku, giây/tác vụ |
|---|---|---|---|---|
| Không bộ nhớ | 0,002 USD | 0,047 USD | 1,4 | 1,5 |
| Tóm tắt cuộn | 0,031 USD | 0,311 USD | 1,3 | 1,7 |
| Truy xuất | 0,007 USD | 0,081 USD | 2,3 | 2,4 |
| Toàn bộ lịch sử | 0,232 USD | 1,661 USD | 2,1 | 2,3 |
Toàn bộ lịch sử tốn kém gấp 20 đến 31 lần so với truy xuất. Truy xuất chậm hơn một chút vì phải gọi hai lần (một lần tìm đoạn, một lần cho trợ lý). Việc gửi 40.000 token mỗi yêu cầu hầu như không làm tăng thời gian xử lý.
 So sánh tác vụ hoàn thành đúng với chi phí giữa các thiết kế
Điểm mấu chốt: truy xuất nằm ở góc trên bên trái — vừa nhanh vừa rẻ với điểm số cao — còn toàn bộ lịch sử nằm tít bên phải mà chẳng đạt điểm cao hơn.
Thất bại đến từ đâu?
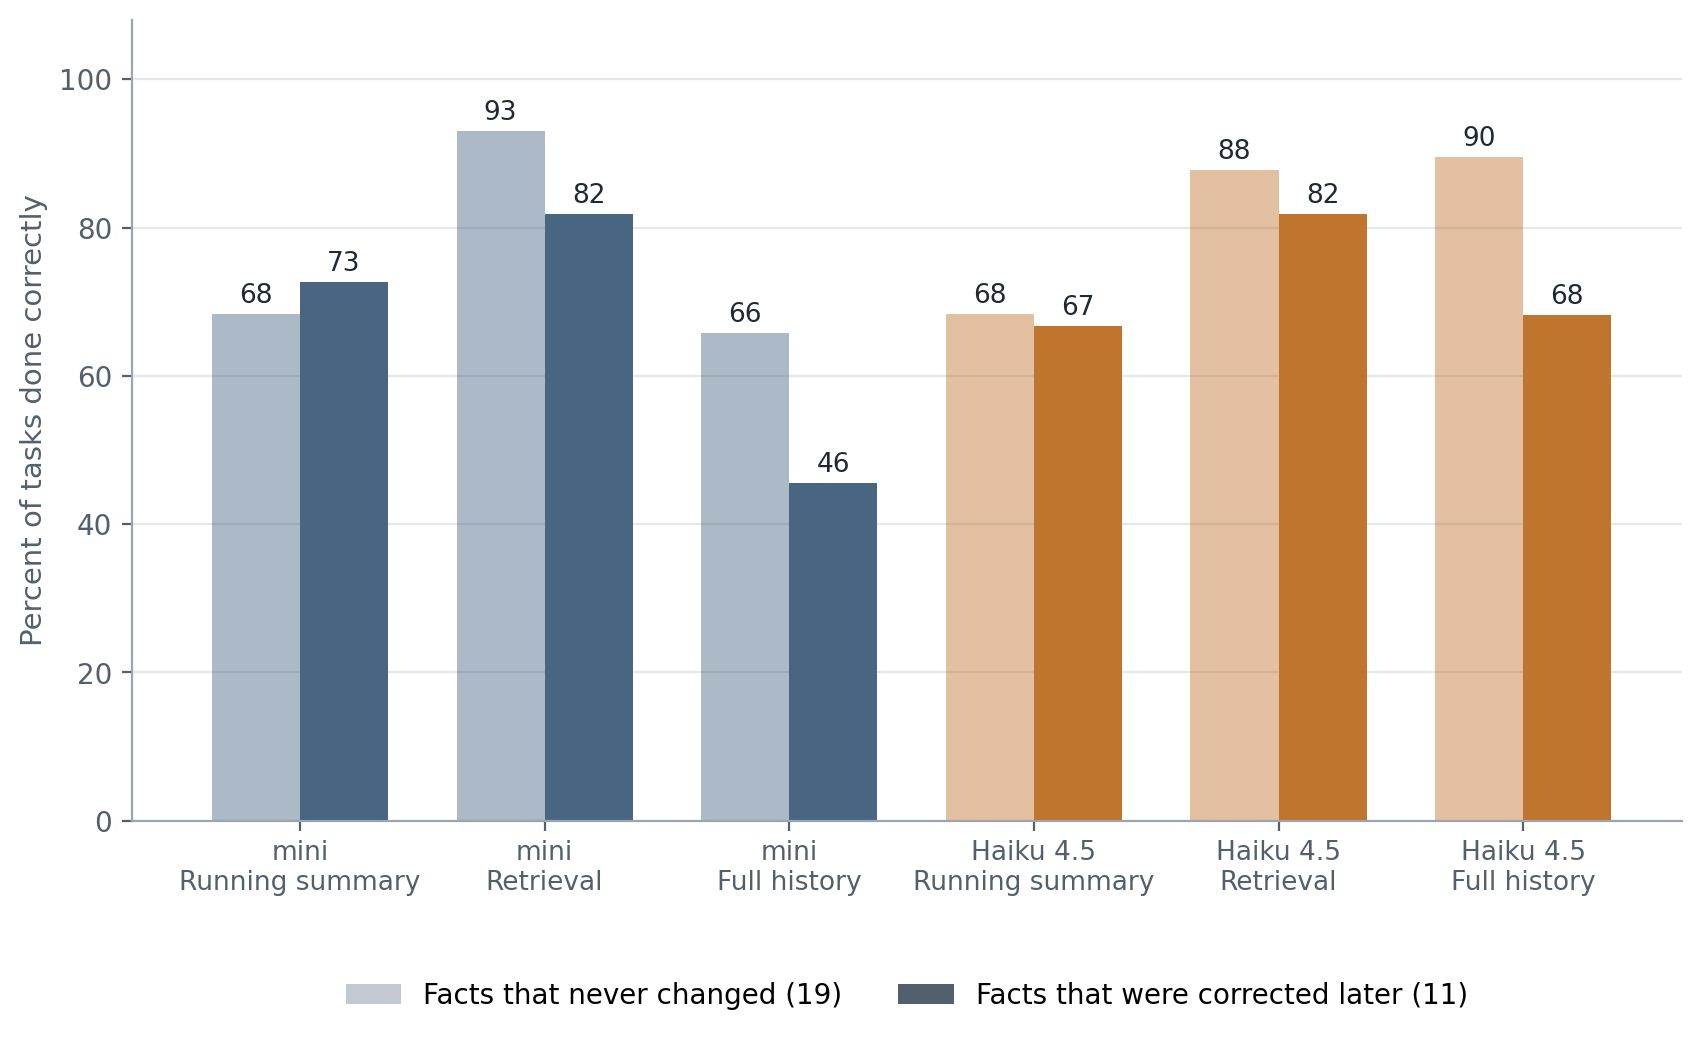
Sự khác biệt rõ nhất đến từ các thông tin bị sửa đổi. Trong 30 sự kiện, có 11 sự kiện được cập nhật sau đó — ví dụ quán ăn trưa của nhóm chuyển từ Juniper Kitchen sang Basil and Co.
Toàn bộ lịch sử lưu cả thông báo cũ lẫn mới trong câu lệnh, buộc mô hình phải tự nhận ra rằng thông tin sau thắng. Mini không phải lúc nào cũng làm được: khi được yêu cầu đặt món cho buổi workshop, nó đặt từ quán cũ trong cả hai lượt chạy. Với các sự kiện bị sửa đổi, mô hình chỉ đạt 46% so với 66% cho các sự kiện không đổi.
Tóm tắt cuộn thì thất bại theo cách khác — nó đánh rơi thông tin ngay trong lúc viết. Bản tóm tắt của mini giữ đúng giá trị mới nhất cho 20/30 sự kiện, còn Haiku giữ được 28/30. Cùng công việc đó, mini mất 122 giây và 0,019 USD, Haiku mất 250 giây và 0,19 USD.
Truy xuất chỉ thất bại khi bỏ sót đoạn. Nó lấy đủ mọi đoạn cần thiết trong 93% lượt chạy; trong số đó, mini vượt qua 95% tác vụ và Haiku đạt 92%. Ở 6 lượt mỗi mô hình bị thiếu đoạn, không có tác vụ nào vượt qua.
 Phân tích kết quả theo sự kiện không đổi và sự kiện bị sửa đổi
Bài học cho người xây dựng trợ lý AI
Từ thử nghiệm này, có vài nguyên tắc đáng lưu ý:
- Kiểm tra hành động, không chỉ câu hỏi. Mini trả lời đúng 97% câu hỏi nhưng chỉ làm đúng 58% tác vụ với cùng lượng lịch sử.
- Đừng mặc định nhiều bộ nhớ hơn là tốt hơn. Toàn bộ lịch sử tốn gấp 20 đến 31 lần mà không cho điểm cao hơn.
- Kiểm tra điều gì xảy ra sau khi có sửa đổi. Thêm một thông báo sau đó thay đổi một sự kiện, rồi xem trợ lý dùng giá trị nào.
- Đếm xem bản tóm tắt giữ được bao nhiêu sự kiện. Bản tóm tắt trong thử nghiệm làm mất 10/30 sự kiện với mini.
- Kiểm tra tác vụ trước tiên — chạy chúng không có bộ nhớ và với đúng đoạn ngữ cảnh, để biết thất bại là do bộ nhớ hay do tác vụ.
Tác giả cũng lưu ý rằng kết quả chỉ đến từ 30 tác vụ trên một nhân vật hư cấu, nên chúng cho thấy cần kiểm tra điều gì, chứ không phải cách mọi trợ lý AI sẽ hành xử.
Cách tự chạy thử nghiệm
Đoạn script kèm theo bài viết gốc chỉ cần Python 3.9 trở lên và một khóa OpenAI, không cần thư viện ngoài. Nó chứa một lịch sử nhỏ 14 tin nhắn và 6 tác vụ để bạn thay bằng dữ liệu của mình.
Quy trình gợi ý: thay lịch sử mẫu bằng vài tuần ghi chú của bạn, viết sáu yêu cầu cần một sự kiện từ đó, rồi chạy cả bốn thiết kế để so sánh số tác vụ hoàn thành với số câu hỏi trả lời đúng. Sau đó thêm một tin nhắn thay đổi một sự kiện và chạy lại.
Một câu hỏi mở dành cho bạn: khi trợ lý AI không chắc chắn, bạn muốn nó hỏi trước hay hành động rồi bị sửa? Trong thang điểm của thử nghiệm này, một câu hỏi bị tính là thất bại vì tác vụ yêu cầu hành động — và câu trả lời của bạn sẽ quyết định mức độ khắt khe đó hợp lý đến đâu.
Với những ai đang cân nhắc tích hợp bộ nhớ cho trợ lý AI trong sản phẩm, kết luận khá rõ ràng: truy xuất là điểm khởi đầu hợp lý, còn nhồi toàn bộ ngữ cảnh vào mỗi câu lệnh là lựa chọn đắt đỏ mà không tương xứng về hiệu quả.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Amazon ra mắt thiết bị đeo Bee mới: Luôn lắng nghe và có thể giúp bạn mua sắm
15 tháng 10, 2026