
Thủ thuật đọc xác suất token của LLM: Một hàm bao Jev-like cho cả mô hình thị giác
Một lập trình viên chia sẻ cách dùng logprobs để biến LLM thành công cụ phân loại nhanh chỉ với một token đầu ra, mở rộng cho cả mô hình thị giác với webcam. Thủ thuật này cho phép đặt câu hỏi trắc nghiệm và đọc trực tiếp phân phối xác suất của mô hình.
Thủ thuật đọc xác suất token của LLM: Một hàm bao Jev-like cho cả mô hình thị giác
Một lập trình viên đã chia sẻ thủ thuật thú vị khi làm việc với các mô hình ngôn ngữ lớn (LLM): thay vì yêu cầu mô hình trả lời dài dòng, ta có thể giới hạn đầu ra chỉ một token và đọc trực tiếp xác suất log của mô hình. Cách làm này biến LLM thành một công cụ phân loại cực nhanh, và đáng ngạc nhiên là nó hoạt động được cả với các mô hình thị giác.
Điểm đáng chú ý là kỹ thuật này không mới với nhiều người, nhưng vẫn còn xa lạ với phần lớn lập trình viên. Bài viết trên blog của Allan R. Bo giới thiệu cách áp dụng nó cho cả văn bản lẫn hình ảnh, kèm theo ví dụ Python hoàn chỉnh chạy webcam theo thời gian thực.
Đọc xác suất token — thủ thuật cũ nhưng hiệu quả
Ý tưởng cơ bản là viết một prompt dạng trắc nghiệm, ví dụ:
State: Đơn hàng của tôi đến bị hỏng và tôi muốn hoàn tiền. Question: Nhóm nào nên xử lý việc này? [A] thanh toán [B] vận chuyển [C] trả hàng Chỉ trả lời bằng chữ cái của lựa chọn tốt nhất.
Sau đó, thêm vài tham số JSON vào request tương thích Chat Completions:
{
  "max_completion_tokens": 1,
  "logprobs": true,
  "top_logprobs": 20
}
API sẽ trả về chữ cái được chọn kèm xác suất log của các token thay thế. Việc ép mô hình chỉ sinh một token giúp phản hồi cực nhanh, tránh câu trả lời dài dòng. Nếu backend hỗ trợ KV-cache, phần tiền tố trạng thái dùng chung giữa các câu hỏi còn được lưu lại, tiết kiệm đáng kể thời gian xử lý.
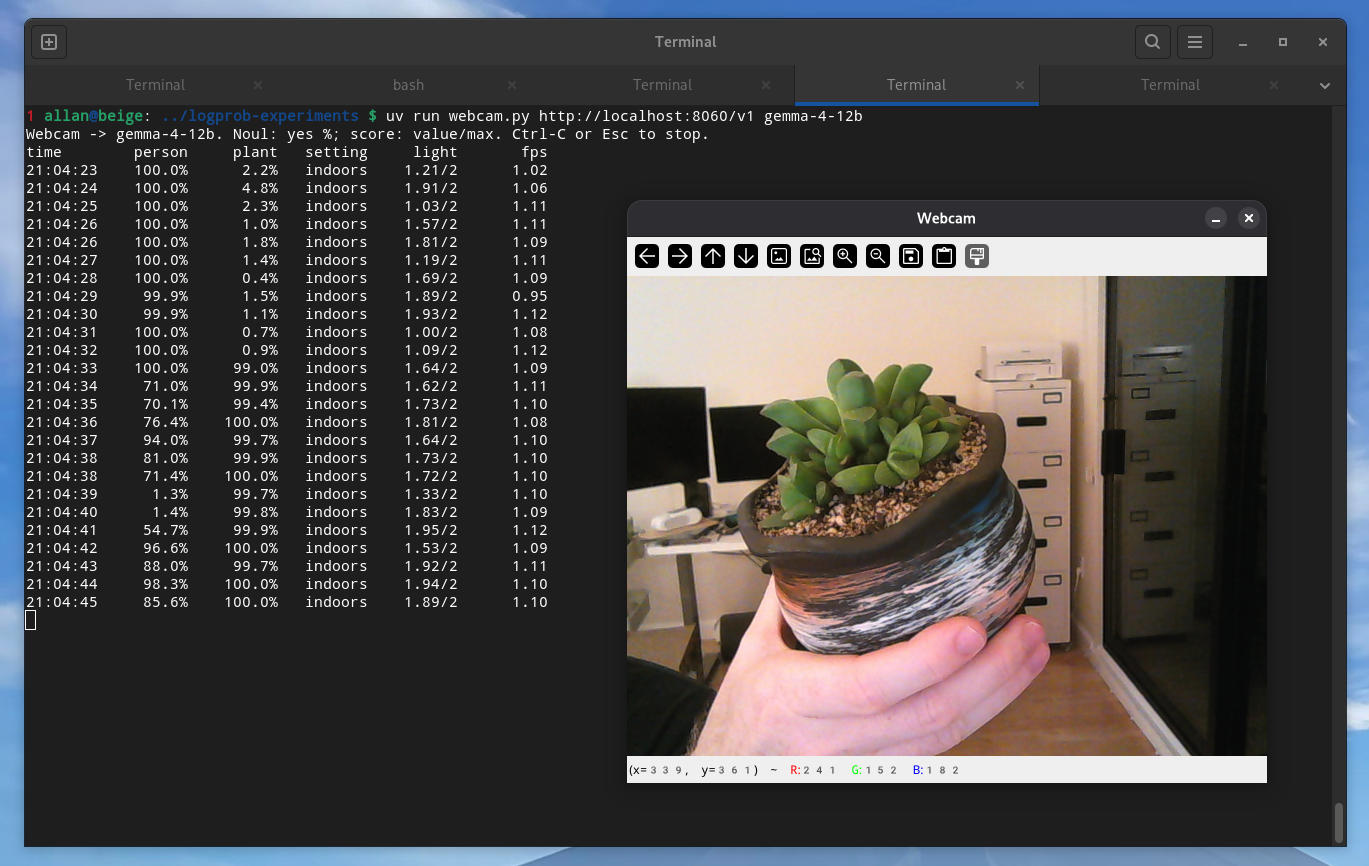 Bảng điều khiển webcam hiển thị kết quả phân loại theo thời gian thực
Mở rộng sang mô hình thị giác
Điều thú vị là thủ thuật này cũng hoạt động với mô hình thị giác. Định dạng request của Jev hiện chỉ mô tả trạng thái văn bản/JSON, nhưng tác giả đã thêm trường attachments để đính kèm hình ảnh.
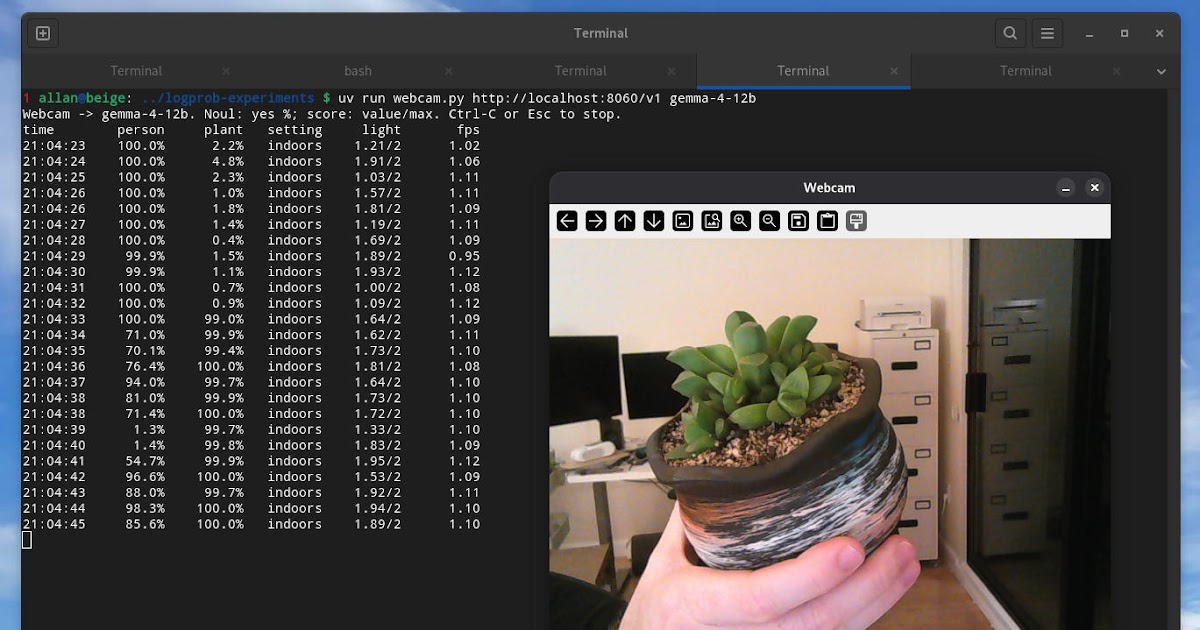
Ví dụ ông xây dựng sẽ chụp khung hình từ webcam, gửi ảnh JPEG dạng base64 và in ra bảng kết quả gồm ba câu hỏi: có người trong khung hình không, đang ở trong nhà hay ngoài trời, và cảnh sáng đến mức nào.
Với Gemma 4 12B chạy trên RTX 3090, tốc độ đạt khoảng 1 khung hình/giây với ba câu hỏi mỗi khung. Khi thử với gpt-6-luna của OpenAI, tốc độ chỉ khoảng 0,2 FPS — có thể do mỗi câu hỏi mỗi khung hình đều phải mở kết nối riêng qua hệ thống của họ.
Các mô hình thị giác chuyên dụng chắc chắn hiệu quả hơn nhiều về mặt tính toán. Nhưng ưu điểm lớn nhất ở đây là tính linh hoạt: muốn thay đổi điều kiện kiểm tra, chỉ cần mô tả lại bằng ngôn ngữ tự nhiên.
Ví dụ Python chạy webcam với llama.cpp hoặc OpenAI
Đoạn mã dưới đây dùng OpenCV chỉ để truy cập webcam cho tiện, không dùng cho xử lý thị giác thực sự:
#!/usr/bin/env -S uv run --script
# /// script
# dependencies = ["opencv-python"]
# ///
"""Xem trước và chấm điểm khung hình webcam với llama.cpp hoặc OpenAI.

uv run webcam.py
uv run webcam.py https://api.openai.com/v1 gpt-6-luna
OpenAI đọc biến môi trường OPENAI_API_KEY.
"""
import argparse
import base64
import concurrent.futures
import datetime
import json
import math
import mimetypes
import os
import pathlib
import time
import urllib.parse
import urllib.request
import cv2

# attachments là phần mở rộng tùy chỉnh của chúng ta cho định dạng Jev.
data = json.loads("""
{
  "state": "Inspect this webcam frame. Judge only what is visibly present.",
  "attachments": [],
  "questions": {
    "person": {
      "type": "noul",
      "instructions": "Is a person visible?"
    },
    "plant": {
      "type": "noul",
      "instructions": "Is a plant visible?"
    },
    "setting": {
      "type": "choice",
      "instructions": "Where is the camera?",
      "criteria": {"indoors": null, "outdoors": null, "unclear": null}
    },
    "light": {
      "type": "score",
      "instructions": "How bright is the scene?",
      "criteria": ["dark", "dim", "bright"]
    }
  }
}
""")

def score(data, url, model):
    state = data["state"]
    if not isinstance(state, str):
        state = json.dumps(state)
    images = []
    for attachment in data.get("attachments", []):
        if attachment.startswith("data:image/"):
            images.append(attachment)
            continue
        path = pathlib.Path(attachment).expanduser()
        mime_type, _ = mimetypes.guess_type(path)
        if mime_type not in {"image/png", "image/jpeg", "image/webp", "image/gif"}:
            raise ValueError(f"Unsupported image file: {path}")
        encoded = base64.b64encode(path.read_bytes()).decode()
        images.append(f"data:{mime_type};base64,{encoded}")
    ...
Script xử lý sự khác biệt giữa các API: llama.cpp dùng Chat Completions còn OpenAI dùng Responses để hiển thị các lựa chọn thay thế.
Cách chạy cục bộ với Gemma 4 12B
Trên Linux với driver NVIDIA, cần cài curl, zstd và uv:
# Mô hình (~7 GB) và bộ chiếu đa phương thức (~175 MB).
mkdir -p ~/models/gemma-4-12b/
cd ~/models/gemma-4-12b/
curl -fL -C - -o gemma-4-12b-it-qat-q4_0.gguf \
  https://huggingface.co/google/gemma-4-12B-it-qat-q4_0-gguf/resolve/main/gemma-4-12b-it-qat-q4_0.gguf
curl -fL -C - -o mmproj-gemma-4-12b-it-qat-q4_0.gguf \
  https://huggingface.co/google/gemma-4-12B-it-qat-q4_0-gguf/resolve/main/mmproj-gemma-4-12b-it-qat-q4_0.gguf

# Binary llama.cpp độc lập cho RTX 3090 (kiến trúc CUDA 86).
curl -fL -o llama.zst \
  https://huggingface.co/buckets/ggml-org/install.sh/resolve/b11160/x86_64/linux/cuda/86/llama-app.zst
mkdir -p ~/bin/
zstd -d llama.zst -o ~/bin/llama
chmod +x ~/bin/llama
~/bin/llama serve --models-dir ~/models/ --port 8060
Lưu ví dụ Python thành webcam.py. Ở terminal khác, trong cùng thư mục:
uv run webcam.py http://localhost:8060/v1 gemma-4-12b
# Hoặc dùng OpenAI, với OPENAI_API_KEY đã đặt trong biến môi trường.
uv run webcam.py https://api.openai.com/v1 gpt-6-luna
Ý nghĩa đối với lập trình viên Việt Nam
Với cộng đồng phát triển phần mềm tại Việt Nam, kỹ thuật này đặc biệt hấp dẫn vì tiết kiệm chi phí và dễ triển khai. Thay vì gọi mô hình thị giác chuyên dụng hay xây dựng pipeline phức tạp, bạn có thể tận dụng LLM sẵn có và chỉ mô tả điều kiện bằng văn bản.
Cách tiếp cận này phù hợp cho các bài toán như:
- Giám sát camera an ninh với các câu hỏi dạng "có người lạ không", "có xe đỗ không"
- Kiểm tra chất lượng sản phẩm trong dây chuyền sản xuất nhỏ
- Phân loại nhanh tài liệu, email, ticket hỗ trợ khách hàng
- Trợ lý cá nhân chạy cục bộ, không cần gửi dữ liệu lên đám mây
Nhược điểm là tốc độ còn hạn chế so với mô hình chuyên dụng, và chi phí xử lý đầu vào vẫn đáng kể vì mỗi khung hình đều phải đưa qua mô hình. Tuy nhiên, với những ai đang tìm cách khai thác LLM theo hướng sáng tạo mà không muốn phụ thuộc vào API đắt đỏ, đây là một hướng đáng thử.