Tôi dùng Gemini tự huấn luyện mô hình thay thế nó với chi phí 9 USD
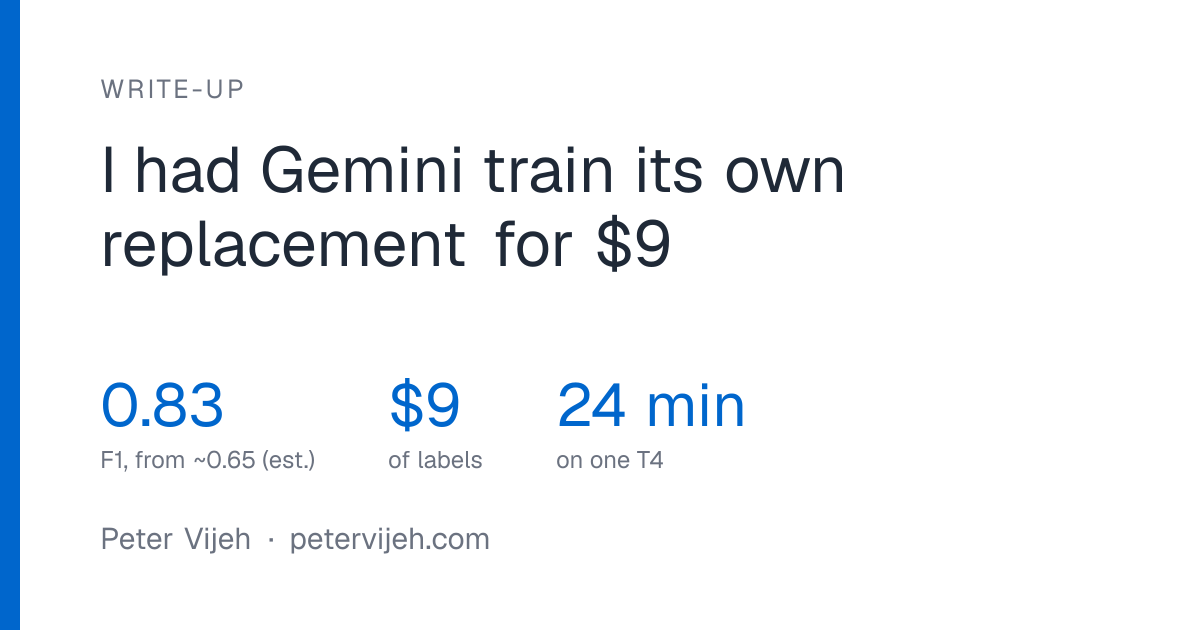
Một lập trình viên đã dùng Gemini 3.1 Pro gán nhãn cho 4.290 bình luận Reddit với chi phí 9 USD, rồi dùng dữ liệu đó để tinh chỉnh mô hình NER mã nguồn mở GLiNER chạy cục bộ. Sau năm lần thất bại vì lỗi cấu hình và một tensor bị hiểu sai, mô hình đạt 0,83 F1 so với nhãn của Gemini và loại bỏ hoàn toàn chi phí gọi API mỗi bình luận.
Tôi dùng Gemini tự huấn luyện mô hình thay thế nó với chi phí 9 USD
Một lập trình viên yêu thích dao bếp cao cấp đã tự động thu thập các bình luận trên Reddit để tìm ra thương hiệu, mẫu mã và loại thép mà cộng đồng đang bàn tán. Ban đầu anh dùng Gemini 3.1 Pro để trích xuất thực thể, nhưng chi phí tăng theo lượng bình luận. Câu hỏi đặt ra: liệu Gemini có thể gán nhãn một lần duy nhất rồi dạy lại cho một mô hình nhỏ chạy cục bộ hay không?
Bài toán: nhận diện thực thể tốn kém
Việc trích xuất tên sản phẩm từ văn bản được gọi là nhận diện thực thể có tên (named-entity recognition — NER), và các mô hình nhỏ đã làm được việc này suốt một thập kỷ. Tác giả dùng Gemini 3.1 Pro, mỗi bình luận tốn một lần gọi API trả phí. Cách này hiệu quả nhưng lãng phí: từ câu "picked up a Mazaki in white #2, way better than my old Fibrox", mô hình trả về Mazaki là thương hiệu, Fibrox là mẫu mã và white #2 là loại thép — chính xác nhưng quá đắt.
Vì trình thu thập chạy liên tục, hóa đơn tăng theo lượng người đăng bài, và cách duy nhất để giới hạn là bỏ qua bình luận.
Giải pháp thay thế hiển nhiên là GLiNER — một mô hình NER mã nguồn mở chạy zero-shot — giúp đưa chi phí về gần như bằng không, nhưng độ chính xác chỉ khoảng 0,65 F1 so với câu trả lời của Gemini. Khoảng cách đó chính là nội dung của phần còn lại.
Mục tiêu: Liệu Gemini có thể gán nhãn 4.290 bình luận một lần và dạy GLiNER thu hẹp khoảng cách?
Kế hoạch ba bước
Kế hoạch gồm ba bước rõ ràng:
- Dùng Gemini gán nhãn vài nghìn bình luận Reddit một lần, đánh dấu mọi thương hiệu, mẫu mã và loại thép.
- Huấn luyện GLiNER trên những nhãn đó.
- Chạy GLiNER trên máy cá nhân cho mọi bình luận sau đó, không cần gọi Gemini nữa.
Gemini gán nhãn 4.290 bình luận với giá 9 USD, tức khoảng 0,0021 USD mỗi bình luận. Nghĩa là mô hình huấn luyện xong sẽ hoàn vốn từ khoảng bình luận thứ 4.291, miễn là các bình luận sau có độ dài tương tự và chạy trên GPU đã có sẵn.
Tuy nhiên có một điểm cần lưu ý: không ai kiểm tra nhãn của Gemini bằng tay, nên mô hình được đánh giá so với Gemini chứ không phải so với sự thật. Ở đâu Gemini sai, mô hình bị tính là đúng khi sao chép lỗi và sai khi sửa lại.
Cách tiếp cận: yêu cầu chuỗi, không yêu cầu vị trí
Quyết định quan trọng nhất trong prompt là không bao giờ yêu cầu mô hình trả về vị trí ký tự. Mô hình đếm ký tự rất kém và thường trả về khoảng lệch hai đến ba vị trí. Thay vào đó, prompt yêu cầu đúng chuỗi con và nhãn, còn TypeScript sẽ tự tính vị trí. Nếu chuỗi không tồn tại trong bình luận, thực thể đó bị loại bỏ và ghi log.
Tên sản phẩm chứa nhiều dấu câu mà bộ tách từ thông thường chia nhỏ, nên một biểu thức chính quy giữ nguyên VG-10, CPM-154 và 1.4116 thành một khối. Khoảng nào vẫn lệch ranh giới token sẽ bị loại bỏ thay vì đoán mò.
Khoảng 30% tập huấn luyện là các bình luận chứa từ khóa dễ gây dương tính giả (gyuto, carbon, handle, patina) nhưng không có sản phẩm nào, được gán nhãn rỗng. Trước lần chạy thứ hai, tác giả để riêng 225 bình luận làm tập kiểm định và không đụng tới nữa.
Cấu hình huấn luyện chạy trên Tesla T4 qua Modal với HF Trainer:
per_device_train_batch_size = 2gradient_accumulation_steps = 8learning_rate = 1e-5threshold = 0.45
Dữ liệu huấn luyện
Tập dữ liệu gồm 4.290 bình luận diễn đàn được gán nhãn bởi LLM với chi phí 9 USD:
- 1.575 mẫu dương tính (69,6%)
- 675 mẫu âm tính
- 2.250 ví dụ huấn luyện, chia thành 2.029 mẫu train và 225 mẫu validation
- 3.907 khoảng thực thể: 1.720 thương hiệu, 1.345 mẫu mã sản phẩm, 842 thông số vật liệu
Khoảng 30% ví dụ cố ý không chứa thực thể nào.
Năm lần thất bại liên tiếp
Trong năm lần chạy đầu, mô hình không học được gì. Ba lần đầu thất bại vì cấu hình — bất kỳ ai dùng HF Trainer với GLiNER đều sẽ gặp phải trong một buổi chiều:
| Lần | Lỗi | Cách sửa |
|---|---|---|
| 1 | max_steps=10000 mặc định của GLiNER ghi đè num_train_epochs=3, huấn luyện tới 39 epoch | Đặt max_steps tường minh |
| 2 | load_best_model_at_end không có eval_strategy sẽ báo lỗi | Đặt eval_strategy="steps" |
| 3 | Trainer lưu state-dict thiếu tiền tố "model." mà loader của GLiNER yêu cầu | Thêm lại tiền tố khi lưu |
| 4 | Thiếu ner_labels ở các ví dụ âm tính | Đặt danh sách nhãn cho mọi ví dụ |
| 4–5 | words_mask được xây dựng dạng nhị phân; loss phẳng ở mức 70–130 | Phát ra chỉ số từ tăng dần |
Lần 4 và 5 là những lần tốn kém nhất. Hàm tokenize_inputs của GLiNER bị lỗi với emoji Reddit hỏng, nên tác giả đã vá lại, và bản vá phải điền một tensor tên là words_mask. Nó nằm cạnh attention_mask, có cùng kích thước, và mọi attention mask từng được xây dựng đều là số 1 cho token thật và số 0 cho phần đệm.
Huấn luyện chạy đến hết. Loss bắt đầu khoảng 130, trôi về 70 rồi đứng yên. Không crash, không cảnh báo, không NaN, gradient kích thước bình thường, checkpoint lưu đúng lịch, nhưng F1 khi đánh giá gần bằng không.
Sự thật về words_mask
Tác giả đọc vòng lặp huấn luyện của GLiNER thay vì đọc docstring. words_mask không phải là mask. Nó là chỉ số từ: số 0 cho token đặc biệt, prompt và padding, rồi 1, 2, 3 cho token con đầu tiên của mỗi từ thật. Đầu chấm điểm khoảng dùng nó để gộp các token con trở lại thành từ.
Khi điền toàn số 1, nó nói rằng cả bình luận là một từ duy nhất, nên mô hình buộc phải tìm khoảng thương hiệu và vật liệu bên trong một token khổng lồ. Không thể làm được, nên loss đứng phẳng — và loss phẳng không cho biết input nào bị sai.
# những gì tôi viết      # những gì GLiNER cần
words_mask = [1,1,1,1,1]  words_mask = [0,1,2,2,3]
Với chỉ số đã sửa, lần chạy thứ 6 học được ngay từ lần đầu. Phần còn lại là tinh chỉnh trên tập đã khóa:
- Mô hình medium 209M đạt 0,800
- Mô hình large 459M (vừa T4 chỉ với gradient accumulation) đạt 0,83
- Tăng gấp mười lần số mẫu âm tính đối kháng (510 thay vì 51) làm F1 giảm còn 0,799, nên lần 10 quay lại con số 51
- Dùng một ngưỡng riêng cho mỗi lớp thay vì một ngưỡng chung đã đưa độ phủ vật liệu từ 0,787 lên 0,911, vì các tên thép như MagnaCut, S35VN hay HAP40 có điểm tin cậy thấp hơn thương hiệu
Mọi lần chạy với mô hình large đều chạm đáy ở epoch 2 rồi overfit; với 2.000 ví dụ đây là vấn đề kích thước dữ liệu, và early stopping là giải pháp.
Kết quả theo từng lớp thực thể
So sánh zero-shot và các checkpoint đã tinh chỉnh trên cùng dữ liệu giữ lại:
- Tổng thể: ~0,65 (zero-shot) → 0,800 (209M) → 0,879 (459M)
- Thương hiệu: 0,858 → 0,904
- Mẫu sản phẩm: 0,775 → 0,877
- Thông số: 0,712 → 0,829
Bộ mã hóa lớn hơn giúp ích nhiều nhất ở nơi từ vựng thuần túy đặc thù ngành.
Bài học rút ra
Dự án thành công. Mô hình chạy cục bộ, khớp nhãn của Gemini ở mức 0,83 F1 trên những bình luận chưa từng thấy, và biết rằng "carbon steel" là một phạm trù chứ không phải một loại thép, còn PM2 đôi khi là Spyderco Paramilitary 2 và đôi khi chỉ là vài chữ cái.
Một lần chạy trước đó đạt 0,879 trên tập chia ngẫu nhiên, nhưng tác giả không tính là kết quả chính thức: với tập chia ngẫu nhiên, hai lần F1 tụt mà anh đổ lỗi cho thay đổi của mình hóa ra lại phụ thuộc vào việc bình luận nào rơi vào tập validation.
Trên giấy tờ, dự án tốn ít hơn một bữa trưa: 9 USD tiền nhãn, 2,50 USD tiền GPU. Nhưng cái giá thật là những ngày vật lộn với một tensor vượt qua mọi kiểm tra của mã nguồn mà vẫn sai.
Theo tác giả, những ngày mất mát như vậy là chuyện bình thường với các dự án tinh chỉnh nhỏ. Mô hình và dữ liệu hiếm khi là vấn đề; chính đoạn mã ở giữa mới hỏng, và một loss phẳng do input sai trông y hệt một loss phẳng do dữ liệu khó. Nếu phải chọn giữa một tập nhãn tốt hơn và một câu lệnh kiểm tra cho mọi tensor tự tay dựng, anh sẽ chọn câu lệnh kiểm tra.
Góc nhìn cho lập trình viên Việt Nam
Câu chuyện này mang đến vài gợi ý thiết thực:
- Tinh chỉnh mô hình nhỏ là lựa chọn kinh tế hợp lý. Với các tác vụ hẹp như NER, chi phí gán nhãn một lần thường hoàn vốn chỉ sau vài nghìn lượt gọi API.
- GPU T4 vẫn đủ dùng. Một mô hình 459M tham số huấn luyện được trong 24 phút trên GPU phổ thông, phù hợp với ngân sách cá nhân hoặc nhóm nhỏ.
- Kiểm tra dữ liệu đầu vào quan trọng hơn kiến trúc. Một tensor bị điền sai có thể làm hỏng toàn bộ quá trình huấn luyện mà không hề báo lỗi — đây là cái bẫy mà bất kỳ ai làm việc với PyTorch đều có thể gặp.
- Đánh giá so với LLM là cách nhanh nhưng có giới hạn. Nó hữu ích để khởi động, nhưng không thay thế được việc kiểm tra nhãn bằng tay nếu bạn cần độ chính xác cao.