
Qwen3-TTS đạt phản hồi dưới 50 ms trên một GPU H100
Nari Labs công bố bản triển khai Qwen3-TTS 1.7B CustomVoice đạt 10 yêu cầu/giây và p95 thời gian tới âm thanh đầu tiên dưới 50 ms trên một GPU NVIDIA H100 SXM, đồng thời mở mã nguồn và bộ đánh giá. Chi phí ước tính khoảng 2 USD cho 1 triệu ký tự, thấp hơn nhiều so với các dịch vụ thương mại.
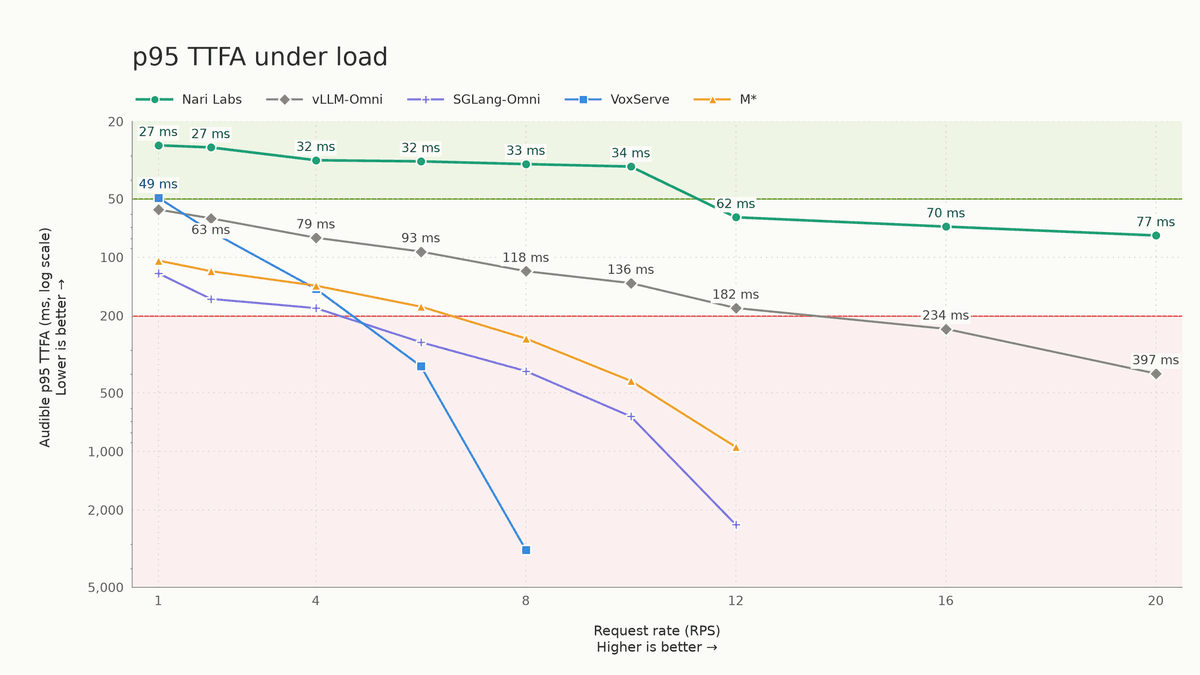
Nari Labs vừa công bố cách họ đưa mô hình chuyển văn bản thành giọng nói Qwen3-TTS 1.7B CustomVoice xuống dưới 50 ms ở phân vị p95 (p95: 95% yêu cầu có thời gian chờ thấp hơn ngưỡng này) cho âm thanh đầu tiên người dùng nghe được.
Kết quả đạt được trên một GPU NVIDIA H100 SXM duy nhất, vẫn giữ phát lại liên tục theo thời gian thực. Nhóm cũng mở mã nguồn bản triển khai và bộ đánh giá hiệu năng.
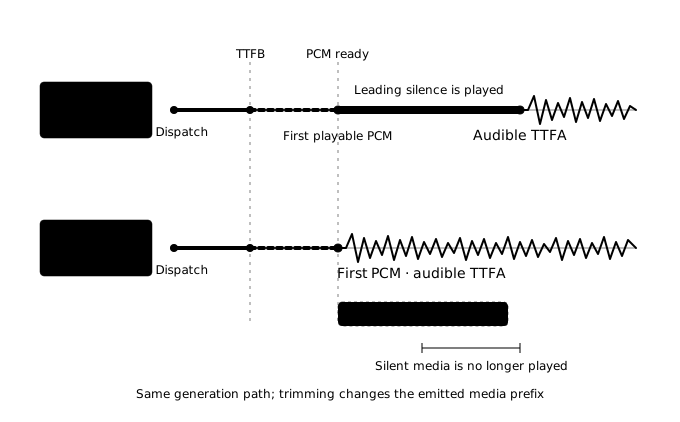 Biểu đồ độ trễ các khái niệm thời gian tới âm thanh đầu tiên
Bốn tiêu chí của một máy chủ TTS thời gian thực
Nhóm tác giả định nghĩa một máy chủ chuyển văn bản thành giọng nói (TTS) thời gian thực cần đạt bốn điều.
- Thời gian tới âm thanh đầu tiên thấp: tính từ lúc gửi yêu cầu đến mẫu âm thanh đầu tiên nghe được.
- Không cạn bộ đệm: một khi phát lại bắt đầu, máy khách không được hết âm thanh đã đệm.
- Dung lượng: hai điều trên vẫn giữ khi số yêu cầu mỗi giây (RPS) tăng.
- Đầu ra hợp lệ: giọng nói vẫn nghe rõ và đúng.
Họ chọn Qwen3-TTS CustomVoice 1.7B vì đây là một trong những mô hình TTS phổ biến có giấy phép thoáng.
Mọi phép đo kéo dài 5 phút với lưu lượng mở theo phân bố Poisson, nhằm mô phỏng tải thực tế. Mỗi engine nhận toàn bộ văn bản trong một yêu cầu HTTP, còn âm thanh vẫn được truyền dần.
Các engine khác xếp ở đâu?
Ở cấu hình mặc định, 1 RPS, kết quả rất chênh lệch. vLLM-Omni có p95 thời gian tới âm thanh đạt 277,883 ms. SGLang-Omni lên tới 1.140,69 ms. VoxServe ở 315,064 ms, còn M* là 1.159,956 ms.
Tỉ lệ yêu cầu bị cạn bộ đệm của vLLM-Omni ở mức 100%. Ba engine còn lại đều 0%.
Nhóm tác giả chỉnh từng engine theo hai hướng chính. Thứ nhất là cắt khoảng lặng đầu: mẫu âm thanh PCM đầu tiên thường chứa vài chục mili giây im lặng trước khi có tiếng thật. Cơ chế cắt động dựa trên cửa sổ RMS ngắn giúp giảm khoảng 80 ms, nhưng không làm suy luận nhanh hơn.
Thứ hai là tinh chỉnh số khung âm thanh gom trước khi giải mã. Khung nhỏ giúp phát nhanh hơn nhưng ít dư địa đệm; khung lớn dễ gom lô hơn nhưng chậm âm thanh đầu. Cách hợp lý là bắt đầu bằng khung nhỏ rồi tăng dần.
Sau tinh chỉnh, VoxServe đạt 49,3 ms p95 ở 1 RPS, ba engine còn lại đều trên 100 ms ở mức 6 RPS trở lên.
Ba mô-đun, một bộ lập lịch
Qwen3-TTS gồm ba phần sinh mã theo cấu trúc phân cấp nhiều sổ mã. Talker dự đoán token của sổ mã đầu tiên cho mỗi khung âm thanh. Code Predictor sinh 15 token sổ mã còn lại. Codec nhân quả chuyển token thành mẫu sóng âm.
Phần lớn bản triển khai tách thành hai tầng: Talker và Code Predictor chạy chung, Codec chạy riêng. Nari Labs đưa cả ba thành ba tác vụ có thể lập lịch độc lập, nằm trên cùng một mặt phẳng lập lịch do một bộ lập lịch quản lý.
Nhờ vậy, bộ lập lịch tự quyết định nên chạy Talker, đẩy Code Predictor hay ưu tiên một việc Codec đang gần hạn phát. Nó cũng gom lô các yêu cầu cùng chờ một mô-đun.
Việc gộp Talker với Code Predictor trông có vẻ hiệu quả hơn, nhưng khối gộp thành một đơn vị không thể ngắt, dễ chặn các việc gấp hơn. Tách rời tạo ra các đơn vị việc ngắn hơn, cho bộ lập lịch nhiều cơ hội xen kẽ hơn.
Ưu tiên theo hai kiểu gấp khác nhau
Streaming giọng nói có hai khái niệm gấp. Trước khi có khối âm thanh đầu, mỗi mili giây đều làm tăng thời gian chờ, nên đường này cần ưu tiên cao nhất.
Sau khi phát lại bắt đầu, mục tiêu đổi khác: khối tiếp theo chỉ cần đến trước khi âm thanh hiện tại phát xong. Sinh sớm hơn không mang lại lợi ích cho người dùng.
Vì thế, yêu cầu chưa có âm thanh đầu được ưu tiên cao. Các luồng đã chạy chỉ thành gấp khi tiến gần hạn phát.
Nếu chạy riêng mọi yêu cầu gấp thì hiệu quả gom lô mất hết. Bộ lập lịch chọn một yêu cầu gấp làm neo, rồi lấp phần còn lại của lô bằng việc tương thích.
Khai thác cấu trúc đều của Code Predictor
Code Predictor là transformer tự hồi quy nhưng chạy rất đều: luôn thực hiện đúng 15 bước mỗi khung để điền các sổ mã còn lại.
Nhóm tác giả cấp phát trước bộ nhớ đệm KV, ghi toàn bộ vòng sinh khung thành một đồ thị CUDA duy nhất. Họ cũng dùng nhân attention viết bằng Triton chuyên cho ngữ cảnh ngắn, có chặn.
Thay một chuỗi lệnh do CPU điều khiển bằng một chương trình GPU cố định giúp giảm độ trễ và đơn giản hóa hệ thống thực thi.
Codec xây lại quanh trạng thái đệm
Codec của Qwen3-TTS gồm transformer và mạng tích chập (CNN). Sinh khối âm thanh tiếp theo phụ thuộc vào cả ngữ cảnh transformer lẫn trạng thái tích chập từ các khối trước.
Cách làm ngây thơ là xử lý lại toàn bộ lịch sử khung mỗi lần cập nhật, giải mã lặp lại âm thanh cũ khi câu nói dài ra.
Nhóm tác giả giữ lại ngữ cảnh transformer và trạng thái tích chập cần cho khối kế tiếp. Giải mã tăng dần chỉ xử lý khung mới đến.
Khởi tạo bộ đệm trạng thái từ khung đầu tốn thêm chi phí và làm hỏng thời gian chờ. Vì thế họ giải mã đầy đủ cho âm thanh đầu, rồi chuyển sang giải mã tăng dần có đệm trạng thái.
Kích thước khối cũng thay đổi trong một yêu cầu: khối nhỏ để phát nhanh, khối lớn để gom lô và tận dụng GPU tốt hơn.
Các tối ưu phục vụ khác
Đồ thị CUDA được ghi sẵn cho một tập kích thước lô định trước. Nếu nhóm sẵn sàng vượt kích thước lô lớn nhất đã ghi, hệ thống chia sang lượt lập lịch khác thay vì rơi về chế độ chạy trực tiếp.
Nhóm cũng tránh đồng bộ CPU và GPU không cần thiết. Ví dụ, khi token kết thúc (EOS) bị chặn, quá trình sinh không thể dừng, nên việc kiểm tra dừng được hoãn lại tới khi bật EOS.
Cuối cùng, hệ thống hỗ trợ đầu vào dạng stream cho các hệ chuyển giọng nói sang giọng nói. Khi mô hình ngôn ngữ phía trên đang sinh token, mô hình TTS có thể bắt đầu tổng hợp trước khi nhận đủ câu trả lời.
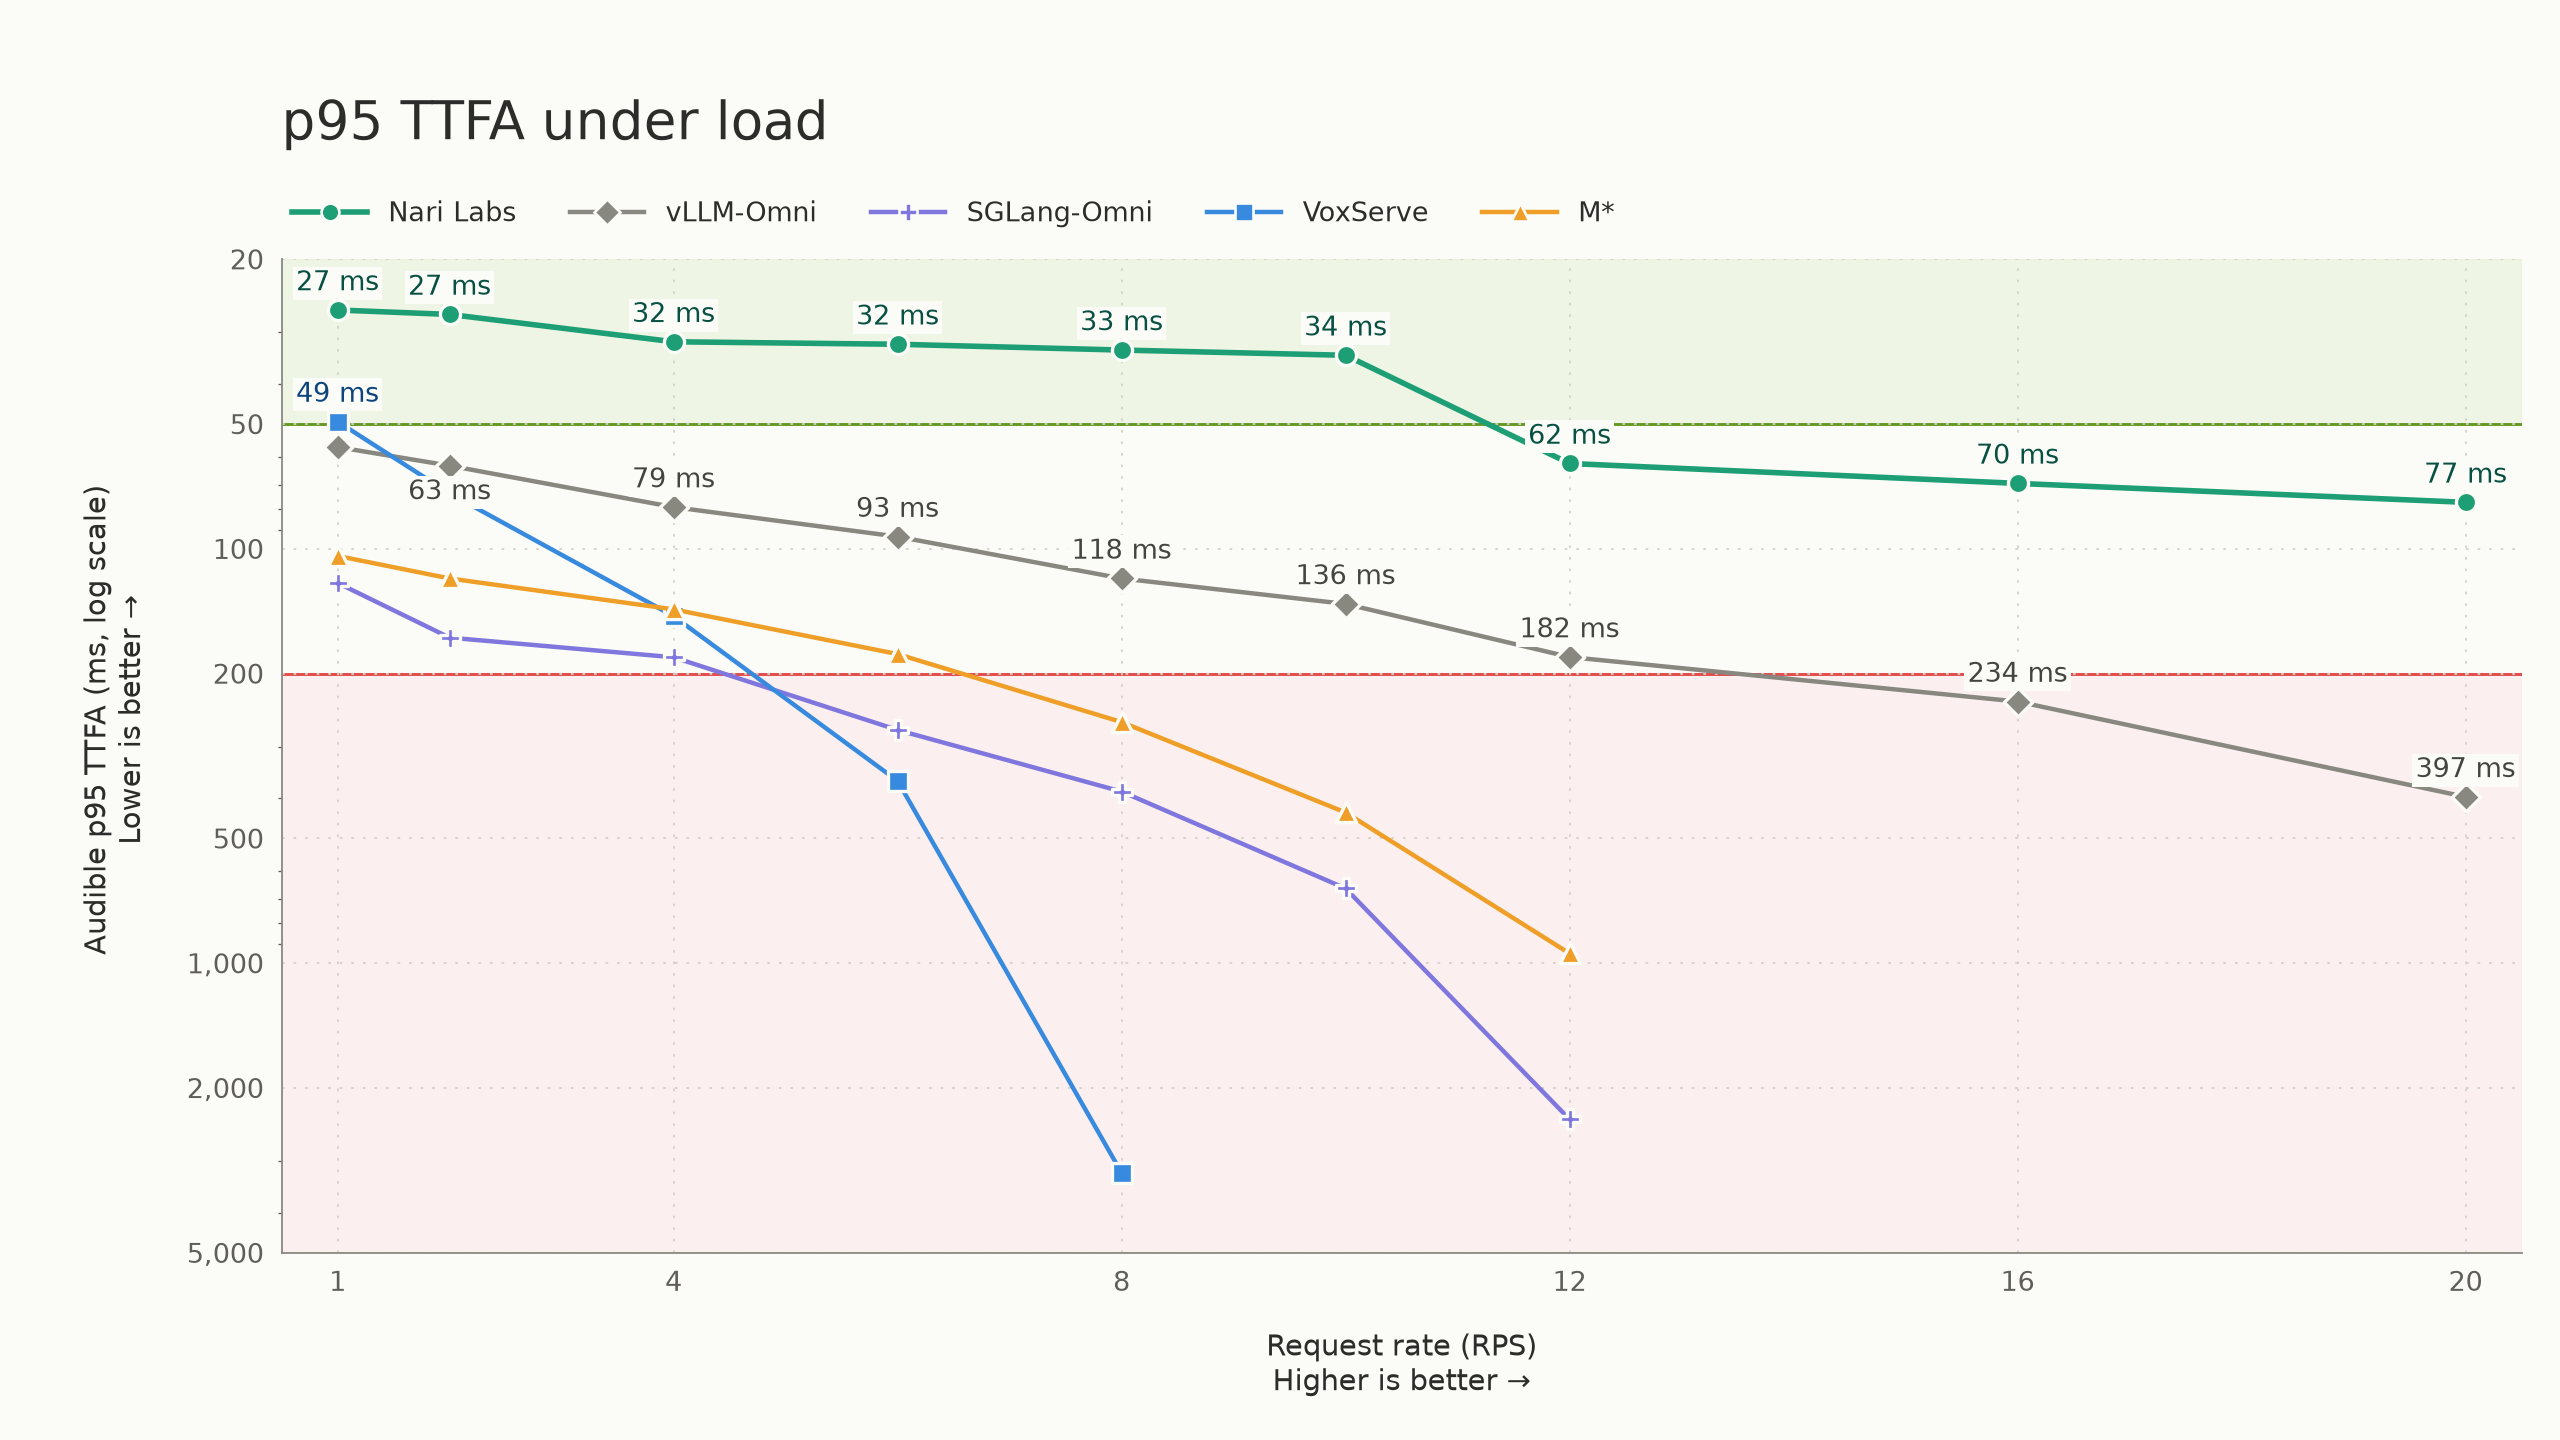 So sánh hiệu năng và chi phí giữa các engine
Hiệu quả và chi phí
Ở 10 RPS, hệ thống sinh khoảng 630 ký tự mỗi giây. Với giá 4,29 USD một giờ cho một phiên bản H100 SXM, chi phí xấp xỉ 2 USD cho 1 triệu ký tự khi chạy hết công suất. Con số này chưa tính mạng, công suất nhàn rỗi và chi phí vận hành.
Để so sánh, ElevenLabs V3 có giá 100 USD cho 1 triệu ký tự, còn Cartesia Sonic 3.5 là 49 USD cho 1 triệu ký tự, với thời gian chờ cao hơn.
Nhóm duy trì p95 dưới 50 ms tới 10 RPS, và vẫn dưới 100 ms ở 20 RPS.
Nari Labs cho biết Qwen3-TTS chỉ là bước đầu trong hướng suy luận đa phương thức. Họ dự định mở rộng sang hình ảnh, video, mô hình thế giới và tinh chỉnh mô hình.
Nhóm gồm các kỹ sư từng làm tại YC, KRAFTON và NAVER, đã công bố nghiên cứu tại NeurIPS và ICLR. Mô hình TTS mở Dia của họ đã được tải hơn hai triệu lần và từng đứng đầu Hugging Face.
Góc nhìn
Con số dưới 50 ms quan trọng với các hệ hội thoại bằng giọng nói. Với trợ lý ảo, tổng đài hay ứng dụng học nói, độ trễ âm thanh đầu quyết định cảm giác chờ.
Bài học không nằm ở mô hình mà ở cách phục vụ. Tách mô-đun thành tác vụ độc lập, lập lịch theo hạn phát và giữ trạng thái đệm đều là kỹ thuật có thể áp dụng cho hệ suy luận khác.
Chi phí khoảng 2 USD cho 1 triệu ký tự cho thấy tự vận hành TTS trên GPU thuê theo giờ có thể rẻ hơn đáng kể so với thuê dịch vụ. Đổi lại, đội kỹ thuật phải tự lo hạ tầng, giám sát và chất lượng giọng.
Với kỹ sư Việt Nam, mã nguồn và bộ đánh giá mở là điểm khởi đầu tốt để thử nghiệm. Cần lưu ý mốc giá trên tính theo GPU H100 chạy hết công suất, nên chi phí thực tế sẽ cao hơn nếu tải thấp.
Nguồn: nari-labs.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Nari Labs vượt mặt các mô hình đóng: Qwen3-TTS và Qwen3-ASR dẫn đầu cả về độ chính xác lẫn chi phí
14 tháng 9, 2026
Công nghệ
Microsoft VibeVoice: Bộ công cụ AI giọng nói mã nguồn mở thế hệ mới
28 tháng 4, 2026
Phần mềm
Giải pháp Voice AI nhanh và thông minh với kiến trúc Responder-Thinker và Local VAD
07 tháng 4, 2026