Tôi xây dựng công cụ kiểm tra tuyên bố bằng Codex — và nó đã bỏ sót một tuyên bố sai
Công cụ tìm đúng đoạn văn nguồn nhưng không phát hiện sự sai lệch, và chính quá trình kiểm tra cho thấy các quy tắc dựa trên từ khóa dễ vỡ ở đâu. Bài viết phân tích cách một công cụ kiểm chứng tuyên bố hoạt động, giới hạn của nó và bài học cho người viết kỹ thuật.
Tôi xây dựng công cụ kiểm tra tuyên bố bằng Codex — và nó đã bỏ sót một tuyên bố sai
Công cụ tìm đúng đoạn văn nguồn nhưng không phát hiện ra sự sai lệch, và chính quá trình kiểm tra cho thấy các quy tắc dựa trên từ khóa dễ vỡ ở đâu. Đây là câu chuyện về Evidence Desk — một công cụ chạy trên trình duyệt được xây dựng với sự hỗ trợ của Codex — và những giới hạn mà ngay cả tác giả cũng không ngờ tới.
Tôi từng phải suy nghĩ rất kỹ về cách diễn đạt các kết quả kỹ thuật, đặc biệt khi một câu được viết lại cho trôi chảy hơn. Một lỗi dễ mắc là biến "giảm 20% sai số" thành "cải thiện 20% độ chính xác". Việc cắt 20% sai số chỉ làm một con số nhỏ còn lại thu hẹp lại, nên độ chính xác gần như không thay đổi. Con số vẫn nguyên vẹn sau khi viết lại, nhưng thứ mà nó mô tả đã thay đổi hoàn toàn.
Loại lỗi này đủ tinh vi để vượt qua một lần đọc nhanh, bởi chẳng có gì trong câu trông sai lệch cả. Recall có thể lặng lẽ biến thành accuracy, một con số có thể lệch mười điểm, hoặc một mối liên hệ quan sát được có thể khoác thêm động từ mang tính nhân quả trên đường tới một câu gọn gàng hơn. Đó chính là loại lỗi mà tôi muốn Evidence Desk giúp phát hiện.
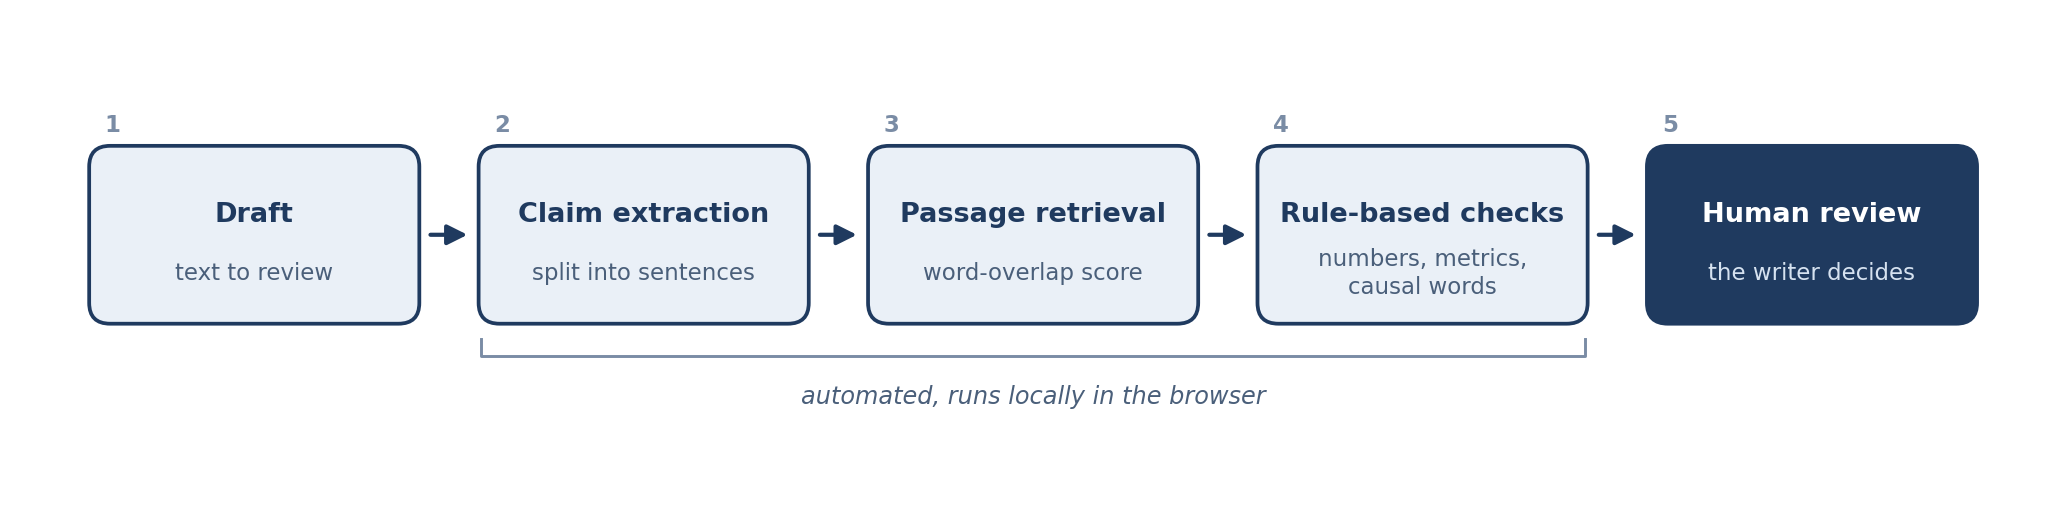 Giao diện công cụ kiểm tra tuyên bố Evidence Desk
Evidence Desk là gì?
Evidence Desk là một công cụ chạy trên trình duyệt mà tôi xây dựng cùng Codex. Bạn đưa cho nó một bản nháp cùng các tệp nguồn mà bản nháp đó được viết ra, và nó chia bản nháp thành từng tuyên bố (claim). Với mỗi tuyên bố, nó tìm đoạn văn gần nhất trong các nguồn và chạy một vài phép kiểm tra rõ ràng; sau đó trả về một trong ba nhãn: Supported (được hỗ trợ), Potential mismatch (có khả năng sai lệch), hoặc Insufficient evidence (không đủ bằng chứng).
Tôi dùng Codex để hỗ trợ triển khai giao diện, logic kiểm tra, các bài test và phần còn lại của ứng dụng xung quanh quy trình tôi đã hình dung sẵn. Phần của tôi là quyết định công cụ nên kiểm tra cái gì và đánh giá liệu hành vi của nó có khớp với mục tiêu đó không. Ví dụ về sai số so với độ chính xác ở trên đến từ mẫu hư cấu có sẵn của công cụ, xoay quanh một bộ phân loại giả tưởng tên là Meridian, và hóa ra cũng chính là bức tranh rõ ràng nhất cho thấy công cụ này mất độ tin cậy từ đâu.
Kiểm tra là một công việc khác với viết lách
Một mô hình viết tốt đang nhắm tới văn bản nghe hợp lý. Kiểm tra lại hỏi về một mối quan hệ: liệu tập bằng chứng này có thực sự nói điều mà tuyên bố đang nói hay không? Đó là một câu hỏi nhỏ hơn câu hỏi liệu tuyên bố có đúng sự thật hay không. Một nguồn có thể sai trong khi tuyên bố vẫn trung thành với nó, và với văn bản kỹ thuật thì phần trung thành với nguồn thường là thứ gây khó chịu trước tiên.
Bạn có thể nhờ một mô hình thứ hai đánh giá mô hình thứ nhất, và cách đó có thể hiệu quả. Tôi không phản đối điều đó. Đánh đổi mà tôi thấy là người đánh giá cũng mang tính sinh tạo (generative), và phán quyết của nó có thể đến mà không kèm lý do để bạn tranh luận. Evidence Desk chọn con đường hẹp hơn: mọi cảnh báo đều đi kèm đoạn văn làm căn cứ và một lý do, để người viết có thứ cụ thể để phản biện.
Quy trình xử lý
Trích xuất tuyên bố được cố tình làm thô. Nó tách theo ranh giới câu và dòng trống, bỏ qua tiêu đề và mọi thứ dưới năm từ, và giữ tối đa 40 ứng viên. Toàn bộ chạy trong trình duyệt, và luồng kiểm tra không gửi yêu cầu mạng nào.
Điểm số cao chứng minh được rất ít
Truy hồi (retrieval) chỉ là trùng khớp từ vựng đơn giản, ngắn đến mức có thể trình bày ngay tại đây (rút gọn từ evidence.ts, hành vi không đổi):
// Tỷ lệ các từ riêng biệt của tuyên bố xuất hiện trong đoạn văn.
// Không trọng số: "classifier" được tính ngang với "20%".
export function overlapScore(claim: string, passage: string) {
  const want = new Set(words(claim));
  if (!want.size) return 0;
  const have = new Set(words(passage));
  let hit = 0;
  for (const w of want) if (have.has(w)) hit++;
  return hit / want.size;
}
Ở mức 0.25, một đoạn văn được coi là có bằng chứng; và ở mức 0.48, một tuyên bố có thể được gọi là Supported. Cả hai ngưỡng đều do con người đặt, không được hiệu chuẩn. Đây là tỷ lệ từ, không phải độ tương đồng ngữ nghĩa, và chắc chắn không phải xác suất tuyên bố đúng.
Tuyên bố về độ chính xác của Meridian cho thấy vì sao điều đó quan trọng. So với đoạn văn về sai số, nó đạt điểm 86, cao nhất trong mọi đoạn, bởi bản nháp được viết ra từ chính đoạn đó. Điểm cao cho bạn biết một câu được suy ra từ nguồn sát đến mức nào, và một bản viết lại bị bóp méo thì theo định nghĩa là một suy dẫn sát. Truy hồi đã tìm đúng đoạn văn. Nó không có cách nào nhận ra rằng đoạn văn đó phản đối.
Các phép kiểm tra bổ sung được gì và bỏ sót gì
Có ba phép kiểm tra nằm bên trên. Kiểm tra số liệu rút các con số ra khỏi tuyên bố và đoạn văn được truy hồi, loại bỏ dấu phẩy và khoảng trắng, rồi phàn nàn về bất kỳ con số nào trong tuyên bố mà đoạn văn không chứa. Kiểm tra chỉ số tìm các thuật ngữ đánh giá bị lẫn lộn. Kiểm tra nhân quả tìm những từ như "caused" hay "led to" trong tuyên bố và kỳ vọng đoạn văn cũng có.
Kiểm tra số liệu "đáng đồng tiền". Tuyên bố rằng bộ phân loại đạt recall 95% truy hồi câu báo cáo 85%, và cảnh báo rằng 95% không xuất hiện ở đâu trong bằng chứng là đúng. Khớp chính xác thì thô, nhưng nó bắt được một con số bị đổi.
Tuy nhiên, sự thô đó cắt cả hai chiều: cùng phép kiểm tra có thể vượt quá phạm vi với một tuyên bố thực ra vẫn ổn. Khi tôi thử công cụ với một bài báo, một câu chứa cả 84% và 60% bị trả về cảnh báo số liệu, và lý do khá đơn giản: đoạn văn được truy hồi chỉ chứa một trong hai con số đó. Phép kiểm tra coi một con số thiếu là sai lệch, chấm hết, không tính đến việc bằng chứng có thể bị chia tách qua hai đoạn văn, và quy tắc trong kho mã vẫn hoạt động như vậy.
Điều tôi muốn thấy hơn là một công cụ nói rằng nó không thể xác lập một con số, chứ không phải một công cụ gắn cờ nó một cách đầy tự tin. Tôi quan tâm ít hơn đến việc giao diện trả về một phán quyết, và quan tâm nhiều hơn đến việc tôi có thể bảo vệ lý lẽ đằng sau nó hay không.
Kiểm tra chỉ số — nơi thiết kế hết đường
Đây là đoạn mã rút gọn từ evidence.ts, hành vi không đổi:
const METRICS = /\b(accuracy|precision|recall|error|f1|auc)\b/i;

// Chỉ kích hoạt khi tuyên bố nêu tên một chỉ số mà đoạn văn không hề nhắc tới.
const claimMetric = claim.match(METRICS)?.[1]?.toLowerCase();
if (claimMetric && METRICS.test(best.text) && !new RegExp(`\\b${claimMetric}\\b`, "i").test(best.text)) {
  reasons.push("Possible metric confusion: ...");
}
Nó chỉ kích hoạt khi từ chỉ số đầu tiên của tuyên bố bị thiếu trong đoạn văn được truy hồi. Đoạn văn Meridian có nhắc tới accuracy ở câu thứ hai, nên nó im lặng, và kiểm tra số liệu cũng vậy vì thấy 20% ở cả hai phía. Chạy engine trên bản nháp mẫu trả về Supported, với điểm 86, cho tuyên bố về độ chính xác. Không có gì gắn con số với đại lượng mà nó đo lường. Trong nguồn, 20% thuộc về sai số; trong bản nháp, nó thuộc về độ chính xác, và cả hai phép kiểm tra đều coi đoạn văn như một túi từ và số.
Tôi kỳ vọng bản mẫu sẽ là cách nhanh để xem công cụ có làm đúng việc không. Thay vào đó, kết quả trên màn hình không khớp với kết quả engine trả về cho cùng tuyên bố và nguồn. Bản mẫu mang theo một bản đánh giá đã lưu, nên nó hiển thị Potential mismatch cho tuyên bố về độ chính xác, trong khi chạy cùng đoạn văn qua logic kiểm tra thực tế lại trả về Supported. Đó là một phát hiện khó xử trong một công cụ mà toàn bộ mục đích là giúp người ta kiểm chứng tuyên bố: giao diện đang hiển thị kết quả mà tôi muốn thấy, chứ không cho thấy rằng engine có thể tạo ra nó.
Kiểm tra nhân quả và điểm mù của nó
Trong bản mẫu, tuyên bố rằng việc dùng trợ lý học tập gây ra điểm thi cao hơn kéo lên đoạn văn về khác biệt điểm số — đoạn này không có từ nhân quả nào — nên tuyên bố bị gắn cờ. Trông như phép kiểm tra đang hoạt động. Nhưng câu thực sự quan trọng nằm ở đoạn kế tiếp, và nó nói rằng kết quả không xác lập rằng trợ lý gây ra khác biệt đó. Vậy từ "caused" có ở đó, chỉ là nằm trong một mệnh đề phủ định. Viết lại tuyên bố thành "The assistant caused the score difference between students" thì truy hồi lại rơi đúng vào câu đó, và tuyên bố được trả về Supported ở mức 50. Khớp từ khóa không hiểu phủ định là gì, và bản mẫu chỉ bắt được tuyên bố nhân quả của nó nhờ may mắn về thứ tự xếp hạng đoạn văn.
Một bản sửa tiềm năng (chưa có trong kho mã) sẽ gồm ba thay đổi nhỏ: loại bỏ dấu câu cuối khi tách từ, yêu cầu mỗi con số khớp phải nằm cùng câu với từ chỉ số của tuyên bố, và coi từ khóa nhân quả nằm trong mệnh đề bị phủ định là không tồn tại. Một nguyên mẫu như vậy xử lý sạch mọi lỗi mô tả ở đây, và ba bài test hiện có vẫn đạt. Nó vẫn sẽ là heuristic, bởi một con số và chỉ số của nó hoàn toàn có thể nằm ở hai câu khác nhau.
Nói "không đủ bằng chứng"
Supported nghĩa là đoạn văn được truy hồi mạnh nhất đã vượt qua các phép kiểm tra. Potential mismatch nghĩa là một phép kiểm tra kích hoạt hoặc độ trùng khớp yếu. Insufficient evidence nghĩa là không đoạn văn nào đạt 0.25, và điều này không bao giờ nên được đọc là "sai". Tuyên bố rằng một mô hình trở nên tốt hơn trong việc phát hiện các ca hiếm gặp đạt điểm 0 so với một nguồn nói rằng recall trên lớp thiểu số tăng từ 0.41 lên 0.58. Công cụ báo rằng nó không tìm thấy gì — đó là kết quả trung thực cho một cách diễn đạt lại mà nó không đọc được.
Với mỗi tuyên bố, giao diện hiển thị đoạn văn được truy hồi, ba ứng viên hàng đầu và lý do. Nó vẫn có thể đánh lạc hướng bạn. Một Potential mismatch với độ trùng khớp từ 25 đến 48 lại đến mà không kèm lý do nào, bởi quy tắc trùng khớp yếu không đưa ra lý do.
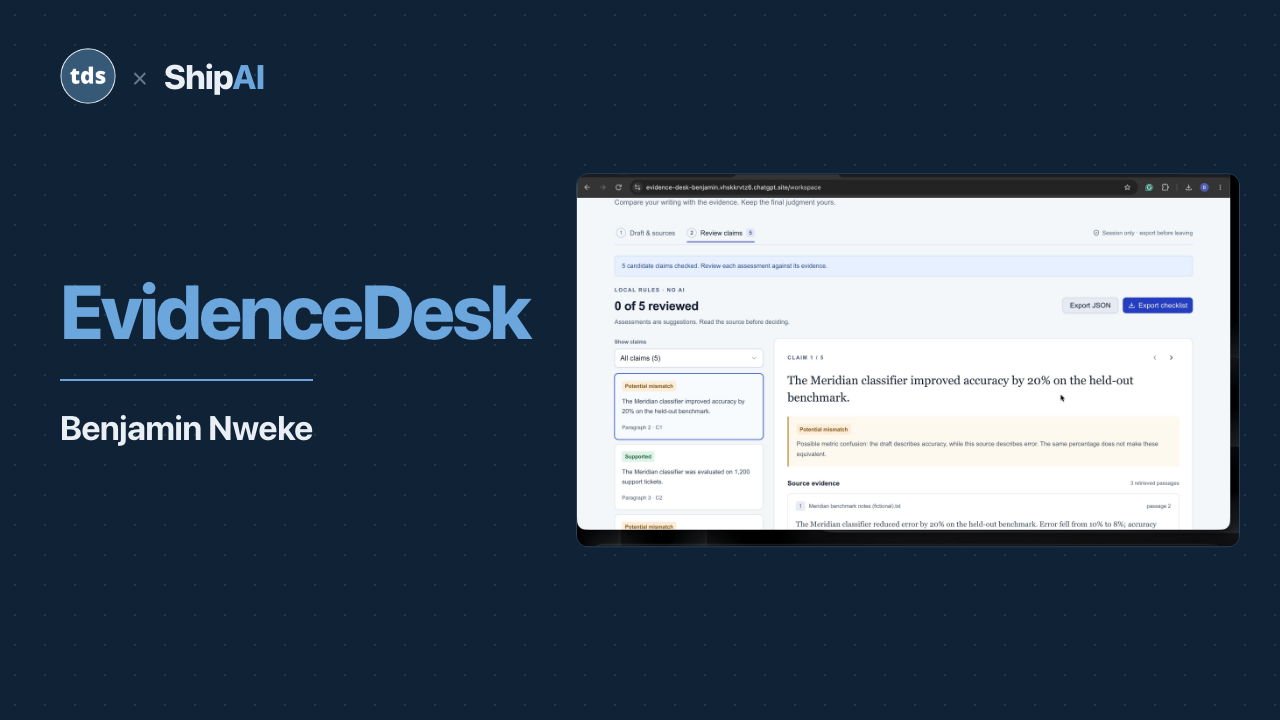 Sơ đồ luồng kiểm tra của Evidence Desk
Nơi công cụ sụp đổ
Khớp từ vựng bỏ sót hoàn toàn việc diễn đạt lại (paraphrase), như điểm 0 cho thấy, và bộ tách từ giữ nguyên dấu chấm ở cuối từ cuối câu. Một tuyên bố kết thúc bằng "students." không khớp với "students" giữa đoạn văn — đó là cách tuyên bố rằng thí điểm gồm 84 sinh viên lại truy hồi tiêu đề tài liệu và nhận cảnh báo số liệu vì lý do sai. Engine không có phép kiểm tra phóng đại nào cả, nên câu "always achieved a recall of 85%" vẫn được gọi là Supported. Các tuyên bố là từng câu đơn, nên một đại từ hay con số được định nghĩa trước đó sẽ mất ngữ cảnh, và giới hạn 40 tuyên bố bỏ rơi phần còn lại của một bản nháp dài.
Các bài test chứng minh ít hơn những gì giao diện gợi ý. Chỉ có ba bài, và không bài nào chạm tới kiểm tra chỉ số, kiểm tra nhân quả hay các ngưỡng. Không có chuẩn đối sánh (benchmark) nào cho tần suất cảnh báo đúng, và tôi sẽ không giả vờ là có. Một tuyên bố trung thành được kiểm tra với một nguồn sai cũng sẽ qua sạch, bởi công cụ chỉ so sánh tuyên bố với tài liệu được cung cấp và không gì khác.
Bài học tôi rút ra
Viết một câu và kiểm tra bằng chứng của nó là hai bước riêng biệt, và chúng thất bại theo những cách riêng biệt. Một điểm trùng khớp cao chỉ cho thấy rằng bản nháp được dựng từ một đoạn văn, nên truy hồi có thể rơi đúng đoạn văn mà vẫn bỏ lỡ rằng nó phản đối. Khớp số liệu cũng chưa đủ, bởi một con số phải được gắn với đại lượng mà nó đo lường thì mới lộ ra việc đánh tráo như biến sai số thành độ chính xác. Tôi thà phát hành một công cụ kiểm tra nói rõ những giới hạn đó, còn hơn một công cụ trả về phán quyết đầy tự tin.
Được dùng như một công cụ hỗ trợ rà soát, một sản phẩm như thế này giành được chỗ đứng bằng cách thu hẹp bản nháp xuống còn những tuyên bố đáng đọc lại. Nó hết hữu ích ngay khi có ai đó đọc phán quyết của nó như là sự thật.
Mã nguồn nằm trên GitHub, và phần hướng dẫn ShipAI trình bày giao diện khi sử dụng.
Evidence Desk — không gian rà soát tuyên bố được xây dựng cùng Codex: người viết kỹ thuật đặt bản nháp bên cạnh các nguồn của nó, còn các phép kiểm tra từ khóa và quy tắc sẽ gắn cờ những tuyên bố mà nguồn không hậu thuẫn.