Mô hình 125M tự động hoàn thiện bản piano ngay trên iPhone
Một lập trình viên đã huấn luyện transformer 125 triệu tham số để tự động hoàn thiện bản piano theo thời gian thực, đạt khoảng 108 nốt mỗi giây trên iPhone 15. Ứng dụng RollTab chạy hoàn toàn trên thiết bị, miễn phí cho người dùng có bàn phím MIDI và iPhone hoặc iPad.
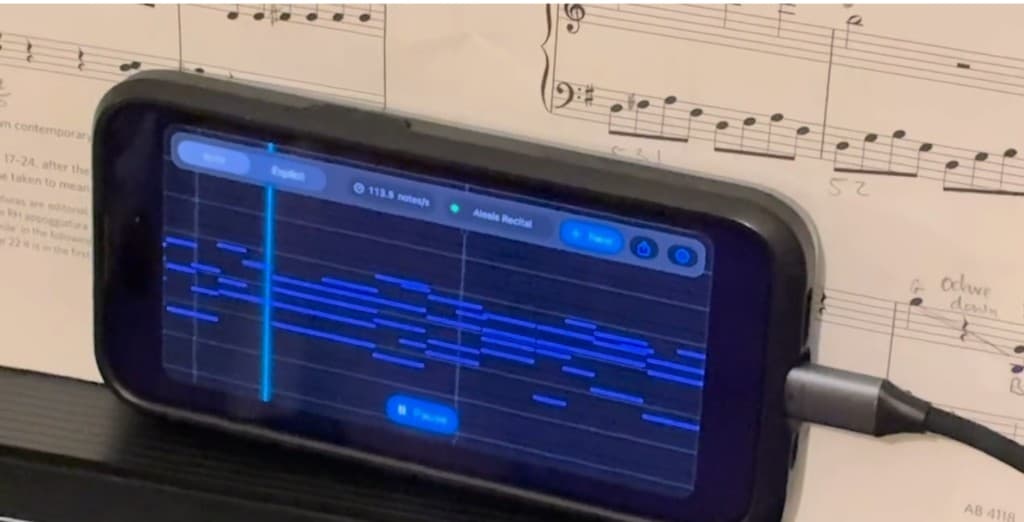
GitHub Copilot gợi ý dòng code tiếp theo dựa trên đoạn code bạn vừa viết. Ý tưởng của dự án này tương tự, nhưng đầu vào là vài nốt nhạc gõ trên bàn phím MIDI thay vì mã nguồn.
Sau 14 thử nghiệm trong gần một năm, lập trình viên này đã đưa ra bản ứng dụng tên RollTab, chạy trên iPhone và iPad. Ứng dụng miễn phí, yêu cầu bàn phím MIDI để hoạt động.
Bài toán khó hơn tưởng tượng
Tệp MIDI không lưu âm thanh mà lưu chuỗi sự kiện: phím được nhấn ở cao độ và lực bấm nào, phím nhả ra, bàn đạp giữ (sustain pedal) đổi trạng thái. Một bản nhạc pop hoặc game có thể tách thành nhiều track cho giai điệu, hợp âm, bass, trống.
Để huấn luyện transformer, trước hết phải chuyển các sự kiện này thành chuỗi rời rạc mà mô hình đọc và dự đoán được. Cách trực tiếp nhất là tạo một token cho mỗi sự kiện, gộp cả cao độ và lực bấm vào token nhấn phím. Nhưng 128 cao độ nhân 128 mức lực bấm cộng thêm 128 token nhả phím đã lên tới 16.512 token, phần lớn là tổ hợp hiếm gặp.
Cách tách nhỏ bằng ngữ pháp, ví dụ [NOTE_ON, PITCH, VELOCITY], thu hẹp không gian đầu ra. Nhưng mỗi nốt lại tốn khoảng bốn bước sinh tự hồi quy, quá chậm với mục tiêu chạy thời gian thực trên máy nhỏ.
Biểu diễn cuối cùng
Tác giả chọn cách mã hóa mỗi nốt thành NOTE(pitch, delta_onset, duration, velocity), không có sự kiện khoảng lặng riêng. Khoảng lặng nằm ở delta_onset của nốt kế tiếp, tức thời gian tính từ lúc nốt trước bắt đầu.
Hợp âm là nhiều nốt có delta_onset = 0, sắp xếp theo cao độ để tránh mô hình bị phạt khi cùng một hợp âm được mã hóa theo thứ tự khác nhau giữa các bản nhạc.
Bên trong, mỗi nốt gồm năm trường phân loại, mỗi trường có bộ từ vựng riêng: loại sự kiện, cao độ, delta, trường độ, lực bấm. Transformer chạy một lần cho mỗi nốt hoàn chỉnh thay vì một lần cho mỗi trường. Có một bộ giải mã nhỏ nối giữa các trường để trường sau dựa vào trường trước.
Cách này đưa mô hình lớn lên khoảng 108 nốt mỗi giây trên iPhone, vượt xa nhu cầu chơi nhạc trực tiếp của con người. Thời gian lượng tử hóa theo 24 bước mỗi phách, đủ cho các nhịp chia đôi và chia ba thông dụng.
Bàn đạp giữ không được mô hình hóa riêng. Tác giả nhúng nó vào trường độ trong bước tiền xử lý: nếu phím nhả khi bàn đạp còn giữ, nốt được kéo dài tới lúc nhả bàn đạp. Cách này làm mất cử chỉ bàn đạp nhưng đơn giản hóa bài toán cho mô hình.
Dữ liệu sạch hơn dữ liệu nhiều
Bộ dữ liệu cuối gồm vài trăm nghìn tệp MIDI, tương đương khoảng 300 triệu sự kiện nốt, chủ yếu là nhạc cổ điển đã hết thời hạn bảo hộ.
Quy trình lọc gồm: chọn tài liệu dành cho piano, loại bỏ các hỗn hợp đa track bất thường, lọc theo mật độ và độ phủ cao độ, khử trùng lặp bằng dấu vân tay bỏ qua dịch giọng và đổi tốc độ đều, gom các phiên bản khác nhau của cùng một tác phẩm vào cùng một tập.
Khi thử tăng dữ liệu lên khoảng 5 lần, mô hình lại kém hơn. Lọc và chọn dữ liệu quan trọng hơn thêm dữ liệu.
Huấn luyện và tinh chỉnh
Mô hình là transformer decoder-only tiêu chuẩn, dùng RMSNorm, rotary positional embeddings (RoPE), self-attention nhân quả và khối SwiGLU/MLP. Ba kích thước được huấn luyện: khoảng 33 triệu, 64 triệu và 125 triệu tham số.
Một kỹ thuật then chốt là scheduled sampling: trong huấn luyện, đôi khi mô hình được cho ăn cao độ do chính nó dự đoán thay vì cao độ đúng, tăng dần từ 0% lên 50%. Cách này làm loss kiểm định tăng nhưng chất lượng bản hoàn thiện tốt hơn rõ rệt.
Đánh giá bằng tai không đủ, nên tác giả dùng Gemini 3.5 Flash để so sánh từng cặp bản hoàn thiện, đảo thứ tự A và B để giảm thiên lệch vị trí. Tiêu chí được tách làm hai: điểm bám theo đoạn nhạc gợi ý, và điểm nghe hay khi đứng riêng.
Dữ liệu so sánh cặp này dùng cho DPO (Direct Preference Optimization), huấn luyện mô hình ưu tiên bản được chọn hơn bản bị loại. Đây là bước tạo khác biệt lớn nhất sau tiền huấn luyện.
Với tập "consensus" chỉ giữ các cặp mà bộ đánh giá nhất quán, tỷ lệ bản hoàn thiện được ưa thích hơn mô hình gốc đạt 69,05%. Tham số beta 0,10 phạt quá mạnh và làm kết quả xấu đi.
Những gì không hiệu quả
Tác giả liệt kê khá thẳng: biểu diễn nhấn/nhả phím bị trôi trạng thái với mô hình nhỏ chạy thời gian thực; chuỗi token ép ngữ pháp hợp lệ nhưng chậm; mở rộng dữ liệu ồn làm kết quả tệ hơn; mô hình lớn hơn không tự hết lặp; Mirostat giảm lặp nhưng làm đầu ra rời rạc.
Điểm đáng lưu ý: loss kiểm định một mình bỏ sót khác biệt về chất lượng thực tế khi chạy liên tục.
Đóng gói lên iPhone
Mô hình được xuất từ PyTorch sang Core ML, lượng tử hóa trọng số xuống INT8. Lần khởi động đầu vẫn chậm vì runtime của Apple tối ưu mô hình cho phần cứng.
Mô hình chỉ học với ngữ cảnh tối đa 512 nốt. Khi phiên chơi dài gần chạm giới hạn, ứng dụng giữ 384 nốt gần nhất và dựng lại ngữ cảnh từ đó, chấp nhận dựng lại KV cache. Core ML không cho truy cập trực tiếp Q, K, V nên chưa thể dùng vòng đệm (ring buffer) với RoPE.
Tác giả tự so sánh sản phẩm với GPT-2 thời kỳ đầu: vẫn thỉnh thoảng lặp, khó với đoạn gợi ý ngắn, còn nhiều thứ muốn cải thiện. Bản mới đang chờ duyệt bổ sung tùy chọn các phương pháp lấy mẫu top-k, top-p, min-p, XTC, top-h và Mirostat v2.
Góc nhìn
Dự án này cho thấy một mô hình 125 triệu tham số, nhỏ hơn nhiều so với các mô hình ngôn ngữ phổ biến, vẫn đủ sức chạy thời gian thực trên điện thoại nếu biểu diễn dữ liệu được thiết kế đúng. Với kỹ sư Việt Nam làm ứng dụng di động hoặc thiết bị biên (edge), bài học đáng giá nằm ở phần tiền xử lý và chọn biểu diễn, chứ không phải ở kiến trúc mạng.
Cách tác giả dùng một mô hình lớn để chấm điểm so sánh cặp cũng là hướng thực dụng khi thiếu người đánh giá chuyên môn. Nhóm nhỏ có thể tái sử dụng cách này để tinh chỉnh mô hình mà không cần dựng đội gán nhãn lớn.
Việc chuyển sang Core ML và lượng tử hóa INT8 là con đường quen thuộc để đưa mô hình học sâu lên thiết bị. Hạn chế truy cập Q, K, V của Core ML là điểm cần lưu ý khi lên kế hoạch tối ưu ngữ cảnh dài.
Nguồn: simedw.com · Quy trình biên tập