
Từ script Python dài hơi đến nền tảng tự phục vụ: Bài học về hàng đợi, khôi phục lỗi và tái lập kết quả
Khi nhiều người cùng phụ thuộc vào các mô phỏng Python chạy hàng giờ, nút thắt không còn là máy móc mà là khả năng điều phối công việc. Bài viết phân tích cách tách việc nộp job khỏi việc thực thi, quản lý trạng thái đáng tin cậy, cô lập giữa các lần chạy và đảm bảo tái lập kết quả trên nền AWS.
Từ script Python dài hơi đến nền tảng tự phục vụ: Bài học về hàng đợi, khôi phục lỗi và tái lập kết quả
Một mô phỏng Python chạy hàng giờ đồng hồ trông giống bài toán tính toán — chừng nào chỉ có một người dùng nó. Nhưng khi nhiều người cùng nộp job, mọi thứ thay đổi: hàng đợi, trạng thái, cô lập giữa các lần chạy và khả năng tái lập kết quả trở thành những vấn đề khó hơn cả tốc độ xử lý.
Bài viết dưới đây tổng hợp kinh nghiệm thực tế từ việc xây dựng hạ tầng mô phỏng giao thông trên AWS, cùng một bản tham chiếu cục bộ dùng SQLite để minh họa các nguyên lý cốt lõi.
Nút thắt không nằm ở sức mạnh tính toán
Khi chỉ một người chạy mô phỏng, cách xử lý rất đơn giản: máy nào chạy được thì chạy, chậm thì nâng cấu hình, lỗi thì đọc traceback. Nhưng khi số người dùng tăng lên, mọi thứ đổ vỡ theo một cách khác hẳn.
- Nhiều người cùng muốn nộp mô phỏng, mỗi job kéo dài hàng giờ
- Yêu cầu đến nhanh hơn tốc độ hoàn thành
- Một số lần chạy chết giữa chừng
- Ai đó cần lại kết quả của tháng trước và mong nhận được đúng con số cũ
- Mọi người muốn biết job của mình đang chờ, đang chạy, thất bại hay đã xong
- Không ai muốn job này ảnh hưởng job kia, hay máy móc ngốn tiền trong lúc hàng đợi rỗng
 Minh họa hàng đợi công việc trong nền tảng mô phỏng
Điểm mấu chốt: thêm máy chỉ nâng trần lý thuyết, nhưng không giải quyết được xếp hàng, cô lập giữa các lần chạy hay việc thực thi trùng lặp. Trạng thái đáng tin cậy, khôi phục sau lỗi, khả năng truy vết và tái lập vẫn y nguyên. Câu hỏi chuyển từ "làm sao chạy nhanh hơn" sang "làm sao để nhiều người nộp việc an toàn, thấy được tiến trình và phục hồi khi có sự cố".
Tách việc nộp job khỏi việc thực thi
Quyết định quan trọng nhất là tách quá trình nộp job khỏi quá trình chạy mô phỏng. Một tiến trình phía người dùng vừa khởi động mô phỏng vừa chờ kết quả sẽ gánh quá nhiều trách nhiệm: kiểm tra đầu vào, thực thi, vòng đời hạ tầng và trạng thái job bị dính chặt vào nhau.
Hệ quả là chỉ cần mất kết nối hoặc khởi động lại là công việc dang dở, còn câu hỏi "khi nào nên cấp tài nguyên tính toán" bị trộn lẫn với "khi nào người dùng bấm nộp".
Hướng tiếp cận đã áp dụng:
- Lưu cấu hình và tham chiếu đầu vào trước, cấp mỗi lần chạy một job ID duy nhất
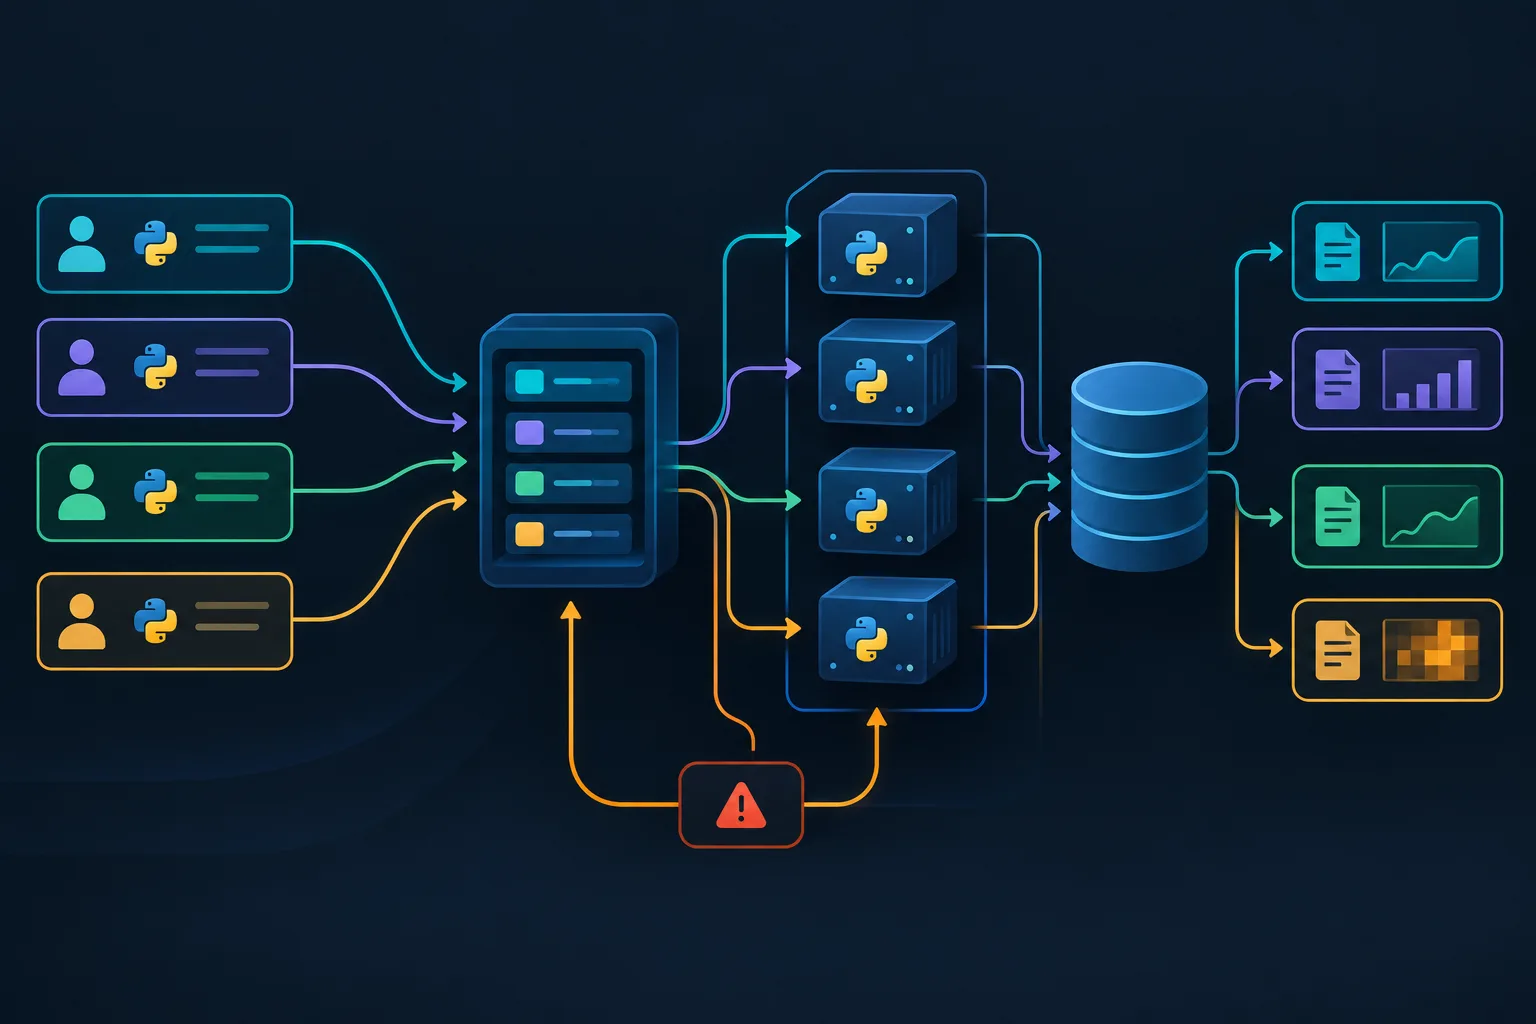
- Đưa công việc vào SQS để xử lý bất đồng bộ
- Dùng Lambda làm lớp điều phối, khởi tạo môi trường EC2 riêng cho từng mô phỏng
- S3 giữ các artifact bền vững: đầu vào, cấu hình, log và kết quả
- Redshift lưu kết quả có cấu trúc để so sánh giữa các lần chạy
Hàng đợi không chỉ "giúp mở rộng". Nó dịch chuyển điểm gặp nhau giữa nhu cầu và năng lực: một đợt nộp dồn dập trở thành backlog rút dần theo tốc độ cho phép. Đó chính là back-pressure, và người dùng không cần bận tâm về nó.
Tuy nhiên, hàng đợi chuẩn của SQS giao ít nhất một lần, nghĩa là cùng một message có thể xuất hiện hai lần. Mọi thành phần phía sau đều phải được viết với giả định đó.
Trạng thái khó hơn tưởng tượng
Giữ trạng thái job đáng tin cậy xuyên suốt các thành phần bất đồng bộ là phần khó nhất. Một mô phỏng không kết thúc chỉ vì message đã đến, instance EC2 đã khởi động hay tiến trình Python đã thoát.
Trạng thái hạ tầng và trạng thái job là hai thứ khác nhau. Một instance còn sống không có nghĩa mô phỏng đang thực sự chạy, và một tiến trình trả về mã 0 không chứng minh job đã hoàn thành.
Các cơ chế được dùng để xử lý:
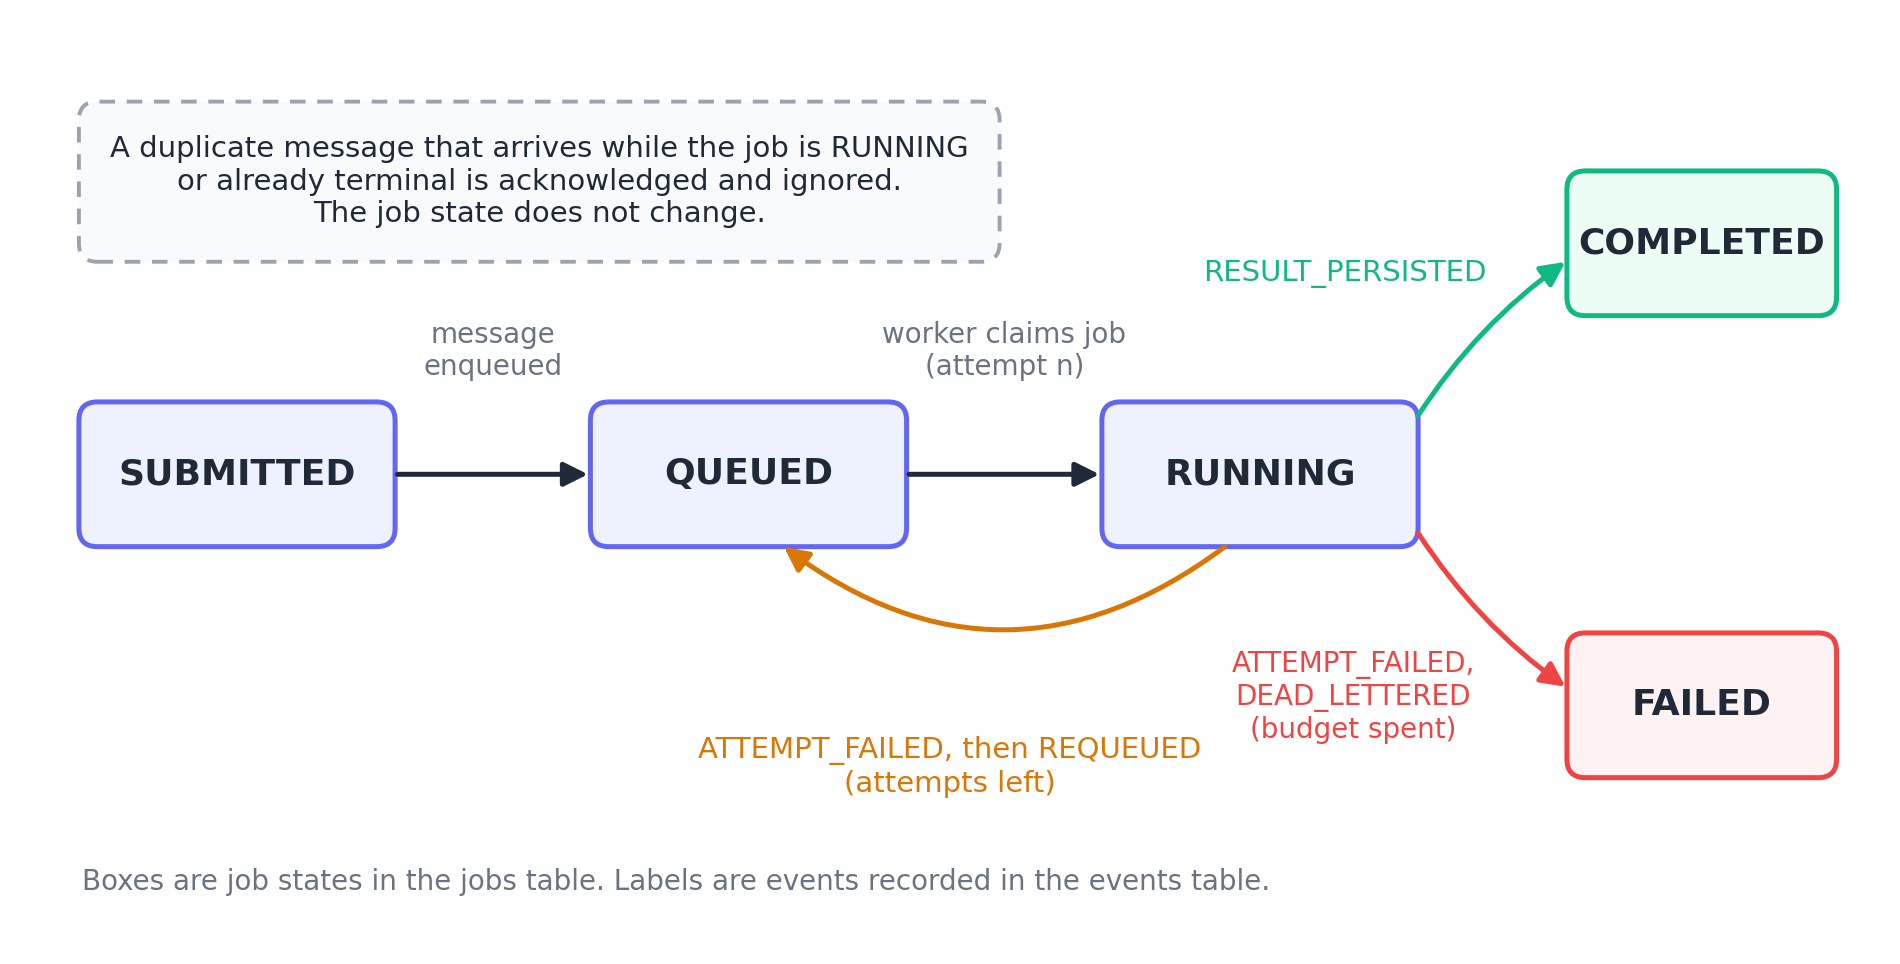
- Job ID duy nhất và chuyển trạng thái tường minh
- Idempotency để chống thực thi trùng
- Lưu trạng thái và bản ghi thực thi bền vững
- Checkpointing và số lần thử có giới hạn
- Dead-letter queue cho các job thất bại vĩnh viễn
Trong bản demo cục bộ, message trên hàng đợi chỉ là gợi ý rằng có thể có việc, còn bản ghi job mới là nơi quyết định cuối cùng. Khi job đã ở trạng thái kết thúc hoặc đang chạy, message trùng lặp được xác nhận và bỏ qua một cách vô hại.
Một điểm cần lưu ý: thử lại chỉ an toàn khi hệ thống biết lần chạy trước để lại gì. Mỗi lần thử có thư mục riêng, để lần thất bại vẫn còn đó cho việc kiểm tra, còn lần kế tiếp bắt đầu sạch sẽ.
Bản demo có giới hạn rõ ràng: nó không mô hình hóa trường hợp worker biến mất giữa chừng, không có checkpoint, không có timeout thực thi và hàng đợi cục bộ không có visibility timeout để thu hồi công việc bị bỏ rơi. Trên SQS, visibility timeout sẽ đưa message chưa được xác nhận trở lại hàng đợi sau khi hết hạn.
Cô lập là điều kiện để chạy song song an toàn
Thêm worker không tự động làm cho việc chạy đồng thời trở nên an toàn. Các job cần tránh đường của nhau: không dùng chung file tạm, không tranh chấp phụ thuộc, không kế thừa tàn dư từ lần chạy trước.
Trong hệ thống thực tế, mỗi mô phỏng chạy trong một môi trường EC2 riêng — có cấu hình, ngữ cảnh thực thi, trạng thái tạm, ranh giới tài nguyên, log và đường dẫn đầu ra riêng. Một lần chạy hết tài nguyên hoặc chết sẽ không làm hỏng lần chạy nào khác, và lỗi có thể truy ngược về đúng job và đúng instance.
Bản demo cục bộ đã thử nghiệm với bốn job độc lập, seed khác nhau:
- Một worker xử lý tuần tự: 14,623 giây
- Bốn worker song song: 4,652 giây, tăng tốc gấp 3,14 lần
Đây chỉ là kết quả từ một thử nghiệm cục bộ duy nhất, phụ thuộc môi trường và số nhân CPU — không phải benchmark AWS. Điều quan trọng hơn: cả bốn job đều hoàn thành, mỗi job giữ thư mục riêng và các seed khác nhau cho ra checksum khác nhau.
Tất nhiên, subprocess là ranh giới yếu hơn nhiều so với một máy riêng. Bốn job vẫn dùng chung một host, một bể CPU/bộ nhớ và một cơ sở dữ liệu SQLite.
Kết quả đã lưu không đồng nghĩa với lần chạy tái lập được
Đây là điều cần ưu tiên hơn cả nếu làm lại từ đầu. Một kết quả đã lưu chỉ cho biết cái gì đã ra, còn một thử nghiệm tái lập được thì cho biết dữ liệu, tham số, mã nguồn và môi trường nào đã tạo ra nó.
Bản demo xây dựng theo từng lớp:
- Hash cấu hình xác định điều gì đã được yêu cầu
- Checksum kết quả xác định điều gì đã trả về (cố ý bỏ qua thời gian chạy thực tế, để hai lần chạy tương đương vẫn so sánh được khi máy chạy tốc độ khác nhau)
- Manifest thực thi ghi lại hash của mã mô phỏng, phiên bản Python, nền tảng, thời gian thực thi
Thử nghiệm với hai job có job ID khác nhau nhưng cấu hình và seed giống hệt: cả hai đều hoàn thành và cho ra cùng hash cấu hình lẫn checksum kết quả, mỗi job có manifest riêng. Hai lần thực thi không cần chung "danh tính vận hành" để giống nhau về mặt khoa học.
Hạn chế: bản demo không có dataset đầu vào, không ghi phiên bản thư viện phụ thuộc. Một manifest đầy đủ trong production nên bao gồm phiên bản dependency, dữ liệu lockfile hoặc tốt hơn là digest của container image.
Thu nhỏ tài nguyên tính toán khi rỗng
Nền tảng gốc chỉ khởi động tài nguyên tính toán khi có việc cần làm. Với năng lực chạy thường trực, độ trễ khởi động thấp và lập lịch đơn giản hơn, nhưng phải trả tiền cho tài nguyên nhàn rỗi. Khởi động theo nhu cầu cắt chi phí đó, đổi lại là độ trễ khởi động, nhu cầu điều phối mạnh hơn, health check chặt hơn và — quan trọng nhất — trạng thái job đáng tin cậy.
Hiệu quả chi phí và độ tin cậy hóa ra lại củng cố lẫn nhau. Một instance biến mất sau khi xong việc thì không được phép giữ bất cứ thứ gì đáng lưu. Điều này buộc hệ thống phải có ranh giới job sạch hơn và trạng thái bền vững hơn.
Hai con số đáng chú ý từ dự án:
- Các nhóm có thể chạy xấp xỉ gấp 3 lần số thử nghiệm mô phỏng so với quy trình thủ công trước đó — nhờ nộp tự phục vụ, hàng đợi bất đồng bộ, thực thi cô lập, chứ không phải nhờ thêm máy
- Chi phí tài nguyên tính toán nhàn rỗi gần như về 0, áp dụng riêng cho lớp EC2 thực thi
Nếu làm lại, sẽ thay đổi điều gì
Các nguyên lý vẫn giữ nguyên: lưu trữ đối tượng bền vững cho artifact, bộ đệm bất đồng bộ với back-pressure, tài nguyên theo nhu cầu và tách bạch rõ ràng giữa control plane và execution plane.
Những thay đổi đáng cân nhắc:
- Đánh giá AWS Batch hoặc ECS trước khi tự quản lý EC2 trực tiếp. Định nghĩa job dạng container giúp phụ thuộc, phân bổ tài nguyên, tái lập và dọn dẹp trở nên tường minh thay vì phó mặc cho script
- Thử Step Functions cho vòng đời kiểm tra, cấp phát, thực thi, khôi phục checkpoint và xử lý lỗi — để các bước chuyển trạng thái hiện ra ở một chỗ thay vì rải rác trong code điều phối tùy chỉnh
- Không chọn Kubernetes chỉ vì nó làm được nhiều thứ. Tính linh hoạt là thật, nhưng chi phí vận hành và control-plane cũng thật — chỉ nên dùng nếu tổ chức đã vận hành sẵn
- Đưa manifest, lineage và tái lập thành tính năng hạng nhất ngay từ ngày đầu
Kết luận
Nhìn lại toàn bộ dự án, tính toán chưa bao giờ là phần khó. Mô phỏng có thể chạy song song trên EC2, trên compute do AWS Batch quản lý hay trong subprocess cục bộ.
Điều khiến nền tảng đáng tin cậy là cách đối xử với mỗi mô phỏng như một đơn vị công việc được quản lý: có danh tính, có vòng đời, có thực thi tách biệt, có hành vi thất bại trong giới hạn và có bản ghi về những gì đã xảy ra cùng cách nó đi đến đó.
Thêm máy có thể giúp mô phỏng chạy song song, nhưng chỉ có trạng thái job tường minh, cô lập, tái lập và khôi phục lỗi mới biến chúng thành một nền tảng tự phục vụ đáng tin cậy. Với một kỹ sư khác, phiên bản ngắn gọn là: một nền tảng mô phỏng đa người dùng gần với hệ thống điều khiển job và lưu bằng chứng hơn là một cụm máy móc.
Bài viết liên quan
Công nghệ
GitHub lại gặp sự cố: Chậm trễ xử lý Pull Request và giao hàng webhook
21 tháng 10, 2026
Công nghệ
Sumi.css: Framework CSS tối giản, chỉ 6,7 KB và không cần viết class
21 tháng 10, 2026
Phần mềm
Lỗ hổng nghiêm trọng trong PHP khiến cả Internet chao đảo: 'Đây không phải là diễn tập'
21 tháng 10, 2026