
Uber chống bão retry như thế nào: Bí quyết giữ hệ thống không sụp đổ dây chuyền
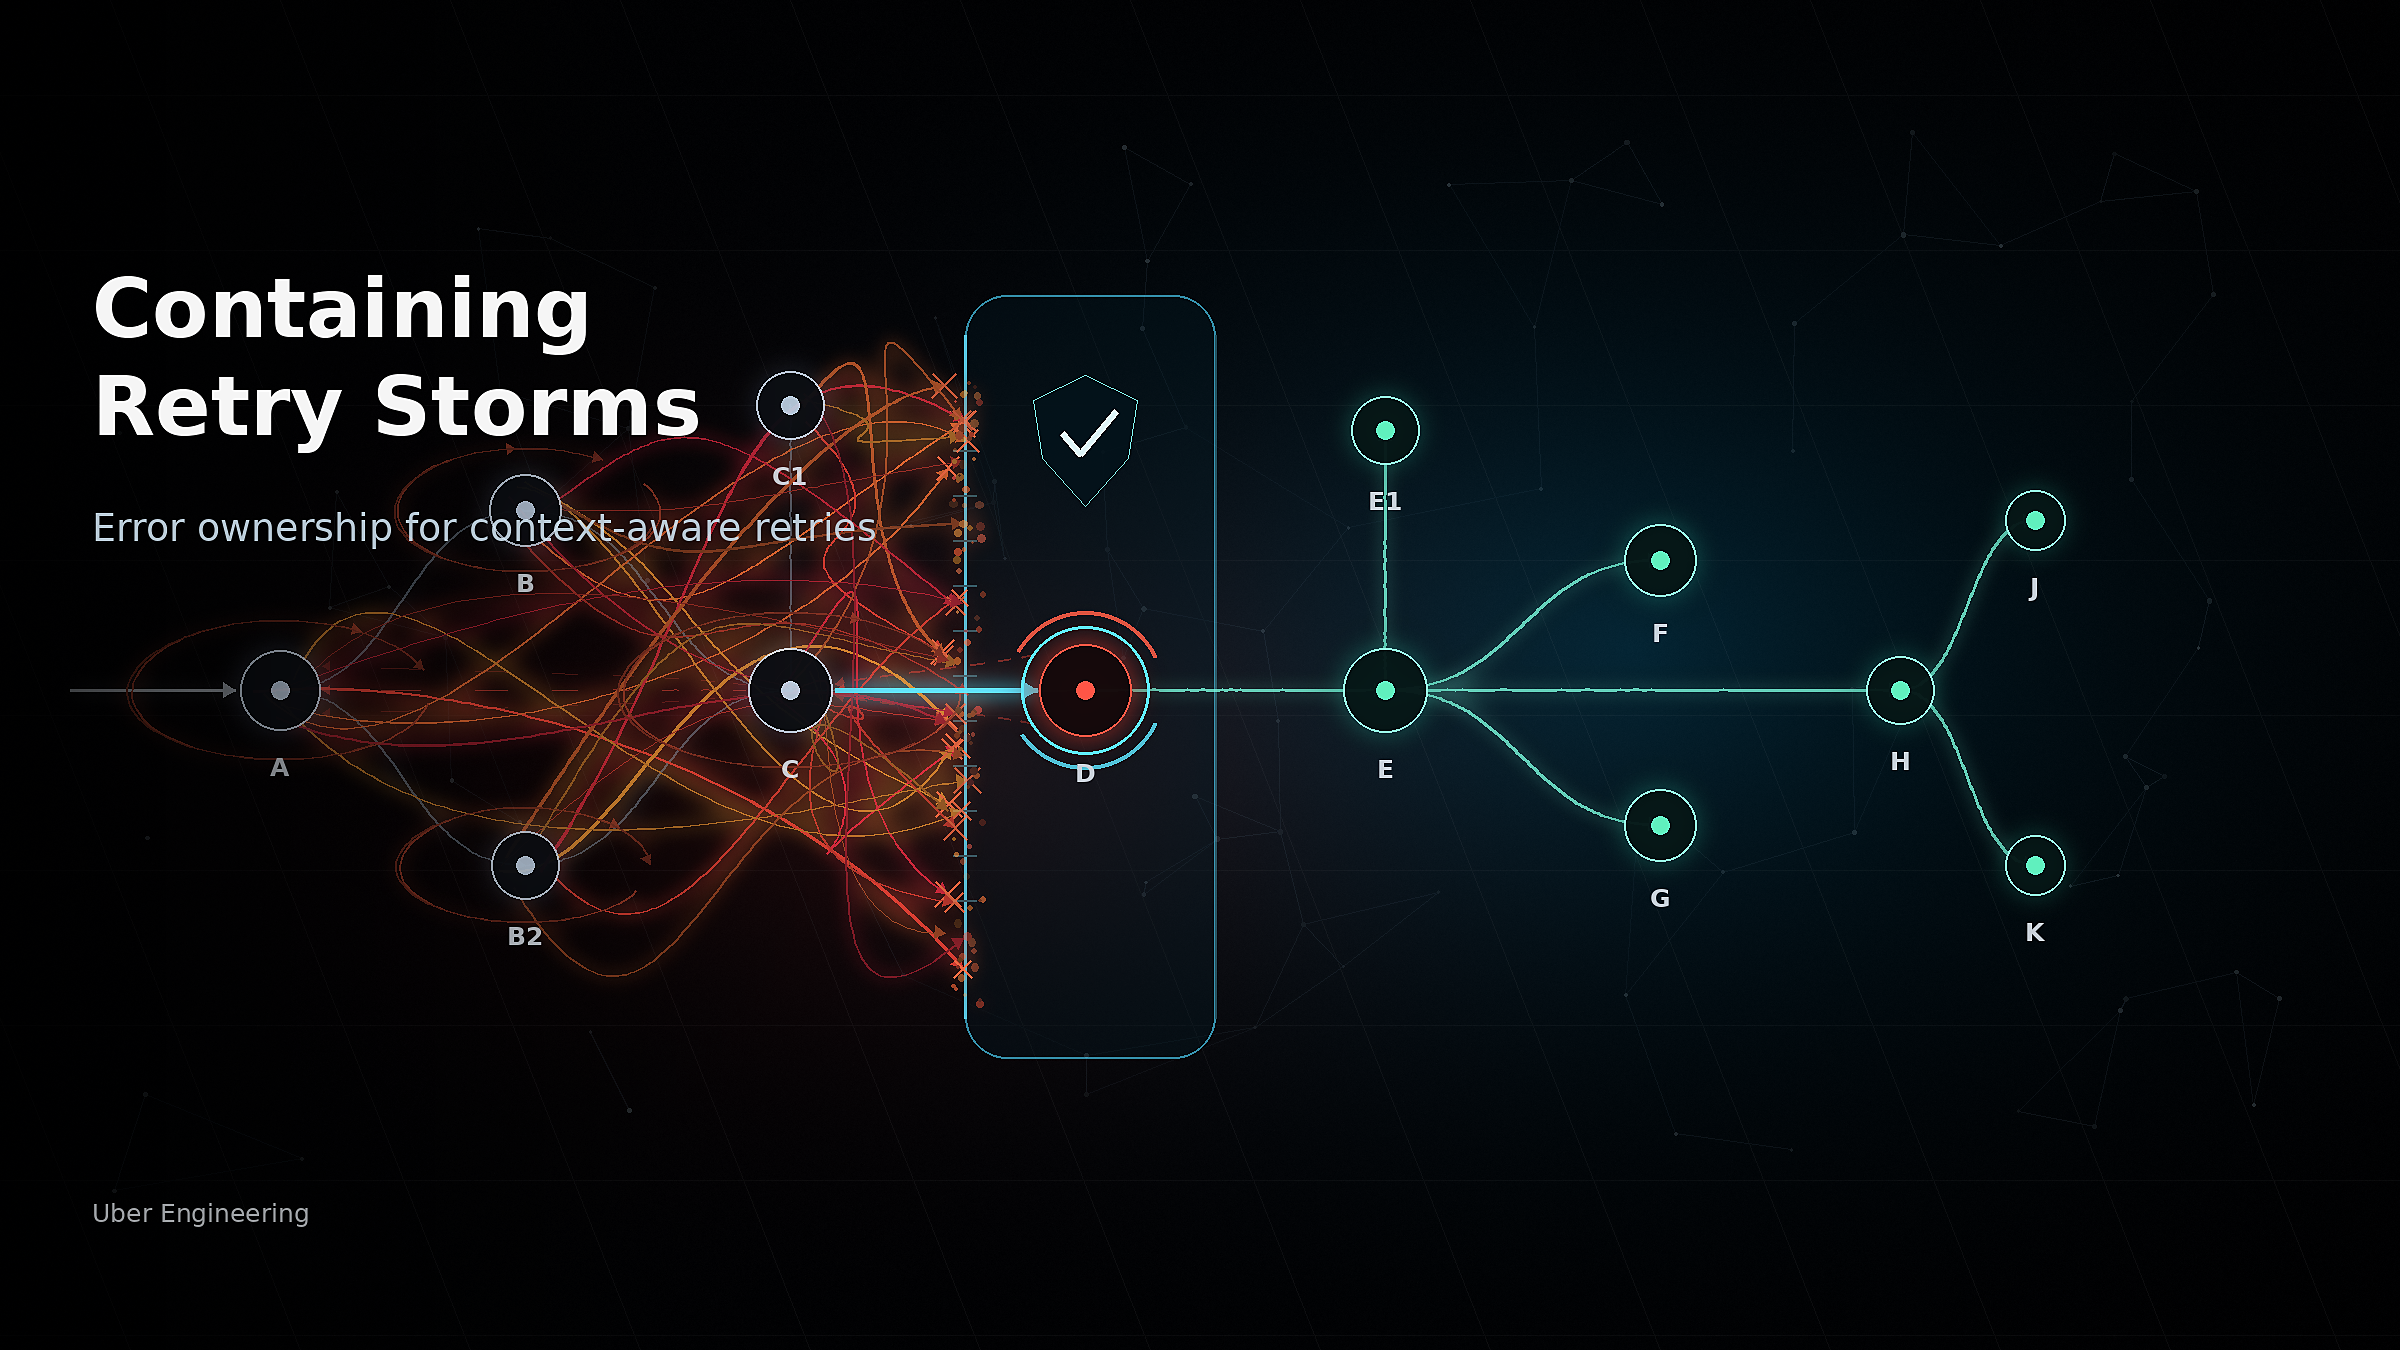
Uber đã phát triển cơ chế "quyền sở hữu lỗi" (error ownership) nhằm ngăn chặn hiện tượng bão retry — khi việc thử lại liên tục làm tê liệt các dịch vụ vốn đã quá tải. Trong sự cố ngày 18/11/2025, giải pháp này đã giúp chặn đứng tới 9,5 triệu yêu cầu dư thừa, giảm bán kính bão retry từ 25 tầng xuống chỉ còn 3.
Uber chống bão retry như thế nào: Bí quyết giữ hệ thống không sụp đổ dây chuyền
Trong thế giới vi dịch vụ (microservices), retry (thử lại) là con dao hai lưỡi. Khi một dịch vụ gặp lỗi tạm thời, việc thử lại giúp hệ thống tự phục hồi. Nhưng khi dịch vụ đó đã quá tải, chính những lần thử lại ấy lại trở thành gánh nặng nhấn chìm cả hệ thống — hiện tượng được gọi là retry storm (bão retry).
Uber, với hệ thống dịch vụ trải dài hàng chục tầng phụ thuộc, từng đối mặt với bài toán này. Đội ngũ kỹ sư của hãng đã phát triển một cơ chế gọi là quyền sở hữu lỗi (error ownership) để giải quyết triệt để vấn đề. Bài viết này sẽ phân tích cách họ làm điều đó.
Vấn đề: Bão retry lan rộng theo cấp số nhân
Hãy tưởng tượng một chuỗi gọi dịch vụ đơn giản: Node A gọi Node B, B gọi C, C gọi D... mỗi tầng một lệnh. Trong trạng thái bình thường, mỗi node chỉ phục vụ đúng bằng lưu lượng đầu vào.
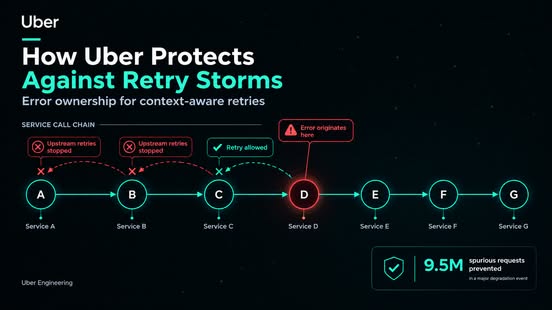 Minh họa chuỗi gọi dịch vụ với fan-out 1:1
Nhưng nếu Node D bắt đầu lỗi và mỗi tầng đều được cấu hình thử lại một lần, số lượng yêu cầu sẽ bùng nổ theo cấp số nhân. Với Ƞ là lưu lượng gốc, số yêu cầu tại tầng có độ sâu d (khi có R lần retry) sẽ là:
R^d × Ƞ
Nếu R = 2 (1 lần gọi gốc + 1 lần thử lại), tới tầng thứ 6, lưu lượng đã tăng gấp 64 lần so với bình thường. Đây chính là cơ chế khiến một sự cố nhỏ ở tầng sâu có thể đánh sập toàn bộ hệ thống.
Retry budget: Giải pháp nửa vời
Các kỹ sư Uber đã thử áp dụng retry budget (ngân sách thử lại) — giới hạn tỷ lệ phần trăm số yêu cầu được phép thử lại. Với ngân sách 10%, số yêu cầu tại tầng d chỉ còn:
(1 + B)^d × Ƞ
Với B = 0.1, tới tầng 6, lưu lượng chỉ tăng khoảng 1,33 lần — dễ chịu hơn nhiều so với 64 lần. Tuy nhiên, retry budget vẫn có điểm yếu chí mạng: nó không phân biệt được đâu là lỗi thực sự có thể phục hồi và đâu là lỗi do quá tải.
Khi một dịch vụ bị quá tải, xác suất thử lại thành công rất thấp. Việc tiếp tục thử lại chỉ làm dịch vụ đó thêm kiệt quệ, kéo dài sự cố. Đây là lúc cần đến một cơ chế thông minh hơn.
Quyền sở hữu lỗi: Ai gây ra, người đó chịu
Ý tưởng cốt lõi của Uber rất đơn giản: chỉ cho phép thử lại ở nơi lỗi thực sự phát sinh. Nếu dịch vụ A gọi dịch vụ B và nhận lỗi từ B, thì A không được phép thử lại — vì A không phải là "chủ sở hữu" của lỗi đó. Ngược lại, nếu A gọi B thành công nhưng vẫn trả về lỗi cho cấp trên, thì A chính là chủ sở hữu lỗi và được phép thử lại.
Cơ chế này dựa trên một hệ thống gọi là Service Dependency Analysis Solution — có nhiệm vụ tương quan giữa lỗi đầu vào (inbound) và lỗi đầu ra (outbound) để xác định ai thực sự gây ra lỗi.
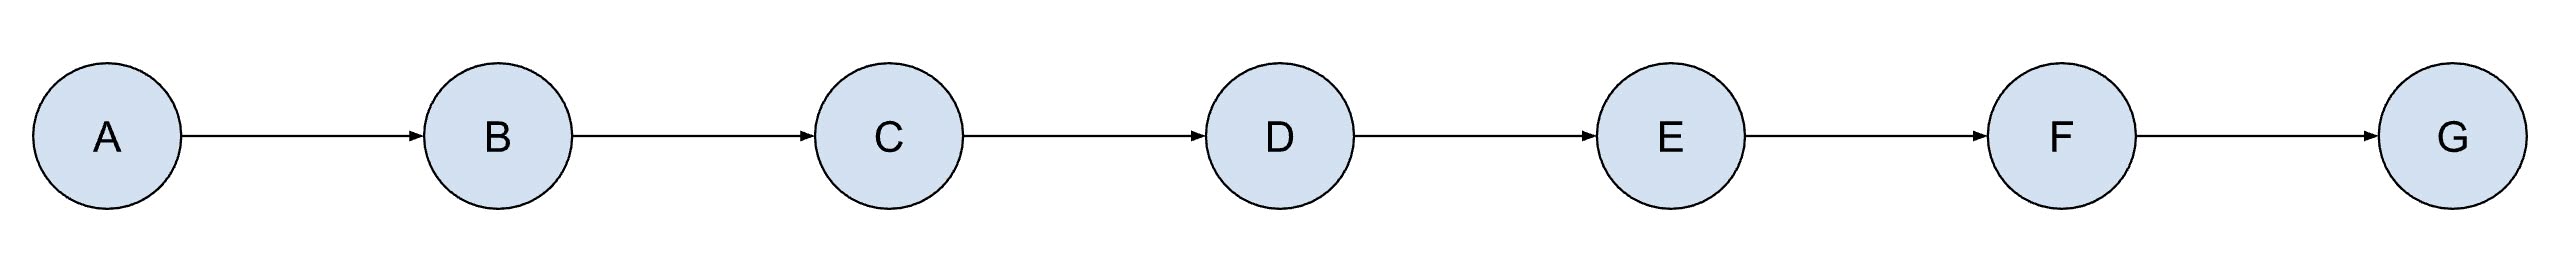 Sơ đồ logic xác định quyền sở hữu lỗi
Khi một dịch vụ nhận lỗi từ downstream (cấp dưới), nó sẽ kiểm tra xem lỗi đó có phải do chính downstream gây ra không. Nếu đúng, nó giữ nguyên header "đã có chủ" và không thử lại. Khi truyền lỗi lên cấp trên, nó đánh dấu "vô chủ" để ngăn cấp trên thử lại. Nhờ vậy, bão retry bị chặn đứng ngay từ gốc.
Kết quả thực tế: Sự cố ngày 18/11/2025
Ngày 18 tháng 11 năm 2025, Uber gặp một sự cố nghiêm trọng khi một dịch vụ Core Entity — nằm sâu hơn 5 tầng trong chuỗi gọi — bắt đầu trả về tỷ lệ lỗi cực cao do vấn đề hạ tầng. Lỗi này nhanh chóng lan ngược lên trên.
Nếu chỉ dùng retry budget thông thường, lưu lượng tới dịch vụ bị lỗi sẽ tăng thêm 46% đến 135%, kéo dài sự cố và giảm cơ hội phục hồi. Nhưng nhờ error ownership đã được bật sẵn trong production, hệ thống đã tự động khoanh vùng thiệt hại:
- Chặn đứng các lần thử lại ngay tại tầng gọi trực tiếp, có nơi giảm tới 200.000 yêu cầu không cần thiết.
- Tính toán tổng thể, hệ thống đã ngăn được 9,5 triệu yêu cầu dư thừa trong service mesh.
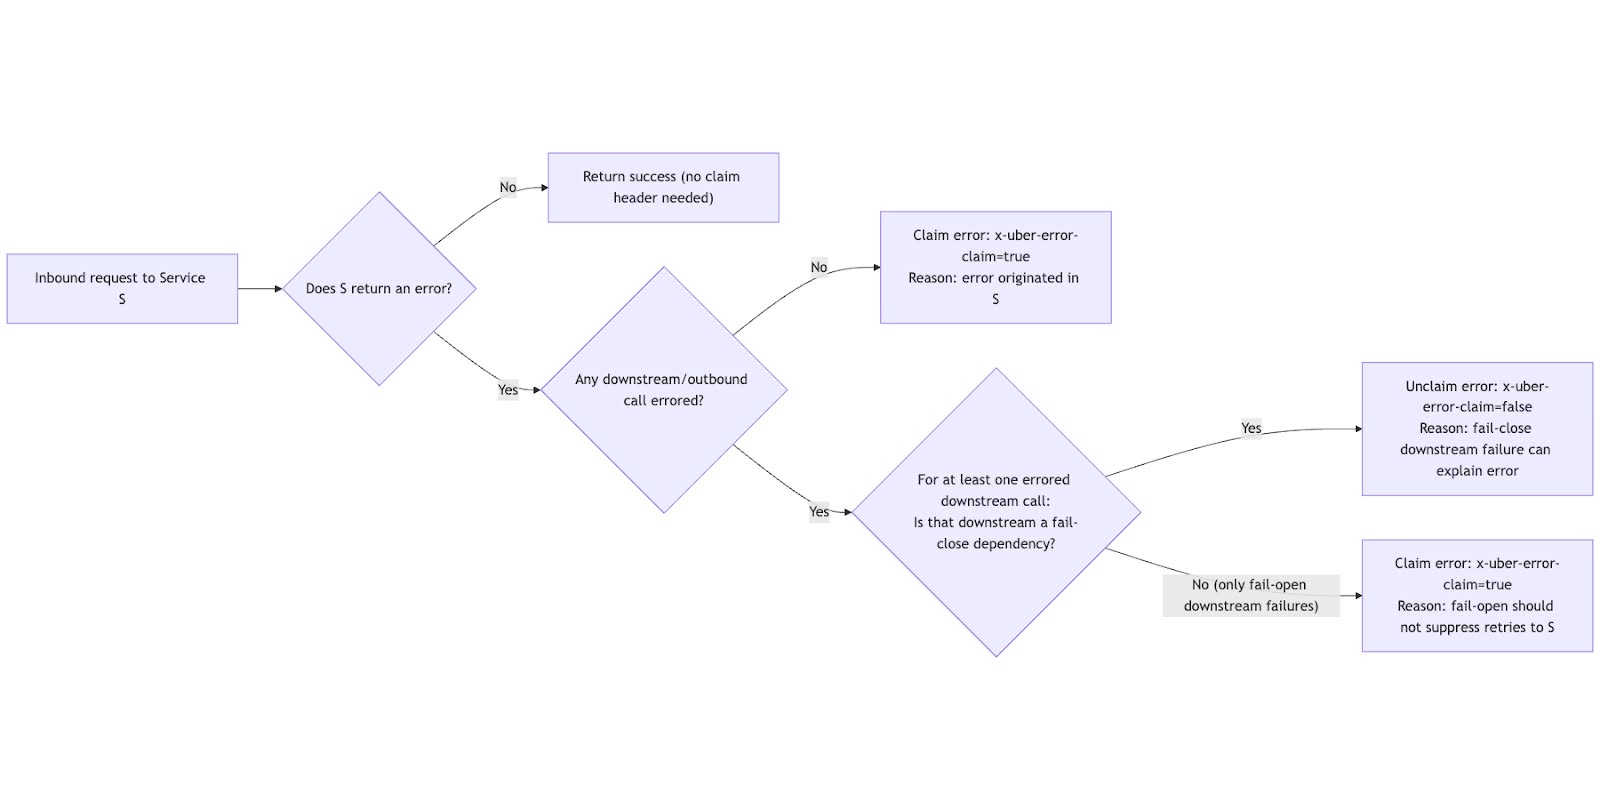 Biểu đồ bán kính bão retry sau khi áp dụng error ownership
Giảm bán kính bão retry xuống mức tối thiểu
Uber định nghĩa bán kính bão retry tối đa (max retry storm radius) là độ sâu lớn nhất trong chuỗi gọi mà bão retry có thể xảy ra. Trước khi có error ownership, con số này lên tới 25 tầng. Sau khi triển khai, nó giảm xuống chỉ còn tối đa 3 tầng, và trung bình từ 20 xuống còn 2.
Điều này có nghĩa là dù một dịch vụ ở tầng sâu có sập hoàn toàn, sóng xung kích cũng chỉ lan được vài tầng trước khi bị chặn đứng. Hạ tầng của Uber nhờ đó được bảo vệ khỏi hiệu ứng domino vốn là cơn ác mộng của mọi hệ thống phân tán quy mô lớn.
Bài học cho các hệ thống Việt Nam
Với các doanh nghiệp công nghệ Việt Nam đang xây dựng hệ thống vi dịch vụ — từ fintech, thương mại điện tử đến các nền tảng gọi xe — bài học từ Uber rất đáng tham khảo:
- Đừng thử lại một cách mù quáng. Cần có cơ chế phân biệt lỗi tạm thời và lỗi do quá tải.
- Retry budget là chưa đủ. Nó giới hạn số lượng nhưng không kiểm soát được "thời điểm" và "ngữ cảnh" của retry.
- Đầu tư vào observability. Hệ thống phân tích phụ thuộc dịch vụ là nền tảng để xác định chính xác nguồn gốc lỗi.
- Thiết kế để chịu lỗi, không phải để tránh lỗi. Sự cố là không thể tránh khỏi; điều quan trọng là khoanh vùng và ngăn chặn lan rộng.
Cách tiếp cận của Uber cho thấy một nguyên tắc quan trọng trong thiết kế hệ thống phân tán: thay vì cố gắng thử lại nhiều hơn, hãy thử lại thông minh hơn. Đôi khi, việc chấp nhận thất bại ở một điểm nhỏ lại là cách tốt nhất để bảo vệ toàn bộ hệ thống.