Unsloth ra mắt GGUF Qwen3.8-27B Dynamic V3.1, tăng 5-10% độ chính xác
Unsloth phát hành bộ lượng tử hóa (quantization) GGUF mới cho Qwen3.8-27B dựa trên thuật toán Unsloth Dynamic V3.1 (bản xem trước), giúp tăng 5-10% độ chính xác ở cùng dung lượng trên hầu hết các benchmark như Terminal Bench 2.1, DeepSWE 1.1 và LiveCodeBench v6. Bản cập nhật áp dụng cho hầu hết các mức lượng tử từ 2-bit đến 6-bit, trong khi mức 3-bit giữ nguyên do chất lượng đã tương đương.
Unsloth vừa phát hành bộ lượng tử hóa (quantization) GGUF mới cho Qwen3.8-27B, sử dụng thuật toán Unsloth Dynamic V3.1 ở dạng xem trước. Theo nhóm phát triển, các bản quant mới đạt độ chính xác cao hơn 5-10% so với bản cũ ở cùng dung lượng trên hầu hết các benchmark, bao gồm cả tác vụ lập trình tác tử (agentic coding), khối lượng công việc tác tử và hội thoại thông thường.
Đây là bản cập nhật ngày 11/11/2026, được Unsloth công bố cùng tài liệu hướng dẫn chạy Qwen3.8. Bản V3.1 được áp dụng cho hầu hết các mức lượng tử từ 2-bit đến 6-bit; riêng mức 3-bit (UD3) không được cập nhật vì nhóm nghiên cứu nhận thấy chất lượng đã tương đương bản mới.
Qwen3.8-27B có gì đáng chú ý
Qwen3.8-27B là mô hình dày (dense) 27 tỷ tham số của Qwen, hỗ trợ cả năng lực thị giác lẫn suy luận, với cửa sổ ngữ cảnh 256K và có thể chạy cục bộ trên cấu hình chỉ 17GB RAM/VRAM. Mô hình được đánh giá mạnh ở các tác vụ lập trình tác tử, thị giác và hội thoại.
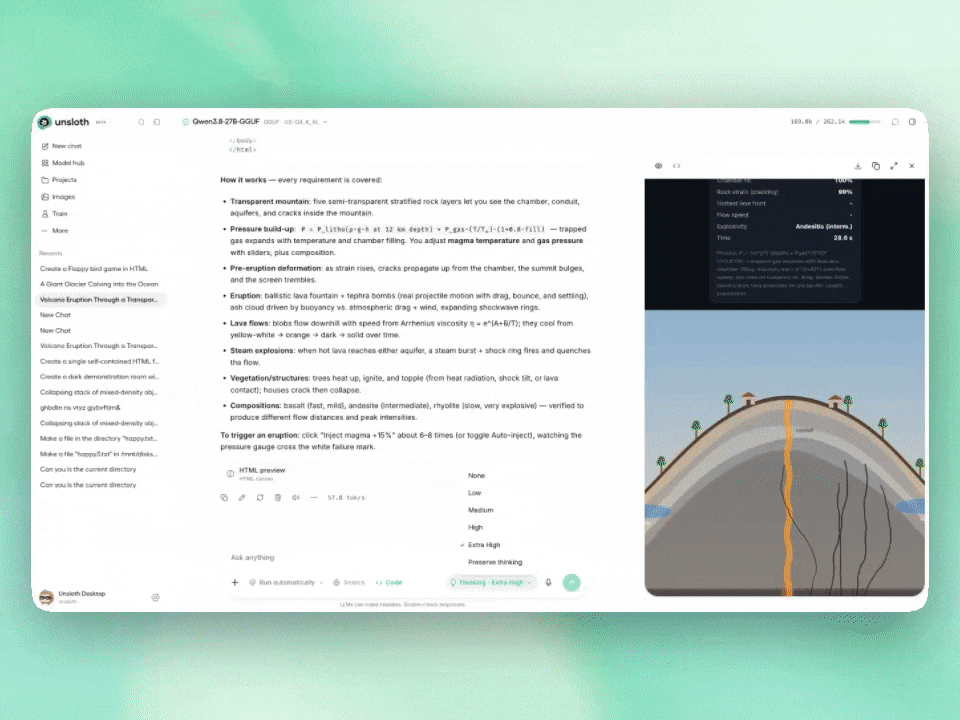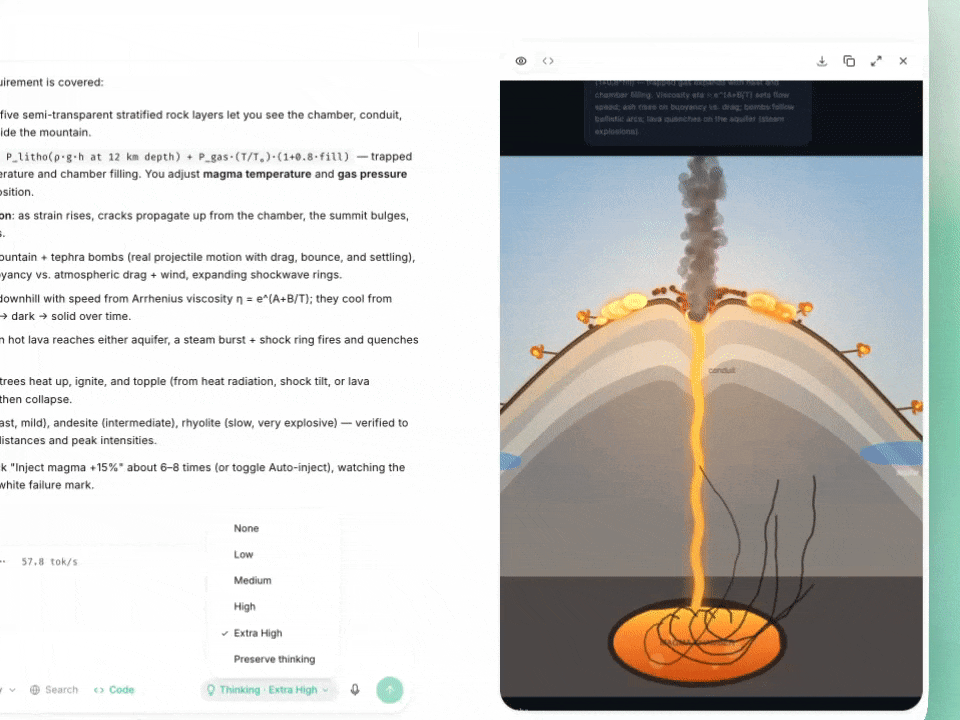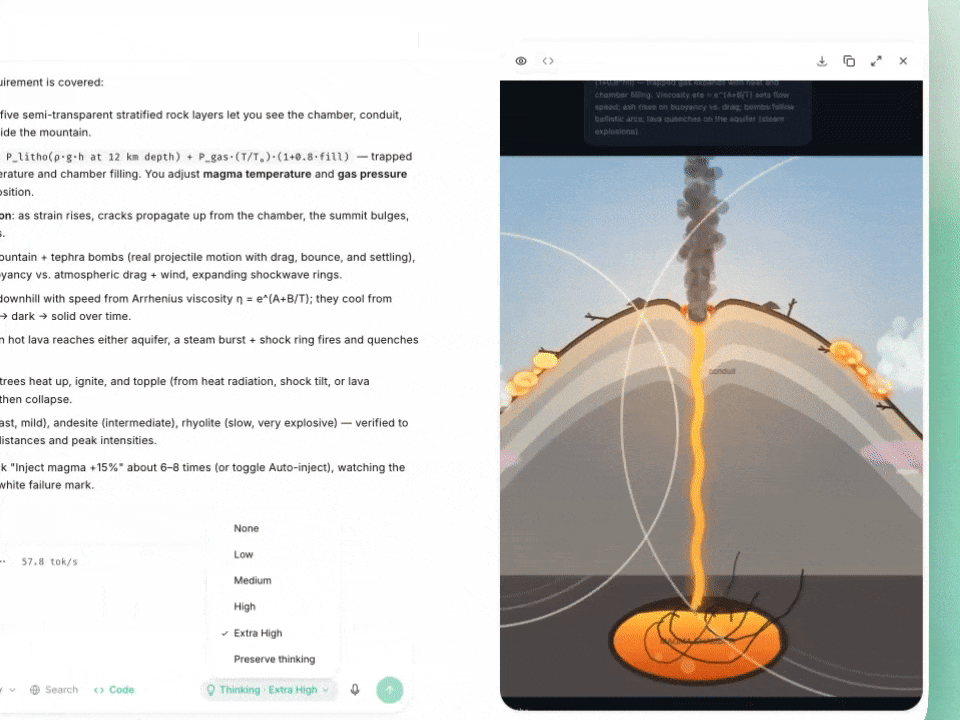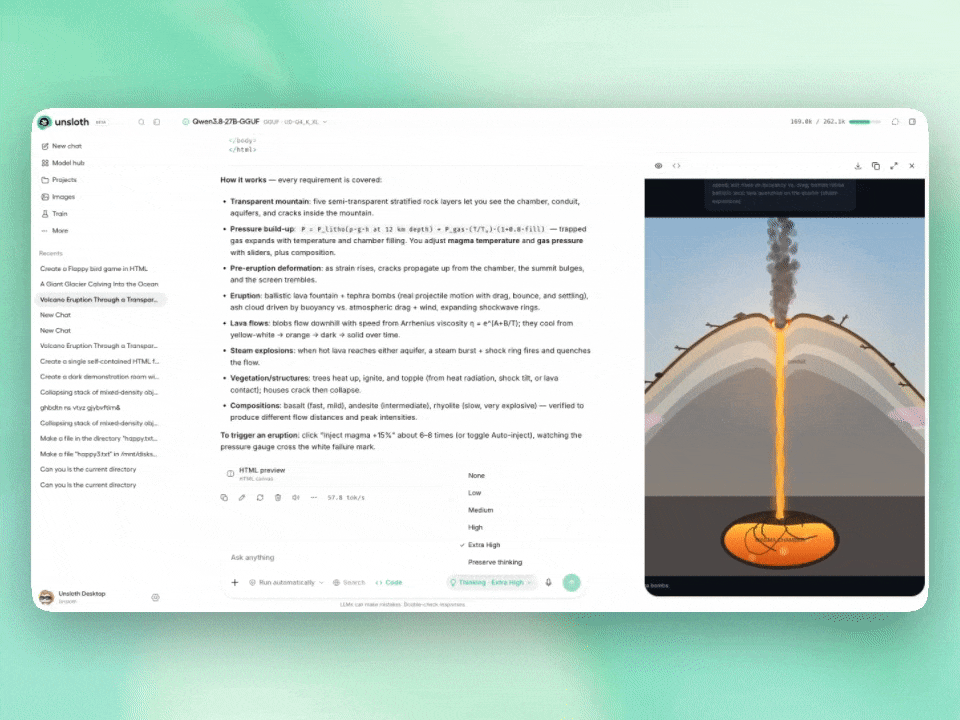 Minh họa mô hình Qwen3.8 chạy cục bộ
Ngoài bản GGUF, Unsloth còn phát hành NVFP4 cho Qwen3.8-27B, chạy nhanh hơn khoảng 1,5 lần so với checkpoint BF16 với dung lượng tệp tương đương. Bản NVFP4 yêu cầu GPU Blackwell của NVIDIA như dòng RTX 50X, DGX Spark, B200, B300; với GPU đời cũ hơn thì GGUF là lựa chọn phù hợp.
Các bản quant của Unsloth còn đi kèm một số cải tiến kỹ thuật: hỗ trợ Developer Role cho các công cụ tác tử như Codex, bật MTP (multi-token prediction) để suy luận nhanh hơn, và cải thiện khả năng phân tích các đối tượng lồng nhau khi gọi công cụ (tool calling) để công cụ chạy thành công hơn.
Cách V3.1 được đánh giá
Unsloth cho biết đã chạy các benchmark tác tử gồm Terminal Bench 2.1, DeepSWE v1.1, cùng các benchmark tổng quát như LiveCodeBench v6, GPQA Diamond, MMLU-Pro, AIME25 và nhiều bài khác. Với benchmark tác tử, nhóm dùng ngữ cảnh 256K; các bài còn lại dùng 128K. Phương pháp luận được giữ giống với khi đánh giá DeepSeek-V4.1-Flash và Qwen3.8-Flash-Next — hai mô hình cũng dùng thuật toán V3.1 xem trước.
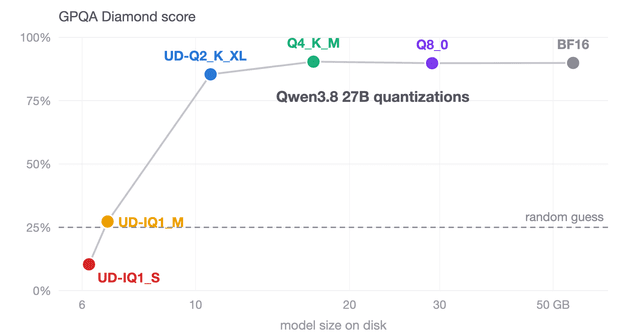
 So sánh hiệu năng lượng tử hóa
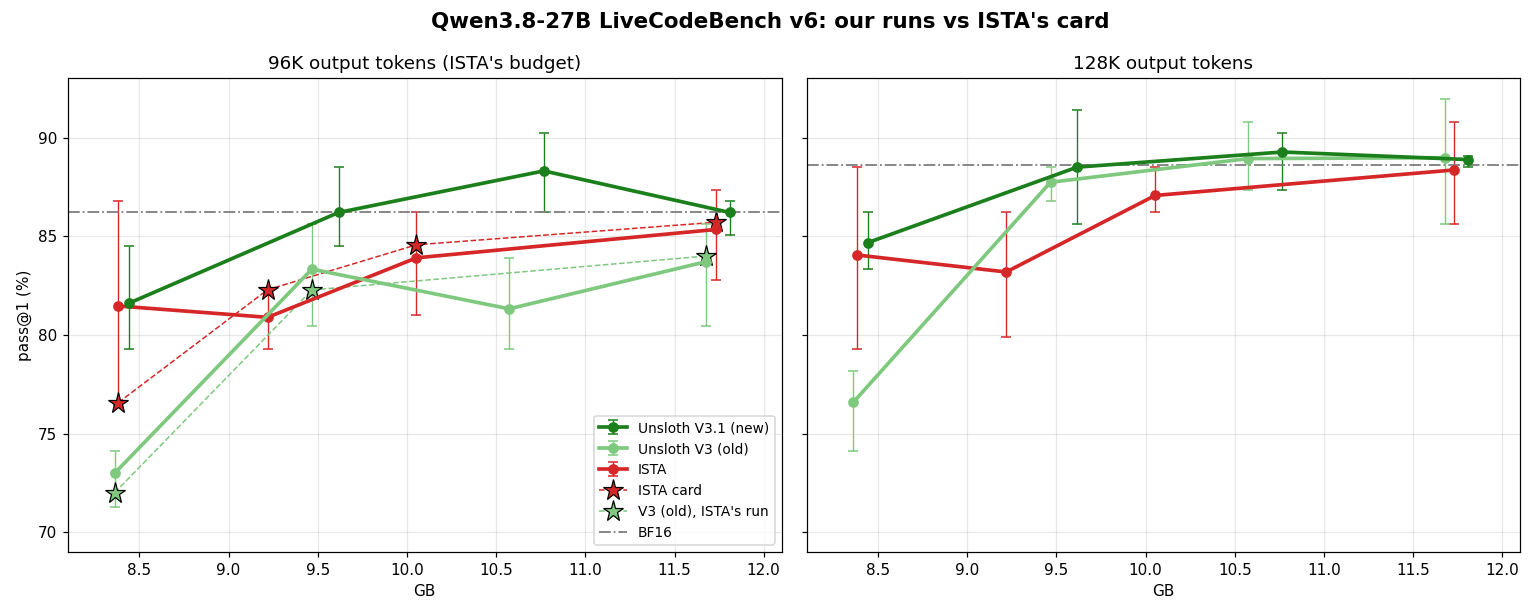
Nhóm phát triển cũng dành phần lớn tài liệu để phản biện kết quả benchmark của bên thứ ba. Cụ thể, với LiveCodeBench, công cụ GSQ-RCO cho rằng các bản quant UD3 của Unsloth làm kém hơn của ISTA, nhưng Unsloth khẳng định điều ngược lại: UD3 tốt hơn ISTA ở mọi kích thước trừ mức nhỏ nhất. Họ suy đoán GSQ-RCO đã dùng ngân sách ngữ cảnh 96K, trong khi ở 128K thì UD3 làm tốt hơn hẳn.
Về benchmark AIME25 của ISTA, GSQ-RCO báo độ phục hồi độ chính xác đạt 100%, 100%, 100% và 96,7%. Unsloth cho rằng ISTA chỉ chạy 1 lần thử, trong khi họ chạy 14 lần và thu được độ phục hồi trung bình 93% đến 96% — không phải 100%. Kết quả này được kiểm chứng lại bằng Math Verify Dynamic 3.1 GGUF, LightEval, và cả giải mã tham lam (greedy decoding, temperature = 0), nhưng vẫn không đạt mức 100% mà ISTA công bố. Nhóm lưu ý GPU vốn không tất định (non-deterministic), nên benchmark cần được chạy nhiều lần, và greedy decoding cũng không đại diện cho cách dùng thực tế.
Yêu cầu phần cứng và thông số khuyến nghị
Bản 4-bit của Qwen3.8-27B chạy được trên 16-19GB VRAM như RTX 5080, RTX 4090 hoặc máy Mac 24GB RAM. Bảng yêu cầu bộ nhớ theo từng mức lượng tử:
- 1-bit: 7-8 GB
- 2-bit: 9-11 GB
- 3-bit: 12-14 GB
- 4-bit: 16-19 GB
- 6-bit: 23-26 GB
- 8-bit: 31 GB
- BF16: 56 GB
Nếu muốn dùng MTP để suy luận nhanh hơn, cần dự trù thêm 1-2GB bộ nhớ. Qwen3.8-27B là mô hình lai (hybrid) giữa chế độ suy luận và không suy luận, với các thông số mặc định khác nhau:
- Chế độ Thinking: temperature 1.0, top_p 0.95, top_k 20, min_p 0.0, presence_penalty 0.0, repetition_penalty 1.0
- Chế độ Instruct (không suy luận): temperature 0.7, top_p 0.80, top_k 20, min_p 0.0, presence_penalty 1.5, repetition_penalty 1.0
Cửa sổ ngữ cảnh tối đa là 262.144 token, có thể mở rộng lên 1M nhờ YaRN. Mô hình còn hỗ trợ tham số reasoning_effort để điều chỉnh độ sâu suy luận, với các mức xhigh (mặc định, cho tác vụ phức tạp), medium (cân bằng độ chính xác và tốc độ), low (tối ưu tốc độ và chi phí) và none. Trên llama-server, có thể đổi mức bằng --chat-template-kwargs '{"reasoning_effort":"medium"}'.
Góc nhìn
Với các kỹ sư và đội phát triển tại Việt Nam đang cân nhắc chạy mô hình cục bộ, điểm đáng giá nhất ở bản cập nhật này là mức tăng độ chính xác đến từ phần mềm chứ không phải phần cứng. Cùng một dung lượng tệp, cùng một cấu hình máy, bản quant mới cho kết quả tốt hơn ở các tác vụ lập trình tác tử — nhóm công việc mà nhiều đội đang thử nghiệm với trợ lý code.
Tuy vậy, phần tranh luận với GSQ-RCO và ISTA cũng là lời nhắc thực tế: kết quả benchmark lượng tử hóa phụ thuộc rất nhiều vào ngân sách ngữ cảnh, số lần chạy thử và cách chấm điểm. Khi tự đánh giá một bản quant cho dự án của mình, nên chạy nhiều lần trên đúng ngữ cảnh và đúng tác vụ thực tế thay vì tin vào một con số duy nhất trên bảng xếp hạng.
Nguồn: unsloth.ai · Quy trình biên tập