Vì sao cách xây dựng prompt của agent ảnh hưởng lớn đến năng lượng và chi phí token
Một phân tích mới từ Neuralwatt cho thấy chính cách các agent harness xây dựng prompt — chứ không chỉ mô hình hay phần cứng — quyết định một phần đáng kể năng lượng tiêu thụ khi suy luận AI. Những lần cache miss, đặc biệt ở đầu prompt hoặc ở các phiên hội thoại dài, có thể khiến một lượt tốn năng lượng gấp đôi và chậm rõ rệt, nhưng phần lớn vấn đề đều có thể khắc phục bằng những thay đổi nhỏ trong cách harness gửi yêu cầu.
Vì sao cách xây dựng prompt của agent ảnh hưởng lớn đến năng lượng và chi phí token
Khi nói về hiệu quả suy luận AI, chúng ta thường chỉ chú ý đến mô hình hoặc phần cứng. Nhưng một phân tích mới từ Neuralwatt chỉ ra rằng chính "harness" — lớp phần mềm gọi mô hình — mới là yếu tố quyết định một phần lớn năng lượng mà GPU tiêu thụ.
Biểu đồ minh họa mức tiêu thụ năng lượng của harness
Prompt caching: Nguồn tiết kiệm lớn nhất
Gần như toàn bộ lưu lượng của Neuralwatt là dạng agentic, với lượng token đầu vào (input) lớn hơn nhiều so với đầu ra (output). Một lượt hội thoại của coding agent thường gửi tới 100.000 token trở lên nhưng chỉ nhận về vài trăm token. Phần lớn input này chính là prompt của lượt trước, chỉ thêm một chút nội dung mới ở cuối.
Nếu phần văn bản trước đó không đổi, máy chủ đã có sẵn KV cache và chỉ cần xử lý phần mới. Đây là prompt caching — nguồn tiết kiệm lớn nhất của hệ thống. Phục vụ một token từ cache rẻ hơn nhiều so với việc tính toán lại token đó từ đầu.
Vấn đề nằm ở chỗ caching đòi hỏi tiền tố chính xác tuyệt đối. Khi harness thay đổi bất cứ điều gì đã gửi trước đó, cache bị "phá vỡ" (cache break), và hệ thống phải tính lại toàn bộ từ điểm khác biệt đầu tiên trở đi. Nếu thay đổi nằm gần đầu prompt — thậm chí chỉ là một dấu thời gian — gần như toàn bộ prompt phải tính lại. Nhưng nếu thay đổi ở cuối, chi phí gần như không đáng kể.
Cùng một mô hình, cùng một mức giá, nhưng tỷ lệ cache khác nhau lại dẫn đến chênh lệch lớn về năng lượng tiêu thụ.
Cùng mô hình, khác harness, khác tỷ lệ cache
Trong 30 ngày từ 8/9 đến 7/10/2026, Neuralwatt ghi nhận hàng trăm client khác nhau, bao gồm các coding agent mã nguồn mở như OpenCode, Oh My Pi (omp) và Pi, cùng các tích hợp trình biên tập, SDK của OpenAI và ứng dụng tùy chỉnh. Riêng OpenCode được khoảng một trong bốn khách hàng sử dụng.
Với các client phổ biến nhất, tỷ lệ input không thể phục vụ từ cache dao động từ 1,6% đến 11,1%. Nhìn thì có vẻ nhỏ, nhưng ý nghĩa rất lớn: client đạt 97% cache chỉ gửi 3 token chưa cache trên mỗi 100 token; client đạt 92% gửi tới 8 token. Điều đó đồng nghĩa với khối lượng tính toán prefill gấp 2,7 lần cho cùng một cuộc hội thoại.
Tỷ lệ cache cũng phụ thuộc vào khối lượng công việc chứ không chỉ harness. Các phiên hội thoại dài thường đạt tỷ lệ cao hơn vì phần văn bản mới mỗi lượt chiếm tỷ trọng nhỏ hơn trong toàn bộ prompt. Một thước đo chính xác hơn là tần suất phá vỡ cache: khoảng 1 trên 100 lượt đối với deepseek-harness, so với khoảng 3 trên 100 đối với OpenCode và Pi.
 Biểu đồ tỷ lệ năng lượng tiêu thụ thêm khi cache miss
Cái giá năng lượng của một lần cache miss
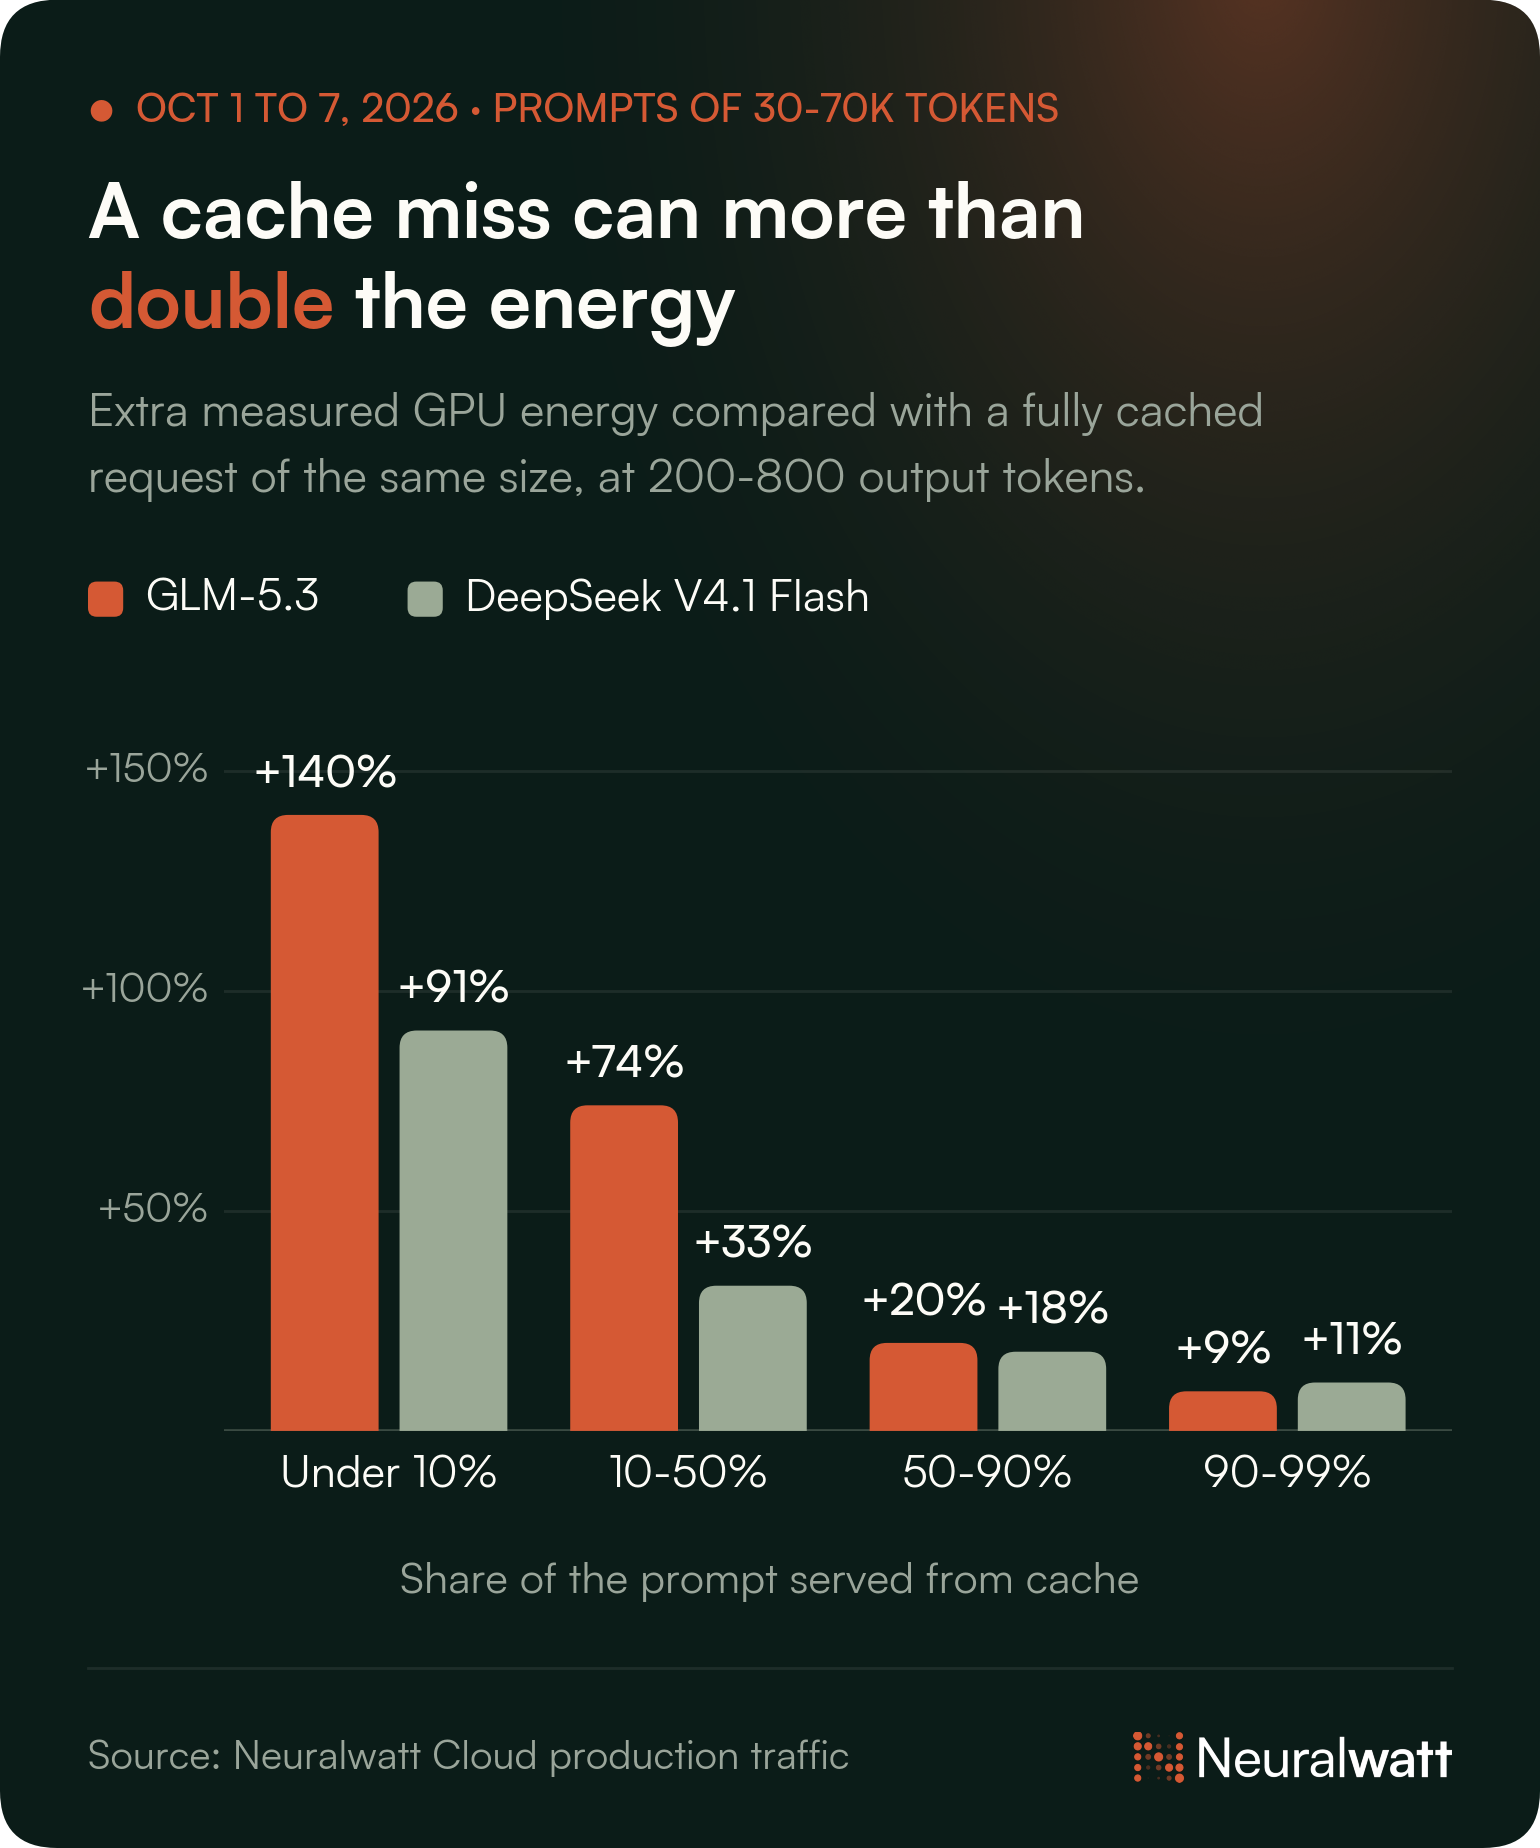
Vì Neuralwatt tính phí dựa trên năng lượng đo được, họ có thể thấy trực tiếp chi phí này. Trong tuần từ 1/10 đến 7/10/2026, họ so sánh các yêu cầu trên cùng một mô hình, cùng kích thước prompt (khoảng 50.000 token) và độ dài đầu ra tương tự.
Kết quả: một yêu cầu gần như không được cache tiêu tốn khoảng gấp đôi năng lượng so với yêu cầu được cache đầy đủ cùng kích thước. Trên mô hình GLM-5.3, con số này gần gấp 2,5 lần. Đáng chú ý, prefill còn cạnh tranh tài nguyên GPU với quá trình sinh văn bản (generation), nên phần prefill lãng phí còn làm chậm phản hồi của tất cả người dùng khác trên cùng máy chủ.
Cache miss càng sâu trong phiên càng đắt
Vấn đề trở nên nghiêm trọng hơn khi phiên hội thoại kéo dài. Khi theo dõi từng lượt trên ba mô hình đông khách nhất, nhóm phân tích nhận thấy hầu hết các lần phá vỡ cache đều nhỏ — chỉ vài nghìn token gần cuối prompt bị tính lại.
Nhưng vượt mốc 128.000 token ngữ cảnh, khoảng 3 trong mỗi 1.000 lượt phải đọc lại hơn một nửa prompt từ đầu. Những lượt ít ỏi này lại chiếm tới 75% tổng số token đọc lại ở độ sâu đó. Mỗi lượt như vậy đọc lại trung bình khoảng 230.000 token, trong khi một lượt bình thường ở độ sâu này chỉ thêm khoảng 370 token mới. Nghĩa là một lượt đọc lại tốn bằng khoảng 600 lượt bình thường.
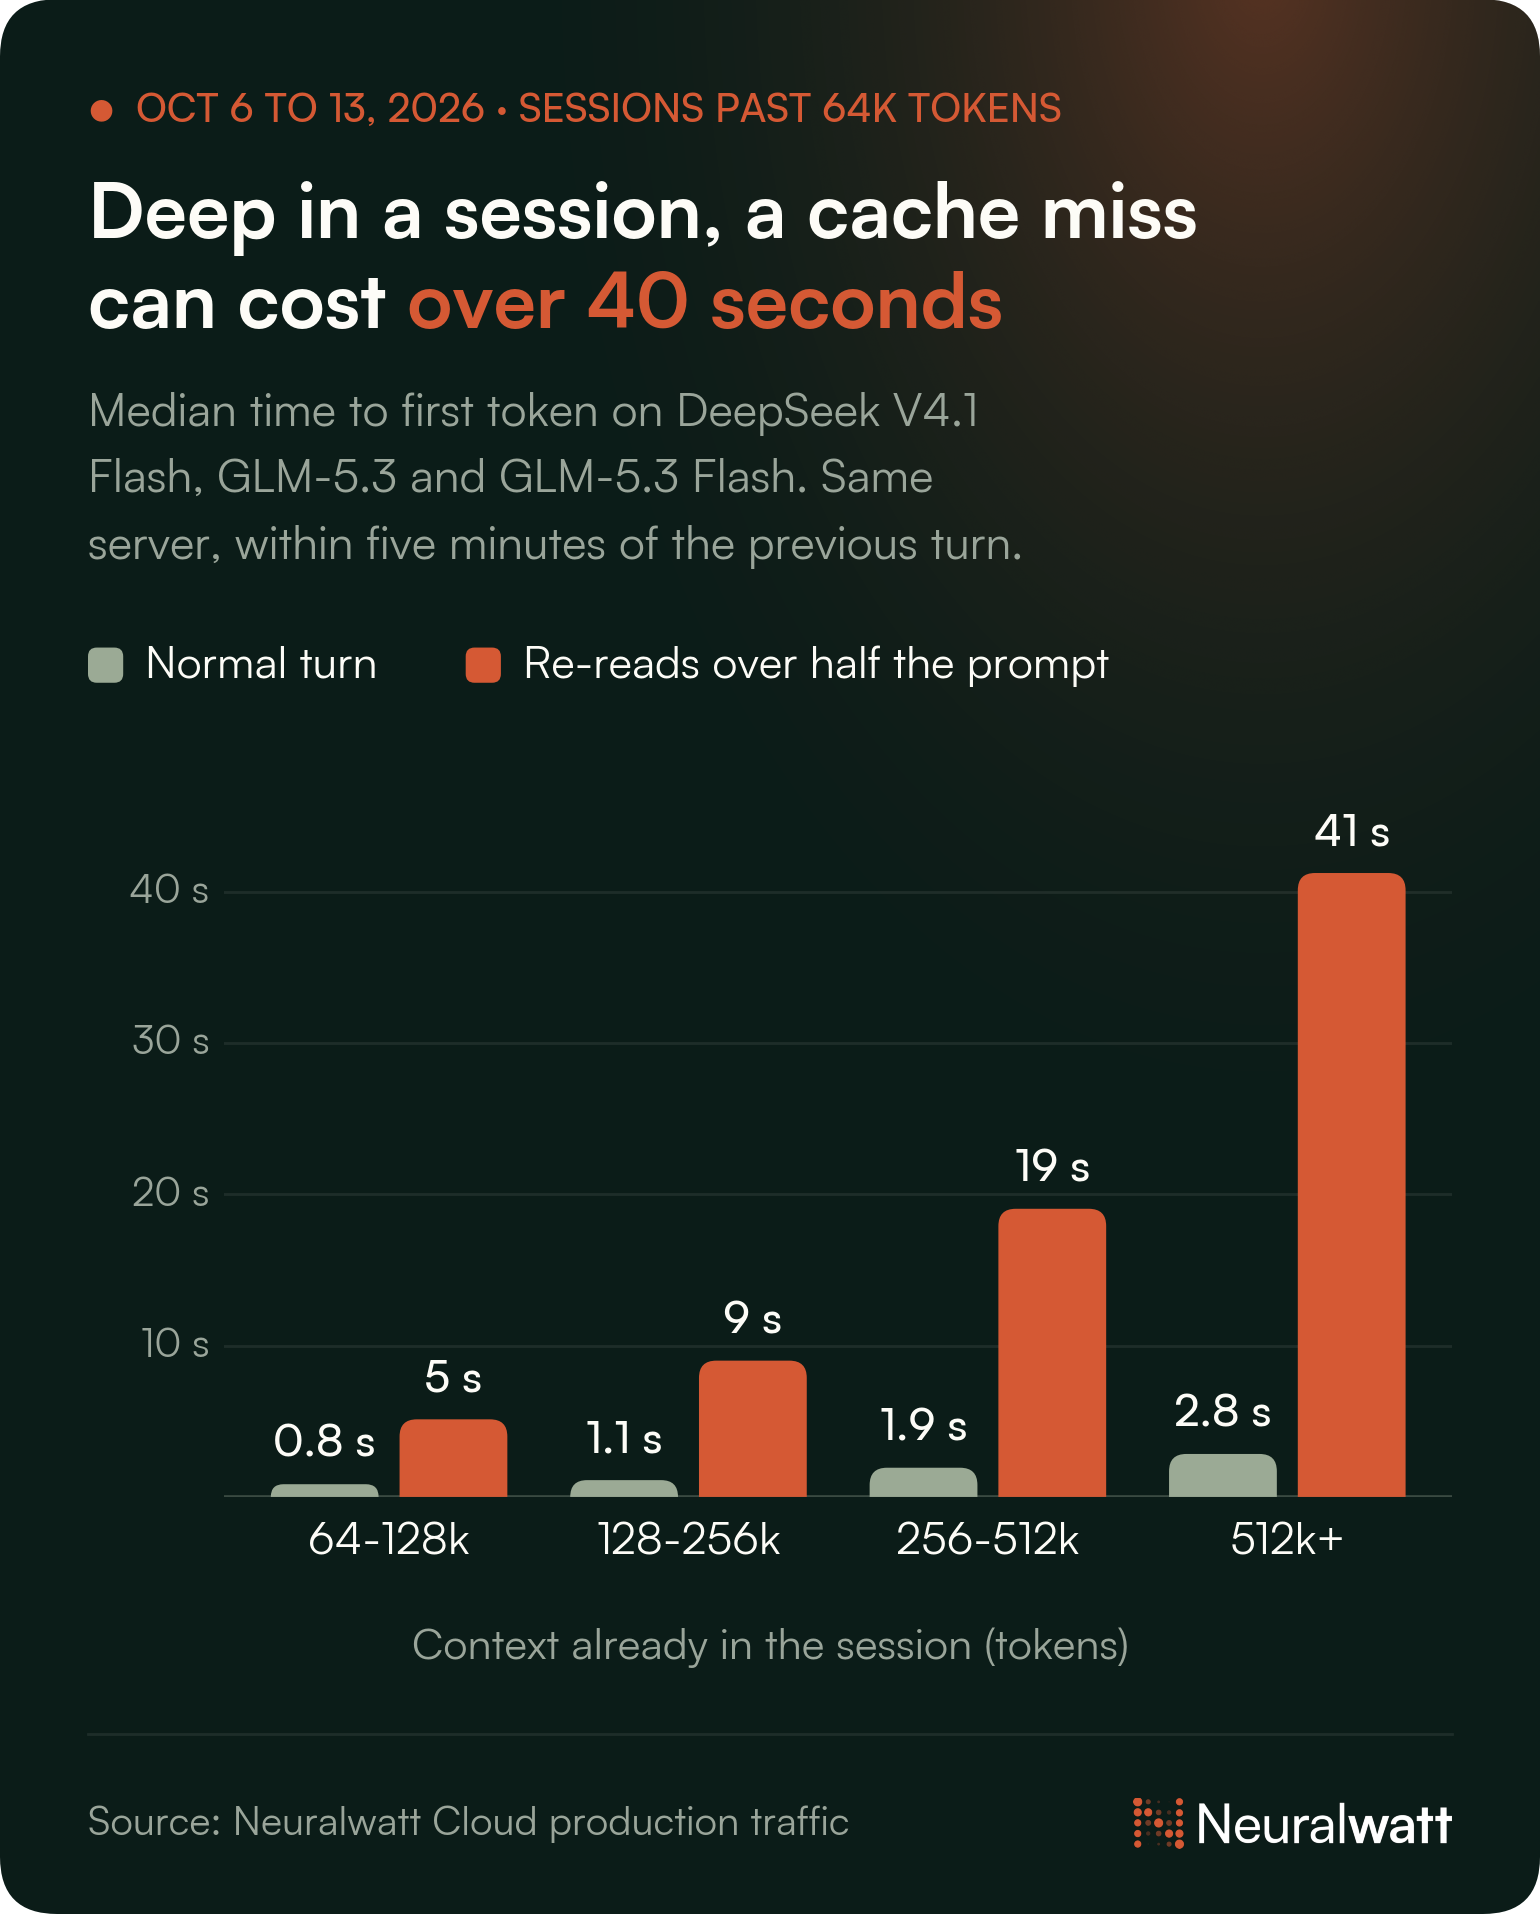
Độ trễ cũng tăng rõ rệt. Thời gian đến token đầu tiên (TTFT) ở các lượt phải đọc lại gần như toàn bộ prompt cao hơn hẳn so với lượt bình thường.
 Biểu đồ thời gian đến token đầu tiên theo độ sâu phiên hội thoại
Tác giả nhấn mạnh rằng điều đáng quan tâm không phải tần suất phá vỡ cache, mà là độ sâu của phiên tại thời điểm phá vỡ. Thay đổi đầu prompt một lần vào lúc đầu thì ít tốn kém. Nhưng làm điều đó ở lượt thứ 200 của một phiên dài sẽ gây ra một khoảng dừng lớn và chi phí năng lượng khổng lồ.
Nguyên nhân gây phá vỡ cache
Phân tích được tiến hành theo hai hướng: trong phòng thí nghiệm (nơi quan sát được từng token) và trên môi trường production (chỉ thấy metadata của yêu cầu).
Trong phòng thí nghiệm
Nhóm nghiên cứu chạy bốn agent mã nguồn mở phổ biến (OpenCode, Pi, omp và Kilo Code) qua một proxy ghi lại, đối chiếu với DeepSeek V4.1 Flash và GLM-5.3, sử dụng các bản phát hành mới nhất tính đến 6/10.
Trong 539 yêu cầu tiếp nối trong cùng cuộc hội thoại, 88% là pure append — tức prompt trước là tiền tố chính xác của prompt mới. 65 yêu cầu còn lại phá vỡ cache. Đáng chú ý, mọi lần phá vỡ đều đến từ việc harness thay đổi nội dung đã gửi, không phải từ chat template của nhà cung cấp. Thời gian rảnh (idle), khởi động lại harness và tiếp tục phiên, hay dùng sub-agent đều không gây phá vỡ cache.
Hai nguyên nhân phá vỡ cache mà không cần người dùng thao tác:
- Nhắc nhở chế độ plan của OpenCode. Sau khi dùng chế độ plan, OpenCode gắn một nhắc nhở vào mỗi tin nhắn người dùng mới rồi xóa nó ở lượt sau. Mỗi lượt phải đọc lại toàn bộ lượt trước, tiêu tốn 330 đến 2.340 token mỗi lượt. OpenCode 2.x giữ nhắc nhở trong tin nhắn riêng nên không còn gây đọc lại.
- Việc omp cắt bỏ file đọc lại. Khi một file được đọc lần thứ hai, omp thay bản cũ bằng một dòng thay thế. Trong thử nghiệm, thay đổi này nằm ở 62% độ dài prompt, buộc đọc lại 5.846 trong tổng số 15.520 token. Đặt các tùy chọn
compaction.supersedeReads: falsevàcompaction.dropUseless: falsesẽ giữ được cache.
Các nguyên nhân khác phụ thuộc vào hành vi người dùng:
- Chuyển mức reasoning effort. Cả hai template đều ghi mức effort ở những token đầu tiên, nên chỉ cần đổi giá trị là toàn bộ prompt bị đọc lại.
- Kết nối hoặc ngắt MCP server. OpenCode 1.x và Kilo Code chèn công cụ mới theo thứ tự chữ cái vào giữa danh sách công cụ, gây đọc lại. OpenCode 2.x chỉ thêm ghi chú ở cuối nên không ảnh hưởng.
- Thêm skill. Cả bốn harness đều liệt kê skill trong system prompt, và điểm khác biệt đầu tiên nằm khá sâu.
- Ngày tháng thay đổi. OpenCode 1.x và Kilo Code đưa ngày hiện tại vào system prompt ở khoảng 2.000 token. Chỉ cần qua nửa đêm là gần như toàn bộ prompt bị đọc lại một lần.
- Nén ngữ cảnh (compaction). Mỗi harness làm một kiểu. Pi giữ nguyên ~20.000 token cuối nhưng viết lại phần tóm tắt gần đầu prompt, khiến hầu hết nội dung bị đọc lại. Cùng cửa sổ 40.000 token, OpenCode 2.x nén ba lần và đọc lại tổng cộng 67.850 token, còn 1.x nén một lần và đọc lại 29.776 token.
Trên môi trường production
Dữ liệu metadata từ 6/10 đến 13/10/2026 cho thấy: thay đổi danh sách công cụ hoặc mức effort khiến khả năng phá vỡ cache tăng hơn 20 lần và tiêu tốn trung bình khoảng 40% prompt trước đó. Thay đổi danh sách công cụ chỉ xảy ra ở khoảng 0,5% tổng số lượt, nhưng lại chiếm tới 19% tổng token đọc lại trên các mô hình được khảo sát — và phần lớn tập trung ở chỉ ba tài khoản.
Ba phần tư token đọc lại còn lại đến từ những lượt mà cả effort lẫn số lượng công cụ đều không đổi. Nhóm này chứa các nguyên nhân không thể thấy từ phía máy chủ: nhắc nhở của OpenCode 1.x, việc cắt bỏ của omp, skill, ngày tháng, nén ngữ cảnh và cả việc cache bị đẩy ra khỏi bộ nhớ.
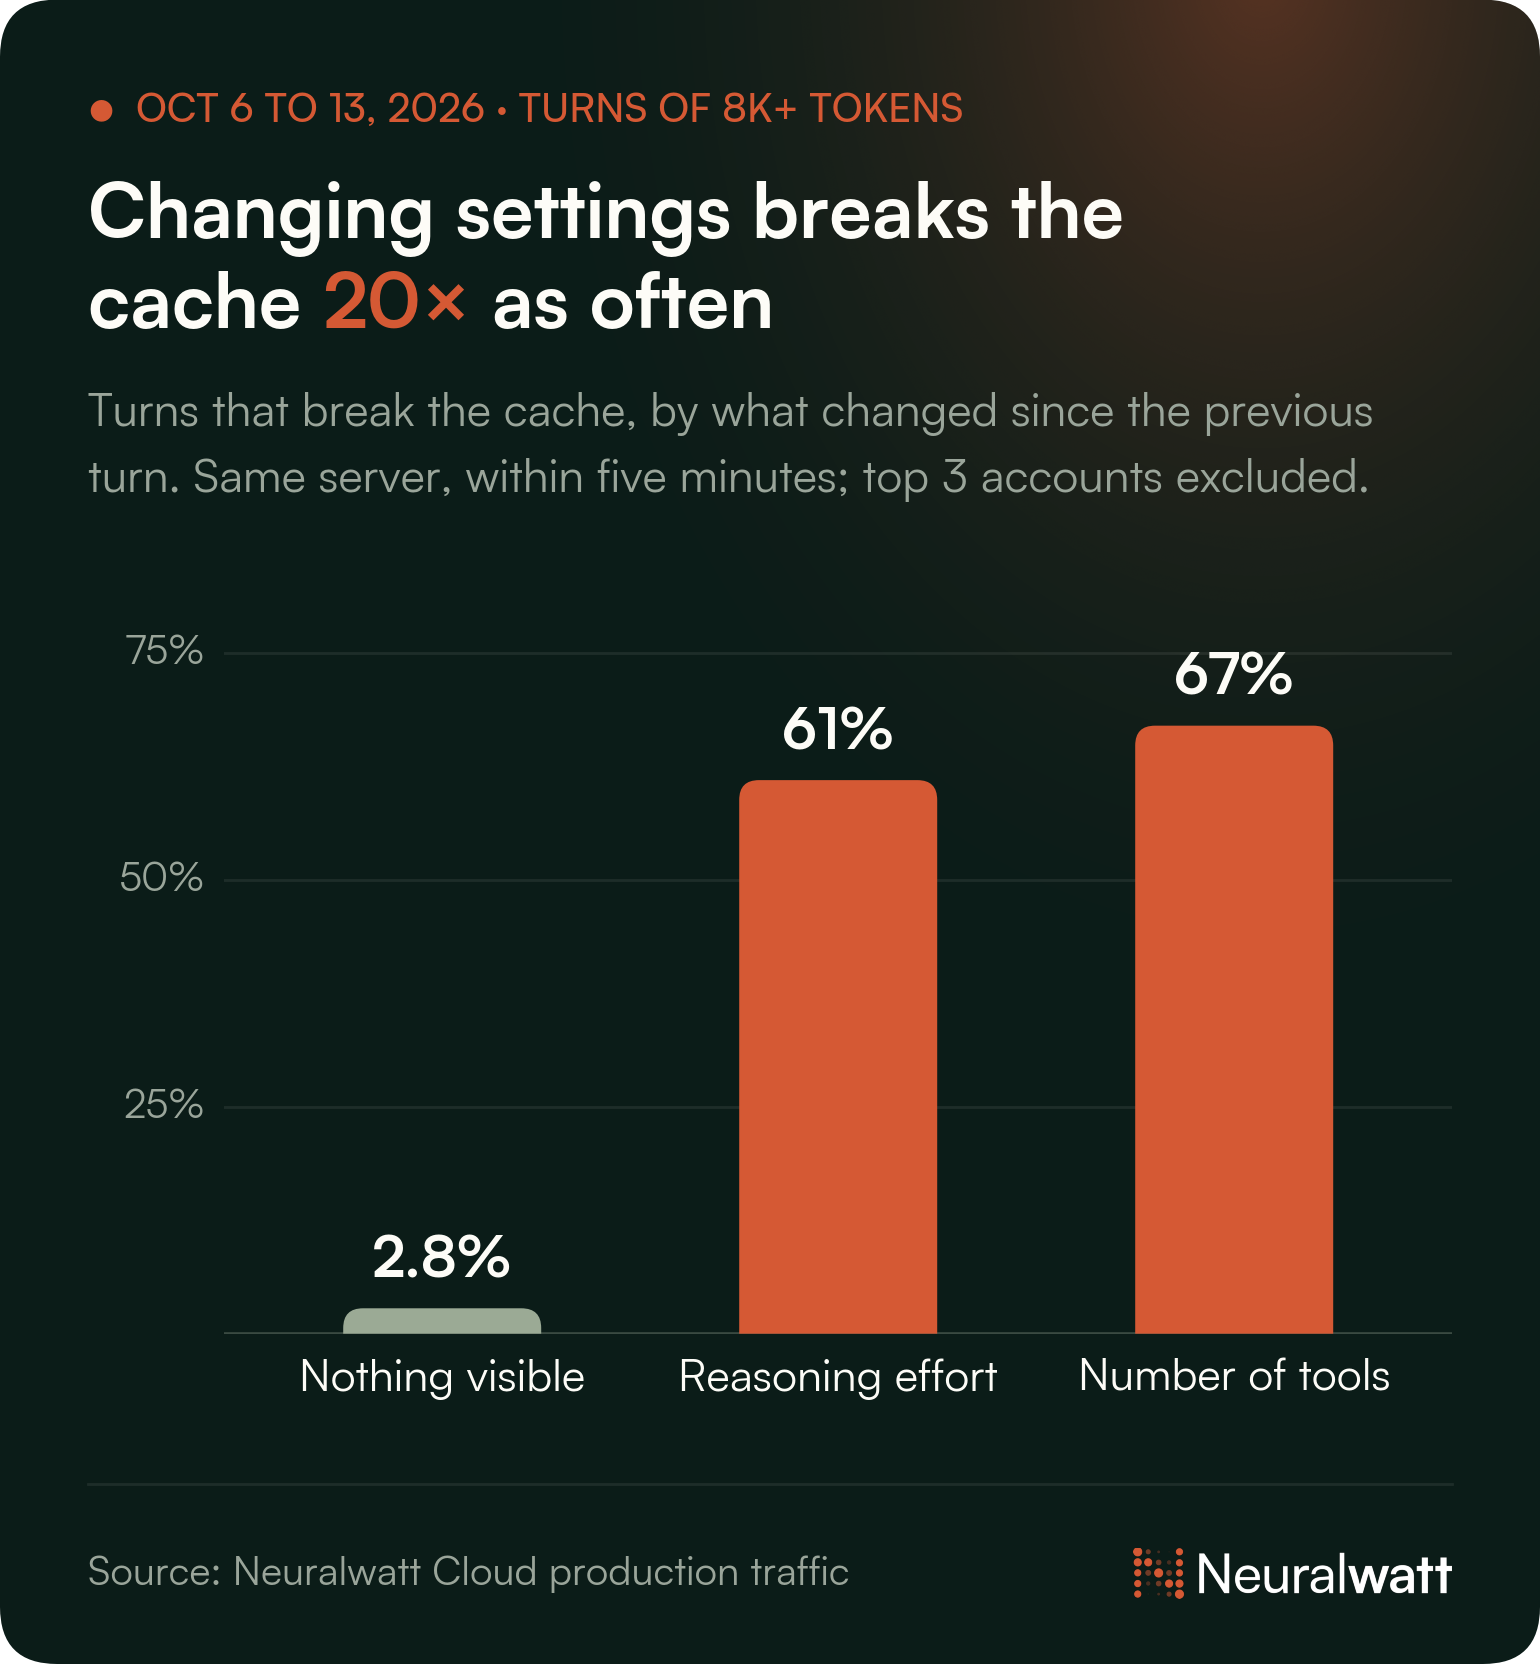 Biểu đồ phân loại nguyên nhân phá vỡ cache
Cách deepseek-harness giữ cache nguyên vẹn
Đáng chú ý, trong bản ghi phòng thí nghiệm, mọi yêu cầu tiếp nối của deepseek-harness đều là pure append, kể cả sau khi tiến trình bị khởi động lại và phiên được tiếp tục. Nhóm nghiên cứu tìm thấy một số nguyên tắc đáng học hỏi trong mã nguồn của nó:
- Các yêu cầu được tái tạo từ một session log chỉ ghi thêm. Việc thử lại và tiếp tục phiên tạo ra prompt giống hệt từng byte.
- System prompt cố định và tối giản. Nó không chứa ngày tháng, trạng thái git hay hệ điều hành; viết một lần rồi để yên.
- Thay đổi trạng thái được đưa xuống sau lịch sử. Khi chính sách phê duyệt hoặc skill thay đổi, harness thêm một ghi chú ngắn thay thế các ghi chú trước, giữ nguyên system prompt và các tin nhắn cũ.
- Danh sách công cụ giữ nguyên thứ tự và nội dung ở mọi chế độ. Các chế độ được thực thi bằng chỉ dẫn văn bản thay vì thêm bớt công cụ.
- Nén ngữ cảnh diễn ra muộn. Lệnh tóm tắt tái sử dụng tiền tố sẵn có, nên ngay cả quá trình nén cũng chủ yếu là cache hit. Trong khối lượng công việc lớn nhất được quan sát, các lệnh này chỉ đạt 22% cache.
- Mọi thay đổi đều được xem xét về tác động đến cache. Mỗi gói trong kho mã đều kèm một mục ngắn về "ảnh hưởng KV cache".
Khuyến nghị cho nhà phát triển và người dùng
Nếu bạn xây dựng hoặc cấu hình harness:
- Giữ phần đầu prompt giống hệt nhau mỗi lượt. Thêm tin nhắn mới và kết quả công cụ vào cuối hội thoại, kể cả mô tả thay đổi cài đặt.
- Không đưa ngày tháng, trạng thái git hay bất cứ thứ gì thay đổi vào system prompt.
- Giữ danh sách công cụ ổn định và có thứ tự. Thêm công cụ mới ở cuối.
- Nén ngữ cảnh muộn, và để lệnh tóm tắt dùng lại chính xác tiền tố của hội thoại.
- Gửi một session id ổn định. Trên Neuralwatt, header
X-NW-Conversation-IDgiúp giữ phiên trên máy chủ đã có cache.
Nếu bạn là người dùng harness:
- Chọn một mức reasoning effort cho cả phiên thay vì đổi giữa chừng.
- Với omp, cân nhắc đặt
compaction.supersedeReads: false. - Chốt các cài đặt như effort, MCP server và skill trước khi phiên trở nên dài. Đó là lúc phá vỡ cache gây tốn kém nhất.
Vì sao điều này đáng được đo lường
Một lần phá vỡ cache không hiện ra dưới dạng lỗi. Bạn vẫn nhận được câu trả lời, chỉ là chậm hơn và tốn nhiều năng lượng hơn. Việc đo năng lượng của từng yêu cầu cho thấy sự lãng phí này cộng dồn lớn đến mức nào — và phần lớn trong số đó có thể khắc phục chỉ bằng một cài đặt hoặc một thay đổi nhỏ trong cách harness xây dựng prompt.
AI vận hành bằng năng lượng. Càng nhìn thấy rõ nó được dùng ra sao, chúng ta càng ngăn được nhiều lãng phí — dù là trong một phiên làm việc của lập trình viên hay trong trung tâm dữ liệu tiếp theo của cả ngành.
Với người dùng Việt Nam đang ngày càng sử dụng nhiều công cụ coding agent trong công việc, đây là bài học thực tế: những tinh chỉnh nhỏ trong cách cấu hình agent không chỉ tiết kiệm chi phí token mà còn góp phần giảm mức tiêu thụ năng lượng của hạ tầng AI nói chung.