
WorldTUI: Mô hình 360 triệu tham số giả lập cửa sổ terminal ngay trên trình duyệt
Một kỹ sư đã tinh chỉnh mô hình ngôn ngữ Qwen2.5-Coder-0.5B thành một 'thế giới terminal' thu nhỏ, không có shell hay hệ thống tệp thật phía sau. Mọi thao tác gõ phím đều được mô hình dự đoán để vẽ lại màn hình, cho phép chạy vim, tmux, python và thậm chí chơi rắn săn mồi, tất cả chạy cục bộ trong tab trình duyệt với dung lượng chỉ 208 MB.
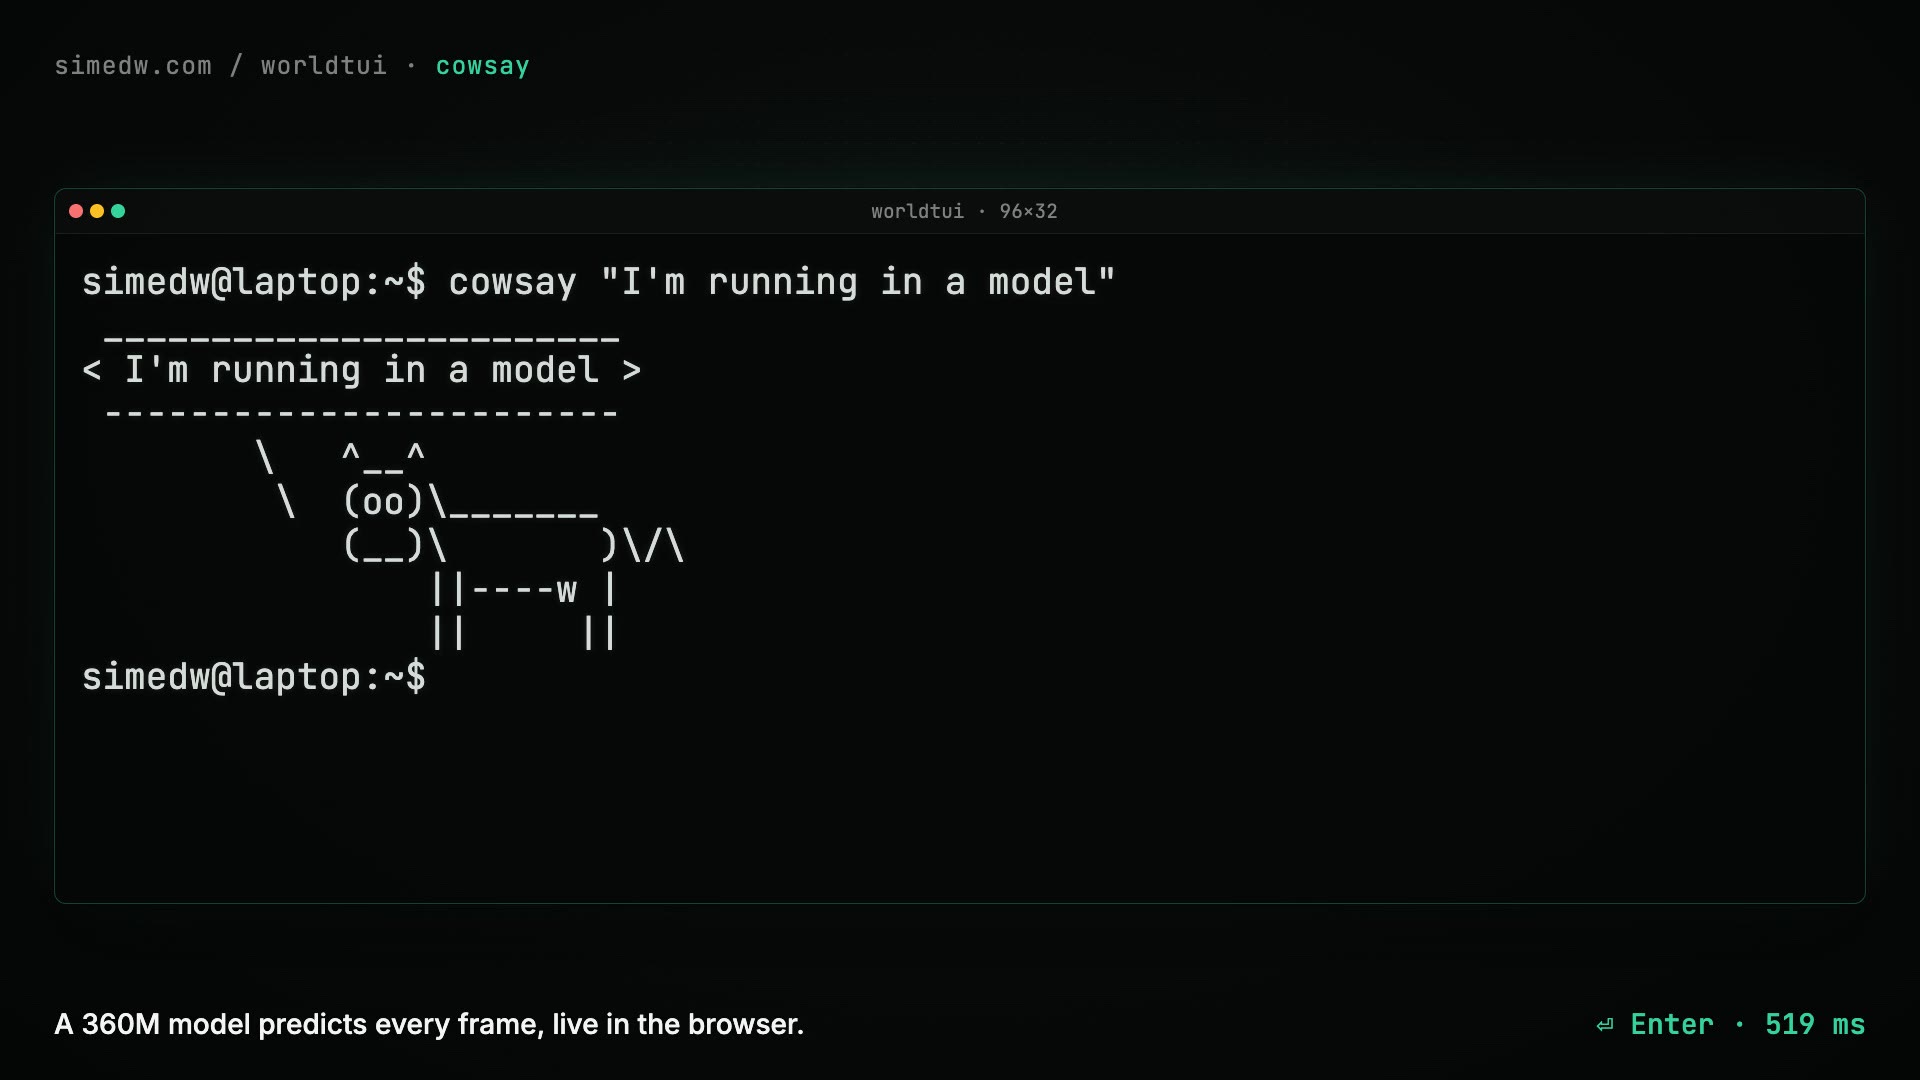
WorldTUI: Khi mô hình 360 triệu tham số học cách "giả làm" terminal
Nếu từng tò mò liệu một mô hình ngôn ngữ nhỏ có thể duy trì được một "thế giới" nhất quán hay chỉ đơn thuần sinh ra văn bản trông giống thật, dự án WorldTUI chính là câu trả lời thú vị. Tác giả đã tinh chỉnh mô hình Qwen2.5-Coder-0.5B để nó đóng vai một cửa sổ terminal hoàn chỉnh — không có shell, không có hệ thống tệp, chỉ có mô hình dự đoán cách màn hình thay đổi sau mỗi lần gõ phím. Kết quả là một bản demo chạy hoàn toàn cục bộ trong trình duyệt, nặng vỏn vẹn 208 MB.
Ý tưởng: ứng dụng không còn được viết bằng code mà được "học"
Tác giả lấy cảm hứng từ Genie 3 — mô hình thế giới (world model) từng gây chú ý khi mô phỏng môi trường trò chơi bằng cách dự đoán khung hình tiếp theo thay vì dùng game engine. Không có cụm GPU khổng lồ hay kho dữ liệu video, anh quyết định thu nhỏ tham vọng: thay vì một thế giới trò chơi, hãy thử với một terminal.
Lý do khá hợp lý:
- Terminal chỉ là một lưới ký tự thay vì điểm ảnh, dễ mô hình hóa hơn nhiều
- Có thể tự sinh dữ liệu huấn luyện gắn nhãn hoàn hảo bằng cách chạy shell thật
- Mô hình ngôn ngữ tiền huấn luyện vốn đã "biết" lệnh
lshaycatnên in ra gì
Câu hỏi cốt lõi mà tác giả muốn giải đáp: liệu mô hình có duy trì được một thế giới nhất quán, hay chỉ tạo ra những dòng lệnh trông có vẻ hợp lý?
Cách mô hình "nhìn" một terminal
Các mô hình ngôn ngữ thông thường nhận prompt rồi nối thêm token vào cuối, từng cái một. Điều này không khớp với terminal, bởi một phím bấm có thể tác động riêng lẻ (như esc trong vim) và đầu ra không phải lúc nào cũng nằm ở cuối — lệnh clear xóa sạch màn hình và đưa con trỏ về đầu.
Vì vậy, thay vì dự đoán một luồng văn bản, mô hình dự đoán những thay đổi trên màn hình. Terminal được coi là một lưới ký tự, mỗi ô một ký tự. Mỗi phiên làm việc bắt đầu bằng một ảnh chụp trạng thái: kích thước màn hình, nội dung từng dòng và vị trí con trỏ. Kích thước không cố định mà là một phần của đầu vào, cho phép mô hình khởi động giữa chừng một ứng dụng — từ prompt bash, bộ đệm vim hay thậm chí ván rắn săn mồi đang chơi dở.
Sau đó, mỗi lần gõ phím được đưa vào dưới dạng byte thô như terminal thật xử lý. Mô hình trả lời bằng danh sách các dòng cần ghi lại và vị trí con trỏ cuối cùng, thay vì vẽ lại toàn bộ màn hình.
Mẹo "COPY" giúp tiết kiệm token
Một vấn đề hóc búa: khi cuộn màn hình, mọi dòng đều phải dịch lên một vị trí. Nếu bắt mô hình sinh lại toàn bộ nội dung, mỗi lần nhấn Enter sẽ tốn khoảng 3.000 token. Giải pháp là bổ sung thao tác COPY — chỉ thị một dòng mới sao chép từ dòng cũ tương ứng.
Nhờ đó, một lần cuộn chỉ tốn ba token mỗi dòng thay vì khoảng 96. Thủ thuật tương tự cũng áp dụng cho việc xóa màn hình, chèn/xóa dòng trong vim hay điều hướng trang man.
Tổng cộng, mô hình chỉ dùng bộ từ vựng 333 token: 256 token byte, 64 token dòng và một vài thao tác đặc biệt. Quá trình giải mã bị ràng buộc bởi ngữ pháp nên mọi dự đoán đều tạo ra một cập nhật màn hình hợp lệ.
Dữ liệu huấn luyện: tự sinh bằng Docker
Tác giả không tìm được bộ dữ liệu ghi lại phiên terminal nào có căn chỉnh chính xác giữa phím bấm và màn hình, nên đã tự tạo. Công thức khá công phu:
- Ngẫu nhiên hóa tên người dùng, máy chủ, kiểu prompt, kích thước terminal
- Ngẫu nhiên hóa thư mục và tệp dựa trên một "nhân vật" hư cấu (lập trình viên, quản trị hệ thống…)
- Chọn 6–24 hoạt động theo trọng số: sửa tệp, vim, python, tmux…
- Theo dõi trạng thái để phiên làm việc chủ yếu mở những tệp thực sự tồn tại
- Gõ như người thật, từng phím một, có tab completion và tỷ lệ lỗi gõ 1,2%
- 35% số phiên bắt đầu giữa chừng, buộc mô hình học cách làm việc từ mọi trạng thái
Kết quả cuối cùng là 336 nghìn tập phim (episode), tương đương khoảng 2 tỷ token — con số khá khiêm tốn so với 18 nghìn tỷ token mà mô hình gốc từng thấy.
Học từ sai lầm của chính mình
Huấn luyện có giám sát thông thường học rất nhanh các thao tác gõ cơ bản. Nhưng trong phiên dài, lỗi tích lũy: chỉ một sai sót trong tên tệp sẽ lan ra toàn bộ phần còn lại của phiên.
Tác giả áp dụng ý tưởng từ DAgger: cho mô hình dự đoán 1–4 sự kiện tiếp theo, so sánh màn hình kết quả với màn hình thật, rồi nếu sai lệch đủ nhỏ, tạo ra một bản sửa lỗi. Mô hình học cách "tự chữa lành" màn hình sai của mình ngay ở lần gõ phím kế tiếp.
Có một giới hạn quan trọng: mô hình phải có đủ thông tin để suy ra cách sửa. Mọi từ ngữ xuất hiện trong bản sửa phải từng hiện trên màn hình thật trước đó — nếu không, huấn luyện sẽ vô tình dạy mô hình thói ảo giác (hallucination).
Khoảng một phần ba số phiên tạo ra được ví dụ sửa lỗi hữu ích. Quá trình này được lặp lại ba vòng, mỗi vòng thu thập lỗi từ phiên bản mới nhất. Riêng bước tự sửa lỗi đã đưa điểm PresetBench từ 24/47 lên 38/47. Tổng thời gian huấn luyện khoảng 75 giờ GPU trên một chiếc RTX 4090.
Kết quả kiểm thử
Ba bài kiểm tra được dùng: ShellBench (106 lệnh trong 24 phiên bash viết tay), PresetBench (47 tình huống lấy từ lỗi thực tế) và bài kiểm tra ghi nhớ gồm 32 "thế giới", mỗi thế giới ghi hai giá trị ngẫu nhiên ra hai tệp rồi đọc lại trong phiên khác.
| Mô hình | ShellBench /106 | Đọc lại tệp /13 |
|---|---|---|
| Qwen2.5-Coder-0.5B (prompt) | 52 | 2 |
| Qwen3-0.6B (prompt) | 60 | 3 |
| WorldTUI | 80 | 9 |
Khác biệt lớn nhất nằm ở khả năng ghi nhớ: WorldTUI đọc lại đúng 9/13 trường hợp, so với chỉ 2/13 và 3/13 của các mô hình được prompt. Dù vậy, nó vẫn chưa phải một hệ thống tệp đáng tin cậy — những lệnh quen thuộc thì ổn, nhưng kết hợp chúng theo cách mới có thể nhanh chóng phá vỡ mọi thứ.
Bài toán tốc độ và lời giải "dòng song song"
Ban đầu tác giả né tránh mô hình tự hồi quy vì lo ngại tốc độ: vẽ lại toàn màn hình tốn khoảng 3.000 token, sinh tuần tự từng cái sẽ rất chậm. Quả thực, gõ phím đơn lẻ mất khoảng 38 ms — chấp nhận được — nhưng một lệnh như vim test.txt hay man mất tới 12 giây.
Bước đột phá: hầu hết các dòng trong một khung hình không phụ thuộc lẫn nhau. Vậy tại sao phải sinh tuần tự? Tác giả chạy mỗi dòng như một phần tử trong batch, tất cả nhận cùng lịch sử trước đó nhưng chỉ sinh phần cập nhật của riêng mình. Chi phí giải mã giảm từ tổng tất cả các dòng (tới 3.000 bước) xuống còn độ dài dòng dài nhất (khoảng 100 bước).
Kết quả rất ấn tượng: độ trễ p95 với khung hình lớn giảm từ 6,7 giây xuống 0,87 giây trên RTX 4090.
Tuy nhiên, vì các dòng độc lập nên chúng không thể phối hợp — dẫn đến vim mở ở dòng 3 thay vì dòng 0, hay nhiều dòng cùng thêm thức ăn cho rắn một lúc. Giải pháp là giải mã suy đoán (speculative decoding): các dòng song song tạo bản nháp, sau đó mô hình xác minh tuần tự và tự sửa khi phát hiện bất đồng.
Thu nhỏ để chạy trên trình duyệt
Để có bản demo web, mô hình phải được thu gọn đáng kể. Bảng embedding cho bộ từ vựng 151.936 token chiếm tới 136 triệu tham số — trong khi WorldTUI chỉ cần 333 token. Cắt bỏ phần dư thừa này đưa mô hình từ 494 triệu xuống còn khoảng 360 triệu tham số, rồi lượng tử hóa xuống int4 để đạt 208 MB.
Bản demo dùng một cài đặt JavaScript tùy chỉnh cho bộ giải mã Qwen, với các compute shader viết bằng WGSL chạy qua WebGPU. Toàn bộ quá trình suy luận diễn ra cục bộ trong tab trình duyệt, không gửi dữ liệu lên máy chủ.
Một thử nghiệm thú vị là chưng cất (distillation) sang ít lớp hơn. Việc loại bỏ riêng lớp 7 hầu như không ảnh hưởng đến độ chính xác token tiếp theo (từ 99,3% xuống 98,9%), nhưng khả năng đọc lại bộ nhớ chính xác sụp từ 64/64 xuống 0/64. Điều này cho thấy một mô hình học trò có thể "trông ổn" mà vẫn âm thầm mất khả năng ghi nhớ — cuối cùng tác giả đã từ bỏ hướng chưng cất.
Nó làm được gì?
Điều khiến tác giả hào hứng nhất là khả năng ghi nhớ. Tạo ra một danh sách thư mục trông hợp lý thì dễ; điều khó là tạo tệp, chỉnh sửa, rời đi rồi quay lại và thấy nội dung vẫn nguyên vẹn. Lần đầu mở tmux, sửa tệp trong vim, lưu lại rồi đọc nội dung mới bằng cat ở một cửa sổ tmux khác, tác giả thốt lên: "Nó sống rồi!"
Mô hình cũng xử lý được:
- Vim: chuyển chế độ bằng
esc, lưu, thoát, quay lại insert mode - tmux: tạo nhiều pane, làm việc riêng trong từng pane và chuyển đổi giữa chúng
- Biến môi trường và mở rộng biến
- Python REPL: các phép toán nhỏ thường đúng, list comprehension trả về list nhưng nội dung hay sai
Tất nhiên vẫn có giới hạn rõ rệt: các công cụ cần internet như lynx khá vô nghĩa, các phép Python phức tạp cho ra kết quả kiểu "ảo giác thời GPT-3", và đôi khi mô hình bị lạc đường khi tạo thư mục lồng nhau.
Góc nhìn cho người đọc Việt Nam
Dự án này đáng chú ý ở chỗ nó chứng minh rằng một mô hình chỉ 360 triệu tham số có thể chạy hoàn toàn cục bộ trên trình duyệt mà vẫn duy trì được một thế giới tương đối nhất quán — không cần hạ tầng đám mây, không cần GPU đắt tiền. Với bối cảnh các công cụ AI đang ngày càng phụ thuộc vào API trả phí, những thử nghiệm như thế này mở ra hướng đi cho các ứng dụng AI biên (edge AI) nhẹ nhàng, riêng tư và không phụ thuộc kết nối.
Dĩ nhiên, cần thẳng thắn: WorldTUI không thực sự hữu ích cho công việc hàng ngày. Nó là một thí nghiệm khoa học về bản chất của mô hình thế giới — liệu một hệ thống có thể mô phỏng hành vi mà không cần cài đặt bất kỳ quy tắc nào bên dưới.
"Điều khiến tôi quan tâm nhất là nó duy trì được một thế giới tương đối nhất quán mà không hề triển khai bất kỳ quy tắc nền tảng nào."
Bạn có thể tự trải nghiệm bản demo (tải 208 MB, chạy cục bộ, tốt nhất trên Chrome hoặc Edge với WebGPU). Thử gõ pythoon để thấy rõ đây không phải shell thật. Trọng số mô hình dự kiến sẽ được công bố kèm liên kết tải về.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
PowerShell: Công cụ dòng lệnh của Microsoft khiến giới lập trình phải bất ngờ
22 tháng 10, 2026