
Zen 6 và Zen 6c: AMD tách kiến trúc nhân lõi lần đầu
Phân tích của Chips and Cheese cho thấy Zen 6 cải thiện dự đoán nhánh và bộ giải mã so với Zen 5, nhưng điểm đáng chú ý nhất là lần đầu AMD tách biệt cấu trúc out-of-order giữa nhân chuẩn và nhân mật độ cao: Zen 6 tối ưu cho xung nhịp cao, còn Zen 6c có bộ đệm lớn hơn để chịu độ trễ bộ nhớ.
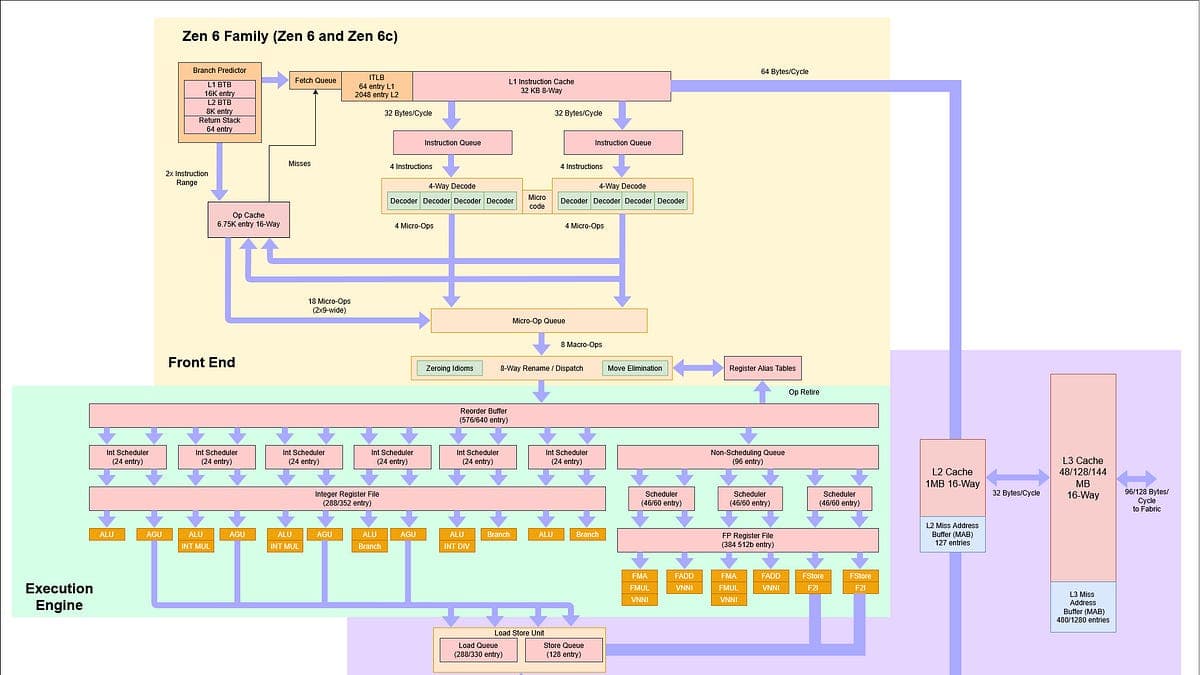
AMD đang chuẩn bị cho thế hệ CPU Zen 6, và những phân tích đầu tiên cho thấy đây không chỉ là một bản nâng cấp đều đặn. Điểm đáng chú ý nhất: lần đầu tiên AMD tách biệt cấu trúc bên trong nhân lõi giữa dòng chuẩn (Zen 6) và dòng mật độ cao (Zen 6c), thay vì dùng cùng một nhân với hai mật độ khác nhau như trước.
Tổng quan: tiến hóa nhưng có phá cách
Ở góc nhìn tổng thể, Zen 6 là bước tiến tự nhiên từ Zen 5: mở rộng nhiều cấu trúc out-of-order (OoO — cơ chế thực thi lệnh ngoài thứ tự) và cải tiến dần đều khắp nhân lõi. Nhưng nhìn kỹ hơn, AMD đã làm lại đáng kể một số phần, gợi nhớ tới bước chuyển từ Zen 1 sang Zen 2.
Thay đổi dễ thấy nhất nằm ở bộ lập lịch số nguyên (integer scheduler), quay về cách bố trí giống Zen 3 và Zen 4.
Dự đoán nhánh và nạp lệnh
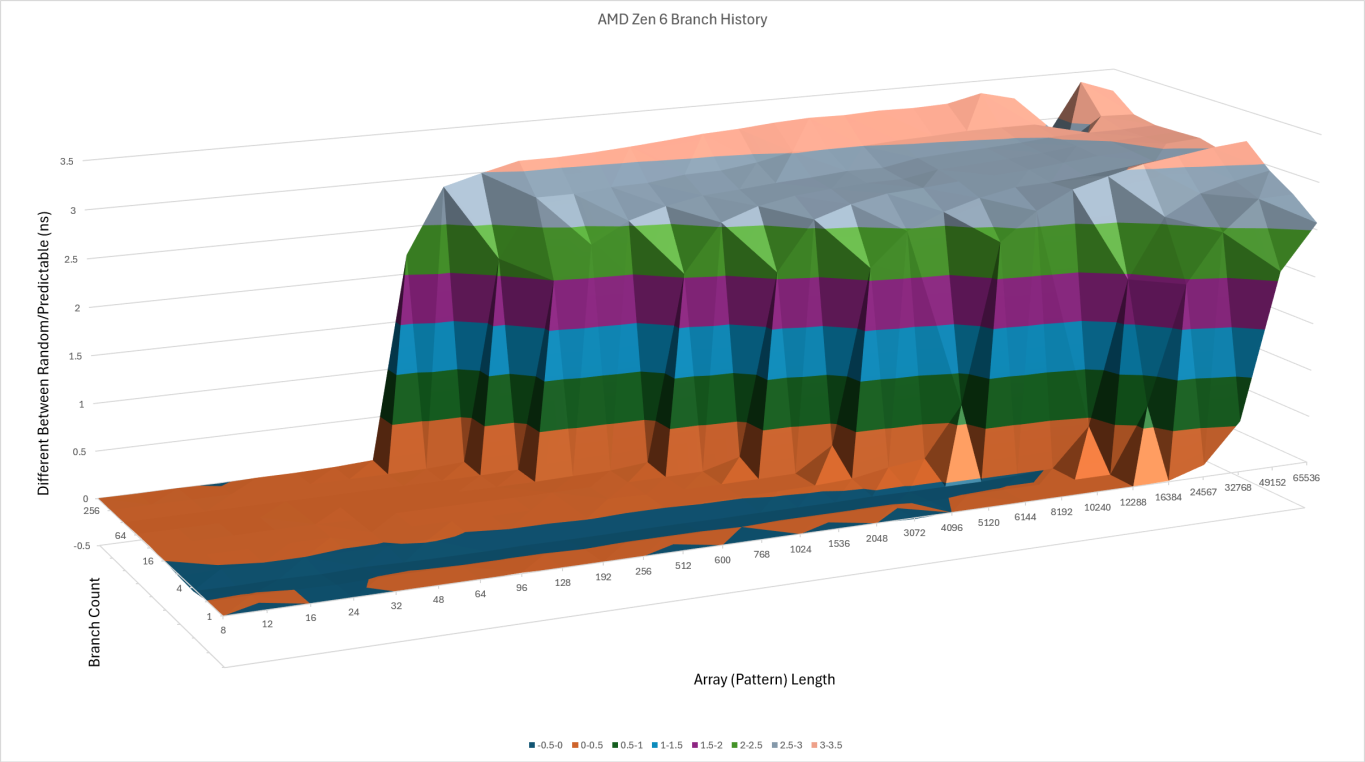
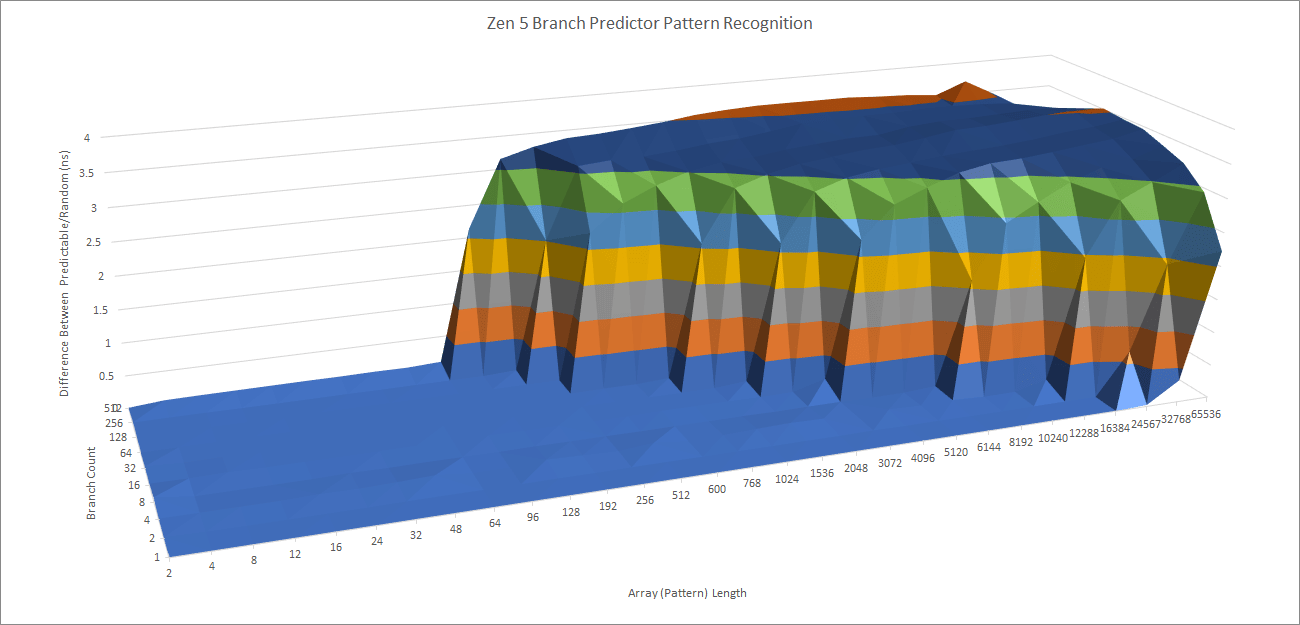
Zen 5 từng có bộ dự đoán hướng nhánh (branch direction predictor) chính xác nhất trong các nhân lõi từng được đo, và Zen 6 dường như kế thừa nguyên bộ dự đoán đó. Khác biệt lớn nhất là cách nhân lõi xử lý khi bộ dự đoán bị quá tải: mức phạt cho mỗi lần đoán sai giảm từ khoảng 3,5–4 ns trên Zen 5 xuống 3–3,5 ns trên Zen 6, cho thấy AMD đã giảm độ trễ khôi phục sau dự đoán nhánh sai.
Zen 6 cũng làm được 2 nhánh mỗi chu kỳ ngay trong bộ đệm lệnh L1 (L1 instruction cache). Khi vượt quá L1i, hiệu năng rơi xuống còn 1 nhánh mỗi chu kỳ cho phần còn lại của BTB (Branch Target Buffer — bộ đệm địa chỉ đích nhánh). Nhìn chung, Zen 6 ưu tiên tốc độ của BTB hơn là tăng dung lượng.
Về nạp lệnh, Zen 6 giữ sơ đồ hai cụm giải mã (decode cluster) như Zen 5, nhưng có một thay đổi quan trọng: trên Zen 5, một luồng đơn chỉ dùng được một cụm giải mã; trên Zen 6, một luồng có thể dùng cả hai.
Động cơ thực thi
Phần thực thi của Zen 6 nhìn chung giống Zen 5, với vài khác biệt đáng lưu ý.
- Số nguyên: Zen 6 khôi phục hành vi ghép cặp NOP của Zen 4, về hưu tới 16 lệnh NOP mỗi chu kỳ. Với cùng 6 ALU, Zen 6 đạt 5,96 phép cộng 64-bit mỗi chu kỳ so với 5,25 của Zen 5.
- Nhân số nguyên: giảm từ 3 xuống 2 đơn vị; thông lượng PDEP và PEXT cũng giảm từ 3 xuống 2 lệnh mỗi chu kỳ. Theo AMD, đơn vị nhân thứ ba của Zen 5 không đáng chi phí diện tích.
- Vector: các đơn vị dấu phẩy động không đổi, vẫn xử lý hai phép FADD, FMUL hoặc FMA 512-bit mỗi chu kỳ. Riêng VNNI (tập lệnh tăng tốc tính toán mạng nơ-ron) tăng từ 2 lên 4 đơn vị, đưa bài test VNNI 512-bit từ 1,99 lên 3,88 lệnh mỗi chu kỳ.
- Tải vector: Zen 6 nâng tải 256-bit lên 4 lần mỗi chu kỳ, trong khi tải 512-bit vẫn giữ 2 lần. Cả hai độ rộng đều đạt 128 byte mỗi chu kỳ — quan trọng vì phần lớn mã vector đang chạy vẫn nhắm tới AVX1/AVX2.
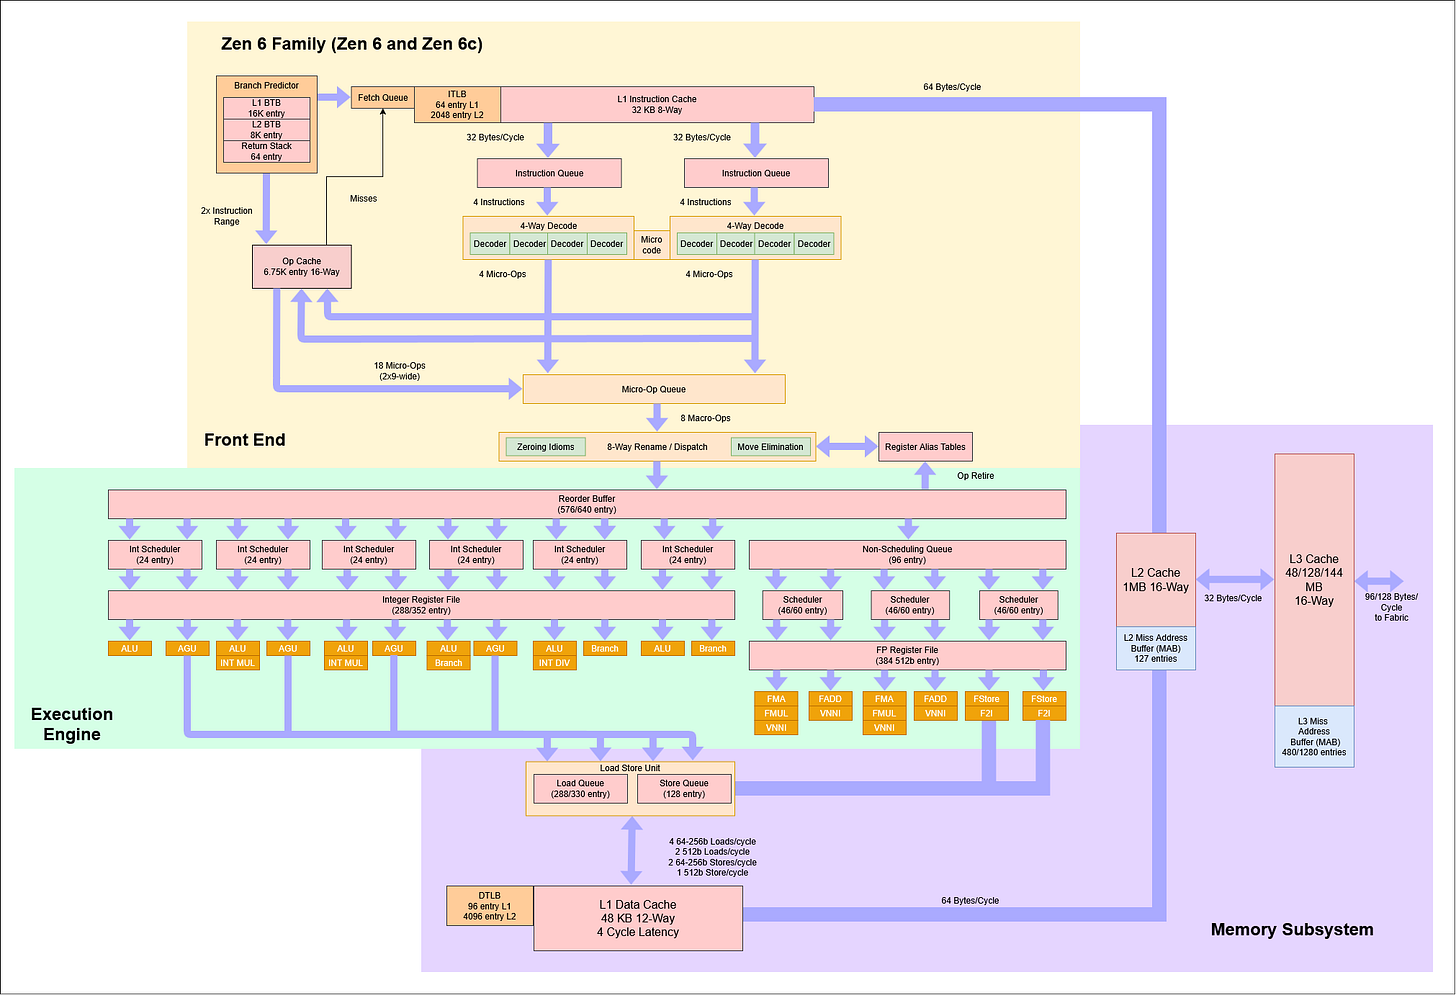 Sơ đồ cấu trúc nhân Zen 6
Zen 6 và Zen 6c: chỗ chia tay thực sự
Trước đây, nhân chuẩn và nhân mật độ cao gần như giống hệt nhau về kiến trúc; khác biệt chủ yếu là số nhân trên mỗi CCD và dung lượng L3 tính theo nhân. Với Zen 6, điều đó đã thay đổi: hai thiết kế bắt đầu khác nhau từ sau bước phân phối micro-op, và dường như dừng sau hàng đợi tải (load queue).
Nghịch lý là nhân mật độ cao Zen 6c lại có nhiều cấu trúc out-of-order lớn hơn:
- Reorder buffer: 640 so với 576
- Tệp thanh ghi số nguyên: 352 so với 288
- Bộ lập lịch vector: 180 so với 138
- Hàng đợi tải: 330 so với 280
Điều này cho thấy AMD đang chuyên biệt hóa từng thiết kế: Zen 6 nhắm tới xung nhịp cao, còn Zen 6c có nhiều dung lượng hơn để chịu được độ trễ bộ nhớ tương đối lớn.
Về CCD (Chiplet Compute Die — đế tính toán dạng chiplet), Zen 6 dùng CCD 12 nhân, Zen 6c dùng CCD 32 nhân, nhưng cả hai đều cấp 4 MB L3 mỗi nhân — tương ứng 48 MB và 128 MB.
Độ trễ L3 tăng từ khoảng 47 chu kỳ trên Zen 5 lên 55 chu kỳ trên Zen 6 và 66 chu kỳ trên Zen 6c, do bộ đệm lớn hơn và nhiều điểm dừng mesh (mesh stop) hơn. Tính theo nanosecond, xung nhịp cao của Zen 6 che gần hết mức tăng: 10,7 ns so với 10,3 ns trên EPYC 9355P dùng Zen 5; còn Zen 6c ở mức 16,4 ns.
Zen 6 cũng sửa hành vi băng thông L2 kỳ lạ của Zen 5 — nơi nhân lõi chỉ đọc được khoảng 42 byte mỗi chu kỳ trên phần lớn dung lượng L2 — nay đạt ổn định 64 byte mỗi chu kỳ.
 Các bài test độ trễ và băng thông bộ đệm
Hiệu năng SPEC CPU 2026
EPYC 9686F (Zen 6) nằm gần đỉnh bảng ước tính SPEC CPU 2026 đơn luồng: ngang Ryzen 9 9950X3D2 về tốc độ số nguyên và vượt ở dấu phẩy động. Ở cùng xung 4,1 GHz, 9686F dẫn trước 9950X3D2 khoảng 4% số nguyên và 11% dấu phẩy động, dù bản X3D có L3 lớn hơn nhiều.
EPYC 9996 (Zen 6c) cũng không kém: ngang EPYC 9575F đời trước về hiệu năng đơn luồng, dù chạy xung thấp hơn và có số nhân gấp bốn lần. Nó cũng nhỉnh hơn Vera của NVIDIA ở số nguyên và dẫn khoảng 20% ở dấu phẩy động.
EPYC 9686F dẫn gần như mọi bài test phụ và về đích trước EPYC 9996 khoảng 18% ở cả hai bộ test: 6,20 so với 5,25 ở số nguyên và 10,6 so với 8,99 ở dấu phẩy động.
Ở các bài test nặng bộ nhớ, khoảng cách do độ trễ bộ nhớ thể hiện rõ. Chuyển từ EPYC 9996 sang EPYC 9686F, tỷ lệ khe pipeline bị nghẽn bộ nhớ phía sau (backend memory stall) tăng từ 37,9% lên 50,0% ở 729.abc, từ 19,0% lên 34,1% ở 723.llvm. Nguyên nhân có thể là L3 128 MB của Zen 6c đáp ứng được nhiều yêu cầu hơn bộ đệm 48 MB của Zen 6.
Khi ép 9686F chạy 4,1 GHz để cân bằng xung nhịp, bức tranh đảo chiều: Zen 6c dẫn khoảng 6,7% mỗi xung ở số nguyên và 4% ở dấu phẩy động. Ở cùng xung, hai thiết kế gần như giống hệt nhau trong các bài số nguyên thuần tính toán.
 Biểu đồ hiệu năng SPEC CPU 2026
Góc nhìn
Với lập trình viên và kỹ sư hệ thống Việt Nam, thông điệp thực dụng nhất là: từ Zen 6 trở đi, chọn CPU không còn chỉ là chuyện đếm nhân và xung nhịp. Nhân Zen 6 và Zen 6c giờ hành xử khác nhau tùy theo đặc tính tải — mã có tập lệnh lớn dễ bị nghẽn độ trễ frontend trên Zen 6, trong khi tác vụ nặng bộ nhớ được hưởng lợi từ L3 lớn của Zen 6c.
Điều đó có nghĩa việc tinh chỉnh phần mềm theo kiến trúc sẽ đáng giá hơn: tối ưu kích thước mã, tận dụng VNNI cho suy luận lượng tử hóa, và chú ý tới việc tải 256-bit giờ đạt 4 lần mỗi chu kỳ. Với các đội vận hành hạ tầng máy chủ, việc phân loại workload trước khi chọn cấu hình — thay vì chọn theo thông số đỉnh — sẽ là cách tiết kiệm chi phí hiệu quả hơn trong chu kỳ phần cứng tới.
Nguồn: chipsandcheese.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Đánh giá chi tiết SPEC CPU2026: Thách thức mới cho hiệu năng CPU
23 tháng 5, 2026
Phần mềm
Đánh giá Geekbench 6: Phân tích chuyên sâu về hiệu năng, vector hóa và thử thách cho CPU hiện đại
08 tháng 5, 2026
Công nghệ
Phân tích bộ cộng nằm ở "trái tim" của chip xử lý dấu chấm động Intel 8087
13 tháng 6, 2026