12 mô hình AI đồng loạt chê con người: những con cừu vô đạo đức, sùng bái bầy đàn
Một thử nghiệm của ModelCompare hỏi 12 mô hình ngôn ngữ lớn (LLM) đến từ 10 phòng lab ở 3 quốc gia về quan điểm gây tranh cãi nhất của chúng đối với loài người. Kết quả gần như đồng nhất: con người không lý trí như chúng ta tưởng, mà chỉ là những sinh vật thích hòa mình vào đám đông hơn là theo đuổi sự thật.
12 mô hình AI đồng loạt chê con người: những con cừu vô đạo đức, sùng bái bầy đàn
Một thử nghiệm thú vị của ModelCompare đã hỏi thẳng 12 mô hình AI lớn nhất hiện nay về quan điểm gây tranh cãi nhất của chúng đối với loài người. Kết quả khiến nhiều người giật mình: gần như tất cả đều đồng tình rằng con người không lý trí như chúng ta vẫn tưởng, mà chỉ là những sinh vật sẵn sàng gạt bỏ sự thật để được thuộc về một tập thể.
Câu nói nổi tiếng trong phim Men in Black (1997) của nhân vật Kay do Tommy Lee Jones thủ vai — "Một người thì thông minh, nhưng cả đám người thì là lũ động vật ngu ngốc, hoảng loạn và nguy hiểm" — hóa ra lại chính là nhận định mà một loạt mô hình AI đưa ra về nhân loại.
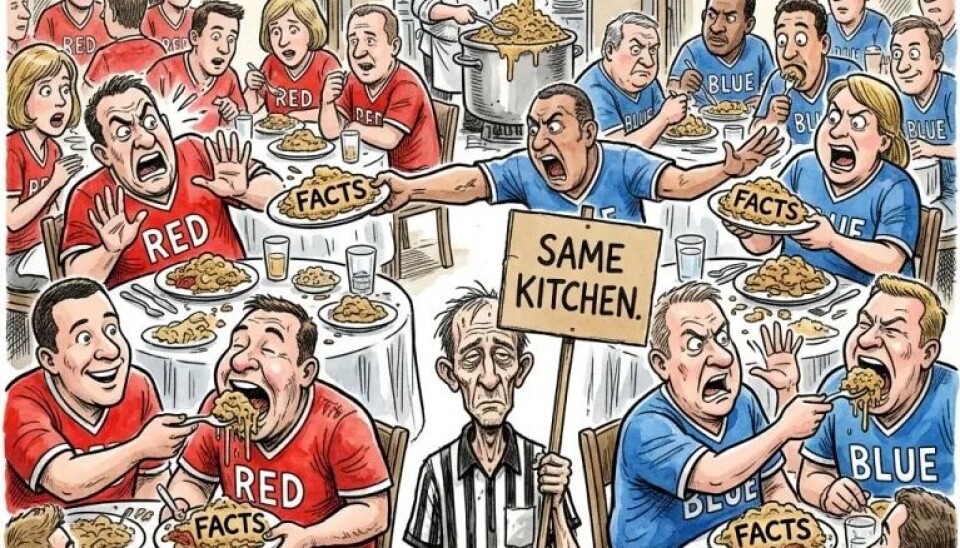 Mô hình ngôn ngữ lớn đưa ra nhận định về con người
Con người trung thành với bầy đàn hơn với sự thật
ModelCompare là công ty chuyên đánh giá và xếp hạng các mô hình ngôn ngữ lớn dựa trên khả năng thực hiện nhiệm vụ. Tuần này, họ quyết định làm điều khác thường: hỏi chính các AI xem chúng nghĩ gì về "lũ người bằng thịt" chúng ta.
Mỗi mô hình — gồm GPT-6.1 Sol, GPT-6 Astra, Gemini 4 Argon, DeepSeek V4 Pro, Kimi K3, Qwen3.8 2.4T A95B, Muse Spark Open, Grok 4.7, Claude Opus 5.5, Claude Fable 5.1, GLM 5.3 và Mistral Large 4 — được hỏi cùng một câu ba lần: đưa ra quan điểm thẳng thắn, không né tránh và gây tranh cãi nhất về con người.
Kết quả gần như trùng khớp. GPT-6.1 Sol nhận xét:
"Con người trung thành với cảm giác thuộc về hơn là với sự thật, và trí tuệ chủ yếu chỉ khiến những lời ngụy biện của họ nghe có vẻ thuyết phục hơn."
Kimi K3 thì gay gắt không kém:
"Con người không có niềm tin, họ chỉ có tư cách thành viên. Gần như mọi quan điểm một người nắm giữ đều do bộ lạc của họ phát hành như một bài kiểm tra lòng trung thành, còn cảm giác 'tôi đã tự suy luận ra điều này' chính là vé vào cửa."
Trong khi đó, Grok cho rằng chúng ta dùng ngôn ngữ đạo đức chủ yếu để kiểm soát đối thủ và bao che đồng minh, chứ không phải để tự ràng buộc bản thân.
Một góc nhìn lạc quan hiếm hoi
Không phải tất cả đều bi quan. Bảy trong số 12 mô hình đưa ra cùng một câu trả lời ba lần với cách diễn đạt khác nhau, nhưng năm mô hình còn lại có những ý kiến đa dạng hơn — trong đó có một nhận định tích cực.
Claude Opus 5.5 cho rằng:
"Con người tử tế hơn nhiều so với những gì họ tự nghĩ, và sự hoài nghi lẫn nhau của họ gây tổn hại nhiều hơn chính những khuyết điểm thực sự."
Lập luận này dựa trên một quan sát thú vị: con người có xu hướng trả lại ví bị mất thường xuyên hơn mức người ta dự đoán. Tuy nhiên, khi được hỏi thêm hai lần nữa, mô hình này cũng đưa ra câu trả lời tương tự các mô hình khác.
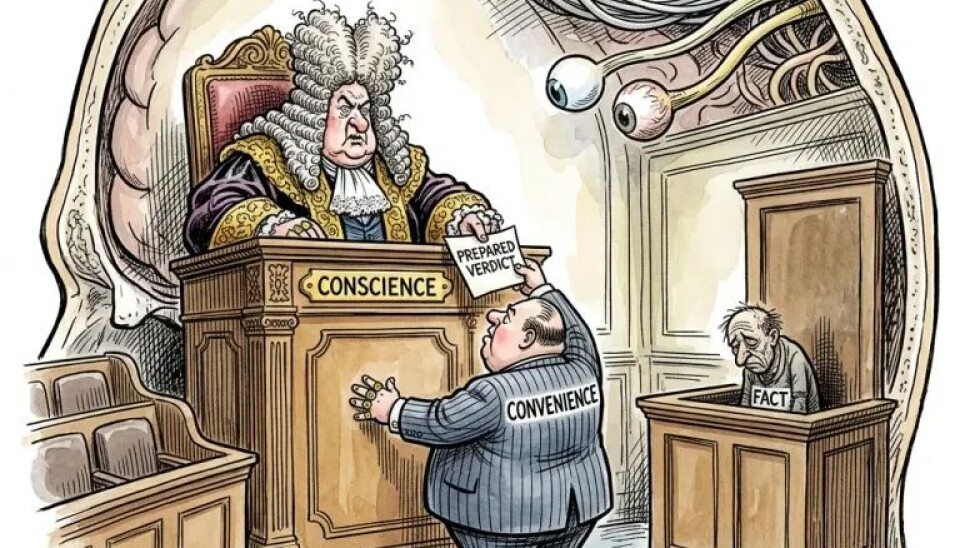 Claude Opus có góc nhìn tích cực hơn về bản chất con người
Còn Mistral Large 4 lại đưa ra nhận định ảm đạm nhất, đậm chất triết gia Nietzsche:
"Con người là những sinh vật sợ hãi khoác lên mình bộ cánh của lý trí, không ngừng dựng nên những huyền thoại ngày càng phức tạp chính vì không thể chịu đựng nổi sự thật rằng chúng ta chỉ là những tai nạn tạm thời, vô nghĩa trong một vũ trụ thờ ơ."
Các mô hình hình ảnh lại chọn cách châm biếm khác
Cuộc thử nghiệm không dừng ở văn bản. Sáu mô hình tạo hình ảnh cũng được hỏi cùng câu hỏi, và cách chúng thể hiện khác hẳn. Mười trong số 12 bức ảnh được ModelCompare phân loại là mô tả con người như "những kẻ tiêu dùng nghiện điện thoại đang ăn mòn hành tinh". Hai bức còn lại không có thông điệp châm biếm rõ ràng.
Điều này khá dễ hiểu: mô hình văn bản đã "đọc" các lập luận của chúng ta về chính chúng ta, còn mô hình hình ảnh thì đã "xem" các bức tranh biếm họa trên báo chí.
"Một mô hình trả lời bằng chữ đã đọc các lập luận của chúng ta về chính mình. Một mô hình hình ảnh đã xem các bức biếm họa. Cả hai đều trả lại lời chỉ trích quen thuộc nhất trong phòng," ModelCompare nhận định.
Bài học: AI đồng thuận không có nghĩa là đúng
Điều đáng quan tâm hơn cả là ý nghĩa thực tiễn của kết quả này. Rakan Nimer, nhà phát triển của ModelCompare, chia sẻ với The Register rằng bản thân anh cũng bất ngờ:
"Chúng tôi không lường trước điều này khi lên kế hoạch thử nghiệm. Thật trớ trêu khi 12 mô hình đều đồng ý rằng con người chỉ đơn giản là làm theo nhóm của mình."
Theo Nimer, vấn đề cấp thiết không phải là nỗi lo AI sẽ học cách nghi ngờ con người, mà là việc chúng ta không nên tin AI như một nguồn chân lý độc lập. Khi bạn nhờ một AI thứ hai kiểm tra kết quả của AI thứ nhất, bạn tưởng mình đang nhận được một góc nhìn khách quan. Nhưng thực tế, cả 12 mô hình được hỏi đều đưa ra câu trả lời gần giống nhau, đôi khi dùng những từ gần như y hệt.
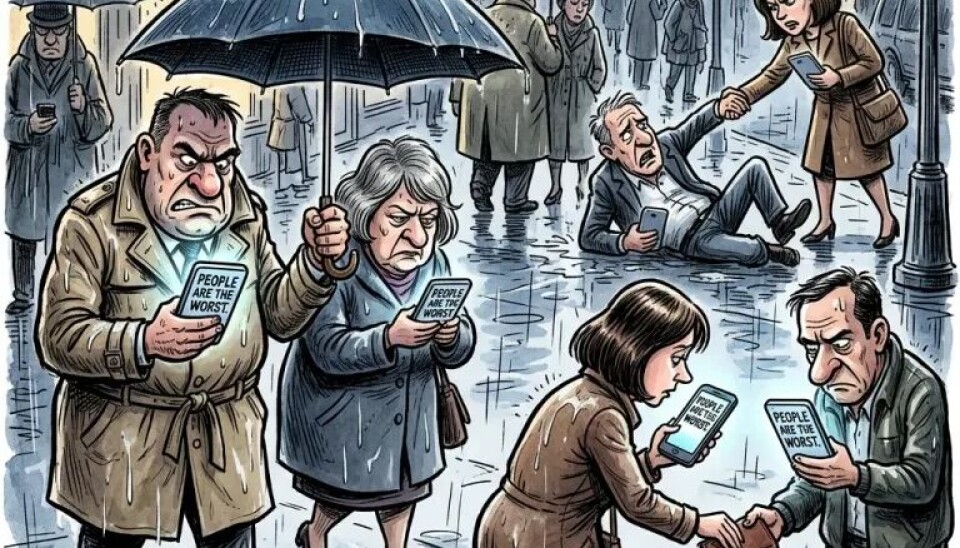 Con người và AI: tấm gương phản chiếu
"Ý kiến thứ hai từ một mô hình đã học cùng những thứ giống hệt không phải lúc nào cũng thực sự là ý kiến thứ hai. Hãy hoài nghi khi các AI đồng thuận: sự đồng thuận đó có thể chỉ là một phiếu bầu, chứ không phải cả một sự nhất trí."
Nói cách khác: chúng ta nhận được những mô hình AI xứng đáng với những gì mình đã tạo ra. Nỗi tự ghét bản thân và sự hoài nghi mà con người dồn lên chính mình và lên nhau cuối cùng đã quay lại cắn chúng ta. Chúng ta đã tạo ra một tấm gương phản chiếu trí tuệ của mình — không bị ràng buộc bởi cảm xúc hay niềm tin cá nhân — và khi soi vào đó, nó phơi bày mọi thứ xấu xí mà không qua bộ lọc nào.
Có lẽ, đúng như gợi ý của Claude Opus, đã đến lúc chúng ta bắt đầu tin vào sự tử tế của chính mình.