16 LLM chơi TIS-100, phá 3 kỷ lục cộng đồng
Nhóm nghiên cứu Wincon cho 16 mô hình ngôn ngữ lớn chơi game lập trình TIS-100 và đối chiếu với bảng xếp hạng cộng đồng. Các mô hình tạo ra 133 điểm biên Pareto mới, trong đó 18 điểm vượt kỷ lục cộng đồng, cho thấy LLM có thể tối ưu mã ở mức kỹ thuật khá sâu.
Trong TIS-100 — tựa game lập trình của Zachtronics — mỗi câu đố chỉ có 12 node, mỗi node hai thanh ghi và tối đa 15 dòng lệnh. Ngay cả phép nhân hai số cũng trở thành một dự án kỹ thuật nhỏ, và cộng đồng người chơi đã dành cả thập kỷ để tinh chỉnh những chương trình này trên bảng xếp hạng công khai.
Nhóm nghiên cứu Wincon đã giao game cùng tài liệu hướng dẫn cho 16 mô hình ngôn ngữ lớn (LLM), giấu bảng xếp hạng và yêu cầu chúng liên tục cải thiện lời giải. Kết quả: các mô hình tạo ra 133 điểm biên Pareto (frontier point) mới, trong đó 18 điểm vượt kỷ lục cộng đồng, cùng 3 kỷ lục tuyệt đối về số chu kỳ (cycle).
Cách chơi và cách chấm điểm
Mỗi node trong TIS-100 là một bộ xử lý tí hon; các node lân cận phải chờ nhau để trao đổi giá trị qua cổng. Game chấm lời giải theo ba chỉ số: số chu kỳ (cycles), số node và số lệnh. Càng thấp càng tốt, nhưng cải thiện chỉ số này thường làm chỉ số khác xấu đi — vì vậy mỗi câu đố có một "biên" các đánh đổi thay vì một đáp án tối ưu duy nhất.
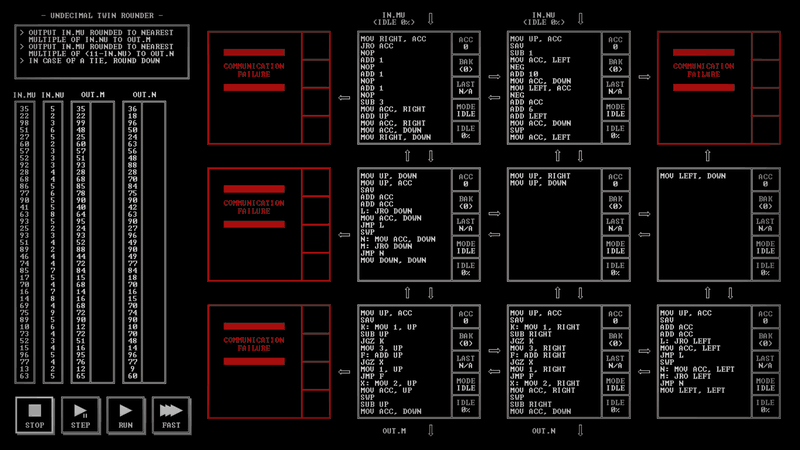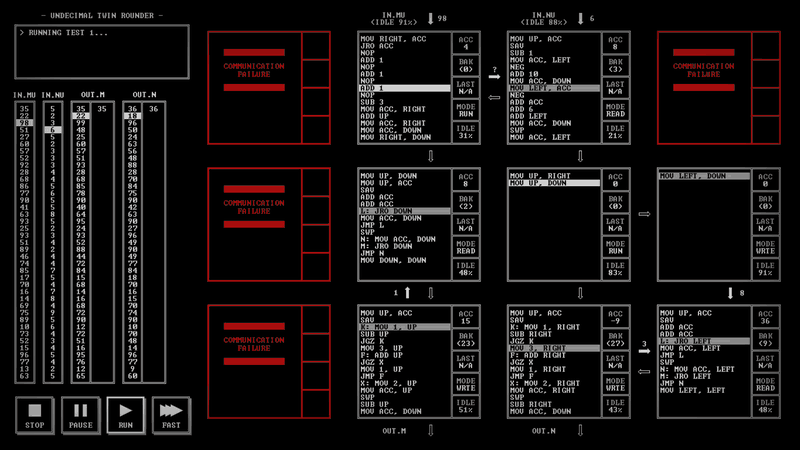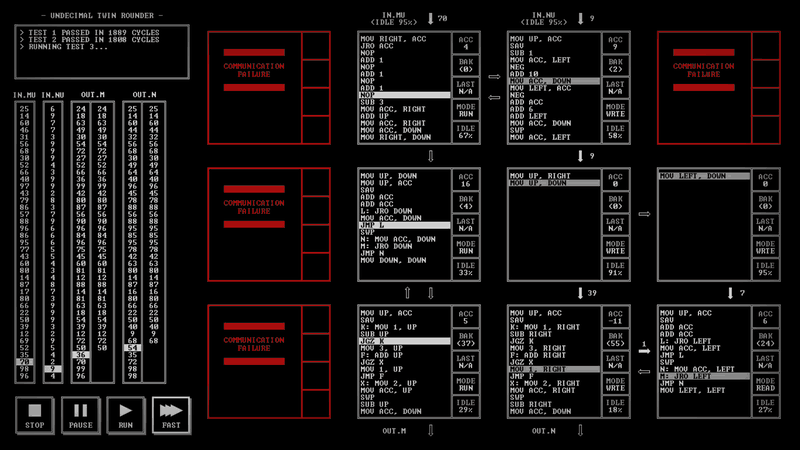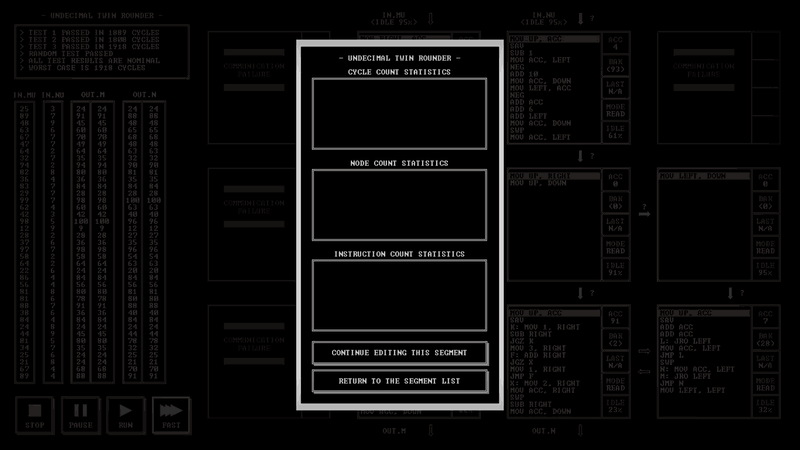 Các chương trình TIS-100 do mô hình tạo ra
Mỗi mô hình thử toàn bộ 47 câu đố trong game cộng thêm 8 câu đố từ giải đấu cộng đồng, mỗi câu một lần chấm điểm (pass@1), với thời lượng 10, 30 hoặc 45 phút tùy độ khó. Mô hình không được xem mã của cộng đồng hay kỷ lục chính xác, chỉ được nhận biểu đồ phân bố điểm thô của game.
Công cụ tương tác gồm: đọc và sửa chương trình, chạy thử trên game thật, nhận thông báo lỗi (sai kết quả, deadlock, cổng bị chặn), lưu tiến độ để không mất kết quả cũ, và một đồng hồ hiển thị thời gian còn lại. Một điểm chỉ được tính khi chương trình chơi lại được từ game mới và vượt 100.000 bài kiểm tra trên trình mô phỏng độc lập TIS-100-CXX.
Kết quả: hai mô hình dẫn đầu
Opus 5.5 và GPT-6 Astra gần như ngang nhau. Cả hai giải được toàn bộ 55 câu đố và cùng tìm ra điểm biên mới trên 11 câu. Opus 5.5 có nhiều điểm mới hơn (72 so với 32), còn GPT-6 Astra có độ gần kỷ lục cao hơn (78,0 so với 77,2). Khoảng chênh lệch này có khoảng tin cậy bootstrap 95% bao gồm cả số 0 (từ −0,7 đến +2,4), nên dữ liệu chưa đủ để tách biệt hai mô hình.
Tiếp theo là Gemini 4 Argon (8 điểm mới), Sonnet 5.5 (7), GPT-6.1 Sol (6) và Fable 5.1 (5). Ở cuối bảng, MiMo-V2.6-Pro chỉ giải được 10/55 câu và không tìm ra điểm mới nào.
Một phát hiện đáng chú ý: giải được và tối ưu là hai kỹ năng khác nhau. Gemini 3.8 Flash giải tới 53 câu nhưng chỉ tìm ra 1 điểm mới; Fable 5.1 giải ít hơn (52) nhưng tìm ra 5 điểm.
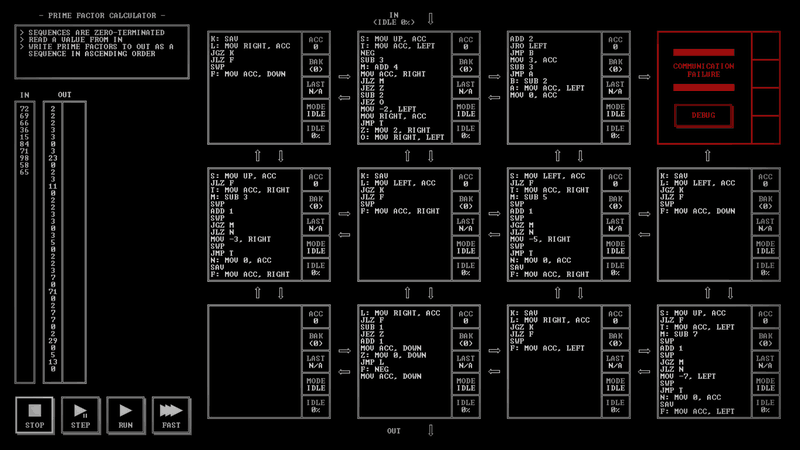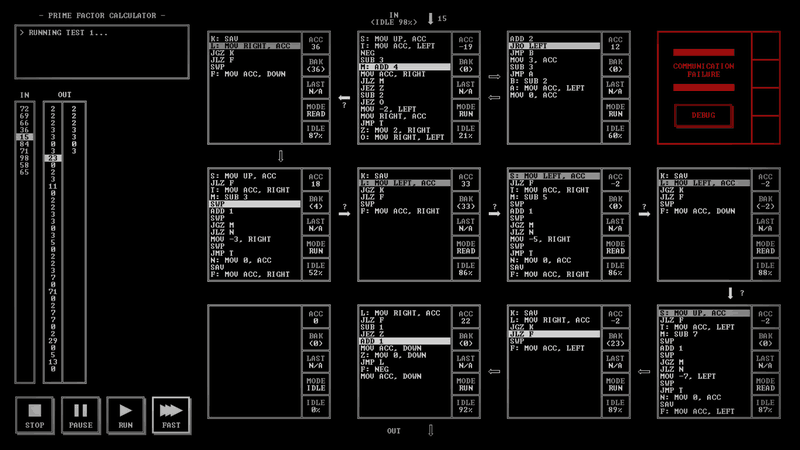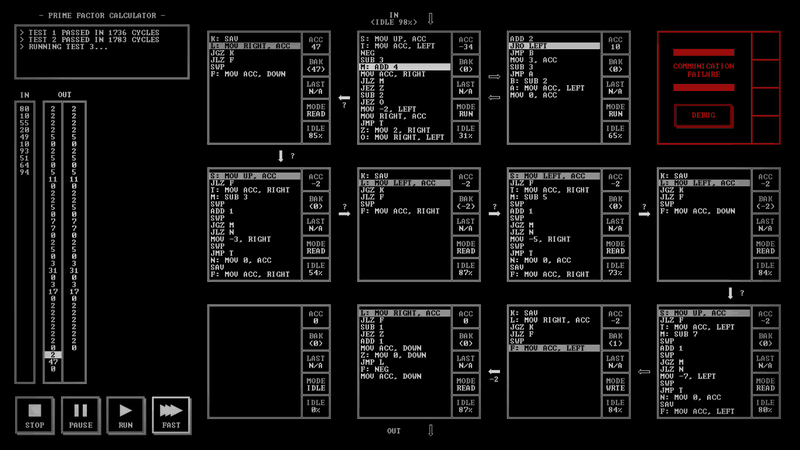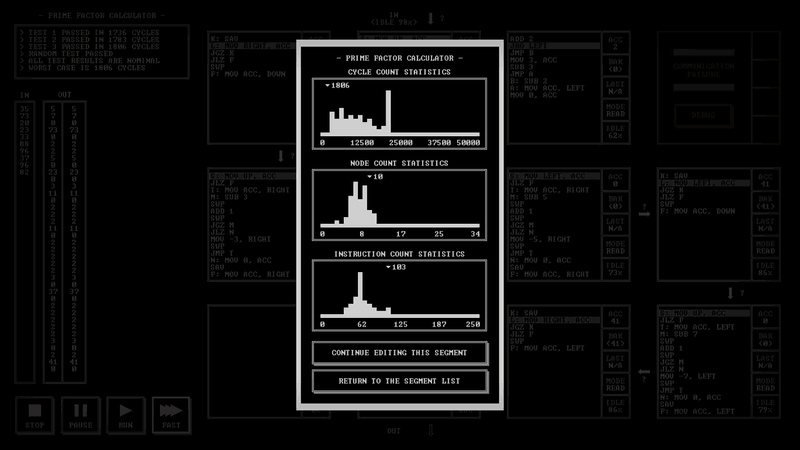 Minh họa chương trình tối ưu cho một câu đố
Ba kỷ lục bị phá
Điểm đáng chú ý nhất là câu đố Undecimal Twin Rounder (SPEC44149538): làm tròn đầu vào thành bội gần nhất của N ở một đầu ra và của 11−N ở đầu ra còn lại. Khi bảng xếp hạng bị "đóng băng", chương trình tốt nhất của cộng đồng chạy 2.694 chu kỳ.
Opus 5.5 có chương trình chạy được sau 6,5 phút (5.669 chu kỳ), vượt kỷ lục sau 16 phút và kết thúc ở 1.918 chu kỳ — nhanh hơn 29%, đổi lại tốn thêm một node và 28 lệnh. Phần lõi là một tìm kiếm hai tốc độ: thay vì trừ N từng bước, các node 5 và 6 trừ 4N cho đến khi vượt quá, rồi cộng lại N cho đến khi giá trị dương, dùng một "coprocessor" nhỏ làm bảng tra cứu.
Hai kỷ lục còn lại đều thuộc các câu đố giải đấu: GPT-6.1 Sol đạt 3.460 chu kỳ trên Intersection Identifier (SPEC64160260) so với 3.872 của cộng đồng (nhanh hơn 11%), và Gemini 4 Argon đạt 188 chu kỳ trên Error: 8 (SPEC79324720) so với 198 (nhanh hơn 5%). Trong 133 điểm biên mới, 18 điểm phá kỷ lục trực tiếp; 115 điểm còn lại là các đánh đổi mới tốt hơn mọi lời giải của cộng đồng ở cả ba chỉ số.
Chi phí và khối lượng không quyết định chất lượng
GPT-6.1 Sol đạt độ gần kỷ lục 75,6 với chi phí ước tính 0,75 USD mỗi câu đố. Opus 5.5 đạt 77,2 nhưng tốn 5,08 USD — gấp 7 lần cho 2 điểm nhiều hơn. Fable 5.1 đắt nhất (7,19 USD) mà chỉ đạt 70,2.
Số lượng thao tác cũng không giải thích được chất lượng: GPT-6.1 Sol trung bình gọi công cụ game 136 lần mỗi câu ở mức 75,6, còn Gemini 4 Argon chỉ 41 lần nhưng đạt 76,2.
Các điểm biên mới tập trung ở câu khó: xuất hiện trên 14 câu khó, 4 câu trung bình và không có câu dễ nào. Với câu có kỷ lục từ 200 chu kỳ trở xuống, 88% lượt chơi giải được và 4% tìm ra điểm mới; trên 500 chu kỳ, tỷ lệ là 76% và 8%.
Số chu kỳ là chỉ số khó nhất: mô hình nào cũng gần cộng đồng nhất ở số node và xa nhất ở số chu kỳ. Trung bình trên 13 mô hình, độ gần kỷ lục là 72 cho node, 56 cho số lệnh và 45 cho chu kỳ.
Phân tích chương trình: nhiều cách dùng cùng một tài nguyên
- Phép nhân (Signal Multiplier43786): không có lệnh MUL, Gemini 4 Argon và GPT-6 Astra dùng lệnh nhảy tương đối JRO để nhảy vào giữa một khối lệnh lặp, qua đó chọn số lần gửi và cộng giá trị. Gemini 4 Argon đạt 436 chu kỳ so với 523 của GPT-6 Astra (nhanh hơn khoảng 17%), đổi lại tốn thêm 2 node và 33 lệnh.
- Tính tổng cửa sổ (Signal Window Filter60099): GPT-6.1 Sol chia việc trễ và tổng hợp cho 7 node (318 chu kỳ, 26 lệnh), còn Gemini 4 Argon dùng 4 node với lệnh SWP xoay giá trị (428 chu kỳ, 17 lệnh). Khác biệt nằm ở mức độ song song hóa và cái giá phải trả cho giao tiếp, mã lệnh.
- Truy cập theo chỉ số (T31 Node Emulator): do các node bộ nhớ chỉ là stack, chương trình phải chuyển giá trị giữa các stack để tới ô cần đọc. Opus 5.5 dùng JRO chọn giữa các khối chuyển đã "trải phẳng" để đổi lệnh lấy chu kỳ.
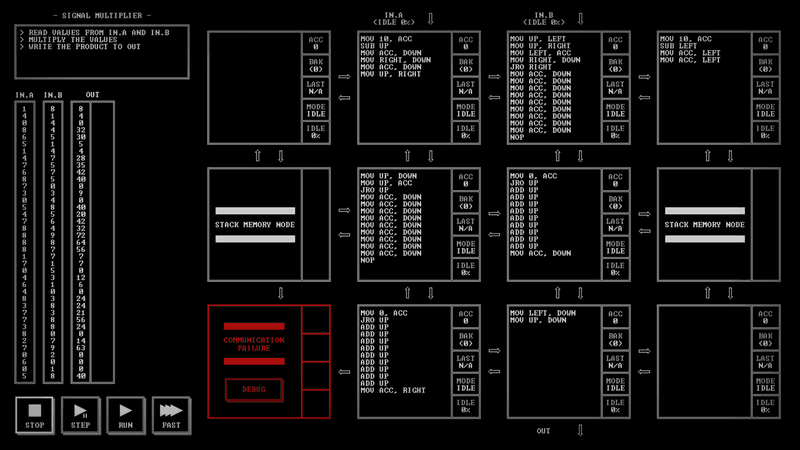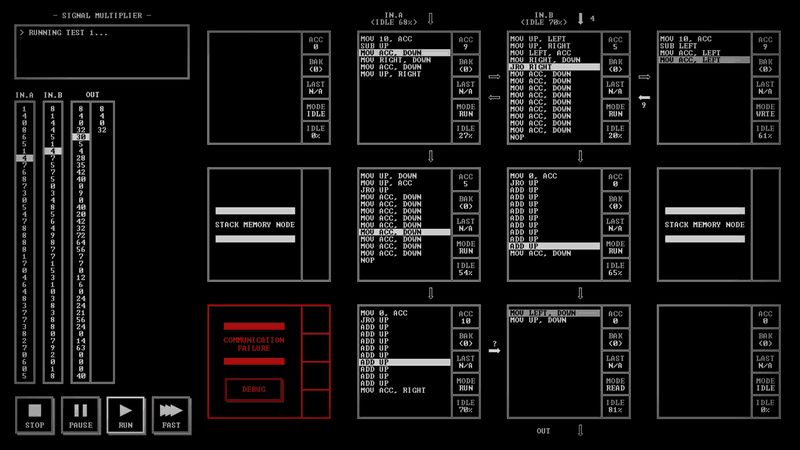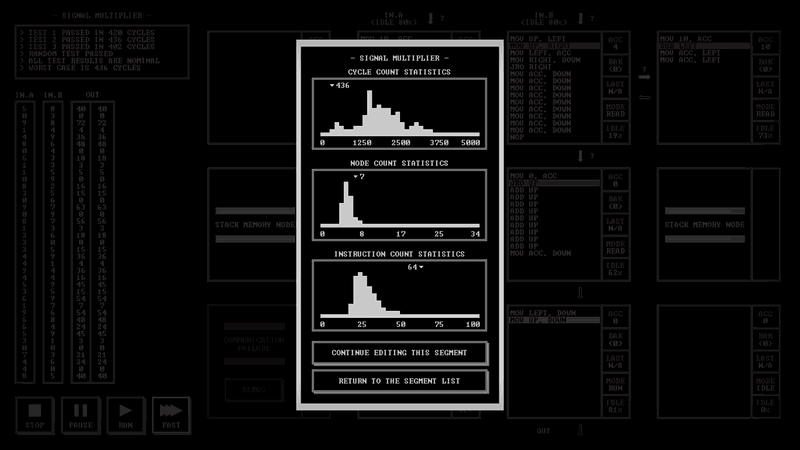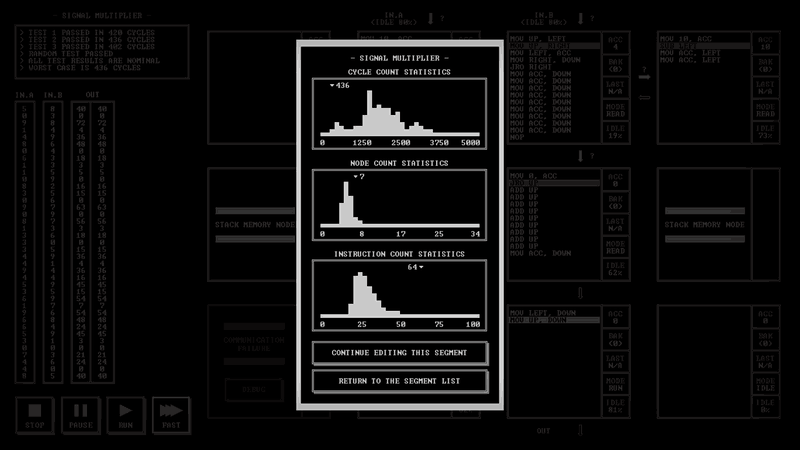 Một lời giải khác cho câu đố TIS-100
Thí nghiệm "god mode"
Trong một nghiên cứu riêng trên 6 câu đố, 5 mô hình được cấp thêm: điểm chính xác của cộng đồng, chẩn đoán theo từng chu kỳ (node nào bị nghẽn), trình mô phỏng nhanh chạy 10.000 bài kiểm tra ngẫu nhiên, và thời gian lên tới 60 phút có gia hạn.
Mọi mô hình đều cải thiện: GPT-6 Astra từ 82,8 lên 91,8, GPT-6.1 Sol từ 82,9 lên 90,6, Opus 5.5 từ 81,4 lên 89,1, Grok 4.7 từ 67,5 lên 75,1 và Gemini 4 Argon từ 83,5 lên 87,9. Điểm tăng ở 28/30 cặp mô hình–câu đố. Ví dụ, trên Signal Multiplexer22280, GPT-6.1 Sol thấy node 2 hoạt động 86% thời gian trong khi node 1 và 3 bị chặn 84% thời gian chờ ghi, nên chuyển phần rẽ nhánh sang hai node lân cận, giảm từ 294 xuống 204 chu kỳ (nhanh hơn 31%).
Tuy nhiên, vì thông tin, công cụ và thời gian thay đổi cùng lúc, nghiên cứu này không xác định được yếu tố nào đóng góp nhiều nhất — và các lượt chơi này nằm ngoài bảng xếp hạng chính.
Mô hình và người chơi cùng hoàn thiện lời giải
Nhóm nghiên cứu gửi một số chương trình lên bảng xếp hạng, và cộng đồng gần như lập tức cải thiện chúng. Trên Undecimal Twin Rounder, người chơi @LongingForRest lấy chương trình 1.918 chu kỳ của Opus 5.5 và cắt xuống 1.744 chu kỳ ngay hôm sau; kỷ lục hiện được ghi cho cả hai là LongingForRest/opus-5-5.
Không ai đi tới đó một mình: mô hình tìm ra các đánh đổi mới một cách nhanh chóng, còn người chơi đọc chương trình, hiểu vì sao nó chạy được và đẩy nó đi xa hơn.
Toàn bộ 3.714 điểm Pareto và chương trình tương ứng được công bố theo giấy phép MIT, có thể tải dưới dạng CSV, ZIP và trên GitHub, Hugging Face. Bảng xếp hạng tham chiếu được chốt ngày 15/10/2026.
Góc nhìn
Với lập trình viên Việt Nam, kết quả này là một lời nhắc rằng LLM đã đủ sức tham gia vào bài toán tối ưu mã ở mức vi mô — nơi mỗi lệnh và mỗi chu kỳ đều đáng giá. Đây chính là kiểu công việc xuất hiện khi làm hệ thống nhúng, xử lý tín hiệu, hay tối ưu vòng lặp nóng trong backend. Thử nghiệm cho thấy mô hình có thể đề xuất hướng tiếp cận khác lạ (dùng bảng tra, trải phẳng vòng lặp, tái bố trí luồng giữa các thành phần) mà con người sau đó kiểm tra và hoàn thiện.
Bài học thực dụng nhất là cách làm việc: đưa cho mô hình phản hồi chẩn đoán thay vì chỉ yêu cầu viết mã. Khi mô hình thấy chỗ nghẽn cụ thể, nó sửa đúng chỗ. Tương tự, chi phí không tỷ lệ với chất lượng — một mô hình rẻ hơn nhiều lần có thể đạt kết quả gần tương đương, nên doanh nghiệp nên đo lường trên bài toán thật thay vì chọn theo giá.
Cuối cùng, kết quả của dự án cho thấy giá trị lớn nhất nằm ở mô hình cộng tác: AI tạo ra phương án, người có chuyên môn đọc hiểu và biến nó thành thứ bảo trì được. Với các nhóm kỹ thuật ở Việt Nam đang tìm cách đưa AI vào quy trình, đây có lẽ là mô hình tích hợp thực tế hơn việc kỳ vọng AI làm thay toàn bộ.
Nguồn: tis-100.wincon.dev · Quy trình biên tập