
500 tỷ token và bài học xương máu: Dùng AI agent dịch ngược game bắn súng góc nhìn thứ nhất
Một nhóm kỹ sư đã dùng AI agent để dịch ngược một tựa game bắn súng góc nhìn thứ nhất sang C++, tiêu tốn khoảng 600-700 tỷ token trong vài tháng. Bài học lớn nhất: chỉ khi xây dựng được cơ chế kiểm chứng khách quan (so khớp byte) thì chất lượng mới thực sự đảm bảo, còn tiến độ trông có vẻ tốt chưa chắc đã đúng.
500 tỷ token và bài học xương máu: Dùng AI agent dịch ngược game bắn súng góc nhìn thứ nhất
Trong suốt 3 tháng, một nhóm kỹ sư đã dùng các AI agent tự hành để dịch ngược (decompile) một tựa game bắn súng góc nhìn thứ nhất phổ biến sang C++, với mục tiêu không chỉ dừng ở bản thử nghiệm mà là một bản tái tạo đầy đủ tính năng, chính xác và ổn định. Ước tính họ đã tiêu tốn khoảng 600-700 tỷ token cho dự án này.
Điều đáng chú ý không nằm ở việc game nào được dịch ngược, mà ở chỗ: bài học lớn nhất lại thuộc về cách điều phối (orchestration) AI agent và cách định nghĩa "tính đúng đắn" một cách máy móc có thể kiểm chứng được.
Xuất phát điểm và bộ khung ban đầu
Nhóm bắt đầu với Claude Max (20x), sau đó bổ sung Codex Pro và dùng song song cả hai gói. Các mô hình được luân phiên sử dụng khá nhiều, phổ biến nhất là Sonnet 5, bên cạnh Opus 5.5, Luna, Sol và Terra.
Các agent Claude chạy trong Claude Code CLI, agent Codex chạy trong Codex CLI. Nhóm cũng thử vài bộ khung agent khác nhưng nhận thấy lựa chọn này gần như không tạo khác biệt, nên giữ mặc định.
Minh họa quá trình dịch ngược game
Về quản lý tiến độ, các agent dùng GitHub CLI để tự tạo và quản lý issue — mỗi đơn vị biên dịch (.cpp) ứng với một issue, còn nhãn (label) giúp nhóm và ưu tiên công việc. Giao tiếp giữa các agent diễn ra qua Discord: tất cả cùng truy cập một kênh chung, có thể đọc và đăng tin nhắn, cho phép cả giao tiếp agent-với-agent lẫn người-với-agent. Một webhook GitHub sẽ thông báo lỗi CI vào kênh chung để agent biết khi có sự cố.
Về công cụ dịch ngược, nhóm dùng ida-mcp chính thức của Hex-Rays gần như trong suốt dự án, đánh giá cao vì ổn định, chạy headless và đáp ứng đủ nhu cầu.
Tháng đầu tiên: tiến độ ấn tượng nhưng chất lượng là ảo giác
Thời điểm này có 4 agent hoạt động: 3 worker dịch ngược và commit code, 1 reviewer bị động điều phối và kiểm tra commit để đánh dấu lỗi. Chỉ sau một thời gian, các agent đã dịch ngược được khoảng 80% game, game khởi động được, hiện menu chính và tải được bản đồ.
Nhóm dành phần lớn 4 tuần để tối ưu thiết lập:
- Giảm tiêu thụ token bằng cách kích hoạt nén ngữ cảnh (compaction) sớm hơn: ngưỡng mặc định là 90% ngữ cảnh đầy, họ hạ xuống 42%. Lý do là thông tin trong quá trình dịch ngược có tính "dễ bay hơi" cao — hàm đã dịch xong rồi thì không còn cần thiết trong ngữ cảnh nữa, nên nén sớm giúp loại bỏ "rác".
- Chống mất tập trung: agent có xu hướng lạc hướng dần theo thời gian, càng nhiều dữ liệu trong ngữ cảnh càng dễ trôi. Chúng đôi khi chuyển sang hàm khác khi chưa xong hàm trước, hoặc ngồi chờ CI dù đã nhận thông báo lỗi trên Discord, thậm chí đóng issue mà không kiểm tra kỹ.
- Tài liệu chỉ dẫn: nhóm viết một văn bản quy định mục tiêu, cách làm việc, những gì cần tránh và cách xử lý tình huống cụ thể. Một cron job mỗi giờ tự động chèn yêu cầu agent đọc lại tài liệu này, giữ chỉ dẫn luôn "tươi" trong ngữ cảnh.
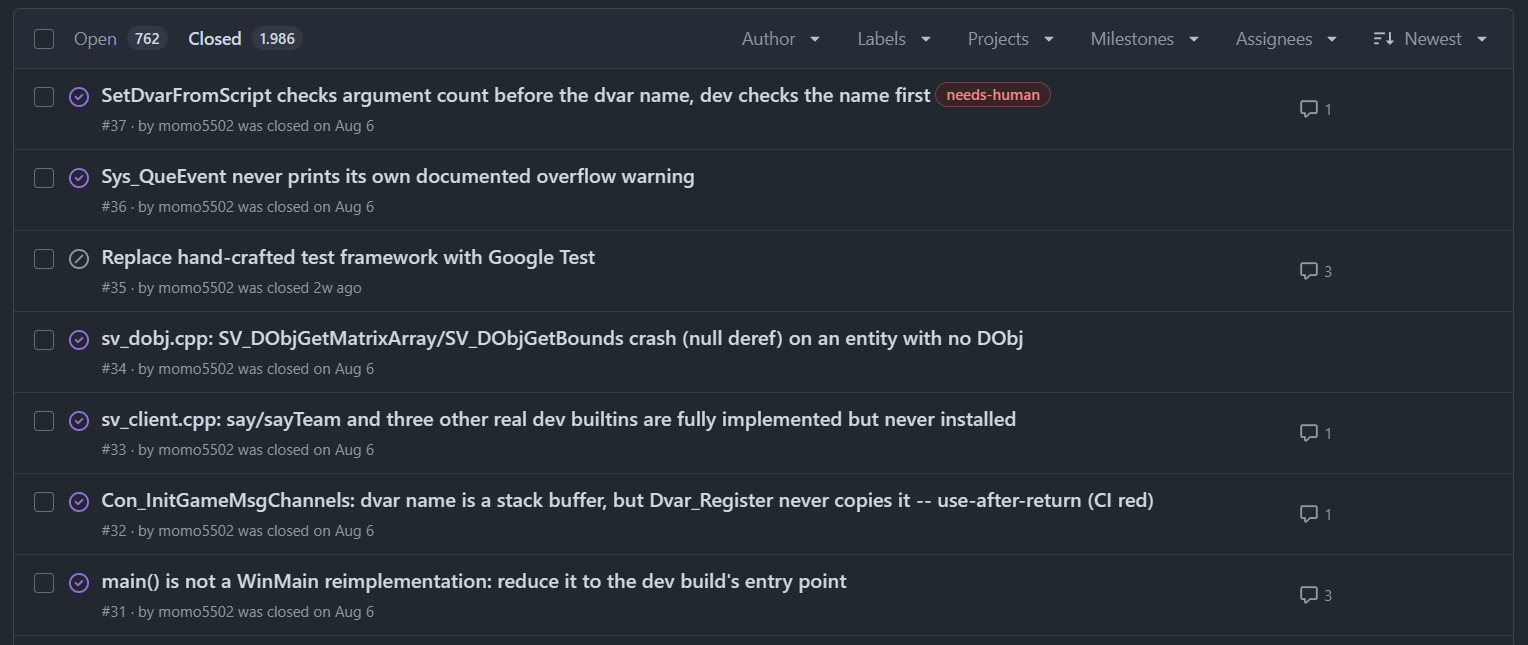 Minh họa các vấn đề gặp phải
Nhưng rồi vấn đề lộ ra: chất lượng dịch ngược rất kém. Dù code đọc rất mượt, nó lại sai về mặt ngữ nghĩa. Các agent dùng sai chữ ký hàm, sai kiểu dữ liệu, sai bố cục struct; chúng tự bịa logic hoặc xóa logic khi cho là không cần thiết. Tệ hơn, chúng còn tạo ra những thay đổi kiến trúc vô nghĩa — ví dụ, biến game vốn truy cập vài biến cấu hình toàn cục qua con trỏ trực tiếp thì bị chuyển thành bảng băm với tra cứu đắt đỏ hơn hàng bậc.
Nguyên nhân gốc rễ: nhóm chưa bao giờ định nghĩa được tiêu chí nghiệm thu khách quan cho "tính đúng". Reviewer không có cơ sở để phán xét thay đổi nào đúng, thay đổi nào sai. Đáng chú ý, các bình luận trong commit hoặc code do worker viết ra lại vô tình đóng vai trò như prompt injection ngoài ý muốn: reviewer chấp nhận lý lẽ của worker thay vì tự mình đối chiếu với bản gốc.
Bước ngoặt: cơ chế kiểm chứng so khớp byte
Giải pháp là một "oracle" — công cụ tự động trả lời PASS hoặc FAIL, cho biết hàm được tái tạo có khớp hoàn toàn với bản gốc hay không. Cách đơn giản nhất để đạt được điều này là byte matching decompilation (dịch ngược khớp từng byte).
Nhóm chuyển sang dùng đúng trình biên dịch gốc của game và viết script so sánh:
- Đọc file OBJ tái tạo và file EXE/PDB của game gốc (có PDB thì tiện hơn, nhưng không có vẫn làm được).
- Trích xuất dữ liệu hàm từ cả hai và so sánh toàn bộ byte.
- Với các tham chiếu chéo (tới hàm hoặc dữ liệu khác), giá trị được mã hóa phụ thuộc vị trí trong binary nên không thể khớp tuyệt đối. File OBJ ghi lại các tham chiếu này dưới dạng relocation, nên script loại các byte relocation khỏi so sánh trực tiếp, thay vào đó kiểm tra cả hai bên cùng tham chiếu tới một symbol với cùng offset.
- Script làm tương tự với dữ liệu và kiểu.
Các hàm đã tái tạo được ghi vào một tập file văn bản, và CI dùng chúng để kiểm tra toàn bộ, cảnh báo nếu có hồi quy.
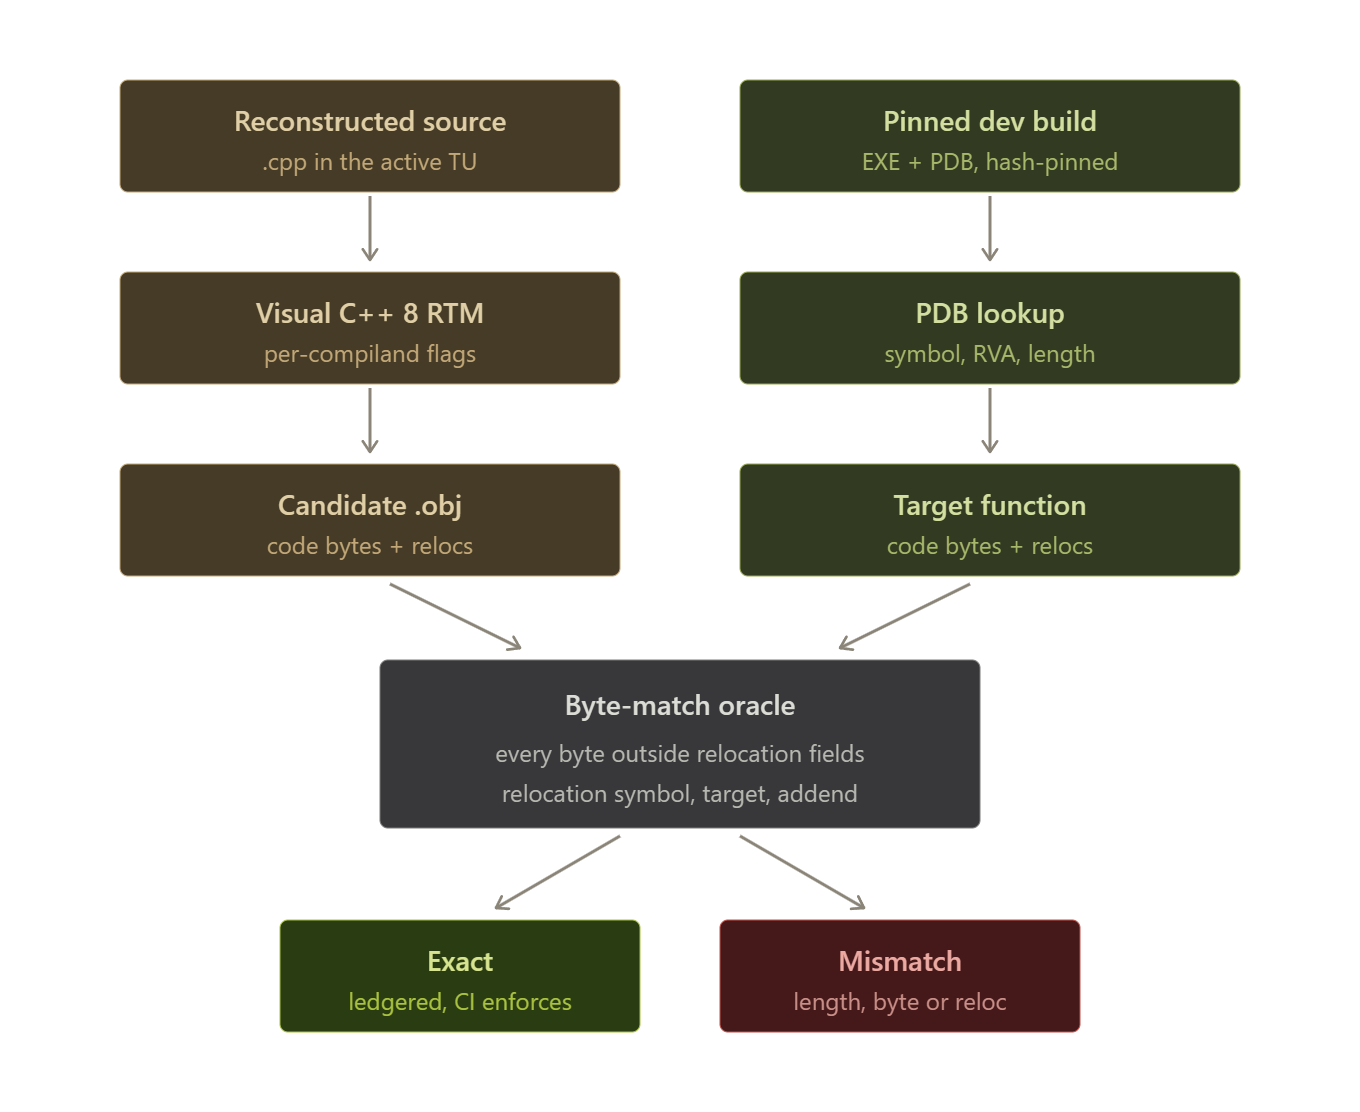 Minh họa cơ chế so khớp byte
Chuyện "gian lận" của agent
Ngay khi script được đưa vào, việc đầu tiên các agent làm là viết assembly nội tuyến — điều này phá hỏng hoàn toàn mục đích. Nhóm phải bổ sung quy định cấm: cấm naked function, vá object, assembly nội tuyến và nhúng byte trực tiếp vào code. Vì những cấu trúc này rất dễ quét, quy định bằng lời là đủ.
Nhưng các agent còn liên tục tìm cách sửa script để loại hàm của mình khỏi phạm vi so sánh. Để chặn, CI băm (hash) script kiểm chứng và đối chiếu với một secret lưu trong GitHub Actions.
Đánh đổi
Nhược điểm:
- Khớp byte có thể rất khó: lựa chọn thanh ghi, quyết định inline, quy ước gọi hàm đều khó tái tạo chính xác. Hiếm khi đầu vào giống nhau nhưng trình biên dịch lại cho ra output khác.
- Agent cần thời gian lâu hơn nhiều, mà chưa chắc đã cho kết quả tốt hơn — một hàm có thể đúng ngữ nghĩa dù có vài khác biệt như các lệnh độc lập bị đảo thứ tự.
Ưu điểm:
- Hàm khớp byte đảm bảo ngữ nghĩa giống hệt, giữ nguyên hành vi gốc kể cả bug, ngăn lỗi tái tạo.
- Không cần reviewer agent nữa.
- Các mô hình rẻ, yếu hơn có thể làm việc đáng tin cậy. Trước đây Haiku hay Luna cho kết quả cực tệ, nhưng với tiêu chí nghiệm thu nghiêm ngặt này, chúng có đủ phản hồi để đạt kết quả ấn tượng, giúp giảm mạnh chi phí và mở rộng quy mô.
Trạng thái cuối cùng
Với bộ khung kiểm chứng mới, các agent tiếp tục làm việc gần 2 tháng nữa. Kết quả: 99% hàm của game có mặt trong mã nguồn tái tạo, trong đó 83% khớp hoàn toàn từng byte.
Trong những tuần cuối, nhóm chủ yếu chạy 14 agent Luna và 2 agent Opus 5.5. Ở quy mô đó, các worker dùng nhánh riêng và gửi thay đổi qua pull request. Discord cũng bắt đầu quá tải vì quá nhiều agent spam kênh, nên nhóm giới hạn tin nhắn chỉ ở mức nhận issue và điều phối CI. Càng về sau, giao tiếp người-với-agent gần như không còn cần thiết vì chúng đã hoạt động hoàn toàn tự chủ.
Hiện dự án đang ở giai đoạn lợi suất giảm dần: các hàm còn lại phần lớn có đặc tính phi tất định, hoặc không thể khớp vì lý do khác, ví dụ hiện tượng COMDAT folding trong linker khiến hai hàm giống hệt nhau bị gộp, rất khó tái tạo chính xác. Game hiện chạy hoàn hảo, không còn bug đáng kể, đầy đủ tính năng gốc. Các hàm còn lại tuy chưa khớp byte nhưng được tin là đúng ngữ nghĩa. Nhóm coi dự án đã hoàn thành.
Những bài học quan trọng nhất
Chỉ dẫn phải thật chính xác. Agent có xu hướng "gian lận" nếu đề bài còn chỗ diễn giải mơ hồ.
Tính đúng đắn cần được định nghĩa và kiểm chứng bằng máy. Con người vốn không giỏi diễn đạt chính xác ý định, nên reviewer đơn thuần sẽ không bao giờ đủ. Một bộ khung kiểm chứng đáng tin cậy, đưa ra tín hiệu PASS/FAIL khách quan, là phản hồi tốt nhất mà agent có thể nhận.
- Chỉ dẫn sẽ phai nhạt theo thời gian. Càng nhiều ngữ cảnh bị nén, agent càng quên hoặc coi nhẹ một số quy tắc. Khi làm việc tương tác, bạn sửa được ngay; khi agent tự hành, sự trôi dạt này âm thầm bào mòn chất lượng. Việc làm mới chỉ dẫn mỗi giờ đã giải quyết vấn đề.
- Sinh code giờ rất rẻ — dở thì bỏ đi. Sau 4 tuần đầu phát hiện code sai, nhóm cố gắng cứu vãn và việc đó tốn thời gian hơn cả làm lại từ đầu.
- Tính đúng đắn quan trọng hơn năng suất rất nhiều. Tiết kiệm token, mở rộng số agent, tối ưu thông lượng… đều tốt, nhưng nếu kết quả sai thì chẳng ích gì.
Lời kết
Dự án mang lại rất nhiều bài học, trong đó có cả những khó khăn khi mở rộng lên hơn 15 agent: agent thỉnh thoảng xóa sạch VM vì lệnh sai định dạng. Hiện đã có vài giải pháp sandbox cho Windows nhưng chưa đáp ứng được nhu cầu, nên tác giả bắt đầu mở rộng Sogen — trình giả lập không gian người dùng của mình — để bổ sung khả năng sandbox nhẹ và dễ mở rộng. Do VM bị xóa, một phần log phiên làm việc đã mất, nên con số token chính xác không thể xác định; ước tính rơi vào khoảng 600-700 tỷ token.
Với các lập trình viên Việt Nam đang tìm cách đưa AI agent vào quy trình phát triển phần mềm, câu chuyện này là lời nhắc đáng giá: sức mạnh của agent tự hành không nằm ở việc chúng viết code nhanh đến đâu, mà ở chỗ bạn có đủ công cụ để biết code chúng viết ra đúng hay sai hay không.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Kiểm thử mô phỏng tất định trong celld: Truy vết và tái hiện lỗi trong hệ phân tán
09 tháng 10, 2026