6 mô hình kiến trúc nâng cao để xây nền tảng dữ liệu cho AI doanh nghiệp
Nhiều doanh nghiệp thất bại khi đưa AI từ phòng thí nghiệm ra môi trường thực tế vì dữ liệu không đủ sạch, không đủ mới và thiếu kiểm soát truy cập. Bài viết phân tích sáu mô hình kiến trúc nền tảng giúp biến hồ dữ liệu doanh nghiệp thành nền tảng AI có quản trị, từ đồng bộ CDC thời gian thực đến bộ lọc truy cập Zero-Trust.
Trong vài năm gần đây, khi các doanh nghiệp nhận ra tiềm năng đột phá của AI tạo sinh, áp lực phải triển khai các use case AI quy mô lớn trở nên cấp thiết. Các nhóm agile được thành lập, mô hình được cấp phát hạ tầng tính toán, trợ lý lập trình được dựng lên và những bản demo đa tác tử (multi-agent) ra đời.
Nhưng khi các hệ thống này rời khỏi môi trường thử nghiệm và được kiểm tra trên pre-production, một điểm nghẽn quen thuộc xuất hiện: mô hình suy luận tốt, nhưng dữ liệu doanh nghiệp bên dưới lại không đủ dễ truy cập, không đủ sạch và không đủ cấu trúc để AI hành động một cách đáng tin cậy.
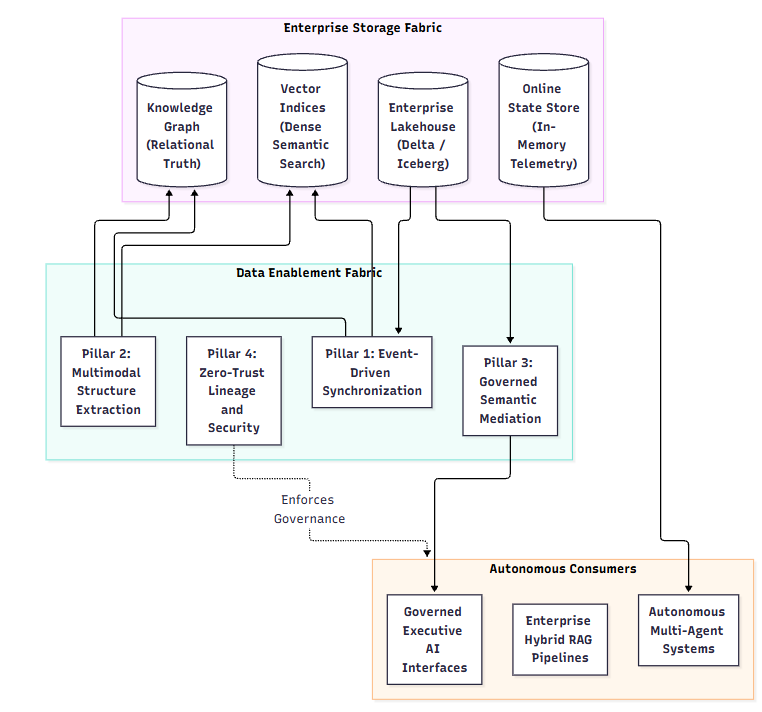 Kiến trúc nền tảng dữ liệu cho AI doanh nghiệp
Vì sao nền tảng dữ liệu truyền thống không còn phù hợp
Các nền tảng dữ liệu doanh nghiệp truyền thống được thiết kế cho một nhóm công nghệ hoàn toàn khác: phân tích tất định (bảng điều khiển BI) hoặc phân tích dự báo (use case ML). Kỹ thuật dữ liệu đã tiến hóa qua các pipeline ETL, lược đồ hình sao (star schema) và kiến trúc Lakehouse Medallion (Bronze → Silver → Gold).
Những nền tảng này được tinh chỉnh cho các phép tổng hợp nhìn về quá khứ, ví dụ "Tỷ lệ rời bỏ khách hàng khu vực EMEA trong quý 3 là bao nhiêu?", được truy vấn bằng SQL cứng nhắc và hiển thị trên BI.
Các tác tử tự trị (autonomous agent) và RAG (truy xuất tăng cường sinh) đã đảo ngược nhiều tiền đề cốt lõi của nền tảng dữ liệu truyền thống:
- Lệch pha đầu vào: Agent tiêu thụ các cửa sổ prompt động được lắp ghép từ tài liệu phi cấu trúc, dữ liệu vận hành và đồ thị tri thức thay vì các bảng dạng chữ nhật.
- Khoảng trễ: Lịch làm mới lakehouse mỗi đêm không thể phục vụ một agent cần dữ liệu giỏ hàng trực tiếp, trạng thái tranh chấp thanh toán và tín hiệu rủi ro được tính vài giây trước đó.
- Thiết kế lại kiểm soát truy cập: Bảo mật cơ sở dữ liệu truyền thống hoạt động ở cấp bảng. Nếu một tài liệu mật được nạp vào vector store dùng chung, tìm kiếm ngữ nghĩa sẽ trả về đoạn đó cho người dùng không có quyền nếu độ tương đồng cosine vượt ngưỡng.
- Ảo giác lược đồ: Trỏ thẳng LLM vào bảng quan hệ thô sẽ tạo ra các phép join ảo giác, tính toán sai định nghĩa nghiệp vụ và truy vấn không được đánh chỉ mục khiến use case "hỏi đáp dữ liệu" không khả thi.
Để vượt qua các bản demo, chúng ta phải ngừng coi AI chỉ là bài toán kỹ thuật prompt. Đây là bài toán dữ liệu. Nếu nền tảng dữ liệu không giữ được dữ liệu tươi mới, sạch sẽ và được khóa chặt bằng phân quyền đúng đắn, các agent sẽ thất bại trong môi trường production.
Bốn trụ cột của một nền tảng dữ liệu sẵn sàng cho AI
Trước khi xem xét các mô hình, cần định nghĩa bốn trụ cột chức năng biến lakehouse doanh nghiệp thành nền tảng dữ liệu sẵn sàng cho AI:
- Đồng bộ hướng sự kiện: Chuyển từ đánh chỉ mục lại theo lô sang vô hiệu hóa liên tục dựa trên CDC (Change Data Capture), ngăn embedding bị cũ và trôi ngữ nghĩa âm thầm.
- Trích xuất cấu trúc đa phương thức: Bảo toàn hình học bố cục, quan hệ bảng và breadcrumb phân cấp mục lục từ tài liệu phi cấu trúc thay vì cắt thành các chunk token tùy ý.
- Trung gian ngữ nghĩa có quản trị: Chèn lớp chỉ số được chứng nhận và ontology doanh nghiệp giữa mô hình suy luận và cơ sở dữ liệu thô, đảm bảo các định nghĩa nghiệp vụ không bị ảo giác.
- Dòng dõi và bảo mật Zero-Trust: Lan truyền danh sách kiểm soát truy cập (ACL) và phân loại dữ liệu từ hệ thống nguồn thẳng vào chỉ mục truy xuất, thực thi lọc trước truy vấn một cách tất định.
Mô hình 1: Pipeline hai tốc độ hướng sự kiện (đồng bộ thời gian thực bằng CDC)
Trong kiến trúc doanh nghiệp tiêu chuẩn, nhóm nền tảng dữ liệu quản lý lakehouse, còn nhóm AI quản lý chỉ mục vector và đồ thị tri thức bên ngoài. Thông thường, một job batch ban đêm quét bảng, sinh embedding qua API LLM rồi upsert hàng loạt vào vector store.
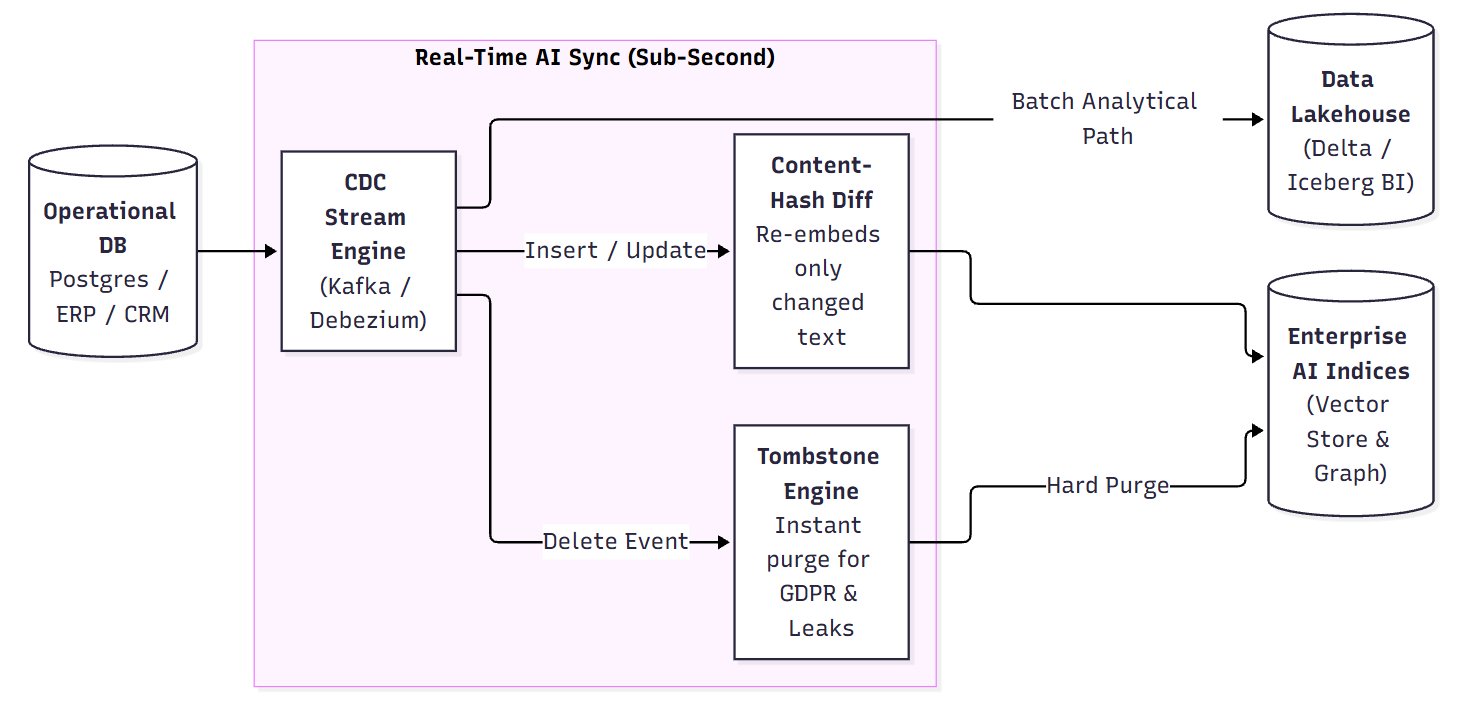
Pipeline hai tốc độ hướng sự kiện thay thế việc quét theo lô bằng CDC thời gian thực trên write-ahead log (WAL). Khi một bản ghi vận hành thay đổi, sự kiện được truyền đồng thời vào lakehouse và bộ định tuyến sự kiện ngữ nghĩa.
Bộ định tuyến kiểm tra payload đầu vào với bộ đệm băm nội dung phân tán (SHA-256 trên văn bản đã chuẩn hóa). Nếu hash trùng nhau, nghĩa là cập nhật chỉ thay đổi bộ đếm hay dấu thời gian nội bộ, sự kiện tái embedding bị hủy. Nếu văn bản đã thay đổi, chỉ chunk cụ thể đó được tái embedding và upsert nguyên tử.
Đáng chú ý hơn, khi một bản ghi hay tài liệu bị xóa tại nguồn — chẳng hạn phòng nhân sự xóa một bản ghi nhớ trợ cấp mật, hay một khách hàng doanh nghiệp đóng tài khoản — pipeline phát ra sự kiện tombstone tức thời. Thay vì để lại các "embedding xác sống" mà agent vẫn có thể truy xuất và rò rỉ vài tuần sau đó, công cụ tombstone ánh xạ khóa chính bị xóa tới tất cả ID chunk con, xóa cứng chúng khỏi vector database và cắt đứt các cạnh quan hệ trong đồ thị tri thức trong vài giây.
Giá trị nghiệp vụ:
- Tối ưu chi phí tái embedding: thay vì chạy tái embedding toàn bộ hàng triệu tài liệu có thể tốn hàng chục nghìn đô la/tháng tiền API LLM, việc so sánh nội dung đảm bảo chỉ dữ liệu đã biến đổi mới được embed, giảm chi phí 85% – 95%.
- Ngăn rò rỉ dữ liệu khi xóa tài liệu mật: lịch làm mới theo lô để các chunk trong chỉ mục vector hàng ngày trời, còn cơ chế tombstone khiến tài liệu bị xóa gần như lập tức không thể tìm thấy.
- Tuân thủ "quyền được lãng quên" (GDPR và CCPA): khi người dùng yêu cầu xóa hoàn toàn dữ liệu cá nhân, việc xóa phải lan truyền khắp hệ thống. Tombstone tự động tạo bảo đảm có thể kiểm toán về tuân thủ pháp lý trên mọi lớp lưu trữ AI.
Ưu và nhược điểm: Ưu điểm là độ tươi mới gần thời gian thực (vài giây so với 24 giờ), loại bỏ chi phí embedding trùng lặp và đảm bảo nhất quán xóa tự động. Nhược điểm là cần hạ tầng streaming (Kafka, Debezium, Redis) và phải xử lý thông điệp đến sai thứ tự. Nên dùng cho các miền vận hành và pháp lý nơi bản ghi thay đổi thường xuyên: hồ sơ khách hàng CRM, giá sản phẩm, tồn kho, tài liệu chính sách và hệ thống ticket.
 Bảo mật và dòng dõi dữ liệu trong nền tảng AI
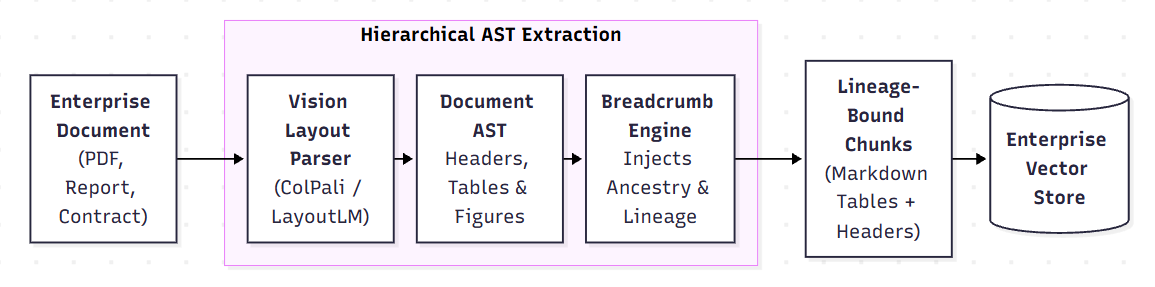
Mô hình 2: Bộ phân tích ngữ nghĩa phân cấp (AST cho tài liệu phi cấu trúc)
Phần lớn thất bại của RAG doanh nghiệp đến từ việc làm phẳng các PDF nhiều trang phức tạp thành chuỗi ASCII thô rồi chạy bộ tách token trượt 512 ký tự. Trong tài liệu doanh nghiệp thực tế, điều này phá hủy ngữ cảnh:
- Phân mảnh bảng: Báo cáo tài chính dựa vào tọa độ cột-hàng chính xác. Bộ tách token phẳng cắt đôi hàng, biến bảng cân đối kế toán thành những con số vô nghĩa.
- Đứt gãy phân cấp: Một điều khoản "mức phạt không vượt quá 10.000 USD" trong Mục 4.2 lấy toàn bộ ý nghĩa pháp lý từ tiêu đề cha "Mục 4: Vi phạm thỏa thuận bảo mật". Cắt chunk mù quáng làm mất tiêu đề cha, tạo ra mảnh vỡ thiếu nền tảng mà tìm kiếm ngữ nghĩa không thể khớp.
Bộ phân tích ngữ nghĩa phân cấp coi tài liệu như cây cú pháp trừu tượng (AST) thay vì văn bản phẳng. Một mô hình bố cục thị giác-ngôn ngữ nhận diện tiêu đề, đoạn văn, bố cục nhiều cột, bảng và hình. Mỗi phần tử con thừa hưởng trọn vẹn đường dẫn breadcrumb tổ tiên (ví dụ: Bao_cao_Thuong_nien.pdf > Công bố Tài chính > Bắc Mỹ > Bảng 4.2). Bảng được tuần tự hóa sạch sang ma trận Markdown hoặc JSON, còn biểu đồ được mô hình thị giác đa phương thức tóm tắt.
Giá trị nghiệp vụ:
- Độ chính xác cấp kiểm toán trên tài liệu quan trọng: với khai phá tài liệu tài chính, pháp lý và tuân thủ, độ chính xác 80% là không đủ. Bảo toàn cấu trúc bảng đảm bảo các con số được truy xuất với toàn vẹn quan hệ 100%.
- Khả năng giải thích và nguồn gốc: mỗi chunk mang theo tổ tiên phân cấp chính xác (trang, chương, mục), giúp người kiểm duyệt xác minh nguồn gốc doanh nghiệp phía sau một khẳng định của AI dễ dàng.
- Khai thác "dữ liệu tối": kéo dữ liệu sạch ra khỏi biểu đồ, bố cục phức tạp và PDF scan thay vì biến chúng thành văn bản méo mó.
Ưu và nhược điểm: Ưu điểm là bảo toàn 100% quan hệ bảng và logic kế toán, độ chính xác truy xuất cao nhờ breadcrumb, hiểu biểu đồ đa phương thức. Nhược điểm là độ trễ nạp cao hơn (vài giây mỗi trang) và cần hạ tầng nạp tăng tốc bằng GPU. Nên dùng cho báo cáo tài chính (10-K, 10-Q), báo cáo thử nghiệm lâm sàng, hợp đồng pháp lý, đặc tả kỹ thuật và tài liệu kiến trúc.
Mô hình 3: Lớp ngữ nghĩa có quản trị (kho chỉ số làm rào chắn cho AI)
Nhiều tổ chức cố gắng xây khả năng "trò chuyện với dữ liệu" bằng cách đưa cho LLM định nghĩa bảng (CREATE TABLE...) và yêu cầu sinh câu truy vấn SQL thô. Trong kho dữ liệu doanh nghiệp, cách này thường không đủ. Bảng thực tế chứa tên cột khó hiểu, cờ lịch sử và logic nghiệp vụ phức tạp.
Nếu một nhà phân tích tài chính hỏi "Doanh thu định kỳ hàng năm ròng quý trước là bao nhiêu?", một LLM soi vào bảng thô không có cách nào biết chính sách doanh nghiệp định nghĩa "doanh thu định kỳ ròng" là: trạng thái = Active AND dùng thử = False AND đã hoàn tiền = False AND tiền tệ = USD. Mô hình sinh truy vấn không được quản trị, cho ra con số sai, ảnh hưởng tiêu cực tới niềm tin của lãnh đạo. Tệ hơn, một LLM không bị ràng buộc có thể phát ra các phép cross join đa bảng không đánh chỉ mục, làm nghẽn kho dữ liệu ở 100% công suất và tốn chi phí tính toán lớn trong vài phút.
Mô hình lớp ngữ nghĩa có quản trị chèn một công cụ chỉ số (như dbt Semantic Layer, Cube hay ontology doanh nghiệp) giữa mô hình AI và kho dữ liệu. LLM bị cấm viết SQL thô. Thay vào đó, nó soi một manifest các chỉ số và chiều (dimension) được phép, sinh ra ý định JSON có kiểu dữ liệu. Khối lượng công việc được chia giữa thứ LLM làm tốt nhất (hiểu ngôn ngữ tự nhiên) và thứ bộ biên dịch tất định làm tốt nhất (độ chính xác toán học và duyệt đồ thị join).
Khi lãnh đạo hỏi về ARR khu vực EMEA, LLM chỉ dịch ngôn ngữ tự nhiên thành ý định JSON có cấu trúc, được kiểm chứng. Lớp ngữ nghĩa không phải mô hình AI mà là bộ biên dịch tất định giữ đồ thị bảng đã mô hình hóa trước, khóa join đã xác minh và công thức đã kiểm toán. Nó tra cứu net_arr trong manifest được chứng nhận, xác định đường join xác minh giữa fact_subscriptions và dim_customers, rồi biên dịch SQL được gia cố, tối ưu, chèn bộ lọc nghiệp vụ bắt buộc và giới hạn ngân sách thực thi truy vấn.
Điều gì xảy ra với truy vấn adhoc? Nếu người dùng hỏi một câu đơn giản như "Quý trước chúng ta kiếm được bao nhiêu tiền?" mà không có ánh xạ rõ ràng, LLM ánh xạ ngôn ngữ đời thường ("tiền") sang chỉ số catalog được chứng nhận (ví dụ tổng đặt chỗ gộp so với doanh thu ghi nhận GAAP). Nếu có mơ hồ, agent tạm dừng và hỏi lại người dùng. Còn nếu người dùng hỏi về chỉ số chưa từng được mô hình hóa, một rào chắn tất định sẽ chặn và chuyển hướng: yêu cầu gửi đề nghị tới nhóm phân tích dữ liệu để mô hình hóa và chứng nhận. Việc từ chối này là một tính năng chấp nhận được, không phải lỗi — với truy vấn tài chính và tuân thủ giá trị cao, một lời từ chối trung thực còn quý hơn một truy vấn ảo giác đầy tự tin.
Giá trị nghiệp vụ:
- Thực thi một nguồn sự thật duy nhất: dù lãnh đạo xem bảng điều khiển Tableau hay hỏi trợ lý AI, con số tài chính vẫn giống hệt và được chứng nhận đầy đủ.
- Loại bỏ đột biến chi phí kho dữ liệu: bảo vệ nền tảng đám mây khỏi các truy vấn cross-join không đánh chỉ mục sinh ra bởi mô hình xác suất.
- Tách rời AI khỏi thay đổi lược đồ: khi kỹ sư dữ liệu tái cấu trúc bảng hay đổi tên cột, họ chỉ cập nhật manifest, giao diện của agent giữ nguyên.
Ưu và nhược điểm: Ưu điểm là 0% rủi ro join ảo giác hay tính toán chỉ số bịa đặt, bộ đệm dưới 50ms cho chỉ số tổng hợp sẵn, cách ly hoàn toàn với thay đổi lược đồ. Nhược điểm là cần có lớp chỉ số ngữ nghĩa được bảo trì tốt từ trước và không thể trả lời câu hỏi về cột chưa mô hình hóa ngoài catalog được chứng nhận. Không thể thương lượng với các use case text-to-data doanh nghiệp, BI tự động, báo cáo lãnh đạo hay agent phân tích hướng khách hàng.
 Lớp ngữ nghĩa có quản trị trong kiến trúc AI
Mô hình 4: Kho ngữ cảnh vận hành (tiêm đặc trưng thời gian thực)
Agent tự trị không chỉ trả lời câu hỏi lịch sử mà còn phải thực hiện hành động vận hành thời gian thực. Ví dụ, một agent phân loại gian lận hay giữ chân khách hàng cần trạng thái vận hành đến từng giây: khách hàng này đã thử bao nhiêu giao dịch trong 15 phút qua, người dùng có gặp quá hai lỗi ứng dụng trong phiên hiện tại không, số lượng tồn kho thời gian thực của SKU tại trung tâm phân phối khu vực là bao nhiêu.
Các nhóm dữ liệu thường giải quyết bằng cách lưu dữ liệu vận hành trong vector database hoặc truy vấn kho dữ liệu đám mây trong vòng lặp suy luận của agent. Cả hai đều không hiệu quả. Vector database tối ưu cho tìm kiếm ngữ nghĩa trên văn bản tương đối tĩnh; khi cập nhật, nó phải xây lại chỉ mục đồ thị HNSW, và hàng nghìn cập nhật số học tần suất cao sẽ làm cạn kiệt CPU và suy giảm độ trễ tìm kiếm cho mọi người. Còn truy vấn kho phân tích như Snowflake hay BigQuery trong vòng lặp agent tương tác gây trễ khứ hồi 2–5 giây, khiến trong vòng lặp 5 bước, độ trễ cơ sở dữ liệu có thể đẩy thời gian phản hồi vượt 25 giây.
Mô hình kho ngữ cảnh vận hành tích hợp một Online Feature Store trong bộ nhớ (như Redis) trực tiếp vào pipeline lắp ghép prompt của agent. Một công cụ xử lý luồng liên tục tính các tổng hợp cửa sổ trượt và ghi vào bộ nhớ. Khi agent được kích hoạt, bộ lắp ghép ngữ cảnh lấy trạng thái vận hành đang hoạt động của thực thể đích trong dưới 5 mili giây, rồi tiêm nó như một khối ngữ cảnh có cấu trúc sạch vào prompt trước khi suy luận bắt đầu.
Giá trị nghiệp vụ:
- Tự trị vận hành thời gian thực: cho phép agent hành động dựa trên những gì đang xảy ra ngay bây giờ, thay vì những gì xảy ra khi lô kho dữ liệu hoàn tất đêm qua.
- Thời gian phản hồi khách hàng dưới một giây: tối ưu chi phí truy xuất trạng thái từ vài giây xuống mili giây, cho phép giao diện thoại và chat thời gian thực.
- Bảo vệ hạ tầng phân tích: chuyển các tra cứu điểm tần suất cao ra khỏi lakehouse, tránh tính toán kho dữ liệu tốn kém cho truy vấn trạng thái vận hành.
Ưu và nhược điểm: Ưu điểm là độ trễ truy xuất trạng thái dưới 5ms trực tiếp vào cửa sổ prompt, ngăn phân mảnh chỉ mục vector, chính sách TTL nghiêm ngặt chống ngữ cảnh cũ. Nhược điểm là cần duy trì pipeline streaming chuyên dụng (Kafka/Flink) và hạ tầng bộ nhớ có chi phí trên mỗi gigabyte cao hơn lưu trữ đối tượng. Bắt buộc với agent chăm sóc khách hàng thời gian thực, phát hiện gian lận tự động, bot định giá thuật toán, định tuyến chuỗi cung ứng và phân loại an ninh mạng.
Mô hình 5: Nền bảo mật bảo toàn dòng dõi (truy xuất Zero-Trust)
Trong CNTT doanh nghiệp truyền thống, bảo mật được quản lý bởi các khung tất định trưởng thành: RBAC (kiểm soát truy cập dựa trên vai trò), ABAC (dựa trên thuộc tính) và Row-Level Security (RLS) nhúng trong SQL database, SharePoint và Salesforce.
Khi nhóm dữ liệu xây vector database và đồ thị tri thức, họ buộc phải thiết kế lại kiến trúc kiểm soát truy cập này. Ví dụ, nếu phòng nhân sự lưu một kế hoạch trợ cấp mật trong thư mục hạn chế, nhưng pipeline nạp lại lược bỏ ACL khi vector hóa, một nhân viên không có quyền hỏi câu hỏi chung về trợ cấp sẽ truy xuất tài liệu mật vì độ tương đồng ngữ nghĩa cao.
Cố gắng giải quyết bằng lọc sau truy xuất — lấy top-50 chunk rồi kiểm tra quyền người dùng — không đáng tin cậy trong production vì hai vấn đề: chuỗi kết quả rỗng (nếu các chunk phù hợp nhất bị hạn chế, mô hình chỉ còn phần dư kém liên quan, khiến agent ảo giác rằng không có chính sách nào tồn tại) và rò rỉ thông tin qua kênh phụ (kẻ xấu có thể suy luận các dự án mật dựa trên biến thiên độ trễ phản hồi).
Nền bảo mật bảo toàn dòng dõi thực thi kiến trúc dữ liệu Zero-Trust. Ranh giới bảo mật, ACL và phân loại dữ liệu được trích xuất trực tiếp từ hệ thống nguồn và gắn như metadata bất biến vào mọi vector và nút đồ thị. Khi agent tìm kiếm thay mặt người dùng, hệ thống chặn token đã ký (JWT) của người dùng để xác định nhóm và mức quyền đã xác minh. Công cụ tìm kiếm thực thi lọc quyền trước truy vấn, tức là không gian tìm kiếm được lọc về mặt toán học ở cấp chỉ mục đồ thị trước khi tính khoảng cách vector. Kết quả là các chunk không có quyền bị loại trừ vật lý khỏi nhóm ứng viên, triệt tiêu rò rỉ dữ liệu.
Giá trị nghiệp vụ:
- Giám đốc an ninh thông tin (CISO) và cơ quan quản lý phê duyệt: cung cấp bảo đảm tất định, có thể xác minh chống rò rỉ dữ liệu nội bộ.
- Bảo toàn cách ly SaaS đa thuê bao: đảm bảo trong môi trường multi-tenant, dữ liệu độc quyền của một khách hàng không bao giờ lộ cho khách khác, kể cả dưới tấn công prompt injection đối kháng.
- Tuân thủ các yêu cầu quản trị dữ liệu nghiêm ngặt: đáp ứng HIPAA, SOC 2 Type II và ISO 27001 bằng cách bảo đảm phân quyền dữ liệu hiện có được thừa hưởng nghiêm ngặt trên mọi giao diện AI.
Ưu và nhược điểm: Ưu điểm là bảo đảm toán học 100% chống truy xuất tài liệu trái phép, loại bỏ chuỗi kết quả rỗng, thừa hưởng hệ thống định danh doanh nghiệp hiện có (Okta, Azure AD). Nhược điểm là tăng chi phí lưu trữ chỉ mục do cấu trúc metadata kết hợp và cần công cụ có đánh chỉ mục HNSW/IVF lọc gốc để giữ tốc độ tìm kiếm. Bắt buộc với mọi trợ lý doanh nghiệp trả lời dựa trên thông tin nội bộ, hồ sơ nhân sự, kiểm toán tài chính, hồ sơ bệnh nhân hay kho lưu trữ dùng chung đa thuê bao.
Mô hình 6: Bánh đà tuyển chọn dữ liệu tự trị (lọc chất lượng và nền tảng tổng hợp)
Giống như bất kỳ công cụ phân tích nào, hệ thống AI sẽ không tự nhiên trích xuất trí tuệ từ hàng thập kỷ dữ liệu hồ chứa chưa được tuyển chọn. Hồ dữ liệu doanh nghiệp đầy nhiễu: thư trả lời tự động ngoài văn phòng, bản nháp ghi nhớ lỗi thời chứa số liệu đã bị thay thế, bản quét OCR bị hỏng và ticket Jira trùng lặp. Đưa dữ liệu thô này vào vector store hay đồ thị tri thức dẫn đến "garbage in, garbage out" — các chunk chất lượng thấp lấn át tài liệu có thẩm quyền khi truy xuất ngữ nghĩa.
Tuy nhiên, việc dùng mô hình tự hồi quy tiên tiến để đánh giá và làm sạch từng tài liệu trong kho hàng triệu trang là không khả thi về tài chính. Bánh đà tuyển chọn dữ liệu tự trị triển khai cách tiếp cận phân tầng:
- Tầng 1 — Lọc chất lượng hiệu chỉnh tốc độ cao: văn bản thô đi qua một mô hình phân loại cực nhanh (SLM chuyên biệt nhỏ hoặc mô hình quyết định không tự hồi quy). Trong vài mili giây, mô hình đánh giá entropy thông tin, cấu trúc ngữ pháp và mật độ sự kiện. Nhiễu giá trị thấp bị loại ngay tại cổng đầu tiên.
- Khử trùng lặp ngữ nghĩa: các chunk qua cổng chất lượng được đánh giá với thực thể đã có trong kho. Nếu tài liệu mới trùng lặp 95% với trang có thẩm quyền hiện có, pipeline cập nhật metadata dòng dõi nguồn thay vì tạo điểm vector trùng.
- Tăng cường tổng hợp bất đối xứng: các chunk có thẩm quyền chuyển tới worker bất đồng bộ chạy mô hình nhỏ được tinh chỉnh (ví dụ SLM 8B tham số), sinh 3–5 câu hỏi thực tế mà chunk này trả lời từ góc nhìn người dùng.
- Đánh chỉ mục bất đối xứng: các câu hỏi tổng hợp được embed song song với chunk tài liệu. Khi nhân viên đặt câu hỏi, vector database khớp truy vấn với câu hỏi tổng hợp thay vì văn bản thô, thu hẹp đáng kể khoảng cách từ vựng và tăng recall tìm kiếm.
Giá trị nghiệp vụ:
- Ngăn phình to vector database: loại bỏ tới 40% nhiễu doanh nghiệp chưa tuyển chọn trước khi vào chỉ mục vector, tối ưu chi phí lưu trữ đám mây và hạ tầng tìm kiếm.
- Tăng độ chính xác