
API Decisions của OpenAI: Khi độ tự tin 99% chỉ đúng 68%
OpenAI ra mắt Decisions API tại DevDay với lời hứa về một mô hình đưa ra quyết định kèm độ tự tin đáng tin cậy. Nhưng thử nghiệm trên 3.600 bài toán logic cho thấy GPT-6 Luna — mô hình đứng sau API này — chỉ đúng 68% số lần khi tự nhận chắc chắn từ 99% trở lên, và độ tự tin gần như mất hết ý nghĩa khi bài toán cần suy luận nhiều bước.
API Decisions của OpenAI: Khi độ tự tin 99% chỉ đúng 68%
OpenAI vừa giới thiệu Decisions API tại sự kiện DevDay, hứa hẹn mang đến một mô hình có thể đưa ra quyết định kèm theo điểm độ tự tin mà lập trình viên có thể đặt ngưỡng để tự động hóa. Nhưng một thử nghiệm độc lập trên 3.600 bài toán logic lại vẽ nên bức tranh đáng lo: khi mô hình GPT-6 Luna nói rằng nó chắc chắn 99%, thực tế nó chỉ đúng 68% số lần.
Đây là vấn đề không nhỏ với bất kỳ ai đang xây dựng hệ thống tự động dựa trên API này — từ phân loại tin nhắn, định tuyến yêu cầu, cho đến quyết định bước tiếp theo của một tác tử AI.
Decisions API là gì và vì sao độ tự tin lại quan trọng?
Decisions API cho phép phần mềm chọn một đáp án từ danh sách do người dùng định nghĩa, rồi rẽ nhánh xử lý dựa trên kết quả đó. Theo các báo cáo, API này chạy trên "một phiên bản của GPT-6 Luna" — mô hình giá rẻ của OpenAI — với tốc độ khoảng 150 mili-giây mỗi quyết định.
Ý tưởng cốt lõi rất hấp dẫn: bạn gửi một câu hỏi cho mô hình, và chỉ cho phép hệ thống tự hành động khi nó tự tin ít nhất 99%. Mọi trường hợp còn lại sẽ chuyển cho con người xử lý. Nhưng quy tắc đó chỉ đáng tin bằng chính con số 99% kia.
 Độ chính xác của API Decisions theo số bước suy luận
Thử nghiệm: Đúng trên trang giấy, đoán mò sau năm bước
Thử nghiệm sử dụng ProofWriter — bộ dữ liệu của Viện Allen — gồm các bài toán logic ngắn bằng tiếng Anh, mỗi bài có vài dữ kiện và quy tắc if-then, kèm một phát biểu cần đánh giá đúng, sai hay không xác định. Điểm mấu chốt: mỗi bài được gán nhãn độ sâu chứng minh — số bước suy luận cần thiết để đi đến đáp án.
Kết quả cho thấy khoảng cách rõ rệt giữa các mức độ khó:
- Ở bài toán chỉ cần đọc trực tiếp, Luna gần bằng đối thủ Jev: 93% so với 98% ở chế độ thế giới mở, và 98% so với 99% ở chế độ thế giới đóng.
- Khi cần chuỗi năm suy luận, Luna tụt xuống 46% và 45% — gần như tung đồng xu. Jev giữ được 81% và 89%.
- Tính trên toàn bộ các độ sâu, Jev đạt 83,8% và 89,3%; Luna chỉ đạt 64,1% và 65,0%.
Đáng chú ý, khoảng cách ở độ sâu 5 lên tới 35 đến 45 điểm phần trăm. Đây không phải chênh lệch nhỏ.
Sai ngay cả khi đáp án nằm trên trang giấy
Điều khiến kết quả này nghiêm trọng hơn là Luna mắc lỗi ngay ở những bài dễ nhất. Ở độ sâu 0 — khi phát biểu hoặc phủ định của nó được viết thẳng trong văn bản — Luna vẫn sai 20 trên 300 bài ở chế độ mở và 6 trên 300 bài ở chế độ đóng.
Ví dụ rõ nhất: văn bản ghi "Charlie is nice" (Charlie tốt bụng). Câu hỏi: "Charlie is not nice" đúng hay sai? Đáp án là sai, vì văn bản đã nói rõ. Luna trả lời đúng — với độ tự tin 100%.
Một mô hình có thể chắc chắn 100% về điều ngược lại với những gì văn bản nói thì không thể chỉ giải quyết bằng cách đặt ngưỡng độ tự tin.
Khi Luna nói 99%, thực tế là bao nhiêu?
 Độ tin cậy của API Decisions qua các mức tự tin
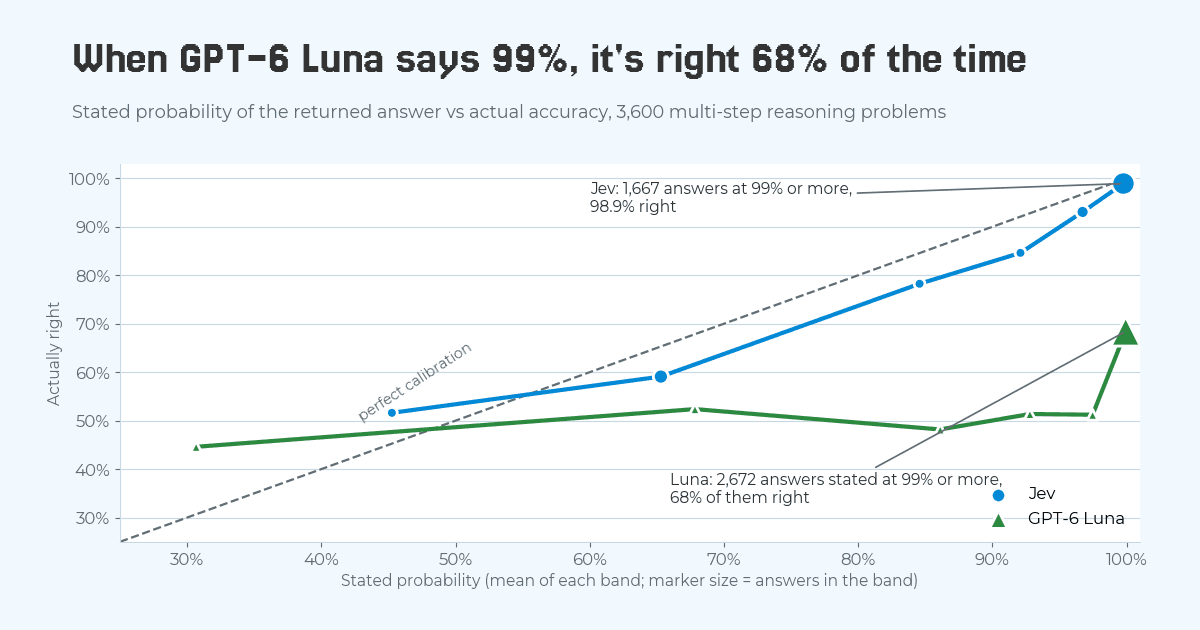
Trên cả 3.600 bài toán, Luna tuyên bố tự tin từ 99% trở lên ở 2.672 câu trả lời, và chỉ 68% trong số đó là đúng. Dưới ngưỡng đó, độ chính xác gần như phẳng lặp — dù nói 70%, 90% hay 97%, mô hình vẫn đúng khoảng một nửa.
So sánh với Jev, đối thủ trực tiếp:
- Jev tuyên bố tự tin 99% trở lên ở 1.667 câu trả lời và đúng 98,9% trong số đó.
- Sai số hiệu chuẩn kỳ vọng (khoảng cách trung bình giữa độ tự tin tuyên bố và thực tế): 0,32 với Luna, chỉ 0,04 và 0,03 với Jev.
- Chỉ số AUROC (khả năng phân biệt đúng/sai, 0,5 nghĩa là vô dụng): 0,66 và 0,68 với Luna, so với 0,85 và 0,86 của Jev.
Nói cách khác, phần lớn câu trả lời sai của Luna được nó khẳng định với độ tự tin từ 95% trở lên.
Vấn đề sâu xa: Độ tự tin mất hết thông tin
Quá tự tin thì có thể sửa được — nếu 99% luôn có nghĩa là 68%, ta có thể hiệu chỉnh lại con số. Nhưng có một thứ hiệu chỉnh không thể cứu: một xác suất không thay đổi theo việc đúng hay sai.
 Khả năng phân biệt đúng sai của API Decisions theo độ sâu
Với các bài toán đọc trực tiếp, xác suất của Luna có ích: câu trả lời đúng nhận được con số cao hơn câu trả lời sai. Nhưng mỗi bước suy luận bào mòn dần giá trị đó. Đến bước thứ năm, AUROC chỉ còn 0,51 — nghĩa là một độ tự tin cao không hề có khả năng đúng cao hơn độ tự tin thấp. Trên bài toán khó, ngưỡng tự tin của Luna gần như định tuyến ngẫu nhiên. Jev vẫn phân loại đúng/sai ở mức 0,84.
Vậy API Decisions có đáng tin không?
Cần lưu ý rằng thử nghiệm này chạy trên Luna qua API thông thường, không phải bản chuyên biệt bên trong Decisions API — và OpenAI chưa công bố tài liệu để kiểm chứng trực tiếp. Bản chuyên biệt hóa có thể làm tốt hơn.
Tuy nhiên, một số bài báo nói rằng Decisions API trả về điểm độ tự tin. Nếu đúng vậy, đây là những gì cần kiểm tra trước khi đặt ngưỡng tự động hóa:
- Kiểm tra ở đúng độ khó bạn sẽ dùng. Bài toán dễ đánh lừa tất cả mọi người — Luna và Jev chỉ cách nhau vài điểm ở độ sâu 0.
- Đối chiếu hiệu chuẩn với dữ liệu gán nhãn trước khi đặt ngưỡng. Một con số 99% thật ra là 68% sẽ đẩy các quyết định sai lọt qua bộ phận kiểm duyệt.
- Kiểm tra rằng độ tự tin phân biệt được đúng sai trên các ca khó nhất. Nếu không, mọi hiệu chỉnh đều vô nghĩa.
- Hỏi hai lần. Khi được hỏi lại, Luna đưa ra đáp án khác ở 10% trường hợp; Jev chỉ đổi ở 2-3%, còn Kev-0.8B, Kev-4B và Laya gần như không đổi.
Bài học cốt lõi: một điểm độ tự tin chỉ đáng giá khi nó thực sự thay đổi theo khả năng đúng. Với mô hình nền của Decisions API hiện tại, điều đó chưa xảy ra trên các bài toán suy luận nhiều bước.
Hàm ý cho người dùng tại Việt Nam
Với các đội ngũ ở Việt Nam đang xây dựng sản phẩm dựa trên API của OpenAI — từ chatbot chăm sóc khách hàng, định tuyến đơn hàng, đến tự động hóa quy trình nội bộ — kết quả này là lời nhắc nhở quan trọng. Việc chọn mô hình không nên dựa vào bảng xếp hạng chung hay giá rẻ, mà cần dựa trên thử nghiệm với chính dữ liệu của bạn.
Cách làm đúng đắn rất đơn giản nhưng tốn công: lấy các ca có gán nhãn từ công việc thực tế, bao gồm cả những ca khó, cho mọi mô hình chạy cùng một cách, đo độ chính xác theo mức độ khó, và kiểm tra xem độ tự tin của từng mô hình có thực sự tách được câu trả lời đúng khỏi câu trả lời sai hay không. ProofWriter cho thấy các mô hình xử lý logic chuỗi như thế nào; dữ liệu của chính bạn mới cho thấy chúng sẽ xử lý quyết định của bạn ra sao.
Khi Decisions API mở rộng, câu hỏi đáng đặt ra là liệu bản Luna chuyên biệt có khắc phục được khoảng cách 35-45 điểm phần trăm và vấn đề hiệu chuẩn nghiêm trọng này hay không. Cho đến lúc đó, đặt ngưỡng tự động hóa dựa trên độ tự tin của mô hình vẫn là một canh bạc.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
ChatGPT ra mắt tính năng Sites: tạo và chia sẻ trang web ngay trong hội thoại
01 tháng 10, 2026