Bảng tra cứu C++ đạt một tỷ truy vấn mỗi giây nhờ băm hoàn hảo
Giáo sư Daniel Lemire giới thiệu thư viện C++23 dùng hàm băm hoàn hảo tính tại thời điểm biên dịch, giúp tra cứu chuỗi chỉ tốn khoảng 5 chu kỳ CPU. Trên chip Apple M4, tốc độ đạt hơn một tỷ truy vấn mỗi giây, nhanh gấp 7-13 lần std::unordered_map.
Bảng tra cứu C++ đạt một tỷ truy vấn mỗi giây nhờ băm hoàn hảo
Rất nhiều phần mềm dành phần lớn thời gian chạy để ánh xạ chuỗi sang giá trị: máy chủ web nhận diện phương thức HTTP hay tên header, trình phân tích URL nhận diện giao thức, trình biên dịch nhận diện từ khóa. Giáo sư Daniel Lemire (Đại học Québec, TELUQ) vừa công bố một thư viện C++23 giải quyết bài toán này bằng hàm băm hoàn hảo tính sẵn lúc biên dịch, đưa thời gian tra cứu xuống chỉ còn khoảng 5 chu kỳ CPU.
 Minh họa bảng băm hoàn hảo
Vấn đề với cách làm quen thuộc
Trong C++, cách mặc định là đưa các chuỗi vào std::unordered_map. Cách này chạy được, nhưng có một điểm bất hợp lý: các khóa đã biết ngay từ lúc viết mã và không bao giờ thay đổi, vậy mà lúc chạy ta vẫn phải trả giá như thể chúng có thể đổi bất cứ lúc nào.
Cụ thể, mỗi lần tra cứu, chương trình phải băm toàn bộ chuỗi, chọn bucket, đi theo con trỏ, so sánh rồi có thể phải duyệt danh sách liên kết. Tiêu chuẩn C++ gần như bắt buộc dùng bảng băm dạng chuỗi (chained hash table), nên chi phí này khó tránh.
Ý tưởng: hàm băm không bao giờ va chạm
Nếu biết trước toàn bộ khóa, ta có thể xây dựng một hàm băm thiết kế riêng cho tập khóa đó, không bao giờ sinh ra va chạm. Đây là khái niệm hàm băm hoàn hảo (perfect hash function), đã xuất hiện từ lâu: công cụ GNU gperf làm việc này từ năm 1989.
Công thức mà nhóm tác giả dùng tương tự gperf:
slot = (độ_dài + asso[ký_tự_thứ_i] + asso[ký_tự_thứ_j] + ...) % kích_thước_bảng
Độ dài khóa được cộng với vài giá trị nhỏ lấy từ một bảng ánh xạ ký tự, thường chỉ cần một hoặc hai vị trí. Kích thước bảng là lũy thừa của 2, nên phép chia dư chỉ là một phép AND bit.
Ví dụ với bốn phương thức HTTP, chỉ cần dùng ký tự đầu tiên là đủ tách rời hoàn toàn GET, PUT, POST và DELETE. Khi tra cứu, chương trình tính slot rồi so sánh với đúng một khóa được lưu ở đó — không dò tuần tự, không duyệt chuỗi.
 Sơ đồ tính vị trí trong bảng băm hoàn hảo
Viết bằng C++ thuần, không cần công cụ ngoài
Điểm khác biệt so với gperf là toàn bộ quá trình tìm hàm băm diễn ra ngay khi biên dịch, nhờ hàm constexpr. Lập trình viên chỉ cần viết C++23 thông thường, khai báo danh sách cặp khóa – giá trị, và trình biên dịch sẽ tự tìm ra hàm băm hoàn hảo. Lúc chạy, việc tính băm có thể chỉ tốn bốn lệnh: nạp một byte của khóa, nạp một byte từ bảng ánh xạ, cộng độ dài, áp mặt nạ.
Thuật toán tìm giá trị ánh xạ khá đơn giản: sắp xếp các ký tự theo số khóa mà chúng xuất hiện, rồi lần lượt thử 0, 1, 2… cho đến khi không còn va chạm. Đây là thuật toán tham lam với khối lượng công việc bị chặn trên — điều quan trọng, vì trình biên dịch C++ giới hạn số phép tính mà một hàm constexpr được thực hiện.
So sánh chuỗi bằng lệnh vector
Tính được vị trí chưa đủ; vẫn phải kiểm tra chuỗi tra cứu có trùng khóa lưu trong slot hay không. Cách so sánh từng byte có nhánh rẽ thường tốn hàng chục lệnh và nhiều nhánh khó dự đoán.
Nhóm tác giả thay bằng cách xử lý khóa như vector: các CPU ARM lẫn x64 đều có thanh ghi 16 byte, nên họ nạp vô điều kiện 16 byte dù khóa chỉ dài vài byte, rồi dùng lệnh shuffle (tbl trên ARM NEON) để đưa các byte vượt quá độ dài về 0. Khóa lưu sẵn đã được đệm 0 từ lúc biên dịch, nên một phép so sánh vector là đủ. Từ khoảng 40 lệnh và 8 nhánh, đoạn mã rút còn 5 lệnh, không nhánh.
Việc đọc 16 byte khi khóa ngắn hơn là an toàn miễn không vượt sang trang bộ nhớ khác, mà mỗi trang tối thiểu 4 KB. Thư viện chỉ cần kiểm tra một lần xem địa chỉ có nằm sát cuối trang hay không; nếu có thì đi đường chậm.
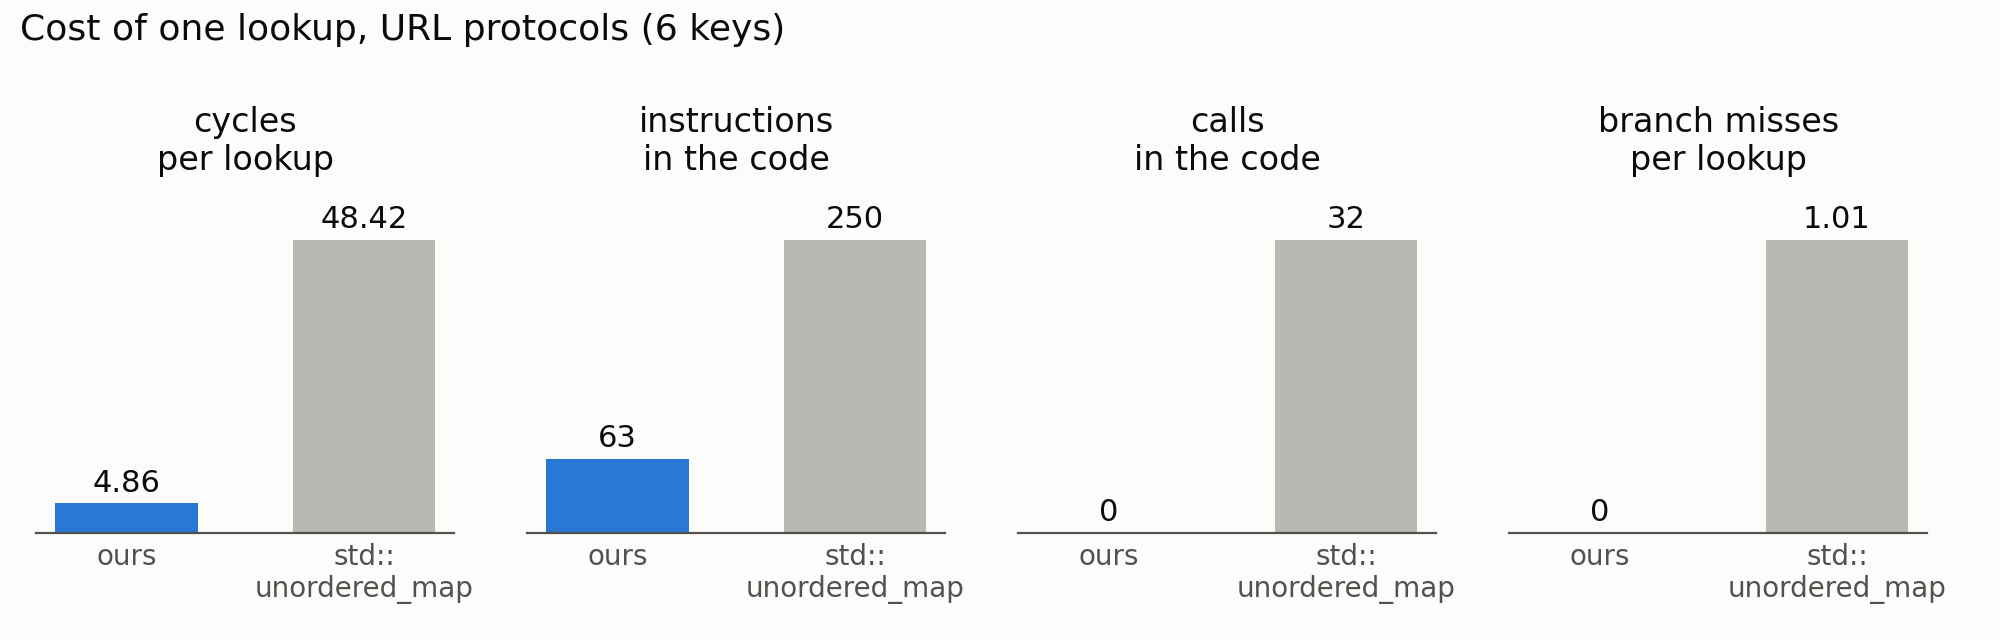 Chi phí tra cứu theo từng bộ khóa
Kết quả đo đạc
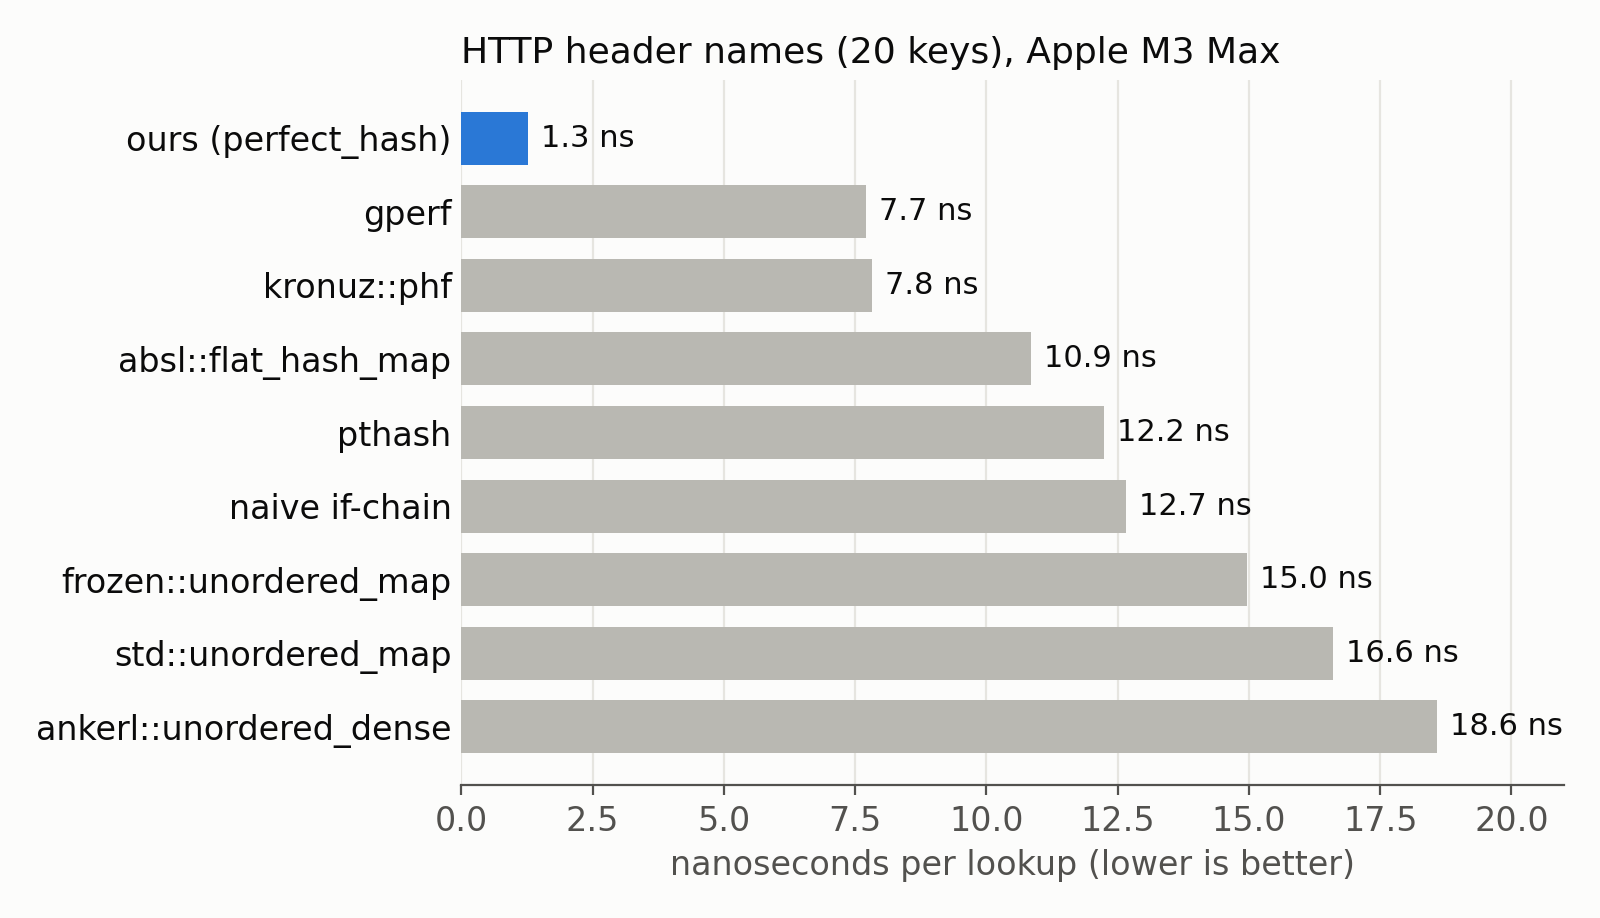
Thử nghiệm trên Apple M3 Max với AppleClang 15, tra cứu ngẫu nhiên 20 tên header HTTP chuẩn, thư viện mới tốn khoảng 1,3 ns mỗi lần tra cứu, tức khoảng 5 chu kỳ. Cùng phép đo, gperf cổ điển cần 7,7 ns, flat_hash_map của Abseil cần 10,9 ns còn std::unordered_map cần 16,6 ns — chậm hơn 13 lần.
Kết quả không phải may mắn của một bộ khóa. Trên nhiều tập khác nhau, từ 6 giao thức URL đến 100 mã cổ phiếu S&P 100, thời gian tra cứu dao động 1,2–2 ns, nhanh gấp 3–6 lần gperf và 7–13 lần chuẩn C++. Với danh sách từ khóa dành riêng của JavaScript, khoảng cách còn lên tới 17 lần.
Trên chip Apple M4, với tập giao thức URL, thư viện vượt mốc một tỷ truy vấn mỗi giây. Bộ xử lý của Apple có thể hoàn tất hơn 8,6 lệnh mỗi chu kỳ với đoạn mã này và gần như không đoán sai nhánh.
Ý nghĩa thực tế
Với lập trình viên C++ ở Việt Nam đang xây dựng máy chủ, proxy, trình phân tích cú pháp hay bộ định tuyến, bài học rất rõ ràng: nếu khóa đã biết lúc biên dịch, đừng trả giá xử lý va chạm lúc chạy. Hàm băm hoàn hảo đưa chi phí xuống còn một phép so sánh duy nhất.
Thư viện được đóng gói dưới dạng một header duy nhất, có thể thả thẳng vào dự án mà không cần cài đặt gì thêm. Đây là công trình hợp tác giữa Daniel Lemire và Francisco Geiman Thiesen (Microsoft), từng được trình bày tại hội nghị P99 CONF 2026; mã nguồn và kịch bản đo hiệu năng đều được công khai.