Bẫy 40ms: Khi swap khiến bộ thu gom rác của Go 'đóng băng' cả chương trình
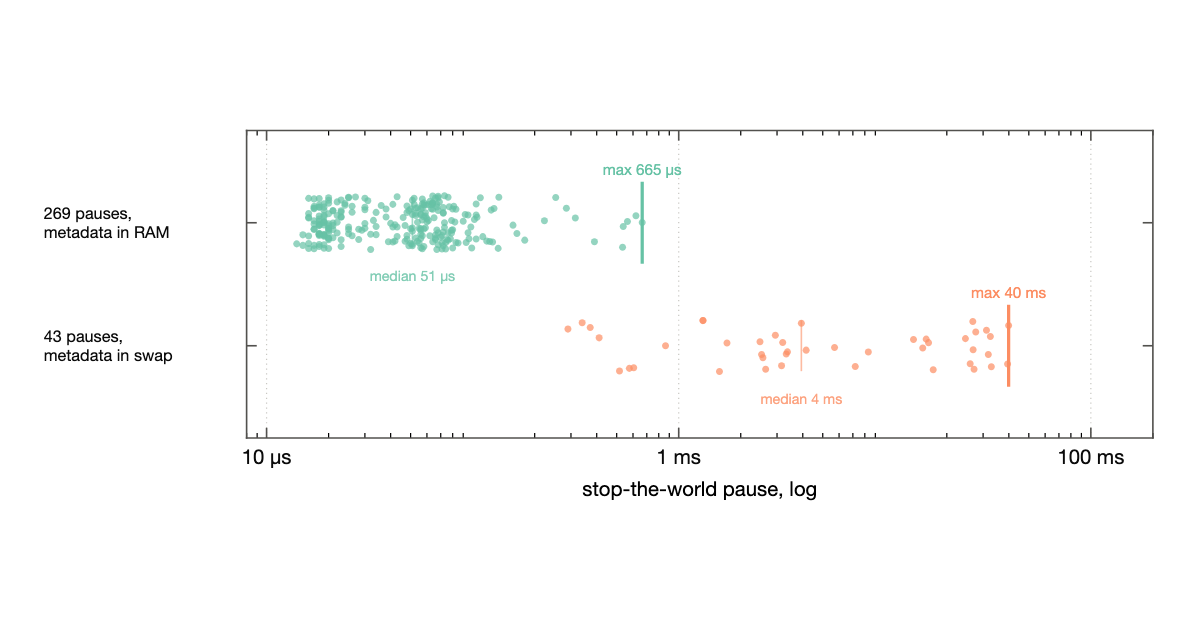
Một kỹ sư ghi lại thí nghiệm đau đầu khi bật swap trong môi trường production: metadata của bộ thu gom rác (GC) trong Go bị đẩy xuống ổ đĩa, khiến thời gian dừng toàn bộ chương trình (stop-the-world) tăng vọt từ 51 micro giây lên tới 40 mili giây. Bài viết phân tích nguyên nhân, chi phí thực tế và những lưu ý cho lập trình viên Go khi vận hành dịch vụ dưới áp lực bộ nhớ.
Bẫy 40ms: Khi swap khiến bộ thu gom rác của Go "đóng băng" cả chương trình
Có những quyết định hạ tầng tưởng chừng vô hại lại âm thầm phá hoại hiệu năng hệ thống. Câu chuyện dưới đây là một ví dụ điển hình: bật swap để "hấp thụ" các đợt tăng vọt bộ nhớ, nhưng lại vô tình biến bộ thu gom rác của Go thành thủ phạm gây ra những khoảng dừng chết người.
Bài viết gốc được chia sẻ bởi một kỹ sư vận hành, người đã dành thời gian đo đạc và mổ xẻ hiện tượng này trước khi áp dụng vào môi trường production. Dưới đây là toàn bộ câu chuyện, kèm theo phân tích và bài học cho cộng đồng lập trình viên Go tại Việt Nam.
Bối cảnh: một cgroup, hai tiến trình, và quyết định dùng swap
Tác giả có một cgroup chạy hai tiến trình:
- Một tiến trình Go liên tục gọi
io.ReadAllrồiproto.Unmarshal, tạo ra một blob dữ liệu và sau đó là một cấu trúc đồ thị (graph struct) — phần này được đánh dấu là scan bởi bộ cấp phát của Go, tức là GC phải quét qua từng con trỏ một. - Một tiến trình HTTP server, phần lớn thời gian im lặng.
 Tiến trình Go và luồng quét của bộ thu gom rác
Suy nghĩ ban đầu khá hợp lý: khi bộ nhớ bị ép, nhân hệ điều hành (kernel) sẽ đẩy các trang bộ nhớ ít dùng xuống thiết bị swap. Vì việc đẩy trang được thực hiện theo cgroup chứ không phải theo từng tiến trình, cả hai tiến trình đều có thể bị đẩy trang ra đĩa — nên xác suất xảy ra "vũ điệu swap in/swap out" giữa kernel và GC được cho là nhỏ.
Kết luận đó sai. Trong quá trình thử nghiệm, tác giả phát hiện một vấn đề có thể gây thiệt hại thực sự: GC của Go đọc metadata của nó — phần nằm ngoài heap, trong một vùng bộ nhớ không bao giờ được giải phóng — trong lúc dừng toàn bộ chương trình (stop-the-world). Và metadata đó hoàn toàn có thể nằm trong swap.
Thí nghiệm: 51 micro giây trung bình, nhưng đỉnh lên tới 40ms
Tác giả chạy mô phỏng trên một máy chủ Hetzner dùng nhân Linux 6.8 với MGLRU (Multi-Generational LRU) được bật. Mọi dữ liệu thí nghiệm — biểu đồ, bộ cấp phát giả lập, script BPF, script Python — đều được công khai trên GitHub.
Kết quả ban đầu khá yên tâm:
- Thời gian dừng trung vị chỉ khoảng 51 micro giây.
- Nhưng khi metadata bị đẩy xuống ổ NVMe, khoảng dừng tệ nhất lên tới 40 mili giây.
 Các bước cấp phát và chi phí ẩn
Con số 40ms không hề nhỏ. Để truy tìm nơi thời gian biến mất, tác giả viết một script BPF nhỏ đếm số lần page fault xảy ra trong lúc cả chương trình đang bị dừng. Trường hợp tệ nhất:
- Tổng thời gian dừng: 39.902 micro giây (~40ms)
- Số page fault trong khoảng dừng: 228
- Thời gian tiêu tốn cho các page fault: 39.013 micro giây
Như vậy, 39 trong tổng số 40 mili giây chỉ để phục vụ 228 lần page fault — và chúng xảy ra ngay bên trong phần "sổ sách" của GC: runtime.finishsweep_m, runtime.(*spanSet).reset, runtime.gcStart... Đây là một chế độ thất bại (failure mode) tiềm tàng mà ít người lường trước.
GC của Go buộc phải dừng toàn bộ chương trình tại hai thời điểm: khi kết thúc quá trình quét dọn (sweep termination) và khi kết thúc quá trình đánh dấu (mark termination). Trong 30 phút thử nghiệm, tác giả ghi nhận 312 khoảng dừng như vậy.
Vì sao swap lại "đánh nhau" với bộ thu gom rác?
Cơ chế diễn ra như sau:
- Runtime của Go cấp phát các trang bộ nhớ chứa metadata. Những trang này không bao giờ được giải phóng, chỉ được tái sử dụng.
- Chúng được đọc lại trong mỗi chu kỳ GC.
- Vì kernel đẩy trang ra swap dựa trên độ tuổi truy cập, những trang ít được chạm tới nhất — chính là metadata GC — bị đưa xuống đĩa.
- GC chạy, dừng toàn bộ chương trình, cố đọc lại các trang đó... và gặp major page fault.
Lúc này kernel phải làm một loạt việc: đọc bảng PTE, gọi do_swap_page, tìm khung trang mới, tính chi phí vào cgroup, đọc dữ liệu, gửi yêu cầu I/O (bio), chờ ổ đĩa, rồi đưa trang trở lại bộ nhớ. Tất cả diễn ra trong khi chương trình Go đã hoàn toàn đứng yên.
 Các điểm lỗi khi metadata nằm ngoài bộ nhớ
Vấn đề nghiêm trọng ở chỗ: 40ms này không phải là "chỉ chậm một chút". Theo thuật ngữ của Go, mọi P (processor) đều dừng lại. Nghĩa là nếu một goroutine đang chờ I/O, dữ liệu có thể đã về nhưng không có ai xử lý cho tới khi khoảng dừng kết thúc.
Để so sánh: 40ms gấp 800 lần khoảng dừng trung vị. Nó xảy ra hai đến ba lần mỗi đợt tăng vọt bộ nhớ trong bài kiểm thử. Đó là một con số đáng lo ngại với bất kỳ dịch vụ nào có yêu cầu độ trễ thấp.
Một chi phí ẩn khác: xây dựng thông điệp chậm gấp 30 lần
Ngoài khoảng dừng toàn cục, tác giả còn phát hiện một vấn đề thứ hai. Việc xây dựng một thông điệp 511 KiB — bình thường chỉ mất 3–5ms — đã tăng vọt lên:
- 105ms trên ổ NVMe
- 903ms trên network volume của Hetzner
Tính theo từng thông điệp, chi phí này còn lớn hơn cả khoảng dừng metadata. Điểm an ủi duy nhất: chỉ goroutine đang cấp phát phải trả giá, nên vấn đề mang tính cục bộ chứ không lan ra toàn chương trình như trường hợp metadata.
Tác giả chưa xác định chính xác thời gian đó "chảy" đi đâu, nhưng vẫn muốn nêu ra vì đây là một chi phí thực tế mà kỹ sư vận hành cần biết.
Bản thân swap không phải là điều xấu — tác giả đồng ý với quan điểm của Chris Down. Nhưng nó không "hợp cạ" với bộ thu gom rác, đặc biệt trong môi trường production nơi quá trình thu gom diễn ra liên tục.
Liệu Green Tea GC của Go 1.26 có thay đổi cục diện?
Một độc giả đặt câu hỏi liệu Green Tea GC — bộ thu gom rác mới trong Go 1.26 — có thay đổi cách GC đọc metadata hay không. Tác giả đã đo đạc và kết luận: tác động là không đáng kể.
Điều này có nghĩa vấn đề không nằm ở thuật toán GC, mà ở cách kernel quản lý bộ nhớ và cách runtime Go cấp phát các trang metadata. Trừ khi có thay đổi ở tầng cấp phát hoặc cách ghim (pin) các trang metadata khỏi swap, nguy cơ vẫn còn nguyên.
Bài học cho lập trình viên và kỹ sư vận hành Go tại Việt Nam
Với các đội ngũ đang chạy dịch vụ Go trên VPS, máy chủ thuê hoặc Kubernetes, đây là những điểm cần lưu tâm:
- Cân nhắc kỹ khi bật swap cho workload Go có heap lớn. Swap giúp hấp thụ đỉnh bộ nhớ, nhưng có thể biến những khoảng dừng GC vốn rất nhỏ thành các sự cố độ trễ nghiêm trọng.
- Theo dõi khoảng dừng stop-the-world, không chỉ trung vị. Con số trung vị 51 micro giây rất đẹp, nhưng đuôi phân phối (tail latency) mới là thứ phá vỡ SLA.
- Chú ý tới loại ổ đĩa. NVMe nhanh hơn network volume rất nhiều, nhưng cả hai đều tệ hơn hẳn so với việc giữ metadata trong RAM.
- Giới hạn bộ nhớ hợp lý thay vì phó mặc cho swap. Đặt
GOMEMLIMITvà điều chỉnh tham số cgroup có thể tốt hơn việc để kernel tự do đẩy trang ra đĩa. - Đo đạc trước khi triển khai. Toàn bộ dữ liệu thí nghiệm đều được công khai, và đây là cách tiếp cận đáng học hỏi: kiểm chứng giả định bằng số liệu thay vì tin vào trực giác.
Câu chuyện này nhắc nhở rằng trong vận hành hệ thống, những quyết định tưởng chừng nhỏ bé ở tầng hạ tầng — như bật swap — có thể tạo ra hiệu ứng dây chuyền khó lường tới tận tầng runtime của ngôn ngữ lập trình.