
bootgpt: Mô hình ngôn ngữ 510 byte sống trong phân vùng khởi động, tự "mơ" log khởi động Linux
Một lập trình viên đã nhét toàn bộ engine suy luận của mạng nơ-ron vào 510 byte của Master Boot Record, với trọng số và từ vựng nằm ở các sector kế tiếp. Mô hình char-level một lớp ẩn chạy trên 386 trong chế độ thực 16-bit, tự sinh ra log khởi động Linux cho phần cứng không hề tồn tại.
bootgpt: Mô hình ngôn ngữ 510 byte sống trong phân vùng khởi động, tự "mơ" log khởi động Linux
Một dự án mã nguồn mở vừa xuất hiện trên Hacker News đang gây chú ý trong giới lập trình hệ thống: bootgpt, một mạng nơ-ron nhỏ đến mức toàn bộ engine suy luận chỉ chiếm 510 byte của Master Boot Record (MBR). Khi máy tính khởi động, nó không nạp hệ điều hành mà bắt đầu "mơ" ra những dòng log khởi động Linux giả — đầy đủ timestamp, địa chỉ PCI, sự kiện ACPI — cho phần cứng chưa từng tồn tại.
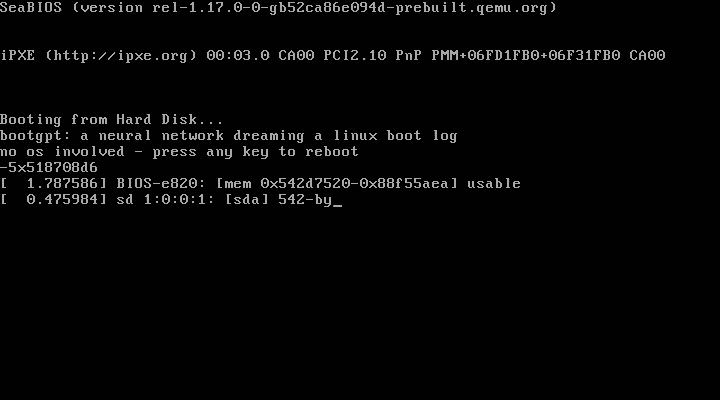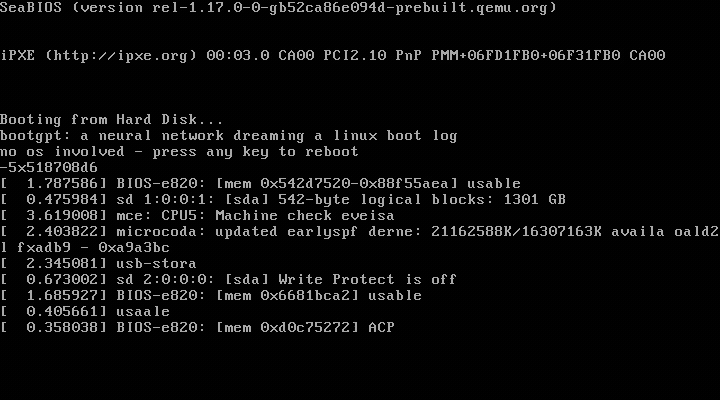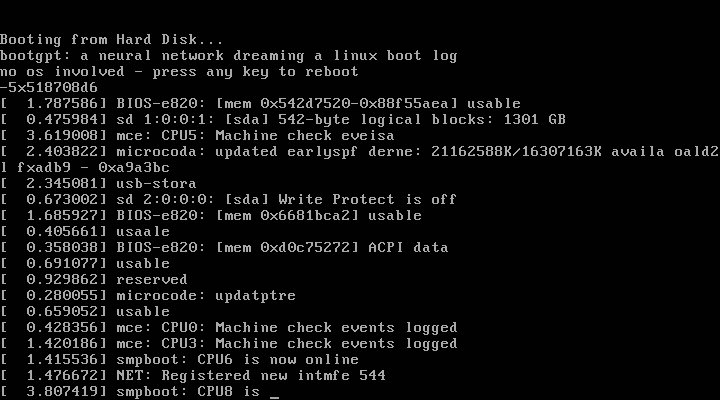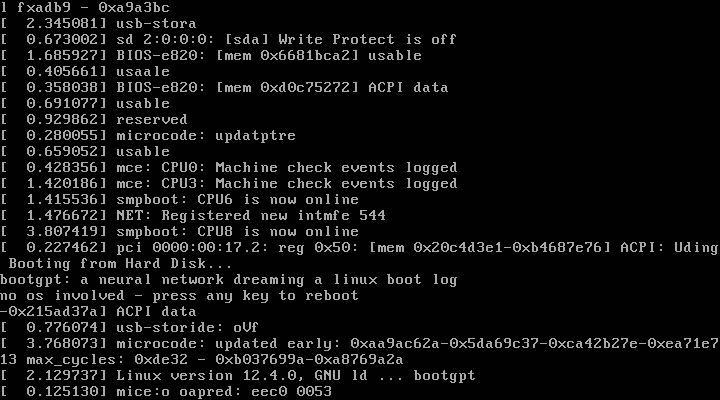 Minh họa quá trình khởi động của bootgpt
Ý tưởng đến từ sân chơi boot sector
Tác giả cho biết ý tưởng bắt nguồn từ boot sector demo scene — cộng đồng những người từng viết cờ vua, game BASIC, thậm chí cả một trình biên dịch C gói gọn trong 512 byte. Câu hỏi đặt ra rất đơn giản: thay vì một chương trình thông thường, liệu có thể dùng một mạng nơ-ron để sinh ra nội dung ngay trong giây phút máy tính thức giấc?
Kết quả là một cỗ máy kỳ lạ: vừa bật nguồn, nó in ra hàng loạt thông báo khởi động của nhân Linux, như thể một hệ thống hoàn chỉnh đang được nạp — nhưng thực chất tất cả chỉ là ảo giác do một mô hình ngôn ngữ tí hon tạo ra.
Kiến trúc: 510 byte mã, phần còn lại là dữ liệu
Điểm đáng nói nhất là cách chia bộ nhớ cực kỳ tiết kiệm:
- MBR (512 byte, trong đó 510 byte là mã): viết hoàn toàn bằng hợp ngữ (asm) thủ công, chứa toàn bộ runtime.
- 23 sector kế tiếp: chứa trọng số mô hình int8 khoảng 11,5 KB, bảng từ vựng và các chuỗi ký tự.
- Chạy trong chế độ thực 16-bit trên CPU 386, không hệ điều hành, không C runtime, không thư viện.
Mô hình chỉ có 8 ký tự ngữ cảnh và một lớp ẩn duy nhất, nên chất lượng đầu ra đúng như kỳ vọng của một mạng nơ-ron siêu nhỏ:
[ 2.283888] pci 0000:01:01.4: [1b36:0a35] ryndrde c4128 6422 Vveine [ 1.953886] NET: Registered protocol family 16
Những dòng log vừa giống thật vừa sai lệch này chính là điểm thú vị: đủ "mùi" kernel để đánh lừa mắt người, nhưng rõ ràng là sản phẩm của một cỗ máy đang mơ.
Quy trình huấn luyện và kiểm chứng từng ký tự
Dự án gồm vài script Python nhỏ nhưng được thiết kế rất chặt chẽ:
- corpus_gen.py tạo khoảng 3 MB dmesg giả, với mỗi phiên khởi động dùng một phiên bản kernel và một ổ đĩa riêng — vì log khởi động thật vốn lặp lại, và chính sự lặp lại đó giúp mô hình tí hon trông "tỉnh táo".
- train.py huấn luyện mô hình (embedding ký tự, một lớp ẩn, softmax), sau đó lượng tử hóa toàn bộ sang int8 với scale là lũy thừa của 2, để boot sector có thể thực hiện toàn bộ lượt lan truyền xuôi chỉ bằng
imulvà một lệnhidiv. - Đặc biệt, script này mô phỏng chính xác phép toán số nguyên mà mã asm sẽ chạy, kể cả bộ lấy mẫu LCG, nhờ đó có thể so sánh từng ký tự giữa đầu ra Python và đầu ra thực tế trên QEMU. Kết quả: khớp chính xác đến từng ký tự.
Bài học từ những lỗi "đắt giá"
Việc so sánh từng ký tự đã giúp tác giả phát hiện ra lỗi yêu thích của mình. Các ký tự đầu tiên khớp với mô phỏng, rồi đột nhiên lệch. Anh truy xuất lớp ẩn qua cổng debug của QEMU và so từng nơ-ron một — chỉ có nơ-ron đầu tiên đúng.
Nguyên nhân: phép kích hoạt dùng idiv, mà lệnh này ghi phần dư vào edx — đúng thanh ghi đang giữ con trỏ tới bảng bias. Kết quả là nơ-ron đầu tiên nhận bias đúng, các nơ-ron sau dùng dữ liệu rác. Cách sửa: tính địa chỉ bias từ biến đếm vòng lặp thay vì giữ con trỏ qua phép chia.
Một lỗi khác được phát hiện chỉ bằng cách đọc mã trước lần chạy đầu: routine in của BIOS xóa bx, nhưng bx lại đang chứa số thứ tự ký tự dự đoán — điều này giải thích vì sao phải push/pop bx quanh lệnh in.
So với các dự án tiền nhiệm
Thể loại boot sector vốn đã có truyền thống lẫy lừng: Oscar Toledo từng đưa cờ vua, cả một hệ điều hành và thậm chí trình thông dịch BASIC vào 512 byte; người khác làm cả trình biên dịch C.
Gần nhất là sectorllm, chạy một mô hình llama2 thật với 5 lớp và cơ chế attention trong khoảng 1,2 KB hợp ngữ chế độ thực. Trong khi đó, bootgpt chọn thái cực ngược lại: engine phải vừa đúng một sector, nên mạng chỉ có một lớp ẩn int8, và mục tiêu không phải kể chuyện chung chung mà là ảo giác chính xác một thứ duy nhất — log khởi động của cỗ máy mà nó đang thức dậy.
Chạy thử
Dự án yêu cầu NASM và QEMU:
brew install nasm qemu- Tạo môi trường ảo rồi cài numpy, sau đó chạy
./build.shvà./run.sh. - File
disk.imglà một ảnh khởi động bình thường: có thểddra USB và boot trên bất kỳ máy BIOS nào. Nó chỉ đọc các sector của chính mình.
Nhấn phím bất kỳ sẽ khởi động lại máy — và cỗ máy lại tiếp tục mơ một phiên log Linux khác. Với những ai quan tâm đến lập trình hệ thống, nén mã và AI biên (edge AI), bootgpt là một ví dụ tuyệt vời cho thấy giới hạn khắc nghiệt đến đâu vẫn có thể tạo ra thứ gì đó thú vị.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Anthropic chặn người dùng vì mọi thứ liên quan đến huấn luyện mô hình lớn hơn
31 tháng 10, 2026