
Canto: Mô hình giọng nói được xây dựng cho thế giới thực
Wispr Advanced Interfaces Lab vừa ra mắt Canto, mô hình nhận dạng giọng nói theo thời gian thực đạt tỷ lệ lỗi từ thấp nhất trong các mô hình được thử nghiệm. Mô hình được huấn luyện qua hai giai đoạn tinh chỉnh có giám sát và học tăng cường, giúp xử lý tốt hơn các điều kiện ghi âm khó khăn ngoài thực tế.
Canto: Mô hình giọng nói được xây dựng cho thế giới thực
Các mô hình nhận dạng giọng nói hiện nay đã trở nên rất giỏi trong việc chuyển đổi âm thanh sạch được ghi trong điều kiện lý tưởng. Nhưng việc đọc chính tả thực tế hiếm khi diễn ra trong những điều kiện như vậy. Hàng triệu người dùng Wispr Flow để nhắn tin, viết email, lập trình và phát triển ý tưởng tại bàn làm việc, giữa các cuộc họp, trên đường đi làm hay trong văn phòng đông người. Họ nói qua micro laptop, tai nghe nhét tai và tai nghe chụp đầu, thường xuyên có tiếng người khác, âm nhạc hoặc tiếng xe cộ ở phía sau.
Hôm nay, Wispr Advanced Interfaces Lab giới thiệu Canto, mô hình giọng nói mới nhất của họ dành cho việc đọc chính tả theo thời gian thực. Trên một đánh giá về các bản đọc chính tả trong thế giới thực, Canto đạt tỷ lệ lỗi từ (WER) thấp nhất trong số tất cả các mô hình được thử nghiệm, bao gồm cả các mô hình đến từ Google, OpenAI, AssemblyAI và Deepgram.
Canto là mô hình đầu tiên trong một chương trình nghiên cứu và phát triển rộng lớn hơn tại Wispr Advanced Interfaces Lab. Dưới đây là cách mô hình này hoạt động, cách nó được huấn luyện để xử lý các điều kiện thực tế đầy thách thức, và những nghiên cứu đang định hình thế hệ tiếp theo.
Đánh giá Canto trong điều kiện thực tế
Để kiểm tra Canto trong điều kiện thực tế, nhóm nghiên cứu đã tạo một tập đánh giá gồm 10 giờ đọc chính tả tiếng Anh từ hơn 2.300 người nói khác nhau trên Wispr Flow, được lấy mẫu ngẫu nhiên theo ứng dụng và trường hợp sử dụng. Nhóm đặc biệt lưu ý đảm bảo tách biệt nghiêm ngặt giữa những người nói trong tập huấn luyện và tập kiểm tra để tránh hiện tượng quá khớp (overfitting) với đặc điểm của người nói.
Mọi mẫu dữ liệu đều đến từ người dùng đã đồng ý bật cài đặt chia sẻ dữ liệu của Wispr, cho phép dữ liệu của họ được dùng ẩn danh để đánh giá và cải thiện mô hình.
 Tỷ lệ lỗi từ của các mô hình trên 10 giờ đọc chính tả thực tế
WER đo lường số từ bị thay thế, bỏ sót và thêm vào so với bản ghi chuẩn do con người thực hiện (chỉ số càng thấp càng tốt). Canto đạt WER thấp nhất trong bảng so sánh.
Hiệu suất trong những điều kiện khó khăn nhất
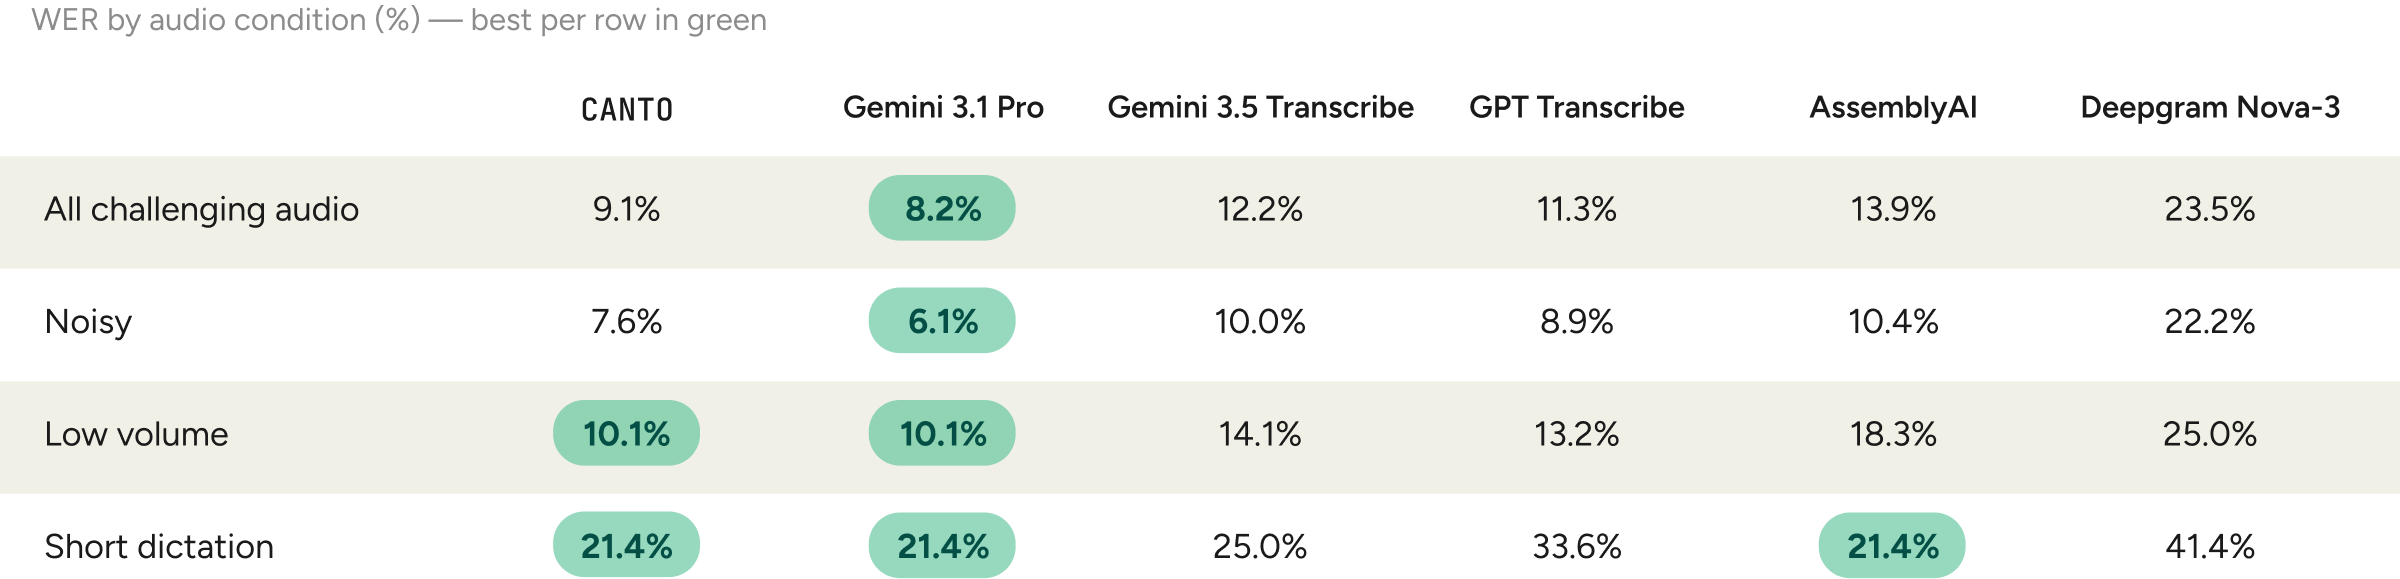
Mô hình hoạt động tốt trên dữ liệu lấy mẫu ngẫu nhiên, nhưng nhóm nghiên cứu cũng muốn tìm hiểu hiệu suất trong những tình huống khó khăn nhất. Họ xây dựng một tập thử thách riêng kéo dài 3 giờ, bao gồm các điều kiện dễ khiến việc đọc chính tả thất bại nhất.
Tập dữ liệu này bao gồm âm thanh bị ảnh hưởng bởi tiếng nói xung quanh, âm nhạc, tiếng xe cộ, tiếng gió, âm lượng ghi âm thấp, giọng nói thì thầm hoặc nói từ xa. Nó cũng chứa các đoạn đọc chính tả rất ngắn, khiến mô hình có rất ít ngữ cảnh xung quanh và ngôn ngữ để giải quyết sự mơ hồ.
Trên toàn bộ tập thử thách, Canto xếp thứ hai sau Gemini 3.1 Pro — một mô hình đa phương thức quy mô biên giới lớn hơn nhiều, không phù hợp cho các ứng dụng thời gian thực với độ trễ thấp. Trong số các mô hình phiên âm thời gian thực được đánh giá, Canto đạt WER thấp nhất.
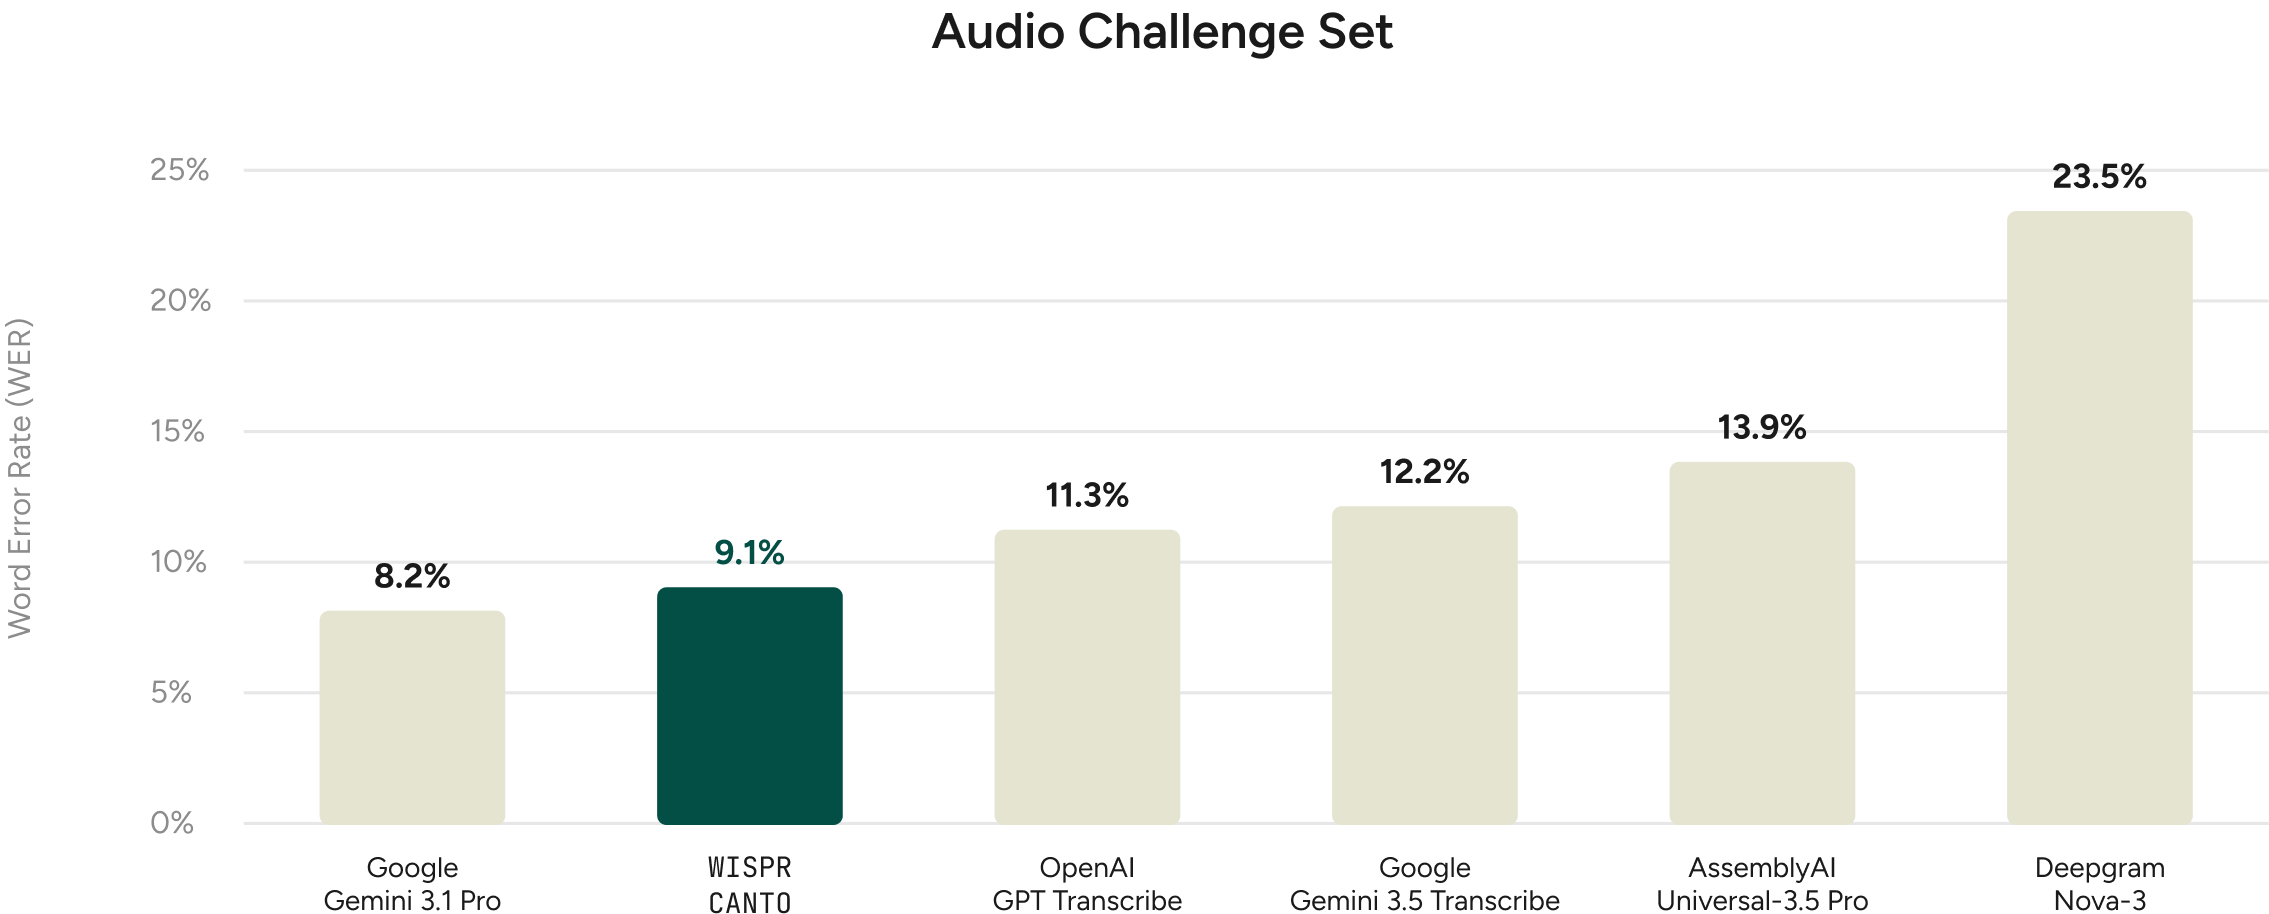 Tỷ lệ lỗi từ trên tập thử thách âm thanh 3 giờ
Khi phân tích sâu hơn, nhóm nghiên cứu nhận thấy Gemini 3.1 Pro đạt WER thấp nhất trên âm thanh nhiễu. Canto đạt WER thấp nhất (đồng hạng) trên giọng nói âm lượng thấp và các đoạn đọc chính tả ngắn. Đáng chú ý, các đoạn đọc chính tả ngắn tạo ra tỷ lệ lỗi cao nhất trên toàn bộ bảng so sánh — một sai sót duy nhất có ảnh hưởng lớn hơn đến WER khi câu chỉ có vài từ, đồng thời các mô hình cũng có ít ngữ cảnh ngôn ngữ hơn để giải quyết sự mơ hồ.
So sánh hiệu suất trên các bộ dữ liệu công khai
Nhóm cũng đánh giá Canto trên ba bộ dữ liệu tiếng Anh công khai: LibriSpeech, FLEURS và Common Voice. Canto đồng hạng với WER thấp nhất trên LibriSpeech, và vẫn cạnh tranh trên FLEURS và Common Voice dù không dẫn đầu ở hai bộ này.
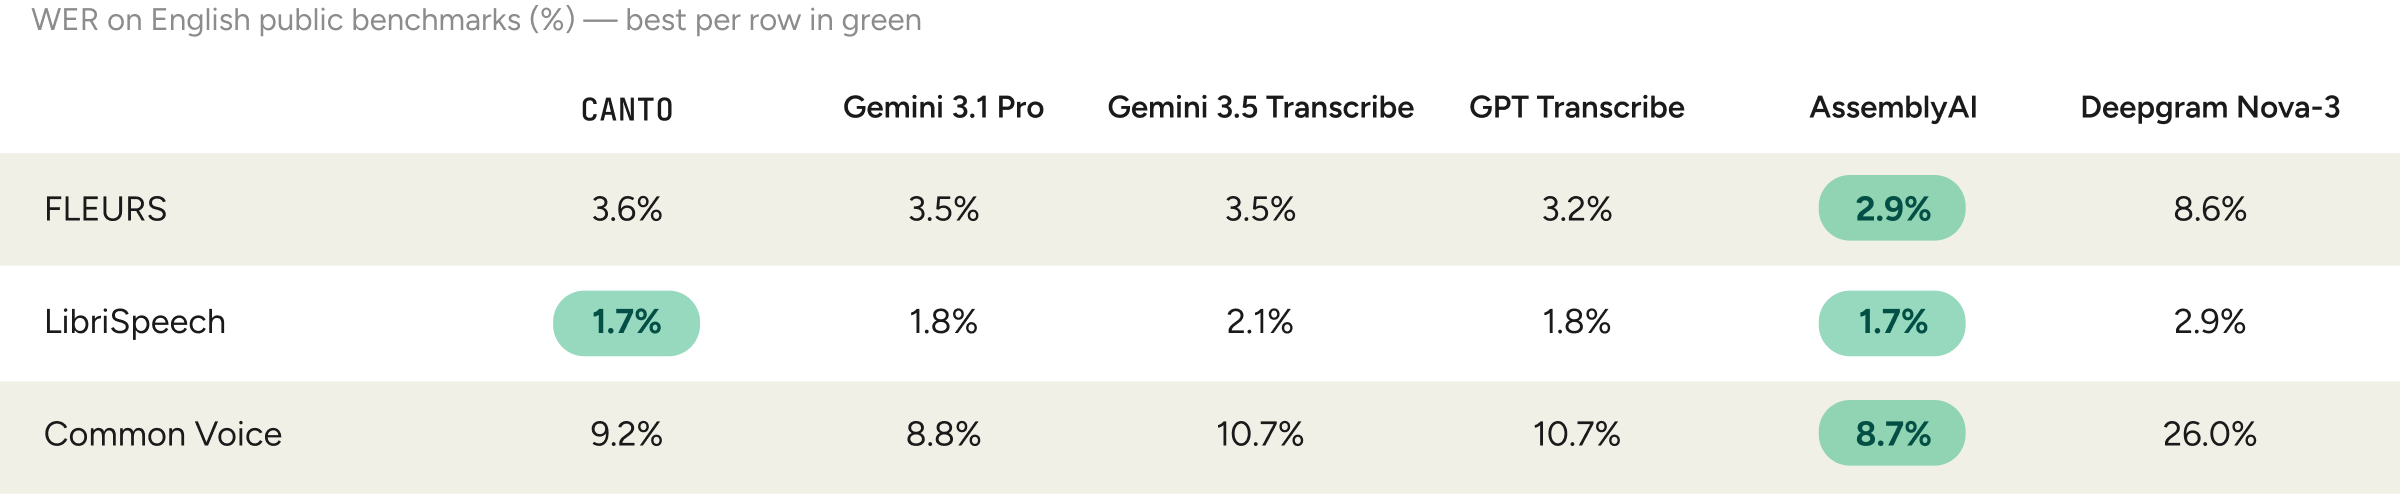 Tỷ lệ lỗi từ trên các bộ dữ liệu tiếng Anh công khai
Các bộ dữ liệu công khai này cung cấp so sánh hữu ích và có thể tái lập, nhưng chúng chủ yếu chứa giọng nói đọc sẵn. LibriSpeech được lấy từ sách nói, trong khi FLEURS và Common Voice chủ yếu gồm người đọc những câu đã chuẩn bị trước. Chúng nắm bắt một phân phối khác so với việc đọc chính tả hàng ngày "ngoài tự nhiên", nơi mọi người nói tự phát, ngắt quãng, sửa lại suy nghĩ và thường cung cấp rất ít ngữ cảnh ngôn ngữ. Sự tương phản này giải thích vì sao nhóm đánh giá Canto cả trên bộ dữ liệu công khai lẫn dữ liệu sử dụng thực tế của Wispr.
Huấn luyện hậu kỳ Canto bằng tinh chỉnh có giám sát và học tăng cường
Canto khởi đầu từ một mô hình được tiền huấn luyện trên hàng triệu giờ giọng nói và văn bản. Sau đó, mô hình được huấn luyện qua hai giai đoạn.
Giai đoạn 1 — Tinh chỉnh có giám sát (SFT): Mô hình được cho xem âm thanh đi kèm bản ghi chuẩn, học cách dự đoán từng từ trong mỗi bản ghi. Giai đoạn này dạy mô hình cách thực hiện nhiệm vụ phiên âm.
Giai đoạn 2 — Học tăng cường (RL): Mô hình được huấn luyện để so sánh chất lượng của các bản phiên âm hoàn chỉnh. Với cùng một đoạn âm thanh, mô hình tạo ra nhiều bản phiên âm khả dĩ. Mỗi bản được chấm điểm so với bản chuẩn, rồi dùng điểm số đó để khiến các bản phiên âm tốt hơn trở nên khả dĩ hơn trong các lần huấn luyện tiếp theo.
Điểm khác biệt nằm ở cách mô hình nhận phản hồi. Tinh chỉnh có giám sát cung cấp những từ mong đợi ở mỗi bước. Học tăng cường đánh giá toàn bộ bản phiên âm đã hoàn thành do mô hình tạo ra, cho phép huấn luyện hướng tới những kết quả mà nhóm quan tâm, chẳng hạn như giảm lỗi nhận dạng trong điều kiện ghi âm khó khăn.
Phương pháp của Wispr sử dụng Group Relative Policy Optimization (GRPO). Ý tưởng cốt lõi rất đơn giản: so sánh các bản phiên âm ứng viên trong cùng một nhóm và học từ điểm số tương đối của chúng. Với mỗi mẫu âm thanh, mô hình lấy mẫu nhiều bản phiên âm ứng viên (gọi là rollout), mỗi bản nhận một phần thưởng — điểm số đo lường mức độ đáp ứng mục tiêu huấn luyện.
GRPO so sánh phần thưởng của từng ứng viên với phần thưởng của các ứng viên khác trong cùng nhóm. Điểm số tương đối thu được, gọi là advantage, cho biết ứng viên đó hoạt động tốt hơn hay kém hơn nhóm của nó.
"Chúng tôi xây dựng hạ tầng có thể tạo và chấm điểm các rollout giọng nói ở quy mô lớn, cho phép chúng tôi kiến tạo các môi trường huấn luyện xoay quanh những hành vi và chế độ thất bại cụ thể."
Việc huấn luyện ở cấp độ chuỗi đã có lịch sử lâu dài trong nhận dạng giọng nói. Các nhà nghiên cứu trước đây đã tối ưu hệ thống ASR bằng phương pháp huấn luyện tối thiểu hóa lỗi từ và phương pháp gradient chính sách. GRPO được giới thiệu gần đây hơn trong DeepSeekMath, và các ứng dụng trực tiếp cho nhận dạng giọng nói tự hồi quy mới chỉ bắt đầu xuất hiện trong các nghiên cứu gần đây.
Học từ những chỉnh sửa của người dùng
Cách sử dụng tên riêng và từ vựng thay đổi nhanh hơn khả năng huấn luyện lại các mô hình giọng nói. Một từ như "Claude" có thể từng là cách viết thay thế ít phổ biến của "cloud". Khi cách dùng thay đổi, một mô hình đọc chính tả thực tiễn cần có cách học sự phân biệt này.
Với những người dùng đã đồng ý chia sẻ dữ liệu, các chỉnh sửa có thể cung cấp tín hiệu quý giá để cải thiện nhận dạng. Nhưng không phải mọi chỉnh sửa đều chỉ ra lỗi phiên âm — mọi người cũng thay đổi định dạng, viết lại câu, hoặc đơn giản là đổi ý.
Wispr sử dụng tín hiệu từ âm thanh và từ chính chỉnh sửa để xác định những sửa đổi có khả năng nhất đại diện cho lỗi nhận dạng. Chúng bao gồm độ tin cậy căn chỉnh cưỡng bức (forced-alignment confidence) — đo mức độ khớp của các từ ứng viên với âm thanh — cùng vị trí và hình dạng của chỉnh sửa. Sau đó, họ chỉ ghép (graft) sửa đổi có khả năng nhất vào bản ghi gốc, giữ nguyên phần còn lại.
Bản ghi thu được trở thành tham chiếu để chấm điểm các rollout GRPO. Một giả thuyết nhận phần thưởng cao hơn khi nó thực hiện đúng sửa đổi dự kiến. Cách ghép này biến một chỉnh sửa cấp tài liệu đầy nhiễu thành tín hiệu huấn luyện cấp chuỗi tập trung hơn.
Học cách sử dụng ngữ cảnh một cách chọn lọc
Khi chạy, Canto được cung cấp từ vựng chuyên biệt từ từ điển cá nhân của người dùng. Điều này giúp mô hình khôi phục tên riêng và các thuật ngữ hiếm khó nhận biết chỉ từ âm thanh. Phần khó là quyết định mô hình nên tin tưởng ngữ cảnh đó ở mức nào.
Giả sử "Barry" xuất hiện trong từ điển của ai đó và họ đọc: "I want to make a berry salad." Trong điều kiện ghi âm kém, cả hai từ đều có thể hợp lý về mặt âm học. Một mô hình quá hăng hái có thể chọn "Barry" vì nó có trong từ điển, dù người đó thực sự nói "berry".
Để đo hành vi này, nhóm nghiên cứu bắt đầu từ một checkpoint SFT và huấn luyện mô hình bằng RL trong khi cung cấp ngữ cảnh đúng trên 10% mẫu huấn luyện, rồi kiểm tra với các yếu tố gây nhiễu tổng hợp có độ tương đồng ngữ âm khác nhau với từ đúng.
Sau huấn luyện RL, mô hình trở nên phản hồi tốt hơn với ngữ cảnh, kể cả khi ngữ cảnh sai. Trong số các thuật ngữ tương đồng ngữ âm nhất, mô hình chấp nhận yếu tố gây nhiễu gần như gấp năm lần so với mô hình SFT ban đầu. Việc huấn luyện đã khiến ngữ cảnh hữu ích hơn, nhưng mô hình đôi khi tin tưởng nó quá dễ dàng.
Để tách biệt việc chấp nhận ngữ cảnh khỏi việc phân biệt ngữ cảnh, nhóm đã huấn luyện ba lần chạy từ cùng một checkpoint SFT: luôn đúng, gây nhiễu + đúng, và chỉ gây nhiễu. Kết quả cho thấy mỗi hỗn hợp dạy mô hình một mối quan hệ khác nhau với ngữ cảnh — và sự đánh đổi này có thể huấn luyện được. Mục tiêu không chỉ là khiến mô hình tuân theo ngữ cảnh, mà còn dạy mô hình biết khi nào ngữ cảnh đáng được tuân theo.
Điều gì tiếp theo
Canto là mô hình đầu tiên trong một họ mô hình lớn hơn. Wispr đang huấn luyện thế hệ kế tiếp ở quy mô lớn hơn gấp mười lần Canto, với mục tiêu cải thiện nhận dạng trong điều kiện âm thanh khó, cải thiện nhận dạng nhiều người nói (cho sản phẩm ghi chú cuộc họp mới ra mắt), tận dụng tốt hơn từ vựng theo ngữ cảnh, và đạt cùng tiêu chuẩn trên nhiều ngôn ngữ hơn.
Một trọng tâm là kiến trúc thống nhất cho phiên âm và phân tách người nói (diarization). Các hệ thống phiên âm cuộc họp thường nhận dạng từ và xác định người nói theo các giai đoạn riêng biệt, khiến lỗi ở giai đoạn này chồng lên lỗi ở giai đoạn kia. Một mô hình kết hợp có thể lý luận đồng thời về việc ai nói gì và khi nào người nói thay đổi. Cấu trúc người nói cũng có thể cung cấp bằng chứng hữu ích trong môi trường nhiễu, giúp phân biệt cuộc trò chuyện đang được phiên âm với tiếng nói không liên quan ở phía sau.
Theo thời gian, các mô hình giọng nói sẽ cần làm nhiều hơn việc nhận dạng từ. Chúng sẽ cần sử dụng ngữ cảnh một cách chọn lọc, hiểu ứng dụng mà người dùng đang nói trong đó, và kết nối điều đã nói với điều người đó đang cố gắng hoàn thành. Canto mang lại cho Wispr mô hình giọng nói, phương pháp huấn luyện và khung đánh giá để theo đuổi giao diện rộng lớn hơn đó.
Đây vẫn là những bài toán nghiên cứu mở. Nếu bạn làm về nhận dạng giọng nói, học tăng cường, phân tách người nói, mô hình đa ngôn ngữ hoặc giao diện đa phương thức, Wispr Advanced Interfaces Lab đang tuyển dụng.

