CHAP: giao thức ghi lại quyết định giữa người và AI agent
Brightbeam AI công bố CHAP 0.2, giao thức mở giúp lưu mọi chỉnh sửa, phê duyệt hay từ chối của con người với đầu ra của AI agent vào một chuỗi kiểm toán có thể truy vấn. Mục tiêu là thay việc dò log rải rác bằng một nơi duy nhất để tra cứu và tái hiện quyết định.
 Minh họa quy trình trước và sau khi áp dụng CHAP
Khi AI agent soạn xong một bản nháp và con người sửa lại, bản sửa đó thường nằm trong mã ứng dụng, trong khung chat, trong bình luận ticket, hoặc chỉ trong đầu người duyệt. Brightbeam AI muốn đưa toàn bộ những quyết định này vào một cấu trúc chung.
Dự án có tên CHAP (Collaborative Human-Agent Protocol, giao thức cộng tác giữa người và agent), phiên bản 0.2 dạng bản nháp công khai. Mã nguồn phát hành theo giấy phép Apache 2.0, đặc tả theo CC-BY 4.0, dùng miễn phí phí bản quyền với mọi ngôn ngữ và cách triển khai.
Bài toán: quyết định của con người bị thất lạc
Trong CHAP, bản nháp của agent là một artefact (sản phẩm trung gian). Chỉnh sửa của con người là một override có cấu trúc, gồm phần chênh lệch (diff), lý do và các nhãn do nhóm tự định nghĩa.
Mọi thứ nối với nhau bằng mã băm nội dung. Sáu tuần sau, khi cần biết chuyện gì đã xảy ra, bạn truy vấn chuỗi thay vì lục log ở bốn giao diện khác nhau.
Cấu trúc của một override
Hai trường ít người để ý lúc đầu là intent_preserved và tags.
- intent_preserved: phân biệt override tinh chỉnh (người dùng đồng ý với quyết định của agent nhưng viết lại cách diễn đạt) với override thay thế (người dùng đi đến kết luận khác). Hai kiểu lỗi này cần hai cách xử lý khác nhau.
- tags: bộ từ vựng có kiểm soát do nhóm thống nhất, nên giữ nhỏ. Đây là chiều dữ liệu bạn sẽ tổng hợp sau vài tháng.
 Cấu trúc một override trong CHAP
Ví dụ: nếu tỷ lệ tinh chỉnh cao quanh một điều khoản chính sách, khả năng cao agent truy xuất sai. Nếu tỷ lệ thay thế cao ở cùng điều khoản đó, chính sách có thể đang mơ hồ.
Những gì có trong bản 0.2
- Đặc tả: phần Core gồm bảy phương thức, một loại envelope, một định dạng truyền, cộng mười một profile tùy chọn.
- Hai bản triển khai tham chiếu bằng TypeScript và Python, phủ toàn bộ Core và các profile, tổng cộng 39 trình xử lý phương thức. Cả hai chạy trên cùng giao thức JSON-RPC 2.0.
- Bộ kiểm thử tuân thủ: 23 vector kiểm thử, kiểm tra chữ ký, chuẩn hóa và chuỗi băm, xuất chứng thư in-toto. Hiện có hai mức tuân thủ công bố được là Minimal và Recommended; mức Full đang chờ kiểm thử tương tác rộng hơn.
- Giao vận MCP server: một Coordinator CHAP có thể tự trình bày như MCP server, biến mọi phương thức CHAP thành công cụ. Có thể trỏ Claude Desktop, Cursor, Claude Code vào đó.
- Giao vận A2A server: Coordinator cũng có thể hiện diện như một A2A agent, quảng bá từng phương thức như một kỹ năng trên Agent Card.
- Cầu nối framework: năm adapter Python cho LangGraph, Pydantic AI, AG2/AutoGen, LlamaIndex Workflows và Google ADK, biến thao tác phê duyệt trong framework thành lệnh trên chuỗi kiểm toán.
- Mười hai kịch bản thực tế, từ lập trình viên độc lập dùng Cursor đến dây chuyền sản xuất được quản lý theo GMP. Ba kịch bản đã có mã chạy được.
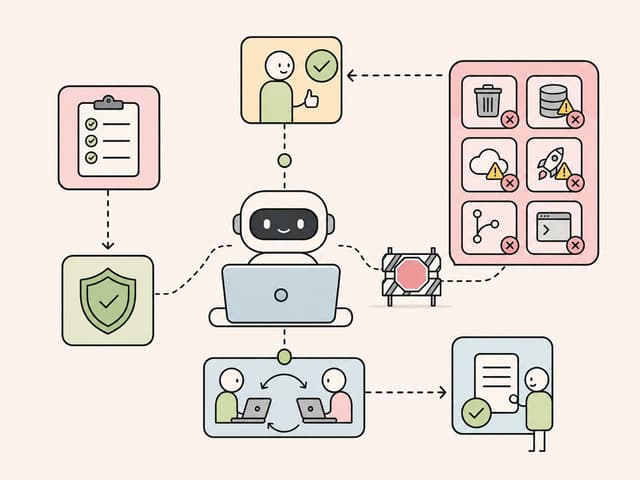
 Minh họa quy trình làm việc cộng tác giữa người và agent
Ví dụ: đánh giá pull request
Một lập trình viên dùng Cursor để xem xét pull request. Bot gắn nhãn "cảnh báo" cho một đoạn mã, người đó thấy không đúng.
Toàn bộ trao đổi gồm các bước: tạo workspace có lưu trữ SQLite, hai bên tham gia, bot tạo tác vụ và hoàn thành với đầu ra là bản đánh giá, gửi yêu cầu xem xét. Sau đó người dùng ghi đè bằng lệnh decide.override với diff thay đổi mức độ cảnh báo, kèm lý do "báo động giả, đây là quy ước của framework, không phải lỗi".
Bản TypeScript dùng lớp vỏ có kiểu tĩnh (coord.api.*), Python giữ dạng envelope JSON-RPC. Cả hai phát ra byte trên đường truyền giống hệt nhau, nên chuỗi kiểm toán không đổi dù dùng client nào.
Phân tích sau hai tháng
Kho tham chiếu có sẵn script phân tích đọc chuỗi kiểm toán từ HTTP hoặc trực tiếp từ file SQLite, nhóm các override theo nhãn và theo đường dẫn tệp.
Báo cáo mẫu cho thấy 47 override, trong đó nhãn false-positive chiếm 66%, framework-pattern-misread chiếm 47%. Lần chỉnh prompt tiếp theo cho Cursor không còn là phỏng đoán, mà dựa trên tên gọi cụ thể của mẫu lỗi.
Quan hệ với MCP và A2A
CHAP không thay thế MCP hay A2A mà đứng cạnh chúng. Agent dùng MCP để gọi công cụ, dùng A2A để trao đổi với agent khác, và dùng CHAP để ghi lại phần việc chung với con người.
Góc nhìn
Với nhóm kỹ sư ở Việt Nam đang đưa AI agent vào quy trình làm việc thật, điểm khó thường không phải chỗ agent viết mã tốt hay dở, mà là chỗ không ai chứng minh được vì sao một thay đổi được duyệt hay bị bỏ. CHAP đề xuất biến chính thao tác phê duyệt hằng ngày thành dữ liệu có cấu trúc, không cần thêm một quy trình gán nhãn riêng.
Tuy nhiên đây vẫn là bản nháp 0.2. Nhóm nào cần ổn định để chạy thật nên chờ bản 1.0, vì phần profile sẽ thay đổi nhanh hơn phần Core. Trước mắt, việc đáng làm là thống nhất bộ nhãn nhỏ ngay từ đầu, để sau vài tháng đã có dữ liệu đủ để đánh giá agent thay vì bắt đầu lại từ con số không.
Nguồn: github.com · Quy trình biên tập