d-Matrix Raptor: Bước đột phá 3D-DRAM cho suy luận AI tại Hot Chips 2026
Tại Hot Chips 2026, d-Matrix đã trình diễn Raptor – bộ tăng tốc 3D-DRAM được thiết kế riêng cho suy luận AI tạo sinh. Giải pháp này hứa hẹn đạt khoảng 1.000 token/giây/người dùng khi phục vụ mô hình 3.000 tỷ tham số với ngữ cảnh 1 triệu token, đồng thời mang lại mật độ băng thông gấp 20 lần so với HBM4.
d-Matrix Raptor: Bước đột phá 3D-DRAM cho suy luận AI tại Hot Chips 2026
Tại sự kiện Hot Chips 2026, d-Matrix đã gây chú ý khi trình diễn Raptor – bộ tăng tốc 3D-DRAM chuyên dụng cho suy luận AI tạo sinh. Đây là một canh bạc kiến trúc nhằm gộp băng thông và dung lượng vào cùng một gói phần cứng, hứa hẹn đạt khoảng 1.000 token/giây/người dùng khi phục vụ mô hình 3.000 tỷ tham số với ngữ cảnh 1 triệu token.
Vấn đề dữ liệu ngày càng phình to
Trọng số mô hình không ngừng tăng, trong khi KV cache tỷ lệ thuận với độ dài ngữ cảnh nhân với kích thước batch. Chỉ cần 64 người dùng với ngữ cảnh 1 triệu token đã có thể ngốn khoảng 935 GB KV cache. Trọng số và cache cộng lại tạo ra bài toán kép: vừa thiếu dung lượng, vừa thiếu băng thông – và cả hai phía đều tiếp tục tăng.
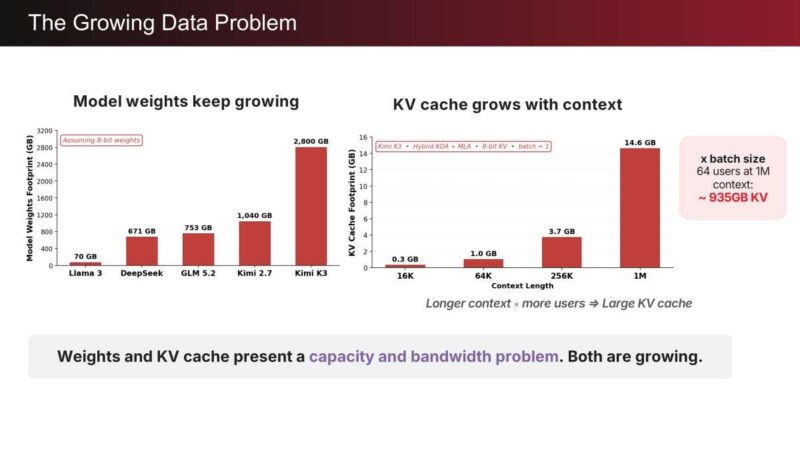 Sơ đồ bài toán dữ liệu ngày càng lớn trong suy luận AI
SRAM và HBM: Hai thái cực đều có điểm yếu
SRAM đạt được mục tiêu băng thông nhưng chỉ ở quy mô rất nhỏ. Một cặp thẻ tăng tốc Corsair SRAM có thể đạt khoảng 300 TB/s với độ trễ ~1 ns, song chỉ chứa được khoảng 4 GB. Một ô SRAM 6T có kích thước lớn hơn khoảng 10 lần so với ô DRAM, và dòng rò ở quy mô GB lên tới hàng chục watt. Vì vậy SRAM phù hợp cho mô hình nháp trong speculative decoding, chứ không thể chứa trọng số của các mô hình hàng đầu.
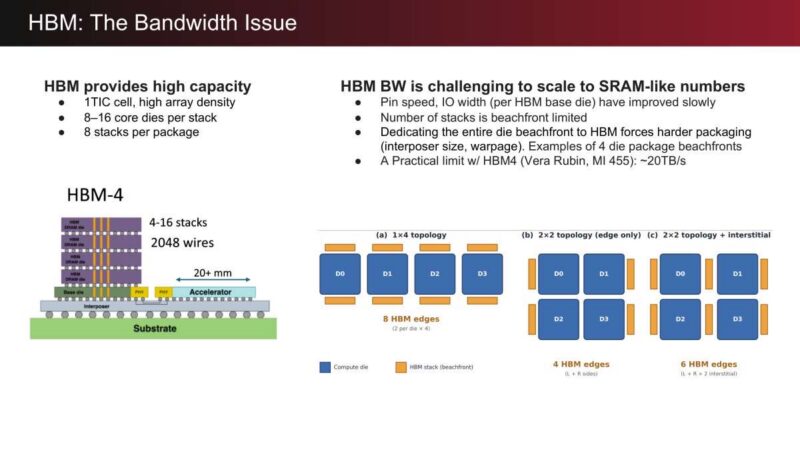
HBM giải quyết được nửa vấn đề dung lượng nhưng lại chật vật với băng thông. Tốc độ chân và độ rộng I/O trên mỗi die nền cải thiện chậm, còn số lượng stack bị giới hạn bởi diện tích đế package – chỉ khoảng 8-16 stack. d-Matrix cho rằng ngưỡng băng thông thực tế của các gói HBM4 như NVIDIA Vera Rubin hay AMD Instinct MI455 chỉ vào khoảng 20 TB/s.
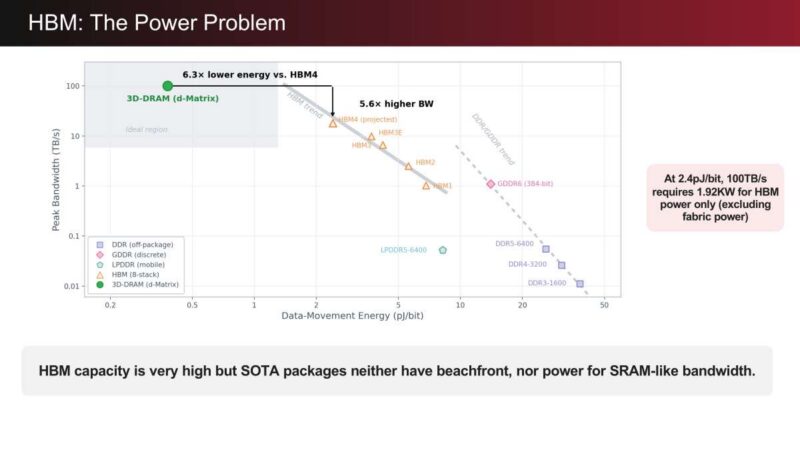
Băng thông cao đi kèm cái giá về điện năng. Ở mức 2,4 pJ/bit, đẩy 100 TB/s qua HBM tiêu tốn khoảng 1,92 kW trước khi tính đến bất kỳ lưu lượng fabric nào.
3D-DRAM: Giải pháp nằm giữa hai thái cực
Câu trả lời của d-Matrix là xếp chồng phần tính toán trực tiếp lên trên các die DRAM. Việc xếp chồng tạo ra thách thức nhiệt vì hàng trăm watt phải thoát ra qua các TSV trong một chồng DRAM nhạy cảm với nhiệt độ, kèm theo thách thức cấp nguồn do sụt áp IR. Theo d-Matrix, một chồng logic-on-top 1-Hi với mật độ không quá 0,5 W/mm² có thể được làm mát bằng chất lỏng và giữ DRAM dưới 100°C.
Trên thang năng lượng, 3D DRAM nằm giữa hai thái cực: SRAM trên die tốn khoảng 50 fJ, hệ thống HBM4 2.5D tiêu tốn khoảng 2,5-5 pJ khi tính cả năng lượng ở mức chip, còn I/O 3D dọc chỉ khoảng 0,3-0,4 pJ – thấp hơn HBM khoảng 10 lần, bởi đây là đường dẫn quy mô milimét không cần PHY thay vì tuyến interposer quy mô centimét. Số lớp xếp chồng ít hơn HBM cũng đồng nghĩa với die lớn hơn và tỷ lệ thành phẩm tốt hơn.
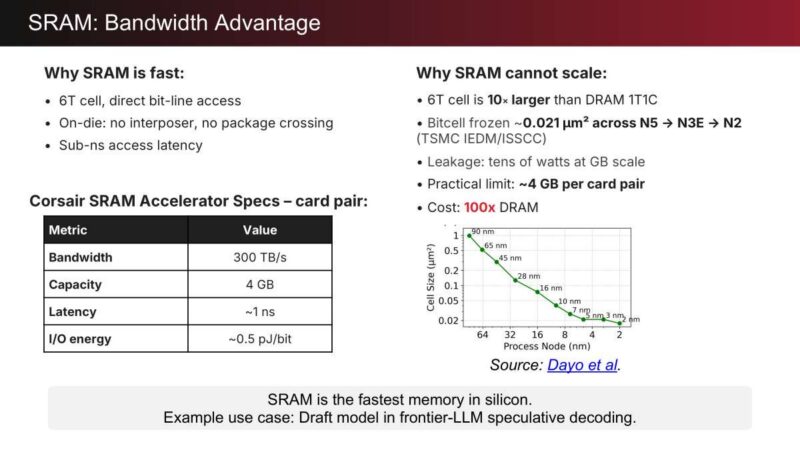 So sánh năng lượng giữa SRAM, HBM và 3D-DRAM
Hành vi của workload suy luận LLM
d-Matrix đã ánh xạ góc nhìn công nghệ này lên cách các workload suy luận LLM vận hành. Prefill xử lý nhiều token prompt song song và bị giới hạn bởi thông lượng tính toán, trong khi decode sinh từng token một và thường bị giới hạn bởi băng thông bộ nhớ. Attention có thể chuyển sang giới hạn tính toán với GQA cao và speculative decoding, còn MoE vẫn bị giới hạn bộ nhớ ngay cả ở batch size khiêm tốn. Decode chính là pha cần băng thông khổng lồ.
Vì decode chiếm phần lớn thời gian chạy thực tế, phần bị giới hạn bộ nhớ là quan trọng nhất. d-Matrix nhấn mạnh rằng phần lớn thời gian suy luận nằm ở pha decode, nên cải thiện băng thông decode sẽ nâng cao hiệu năng suy luận tổng thể.
Với 32 GB mỗi thẻ, trọng số 4-bit và KV cache 8-bit, d-Matrix thiết kế để vừa vặn trong một rack. Một cụm scale-up 72 thẻ có thể chứa mô hình hàng đầu như Kimi K3 với ngữ cảnh 1 triệu token. Việc phân tách và mở rộng đa rack sẽ vượt ra ngoài phạm vi một rack Raptor.
 Kiến trúc hệ thống suy luận dựa trên 3D-DRAM của d-Matrix
Raptor: Hiện thực hóa cụ thể
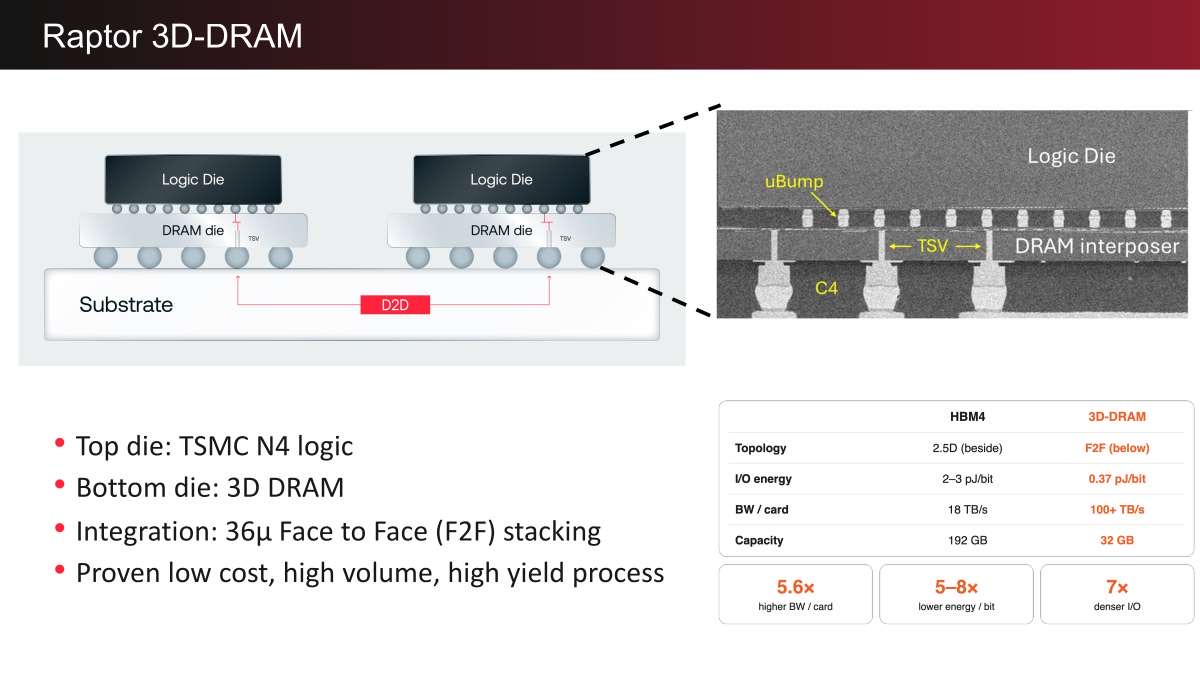
Triển khai cụ thể của d-Matrix mang tên Raptor. Một die logic TSMC N4 nằm trên một die 3D DRAM bằng công nghệ xếp chồng mặt đối mặt 36 µm – quy trình mà d-Matrix mô tả là đã được chứng minh, chi phí thấp, khối lượng lớn và tỷ lệ thành phẩm cao.
Ba thách thức tích hợp đan xen
Việc biến các die thành một hệ thống hoạt động được đặt ra một loạt thách thức tích hợp. d-Matrix nêu bật ba vấn đề đan xen: ánh xạ bank, điện năng I/O và độ tin cậy nhiệt, lưu ý rằng giải pháp cho bất kỳ vấn đề nào cũng sẽ hạn chế không gian thiết kế của hai vấn đề còn lại.
Bài toán ánh xạ bank-tới-channel
Mỗi tensor engine cần một flit 128B mỗi lần truy cập. Với 32B được truyền mỗi lần truy cập cột từ các bank 32B, cần tới 4 bank mỗi channel. Nhưng die của d-Matrix có 840 bank, còn 768 sau khi trừ 72 bank dự phòng, trải trên 256 channel – chỉ đạt 3 bank mỗi channel. Flit 128B không chia hết cho những gì hiện có.
Với 3 bank mỗi channel, một lần truy cập trả về 96B, nên để có flit 128B cần hai lần truy cập và lấy về 192B – lãng phí khoảng 33% băng thông, tương đương gần 33 TB/s. Column staggering có thể đóng gói flit nhưng cần bộ đệm dịch 192B và làm phức tạp thời gian cùng việc kiểm chứng.
Giải pháp stream blocking thu hồi phần lãng phí này. d-Matrix chia sẻ một lần truy cập 32B một phần cho ba flit, nên 4 lần truy cập 96B cấp cho 3 flit 128B, vào 384B và ra đúng 384B. Overfetch giảm về 0, mọi lần truy cập cột đều được dùng, và không cần mạng dịch.
Bức tường điện năng I/O
Di chuyển 100 TB/s ở mức 0,37 pJ/bit tương đương 296 W chỉ riêng cho I/O. Phương pháp DBI thông thường có thể tiết kiệm 20%, nhưng HBM làm được điều này nhờ burst đa chu kỳ cho phép PHY nhìn thấy toàn bộ burst. Trong khi đó, link 3D-DRAM 256-bit đơn chu kỳ của d-Matrix không có burst và không có chân sideband để báo hiệu lựa chọn đảo bit.
Giải pháp stream flipping mang lại 20% tiết kiệm đó mà không cần chân. Mỗi flit được so sánh với flit trước và đảo khi cần, giảm số lần chuyển trạng thái về gần 0 với một bit metadata mỗi flit đi kèm ECC. d-Matrix cho biết chi phí phụ trội chỉ 0,8% mà không cần thay đổi PHY.
 Kiến trúc Raptor với die logic N4 xếp trên die 3D-DRAM
Độ tin cậy DRAM ở 105°C
Nhiệt đặt ra thách thức thứ ba ở nhiệt độ junction 105°C. Tỷ lệ thành phẩm quan trọng vì 840 bank nghĩa là ngay cả tỷ lệ lỗi 1% cũng đe dọa toàn bộ channel, mà việc loại bỏ die đã liên kết lại rất tốn kém. Vô hiệu hóa một bank lỗi sẽ thu hẹp channel của nó, và một channel yếu cũng có thể kéo chậm toàn bộ slice, trong khi nhiệt độ cao hơn sinh ra nhiều lỗi mềm hơn. Thời gian lưu giữ giảm từ 32 ms ở 85°C xuống 4 ms ở 105°C, đòi hỏi refresh thường xuyên gấp 8 lần trong khi ECC và scrub phải theo kịp.
Để chống lại điều này, d-Matrix xen kẽ bit ECC và DBI vào các cột cuối của mỗi subarray, kết hợp ECC thương mại với mã Reed-Solomon. Đọc ít hàng hơn 16-32 lần giúp cho việc refresh thường xuyên gấp 8 lần chỉ tốn khoảng 1,37%, giữ băng thông gần 100 TB/s với mức tổn thất dưới 1,4%.
Bank chaining giữ các channel đối xứng khi bank lỗi. Hai mức mux vật lý cho phép mức một bỏ qua lỗi đầu tiên và mức hai bỏ qua lỗi thứ hai, nên 72 bank dự phòng của chiplet có thể hấp thụ lỗi ở bất kỳ đâu trên die. Bank dự phòng lấp vào và các channel giữ được tính đồng nhất với chi phí định tuyến không đáng kể.
Hiệu quả diện tích silicon
d-Matrix đưa ra so sánh diện tích silicon với HBM4 và NVIDIA Rubin R200. Raptor đạt khoảng 32,6 GB/s per mm² so với khoảng 1,5 GB/s của các phần HBM – gấp khoảng 20 lần băng thông trên mỗi milimét vuông, và 2,96 mW mỗi GB/s so với 40 mW, cải thiện 13,5 lần.
Raptor tuyên bố đạt khoảng 1.000 token/giây/người dùng, phục vụ mô hình lớp 3.000 tỷ tham số với ngữ cảnh 1 triệu token. Luận điểm của d-Matrix là dung lượng bộ nhớ vừa phải mỗi thẻ kết hợp với băng thông cao sẽ thắng trong suy luận độ trễ thấp. Sẽ rất thú vị nếu được thấy hệ thống này chạy thực tế.
Điều đáng bàn
Raptor là một canh bạc kiến trúc gộp băng thông và dung lượng vào một gói duy nhất cho suy luận. Các con số so sánh của d-Matrix với HBM4 và Rubin R200 cho thấy lợi thế thực sự về mật độ và năng lượng trên mỗi GB/s. Nếu 3D DRAM thu hẹp được khoảng cách băng thông bộ nhớ, nó sẽ định hình lại cách các nhà sản xuất tăng tốc cân nhắc giữa dung lượng và băng thông trong hệ thống AI.
Tuy nhiên, câu hỏi đáng đặt ra vẫn là: nếu giải pháp này hiệu quả đến vậy, tại sao các ông lớn như NVIDIA chưa triển khai? Raptor thực sự là một hướng tiếp cận đáng chú ý, và hy vọng chúng ta sẽ sớm được thấy nó vận hành trong thực tế.