Đằng sau những màn trình diễn robot hình người: Vì sao giấc mơ robot phổ quát vẫn còn xa vời
Những video robot hình người nhảy múa, phục vụ đồ uống hay gấp quần áo đang tạo ra làn sóng lạc quan về một tương lai robot phổ quát. Nhưng các nhà nghiên cứu robotics cảnh báo rằng khoảng cách giữa trình diễn và khả năng thực tế vẫn còn rất lớn, và phải mất ít nhất một thập kỷ nữa robot mới có thể làm việc hữu ích trong nhà của chúng ta.
Robot hình người của Tesla đang trở thành tâm điểm trên các nền tảng video trực tuyến
Trong vài năm trở lại đây, một mẫu robot hình người có thân trắng, đầu và ngực màu đen liên tục xuất hiện trên các nền tảng video. Có thể bạn đã từng thấy nó nhảy múa, chuyền bắp rang, bỏ rác vào thùng, hút bụi hay nhấn nút lò vi sóng. Cũng có thể bạn đã chứng kiến cảnh nó ngã ngửa khi đang phát chai nước hoặc loay hoay không là nổi một chiếc áo sơ mi.
Đó chính là Optimus của Tesla, mẫu robot hình người được vận hành bằng trí tuệ nhân tạo mà CEO Elon Musk tin rằng sẽ "không chỉ là sản phẩm lớn nhất của Tesla, mà còn có thể là sản phẩm lớn nhất trong lịch sử". Theo kế hoạch, Optimus sẽ sớm làm việc trong các nhà máy và sau đó là trong chính ngôi nhà của chúng ta. Musk tuyên bố rằng mỗi robot có giá chỉ khoảng 20.000 USD và có thể tự động hóa gần như toàn bộ lao động của con người. Tại Diễn đàn Kinh tế Thế giới ở Davos hồi tháng Một, ông dự đoán robot sẽ được bán cho công chúng vào cuối năm 2027.
Musk không phải là người duy nhất tin vào điều này. Marc Andreessen, đồng sáng lập quỹ đầu tư Andreessen Horowitz, từng nói rằng robotics có thể trở thành "ngành công nghiệp lớn nhất trong lịch sử hành tinh". Jensen Huang, CEO của Nvidia, khẳng định trong tháng Một rằng robot hình người sẽ đạt năng lực ngang con người ngay trong năm nay. Theo Morgan Stanley, số lượng robot "giống và hành xử như con người" có thể đạt gần 1 tỷ chiếc vào năm 2050, tạo ra thị trường trị giá hơn 5.000 tỷ USD.
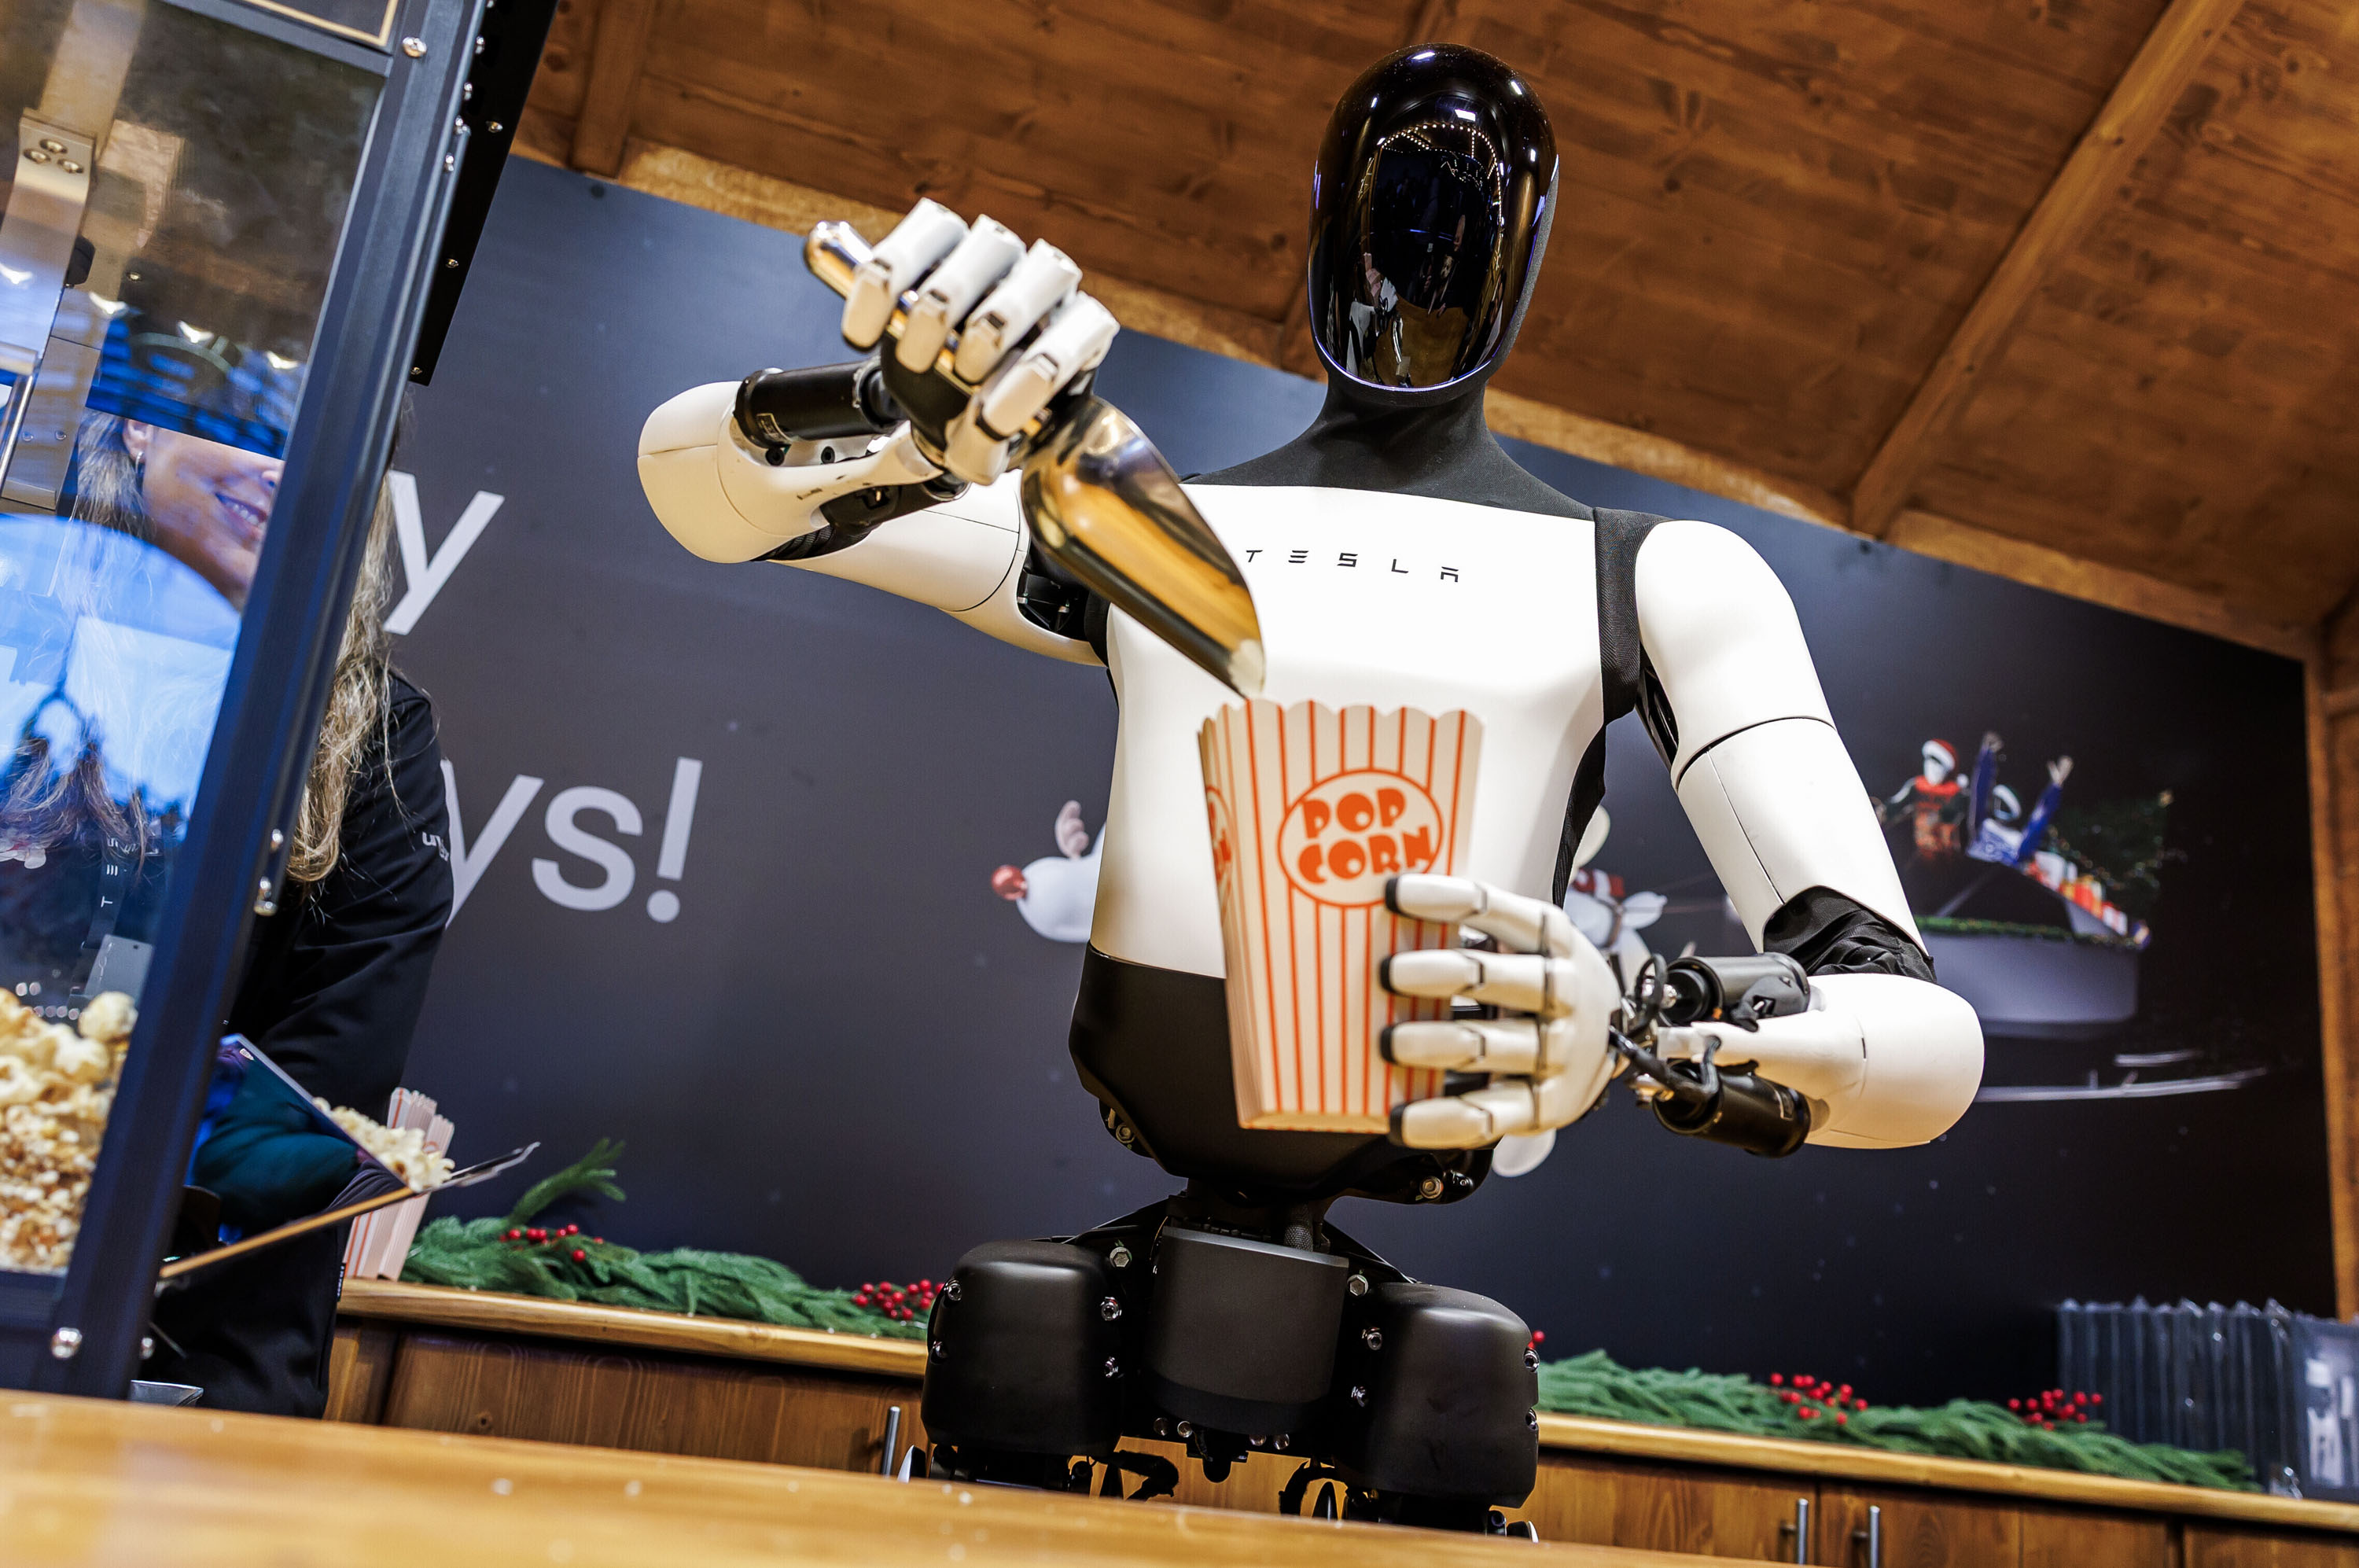 Robot hình người trong các màn trình diễn công khai
Những lời hứa dựa trên một giả định sai lầm
Làn sóng lạc quan này phần lớn được thúc đẩy bởi niềm tin rằng những tiến bộ AI đằng sau các công cụ như ChatGPT hay Claude sẽ cho phép robot thế hệ mới bắt chước chuyển động của con người, giống như chatbot bắt chước ngôn ngữ. Nhưng nhiều nhà nghiên cứu robotics tỏ ra hoài nghi, cho rằng giả định này đã đánh giá thấp những thách thức của việc dùng một trí tuệ được xây dựng trên ngôn ngữ và hình ảnh để làm chủ sự biến thiên vô hạn của thế giới vật lý.
Yann LeCun, người thường được xem là một trong những "cha đỡ đầu" của AI, đã nói thẳng: "Không một công ty nào trong số những doanh nghiệp đang chế tạo robot hình người - tuyệt đối không một ai - có chút ý tưởng nào về cách làm cho những robot đó đủ thông minh để trở nên hữu ích."
Các nhà nghiên cứu cũng chỉ ra rằng chúng ta đang nhầm lẫn giữa robot hình người được chế tạo để giống con người và những cỗ máy đa năng thực sự có khả năng học hỏi, thực hiện nhiều nhiệm vụ khác nhau. Jonathan Hurst, đồng sáng lập kiêm giám đốc robot của Agility Robotics, giải thích: "Rất dễ để tạo ra một robot trông giống người. Nhưng làm một cỗ máy di chuyển hoặc hành xử linh hoạt, năng động như con người thì khó hơn gấp nhiều lần."
Khoảng cách giữa hào nhoáng và thực tế
Căng thẳng giữa hai luồng quan điểm - robot hình người đa dụng đang ở rất gần hay còn xa vời, và liệu AI hiện tại có đủ để hoàn thiện chúng hay không - đang diễn ra tại các phòng thí nghiệm robotics trên khắp nước Mỹ. Ở đó, những lời hứa hẹn về thời gian biểu đang che khuất những tiến bộ âm thầm nhưng có ý nghĩa thực sự.
Khoảng một thập kỷ trước, một loạt đột phá đã dẫn đến cuộc cách mạng AI tạo sinh, biến khả năng trí tuệ nhân tạo được mơ ước từ lâu thành hiện thực. Các nhà robotics - dù không đồng thuận về thời điểm chính xác - tin rằng một cuộc cách mạng có sức biến đổi tương đương cũng có thể xảy ra trong lĩnh vực robot, mang lại cho máy móc trực giác vật lý và sự uyển chuyển mà bấy lâu nay vẫn nằm ngoài tầm với.
Để thấy được một trong những bộ não robot thông minh nhất hiện nay, hãy nhìn vào những gì Google DeepMind có thể làm với thiết bị mang tên ALOHA 2. Nhìn bề ngoài, nó không có gì đặc biệt: chỉ là một cặp tay máy, vài bộ kẹp và hai camera. Nhưng khi được điều khiển bởi Gemini Robotics, ALOHA 2 trở thành một robot đa dụng theo nghĩa nó có thể thực hiện nhiều nhiệm vụ dựa trên các ví dụ đã được huấn luyện.
Ví dụ, yêu cầu nó xếp một hộp cơm trưa, robot có thể dùng hai ngón kẹp để đặt nhẹ một lát bánh mì trắng vào túi Ziploc, đóng túi lại, đặt chùm nho vào hộp nhựa, đậy nắp, rồi cẩn thận chuyển các món vào hộp cơm trước khi kéo khóa. Đó không phải là một bữa trưa ngon, nhưng việc robot có thể hoàn thành nó là một bước tiến khách quan so với những gì có thể làm cách đây ba năm.
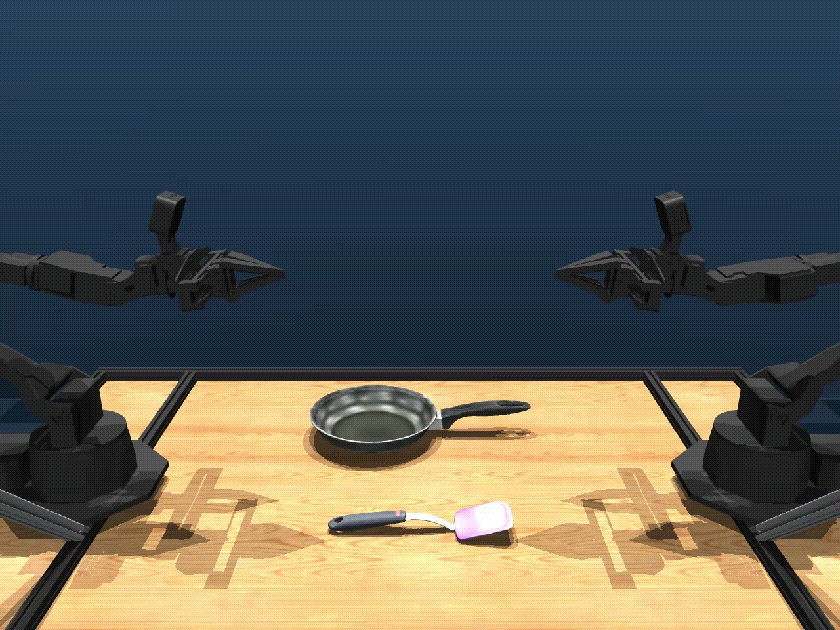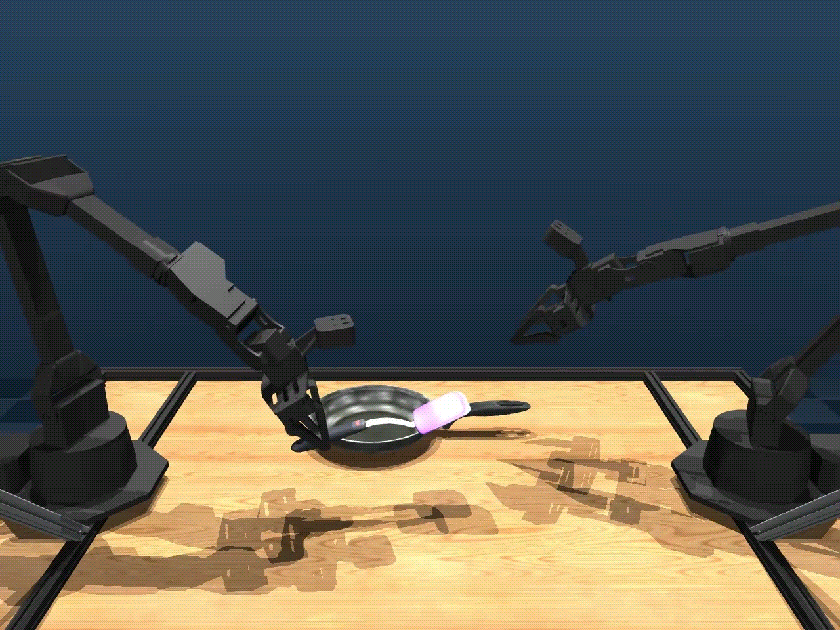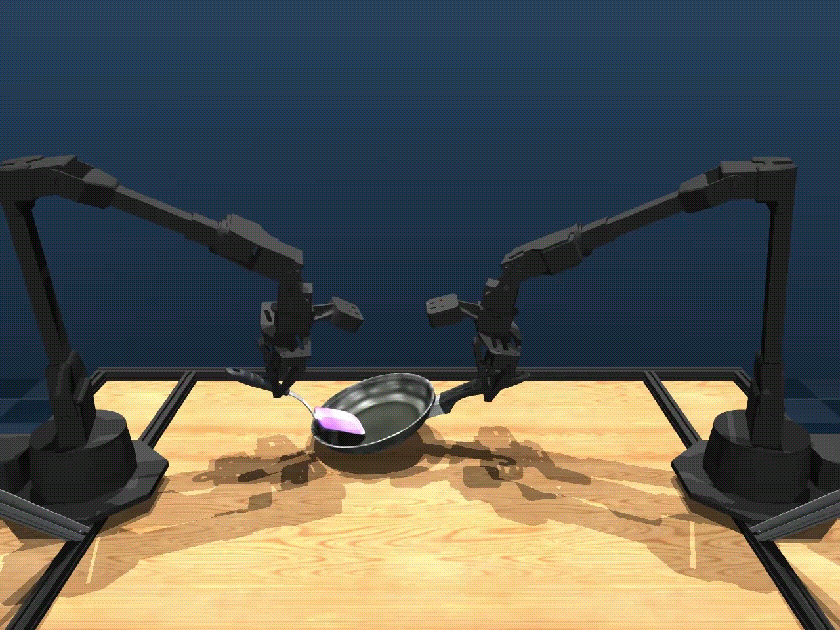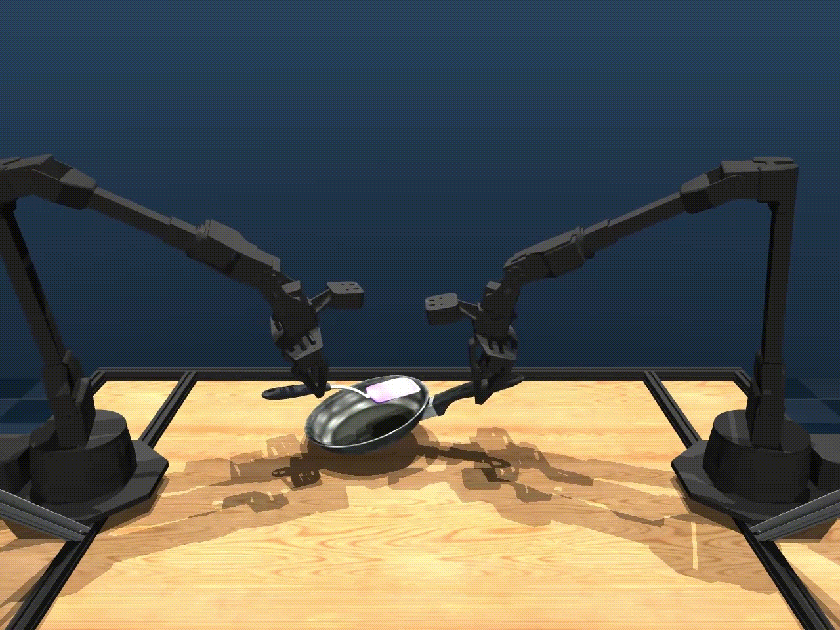 Các nhiệm vụ robot thực hiện trong môi trường mô phỏng
Từ mã hóa cứng đến mô hình AI
Thành tựu này phần lớn nhờ vào AI và tác động của nó lên cái được gọi là "chính sách robot" - hệ thống kiểm soát cách một robot đa dụng đánh giá, hiểu môi trường xung quanh, lập kế hoạch di chuyển và thực hiện nhiệm vụ chính xác.
Trước đây, các chính sách này dựa trên những quy tắc do kỹ sư phát triển và mã hóa cứng vào phần mềm robot - hàng nghìn dòng mã xác định từng milimét chuyển động của robot trong hàng trăm nhiệm vụ. Điều đang diễn ra trong vài năm gần đây - và phần lớn là nguyên nhân của sự lạc quan về robot đa dụng - là các chính sách robot đang được giao cho các hệ thống AI tiên tiến thay vì được lập trình cứng.
Đầu tiên là các mô hình thị giác - ngôn ngữ (VLM), tương tự mô hình ngôn ngữ lớn nhưng được huấn luyện trên cả hình ảnh lẫn từ ngữ. Cho VLM xem ảnh một vũng cà phê đổ và yêu cầu nó tìm dụng cụ để dọn dẹp, nó có thể xác định chiếc khăn gần đó. Kiểu hiểu ngữ cảnh tức thời này chưa từng tồn tại cách đây vài năm.
Tiếp theo là các mô hình thị giác - ngôn ngữ - hành động (VLA), cho phép robot đánh giá môi trường và hành động trong đó. VLA được huấn luyện trên chuỗi hình ảnh hoặc video liên quan đến việc thực hiện một nhiệm vụ, cùng dữ liệu về cách tay robot di chuyển. Dữ liệu chuyển động này thường được thu thập qua điều khiển từ xa, trong đó con người dùng thiết bị điều khiển để dẫn dắt robot thực hiện hành động.
Đặt một robot được trang bị VLA trước bàn làm việc và yêu cầu nó "đóng laptop" hay "cuộn dây tai nghe", nó sẽ khảo sát hiện trường, xác định vật thể liên quan, lập kế hoạch thực hiện rồi đưa tay vào hành động - tất nhiên là nếu nó đã từng thấy nhiệm vụ này được thực hiện.
Tuy nhiên, có một hạn chế rõ ràng: nếu robot được điều khiển bởi VLA được yêu cầu thực hiện nhiệm vụ nằm ngoài tập huấn luyện, khả năng cao là nó sẽ thất bại. Edward Johns, giáo sư robotics tại Imperial College London, nhận xét: "Nghĩ về không gian của mọi nhiệm vụ, một chính sách đa dụng thực sự sẽ có thể làm mọi thứ trong phổ đó. Nhưng hiện nay, một mô hình Gemini Robotics chỉ có thể làm vài việc ở đây và vài việc ở kia."
Bài toán dữ liệu
Vậy làm sao để robot có thể làm được nhiều thứ hơn? Câu trả lời thông thường khá dễ đoán: huấn luyện chúng trên nhiều dữ liệu hơn. Càng nhiều dữ liệu nghĩa là càng nhiều ví dụ, và càng nhiều ví dụ nghĩa là càng đa dụng.
Google DeepMind muốn thu thập "càng nhiều dữ liệu càng tốt", theo Pannag Sanketi, cựu trưởng nhóm kỹ thuật robotics của công ty. Nhưng lấy dữ liệu từ đâu? Các mô hình ngôn ngữ lớn có lợi thế là biển văn bản sẵn có để huấn luyện, nhưng không có kho dữ liệu tương ứng gồm các màn trình diễn vật lý chất lượng cao để huấn luyện robot.
Các nhà nghiên cứu có vài cách bù đắp nhưng đều có điểm yếu. Một là thuê số lượng lớn người tạo và thu thập dữ liệu điều khiển từ xa - tốn kém và mất thời gian. Hai là huấn luyện VLA trên video người thực hiện hoạt động - chất lượng dữ liệu kém. Ba là triển khai robot ngoài thực tế và dùng dữ liệu thu được để tinh chỉnh mô hình AI - robot chưa an toàn và đáng tin cậy ngoài phòng thí nghiệm.
Nhưng niềm tin rằng chỉ dữ liệu huấn luyện là câu trả lời không hề phổ biến. Hurst của Agility gọi đó là "một tiền đề sai lầm về cơ bản". Vấn đề là các nhiệm vụ trong thế giới thực nhanh chóng bùng nổ về độ phức tạp. Nếu bạn muốn pha cà phê, có vô số biến số: không hai căn bếp nào giống nhau; máy pha cà phê hoạt động theo nhiều cách khác nhau; các loại cốc đòi hỏi cách cầm khác nhau; bã cà phê, nước nóng và sữa đều cần xử lý khác nhau.
LeCun thì bác bỏ toàn bộ cách tiếp cận này: "Các phương pháp AI đã thành công với ngôn ngữ không hoạt động với dữ liệu đa chiều, liên tục và nhiễu" - kiểu dữ liệu phổ biến trong robotics. "Bạn phải dùng thứ khác."
Mô hình thế giới: Con đường mới?
Ứng viên hàng đầu cho "thứ khác" đó là cái được gọi là mô hình thế giới (world model) - một dạng AI được huấn luyện không chỉ trên văn bản mà trên sự kết hợp của video, bản quét ba chiều và dữ liệu cảm biến, được xây dựng để dự đoán kết quả của hành động trong thế giới thực. Mục tiêu là tạo ra các mô hình có biểu diễn nội tại về thực tại đủ chính xác để nắm bắt cách thế giới vật lý vận hành - cách vật thể di chuyển, va chạm, rơi và biến dạng.
Các công ty như Nvidia và Google đang nghiên cứu công nghệ này, và dòng vốn đầu tư đang đổ vào những startup nổi bật. World Labs, do nhà nghiên cứu AI Stanford Fei-Fei Li đồng sáng lập, đã gọi được 1 tỷ USD vào tháng Hai và được AMD mua lại vào cuối tháng Chín với giá 8,2 tỷ USD. AMI Labs, do LeCun đồng sáng lập, cũng gọi được 1 tỷ USD vào tháng Ba.
Tuy nhiên, theo chính lời thừa nhận của họ, mọi thứ vẫn còn ở giai đoạn sơ khai. Cuối năm ngoái, bà Li mô tả lĩnh vực này là "non trẻ", đồng thời cho biết "các phương pháp nền tảng vẫn đang được thiết lập". Hiện tại, mô hình thế giới là một hướng nghiên cứu đầy hứa hẹn chứ chưa phải con đường trực tiếp dẫn đến robotics đa dụng.
Bước đột phá nhỏ ở San Francisco
Tại trung tâm khu Mission ở San Francisco, startup Physical Intelligence đang tập trung phát triển một bộ não phổ quát có thể về mặt lý thuyết biến bất kỳ robot nào thành máy đa dụng. Năm 2024, công ty công bố hệ thống robotics đa dụng đầu tiên mang tên π0, một VLA mà họ khẳng định là "chính sách robot đa dụng có năng lực và độ khéo léo cao nhất tính đến thời điểm đó".
Mỗi bản cập nhật đều mang lại cải thiện quan trọng. Từ việc gấp quần áo chậm chạp đến cất đồ trong môi trường mới, rồi hoàn thành các nhiệm vụ như gấp hộp với tỷ lệ thành công cao hơn. Đến tháng Tư năm 2026, phiên bản π0.7 dường như đưa Physical Intelligence sang lãnh thổ mới khi sử dụng một mô hình thế giới nhẹ tạo ra hình ảnh về các bước cần thiết để thực hiện nhiệm vụ.
Công ty tuyên bố mô hình này thể hiện những dấu hiệu đầu tiên của "tổng quát hóa tổ hợp" - thuật ngữ chỉ khả năng hệ thống AI thực hiện kỹ năng chưa từng được tiếp xúc bằng cách tái tổ hợp những kỹ năng đã học trong dữ liệu huấn luyện. Một thử nghiệm yêu cầu mô hình "cho khoai lang vào nồi chiên không dầu" - nhiệm vụ chưa từng gặp trước đây. Trong video trình diễn, máy loay hoay một chút, khởi đầu vài lần sai, và cuối cùng cũng xoay xở được một cách tạm ổn, dù không hoàn thành trọn vẹn nhiệm vụ.
Sergey Levine, giáo sư Đại học California, Berkeley, đồng sáng lập PI, tỏ ra hào hứng: "Đây thực sự là lần đầu tiên chúng ta thấy một cách thuyết phục kiểu tổng quát hóa tổ hợp đó, nơi chúng ta có thể yêu cầu mô hình làm những nhiệm vụ mà chúng ta không thu thập dữ liệu cụ thể để huấn luyện, và nó sẽ thực sự thực hiện một nỗ lực tạm chấp nhận được."
Sau khi tìm hiểu, nhóm phát hiện những mẩu dữ liệu điều khiển từ xa có nhãn liên quan ẩn trong tài liệu huấn luyện, gồm hai ví dụ về người điều khiển dùng robot đẩy giỏ chiên vào nồi. Những mảnh dữ liệu đó có thể đã đủ để π0.7 gần như chiên được khoai lang.
"Thành công 70% nghĩa là nó không hoạt động"
Bạn có thể đang cảm nhận sự chênh lệch giữa những bước tiến chập chững trong phòng thí nghiệm - "Nhìn kìa! Nó cho khoai lang vào nồi chiên không dầu!" - và sự uyển chuyển sống động, đầy choáng ngợp trong nhiều màn trình diễn, nơi robot nhảy múa trên sân khấu hay lịch sự phục vụ đồ uống.
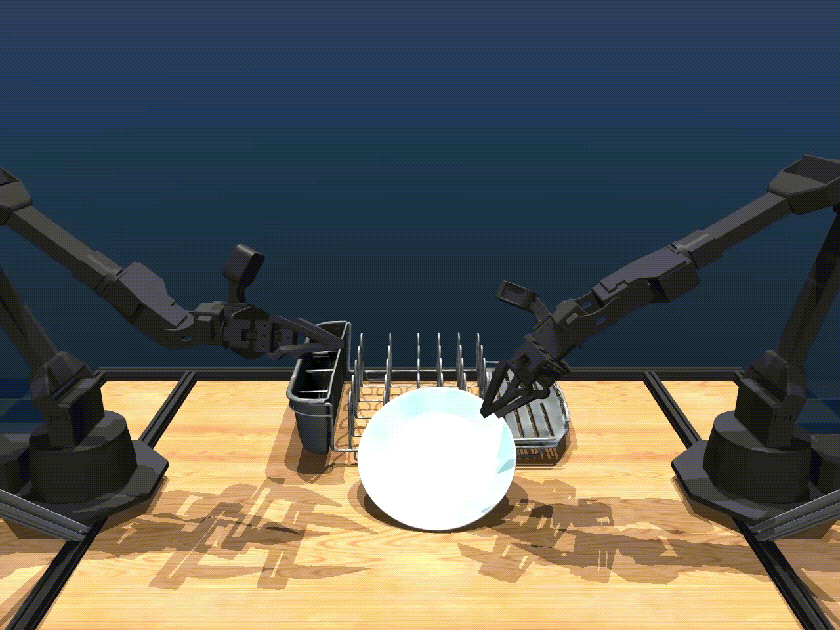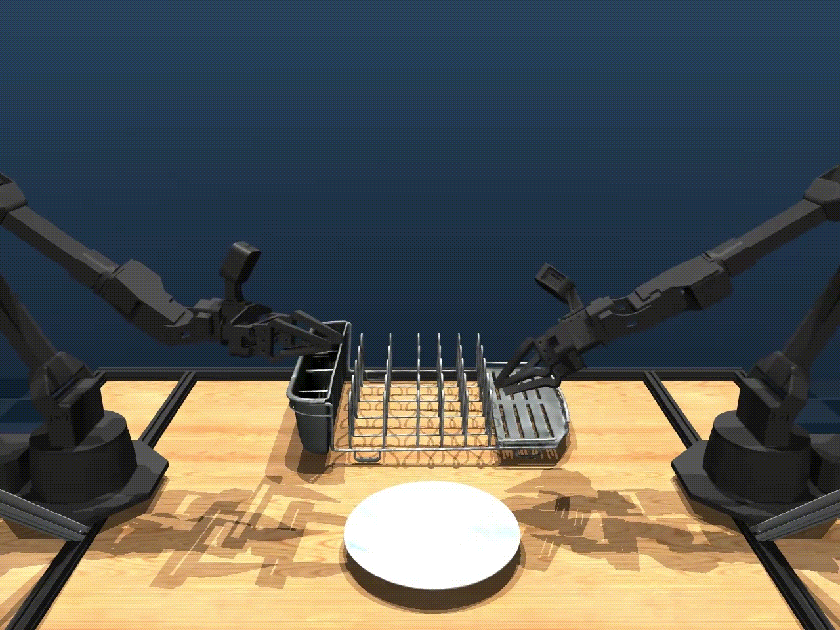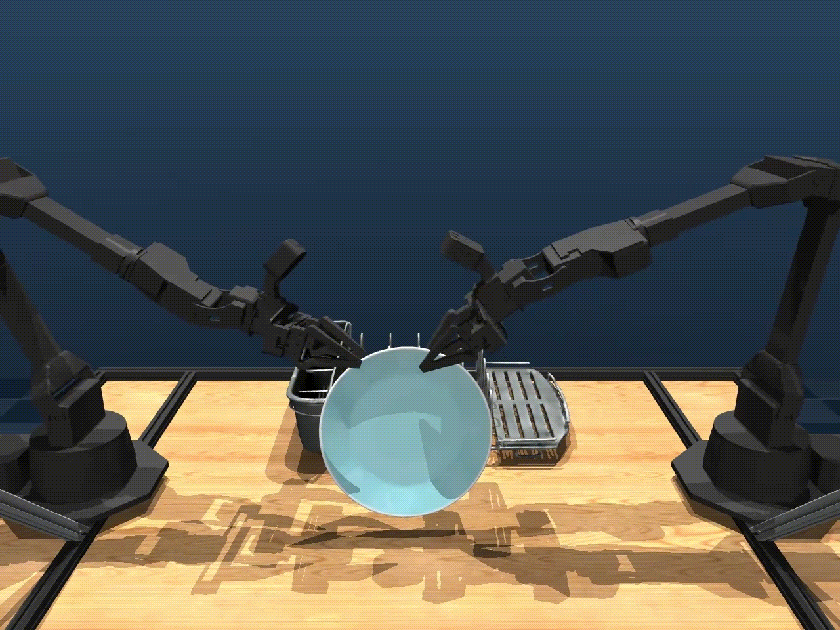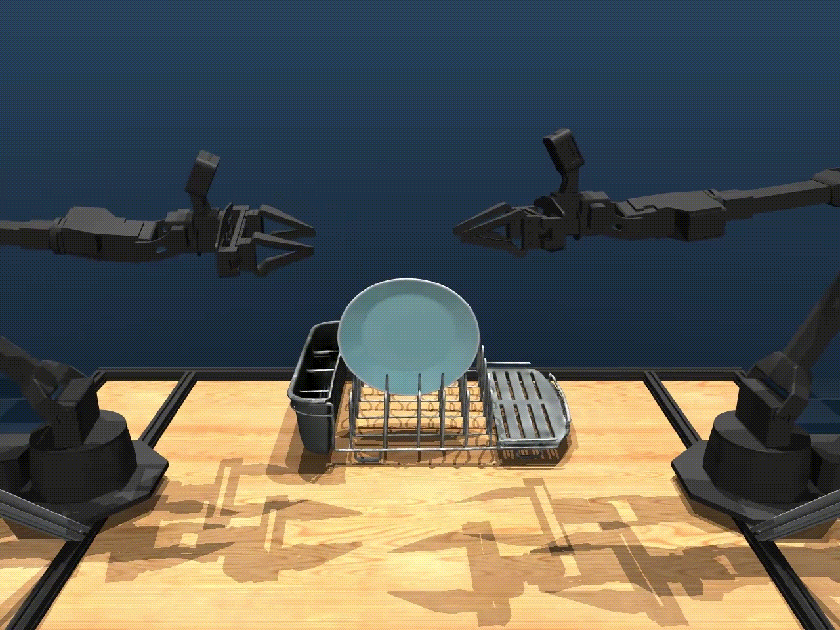 Robot trong môi trường nhà bếp và sinh hoạt
Các buổi trình diễn đó thường không tiết lộ rõ một sự thật quan trọng: trong nhiều trường hợp, con người đang điều khiển robot hoặc đã lập trình sẵn các hành động của nó. Robot xuất hiện trên sân khấu cùng CEO Nvidia Jensen Huang hồi tháng Ba năm 2025, tưởng như phản hồi chỉ dẫn và đi theo ông, thực chất được điều khiển từ xa bởi cái mà nhà sản xuất gọi là "một người điều khiển rối phía sau hậu trường".
Hiện tại, lập kế hoạch chuyển động hoàn toàn tự động để robot biết nên đi đâu - đặc biệt trong môi trường mới, hỗn loạn như công trường hay ngôi nhà xa lạ - vẫn là thách thức chưa được giải quyết. Thách thức lớn hơn nữa là khiến robot xử lý các công việc lớn hơn, mơ hồ hơn gồm nhiều nhiệm vụ và đòi hỏi quyết định về cách thức, thứ tự thực hiện. Đó là khác biệt giữa robot có thể đặt đĩa vào lò vi sóng và robot có thể phản hồi lệnh "Nấu bữa tối" bằng cách khám phá tủ lạnh, cắt nguyên liệu và bật bếp.
Thêm vào đó, một robot thực dụng về cơ bản phải làm đúng mọi lần. Marc Raibert, nhà sáng lập Boston Dynamics, nói: "Với VLA, người ta rất phấn khích khi kết quả tăng từ 50% thành công lên 70%. Nhưng thành công 70% thì giống như nó không hoạt động, đúng không?"
Số ít robot hình người đang được thử nghiệm trong môi trường thực tế chỉ đảm nhận những nhiệm vụ cực kỳ hạn chế trong không gian được kiểm soát chặt chẽ. Agility đã triển khai hàng trăm robot trong các thử nghiệm tại cơ sở của GXO Logistics, Amazon và Schaeffler, nhưng theo Hurst, hiện tại chúng chỉ nhắm đến các nhiệm vụ đơn giản như di chuyển thùng và hộp.
Elon Musk tuyên bố hồi tháng Năm năm 2025 rằng "hàng nghìn" robot Optimus sẽ làm việc tại nhà máy Tesla vào cuối năm, nhưng đến tháng Một năm nay, ông nói công ty chỉ có "một số robot Optimus đang làm nhiệm vụ đơn giản trong nhà máy".
Chặng đường còn rất dài phía trước
Việc chuyển từ nhà máy sang hộ gia đình sẽ còn khó khăn hơn nữa. Hiện tại, bạn có thể đặt trước robot gia đình 1X Neo, dự kiến giao hàng vào cuối năm nay với giá 20.000 USD. Nó hứa hẹn đảm nhận "những công việc nhàm chán và tầm thường quanh nhà" - cất bát đĩa, mở cửa, dọn phòng khách. Nhưng hiện tại, để làm hầu hết mọi việc, robot cần một người vận hành từ xa. Khi được hỏi bao lâu nữa robot hoàn toàn tự động mới sẵn sàng cho công việc nội trợ, Hurst trả lời: "Nếu phải chọn một con số, tôi sẽ nói 10 năm nữa trước khi robot thực sự làm được những việc hữu ích trong nhà mọi người."
Khi điều đó xảy ra, robot có thể sẽ đến từ Trung Quốc, vì quốc gia này đang dẫn trước phương Tây về sản xuất. Gần 90% trong khoảng 15.000 robot hình người được xuất xưởng năm 2025 là do các công ty Trung Quốc sản xuất, theo công ty phân tích thị trường Omdia và hãng robotics Trung Quốc Unitree. Một mẫu do Unitree sản xuất có giá dưới 6.000 USD - mức giá phải chăng có thể giúp robot trở nên hấp dẫn hơn nhiều với người tiêu dùng.
Giấc mơ chế tạo robot hình người đã có từ rất lâu. Từ năm 1495, Leonardo da Vinci đã phác thảo thiết kế cho một hiệp sĩ cơ khí điều khiển bằng dây cáp và ròng rọc. Xuyên suốt thế kỷ 20, những cỗ máy của giấc mơ khoa học viễn tưởng đã đến rồi đi. Elektro của Westinghouse gây chấn động tại Hội chợ Thế giới năm 1939. WABOT-1 của Đại học Waseda năm 1973 là robot hình người lập trình được đầu tiên với quy mô đầy đủ. ASIMO của Honda ra mắt năm 2000 có lẽ là cỗ máy đầu tiên chứng tỏ được chút năng lực - nó có thể leo bậc thang, nhận diện khuôn mặt và tự di chuyển qua không gian. Nhưng robot này đã bị ngừng sản xuất năm 2018, không thể tiến xa đủ để trở nên hữu ích ngoài các buổi trình diễn.
Tất cả đều từng là những kỳ tích kỹ thuật đáng kinh ngạc vào thời điểm của chúng. Nhưng không cỗ máy nào sẵn sàng định hướng thế giới thực. Robot ngày nay, ngay cả với sức mạnh biến đổi của AI tiên tiến, vẫn đối mặt với thách thức hiện hữu tương tự.