
Dấu chân vô hình của AI: Đo lường tác động môi trường khi chúng ta không còn tự huấn luyện mô hình
Khi các kỹ sư AI chuyển từ tự xây dựng mô hình sang gọi API và vận hành agent, dấu chân môi trường của công việc cũng dịch chuyển sang những trung tâm dữ liệu mà ta không nhìn thấy. Bài viết phân tích cách đo lường năng lượng, khí thải carbon và lượng nước tiêu thụ bằng các công cụ miễn phí như EcoLogits, CodeCarbon và Green Algorithms.
Dấu chân vô hình của AI: đo lường tác động môi trường khi bạn không còn tự huấn luyện mô hình
Vài năm trước, việc đo lượng điện tiêu thụ và khí thải CO2 của một dự án machine learning chỉ cần thêm vài dòng CodeCarbon vào code. Ngày nay, khi phần lớn kỹ sư AI gọi API thay vì tự huấn luyện mô hình, dấu chân môi trường vẫn tồn tại — nhưng nằm ở những nơi ta không thể nhìn thấy. Bài viết dưới đây trình bày một phương pháp thực tế để đo lường cả phần bạn kiểm soát lẫn phần nhà cung cấp vận hành.
Khi vai trò của kỹ sư AI đã thay đổi
Cách đây vài năm, một kỹ sư data science thường tự chọn dữ liệu, tự huấn luyện mô hình và tự triển khai trên phần cứng mình hiểu rõ. Trong khoảng hai năm trở lại đây, bức tranh đã khác hẳn: nhiều người trong chúng ta trở thành người dùng hệ thống AI thay vì người xây dựng mô hình. Ta gọi API, nối chuỗi prompt, gắn agent vào các công cụ, hoặc bật một tính năng AI do người khác phát triển.
Hệ quả là phép tính diễn ra trên những cỗ máy ta chưa từng thấy, trong những trung tâm dữ liệu không có tên trong hợp đồng, với các mô hình mà kích thước thường là bí mật thương mại. Dấu chân môi trường không biến mất — nó chỉ dịch chuyển sang nơi ta không còn quyền truy cập.
 Minh họa dấu chân AI trong trung tâm dữ liệu
Tác động môi trường của AI gồm những gì?
Thảo luận về AI thường chỉ xoay quanh carbon, nhưng thực tế có năm tác động chính:
- Năng lượng: điện năng tiêu thụ, tính bằng Wh hoặc kWh.
- Khí thải nhà kính: tính bằng gam hoặc kg CO2 tương đương (CO2e), phụ thuộc vào cách sản xuất điện. Cùng một lượng điện, phát thải từ than cao hơn hẳn so với điện hạt nhân hoặc điện gió.
- Nước: dùng để làm mát trung tâm dữ liệu (qua bay hơi) và cả để sản xuất điện.
- Vật liệu: kim loại và khoáng sản khai thác để chế tạo chip, máy chủ, thiết bị mạng.
- Rác thải điện tử: số phận của phần cứng khi bị thay thế.
Phân tích đầy đủ tất cả các giai đoạn — từ sản xuất, sử dụng đến hết vòng đời — được gọi là đánh giá vòng đời (LCA). Bài viết này chỉ tập trung vào giai đoạn sử dụng, tức điện năng tiêu thụ khi AI chạy, cùng khí thải và nước phát sinh. Lý do rất thực tế: đây là phần mà kỹ sư AI có thể tác động trực tiếp.
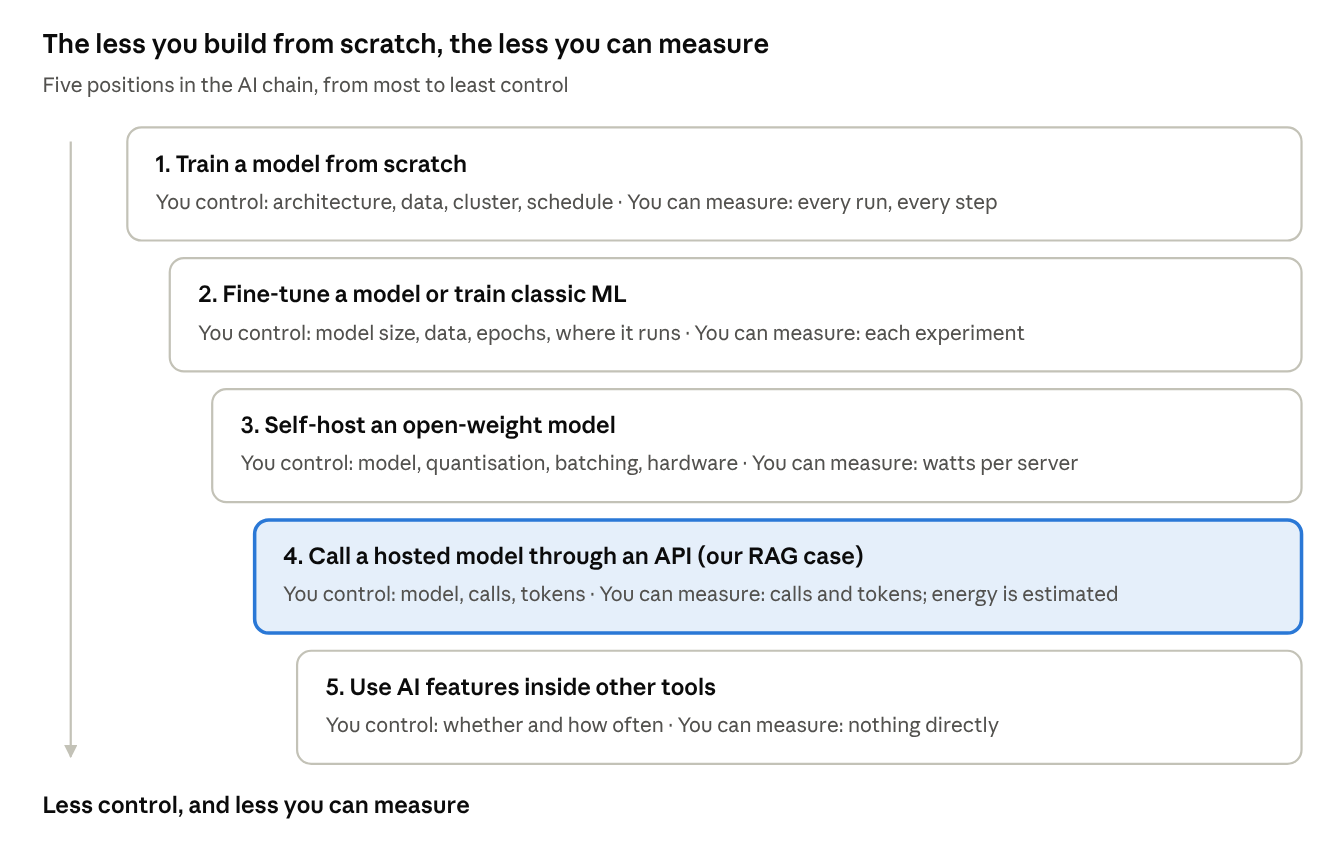
Vì sao càng ít tự xây, càng khó đo?
Có thể chia vai trò của kỹ sư AI thành năm cấp độ, từ kiểm soát nhiều nhất đến ít nhất. Ở cấp 1, bạn sở hữu toàn bộ máy móc nên đo được từng watt. Ở cấp 4 — nơi nhiều đội ngũ hiện nay đứng — phần tính toán quan trọng nhất diễn ra trên máy chủ của nhà cung cấp LLM. Logic rất đơn giản: càng ít tự xây từ đầu, càng khó đo tác động môi trường.
Cách Google tính con số 0,24 Wh cho một prompt
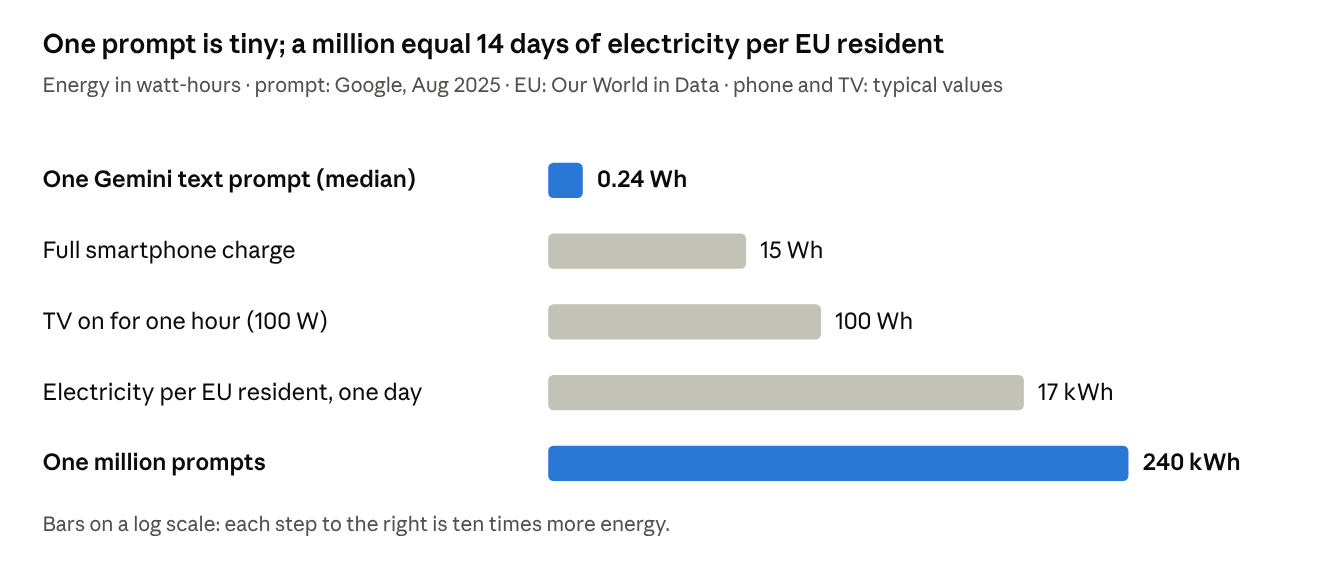
Tháng 8/2025, Google công bố phương pháp và kết quả cho một prompt văn bản gửi tới Gemini. Theo họ, một prompt trung vị tiêu thụ 0,24 Wh điện, phát thải 0,03 g CO2e và dùng 0,26 mL nước.
Con số này lớn hay nhỏ? Một watt-giờ là điện năng thiết bị 1 watt dùng trong một giờ; hóa đơn điện tính bằng kWh, tức 1.000 Wh. Một prompt chiếm chưa tới 2% dung lượng pin điện thoại. Nhưng một dự án không bao giờ chỉ có một prompt: một triệu prompt ở mức 0,24 Wh là 240 kWh, tương đương khoảng 14 ngày điện tiêu thụ bình quân của một người dân EU. Một trợ lý trả lời 30.000 câu hỏi mỗi ngày sẽ chạm mốc một triệu chỉ trong khoảng một tháng.
Để ra con số đó, Google tính bốn thành phần:
- Chip AI: TPU của Google (hoặc GPU) xử lý phép toán của mô hình, đọc prompt và sinh câu trả lời từng từ một.
- Phần còn lại của máy chủ và các máy chờ: CPU, RAM, cùng các máy chủ để không tải chờ đợi đề phòng lưu lượng tăng đột biến — điện năng của chúng được chia đều cho mọi prompt.
- Bản thân tòa nhà trung tâm dữ liệu: làm mát, biến áp, phân phối điện, thể hiện qua chỉ số PUE. Trung tâm dữ liệu của Google có PUE trung bình 1,09, nghĩa là mỗi 1 Wh máy chủ dùng tốn thêm 0,09 Wh cho tòa nhà.
- Quy đổi từ điện sang carbon và nước: nhân điện năng với cường độ carbon của lưới điện nơi đặt trung tâm dữ liệu. Cùng 0,24 Wh nhưng phát thải rất khác nhau giữa một nước dùng thủy điện, hạt nhân, điện gió và một nước chạy than hay khí đốt. Với hỗn hợp điện của Google, kết quả là 0,03 g CO2e.
Cần lưu ý: theo DatacenterDynamics, phạm vi tính toán này loại trừ mạng truyền tải, thiết bị người dùng, quá trình huấn luyện mô hình và lưu trữ dữ liệu. Google cũng thừa nhận các con số chưa được bên thứ ba độc lập kiểm chứng.
Từ con số của Google đến dự án của bạn
Con số 0,24 Wh mô tả một câu hỏi chat trung vị gửi tới Gemini. Mô hình, prompt và trung tâm dữ liệu trong dự án của bạn đều khác, nên không thể dùng lại nguyên xi. Thứ có thể tái sử dụng là phương pháp — và bạn không phải làm thủ công. Hai công cụ miễn phí làm việc đó thay bạn:
- EcoLogits: áp dụng các bước trên cho máy chủ nhà cung cấp, trả về con số ước tính cho mỗi lần gọi API theo đúng mô hình bạn dùng.
- CodeCarbon: áp dụng quy trình tương tự cho máy chủ của chính bạn, kể cả thời gian máy ngồi chờ.
Ba khái niệm bạn sẽ gặp trong cấu hình và kết quả của hai công cụ này:
- Idle: thời gian máy bật nhưng không làm việc hữu ích.
- PUE: hệ số tiêu hao phụ của trung tâm dữ liệu. Google là 1,09; phần lớn trung tâm dữ liệu khác cao hơn. Trong CodeCarbon, đây là tham số bạn phải tự đặt.
- Cường độ carbon (hay hệ số lưới điện): số gam CO2e phát thải cho mỗi kWh điện tại nơi máy chạy. Con số này chênh lệch vài lần giữa các quốc gia, và cả hai công cụ đều tự tra cứu giúp bạn.
 Sơ đồ các lớp đo lường dấu chân AI
Ranh giới: ai đo gì, ai không đo gì
Với một lần gọi của ứng dụng AI, bức tranh được chia thành ba vùng rõ rệt:
- Vùng của bạn (đo bằng CodeCarbon): máy chủ API, cơ sở dữ liệu vector, phần tính embedding, các lần thử lại, log và các job đánh giá. Không nhà cung cấp nào tính hộ bạn phần này.
- Vùng của nhà cung cấp: chính các lớp tính toán trên máy chủ của họ. Bạn chỉ trả tiền qua hóa đơn API hoặc gói thuê bao, nhưng chúng tồn tại vì ứng dụng của bạn gửi yêu cầu — nên vẫn thuộc dấu chân dự án.
- Vùng không ai tính: phần cứng, quá trình huấn luyện mô hình và mạng truyền tải, vì chúng được chia sẻ cho nhiều mục đích khác nhau.
Một cảnh báo quan trọng: prompt của bạn không phải prompt trung vị. Một lần gọi của trợ lý RAG gửi kèm câu hỏi và nhiều đoạn văn bản truy xuất được, thường hàng nghìn từ mà mô hình phải đọc trước khi viết chữ đầu tiên. Càng nhiều chữ phải đọc, chip càng tốn điện. Các mô hình suy luận và agent còn đẩy con số lên xa hơn: báo cáo tháng 4/2026 của IEA cho biết tác vụ suy luận, agent và tạo video có thể tốn năng lượng gấp hàng trăm đến hàng nghìn lần một câu trả lời văn bản đơn giản.
Trường hợp thực tế: trợ lý RAG trên mô hình thuê ngoài
Hãy lấy một kịch bản quen thuộc: đội ngũ của bạn xây trợ lý nội bộ trả lời câu hỏi dựa trên tài liệu của công ty bằng hệ thống RAG (Retrieval-Augmented Generation). Mỗi câu hỏi diễn ra theo bốn bước: máy chủ nhận câu hỏi, chuyển thành embedding và tìm các đoạn liên quan trong cơ sở dữ liệu vector, gửi câu hỏi kèm các đoạn đó tới LLM qua API, rồi LLM viết câu trả lời và máy chủ gửi lại cho người dùng.
Bước 1, 2 và 4 nằm trên hạ tầng bạn kiểm soát. Bước 3 diễn ra hoàn toàn bên nhà cung cấp — mô hình không hề được chuyển về máy bạn. Đây cũng là điểm đáng lưu tâm về quản trị dữ liệu: không phải doanh nghiệp nào cũng chấp nhận để tài liệu nội bộ rời khỏi hạ tầng mỗi lần có truy vấn, nên một số đơn vị chọn tự vận hành mô hình open-weights.
Quy trình ước tính gồm năm bước
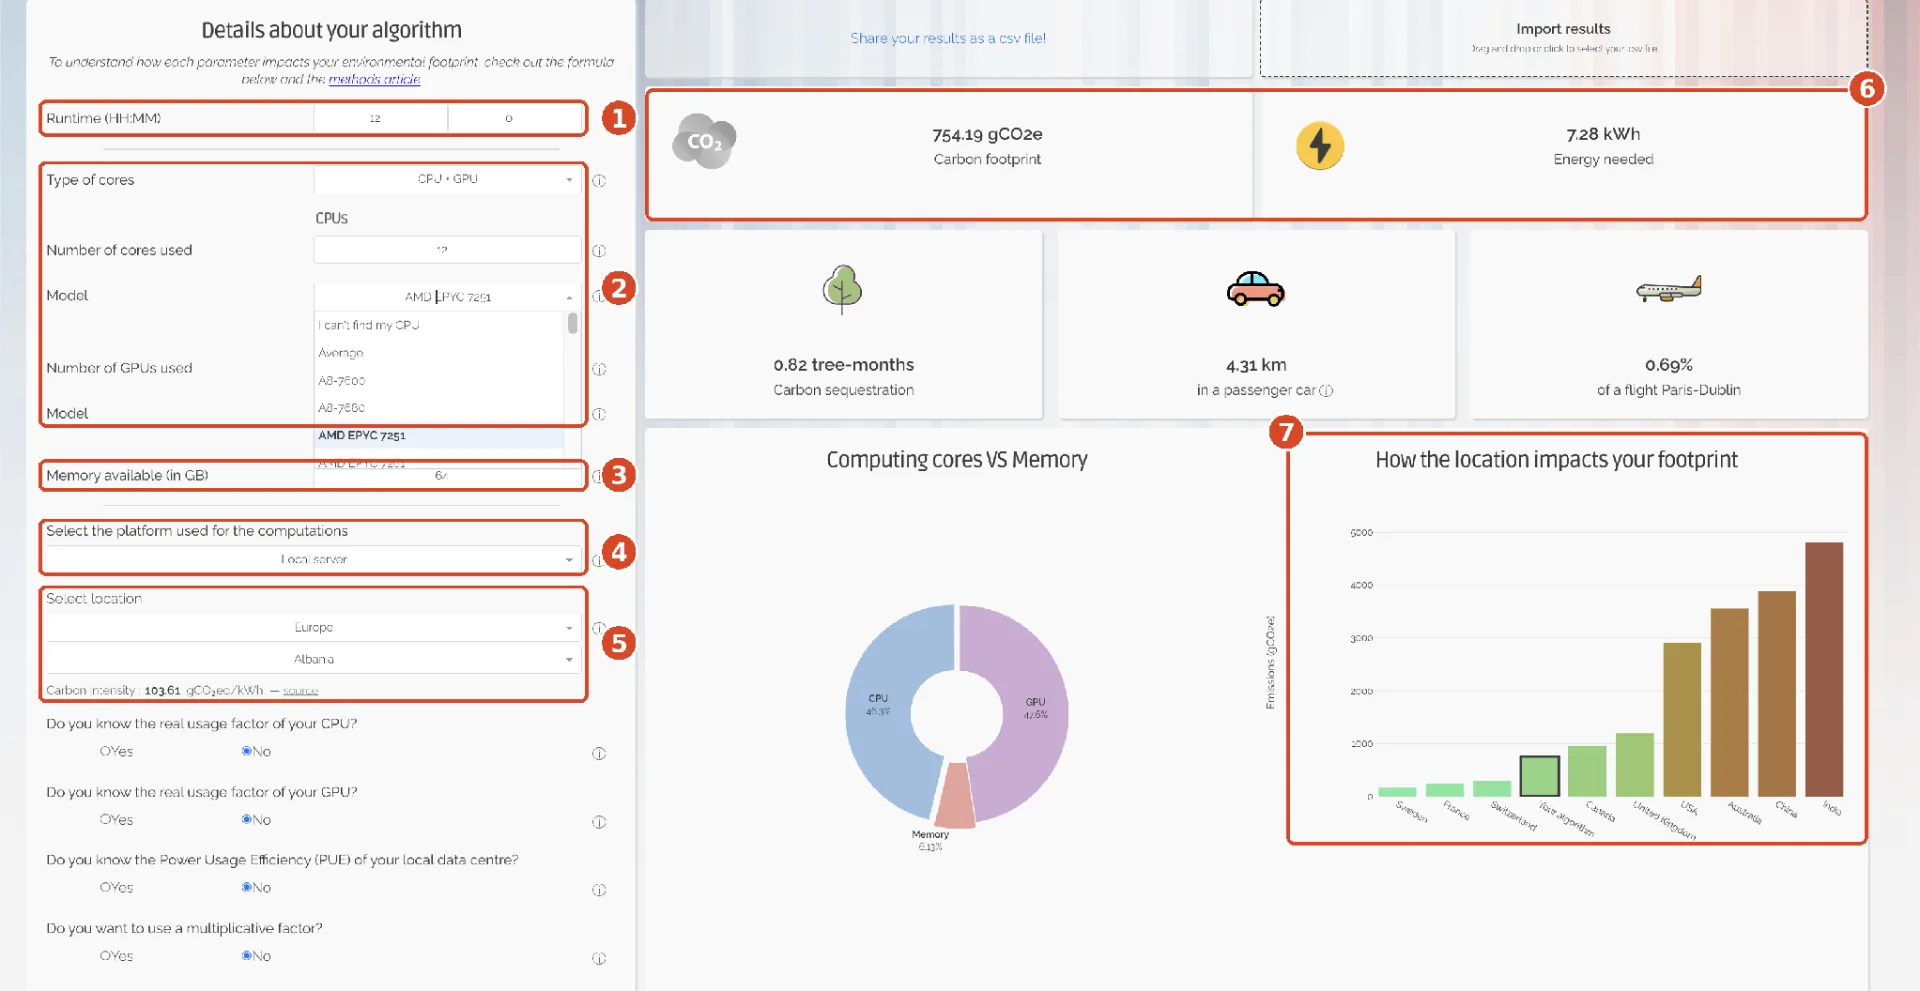
Bước 1 — Nhìn tổng thể trước khi xây, với Green Algorithms. Phần năng lượng rẻ nhất là phần tính toán bạn quyết định không chạy. Công cụ tính toán miễn phí của Đại học Cambridge này cho bạn một bậc độ lớn mà không cần cài đặt hay viết code: nhập thời gian chạy, phần cứng (CPU, GPU, số lượng), dung lượng bộ nhớ, nền tảng (máy cá nhân, máy chủ nội bộ hay cloud) để suy ra PUE, và quốc gia để suy ra cường độ carbon. Kết quả là điện năng và lượng CO2e kèm quy đổi trực quan. Trong dự án RAG, công cụ này hợp nhất với bước đánh chỉ mục (indexing) — chuyển toàn bộ tài liệu thành embedding và nạp vào cơ sở dữ liệu vector — để biết trước chi phí là vài kWh hay vài trăm kWh. Green Algorithms không bao gồm các lần gọi LLM.
Bước 2 — Đếm những gì bạn sẽ gửi. Giả sử trợ lý nhận 2.000 câu hỏi mỗi ngày, mỗi câu trả lời khoảng 300 token, mỗi lần gọi mất khoảng 6 giây. Ba con số này là đủ cho bước tiếp theo.
Bước 3 — Ước tính phía LLM bằng EcoLogits. Thay vì dùng con số 0,24 Wh vốn mô tả một mô hình khác, ta hỏi EcoLogits về con số phù hợp với dự án của mình:
from ecologits.tracers.utils import llm_impacts

for model in ["gpt-4o-mini", "gpt-4o"]:
    impacts = llm_impacts(
        provider="openai",
        model_name=model,
        output_token_count=300,  # độ dài một câu trả lời RAG
        request_latency=6.0,     # số giây của lần gọi
    )
    e = impacts.energy.value     # kWh, trả về dưới dạng khoảng
    g = impacts.gwp.value        # kgCO2eq, trả về dưới dạng khoảng
    print(f"{model}: {e} kWh, {g} kgCO2eq")
Bước 4 — Đo phía máy chủ bằng CodeCarbon. Chạy từ dòng lệnh:
codecarbon monitor --project-name rag-assistant --no-api
# nếu không có internet, thêm: --offline --country-iso-code VN
Công cụ ghi ra file emissions.csv với cột energy_consumed (kWh) và emissions (kgCO2e). Nếu muốn khởi động từ code, bọc máy chủ của bạn:
from codecarbon import EmissionsTracker

tracker = EmissionsTracker(
    project_name="rag-assistant",
    tracking_mode="machine",  # cả VM, không chỉ tiến trình này
    pue=1.2,                  # hệ số phụ của trung tâm dữ liệu cloud
)
tracker.start()
app.run()                     # máy chủ API của bạn
tracker.stop()
Con số 1,2 trong code là PUE, lấy theo cách tính của Google. CodeCarbon không tự đoán được và mặc định dùng 1,0, nên bạn phải tự đặt: hỏi nhà cung cấp cloud hoặc tra trong báo cáo phát triển bền vững của họ, hỏi đội vận hành nếu là máy chủ nội bộ, và giữ 1,0 nếu chạy trên laptop. Nếu không ai trả lời được, dùng giá trị Green Algorithms đề xuất cho nền tảng của bạn và ghi rõ đó là giả định.
Ví dụ máy của bạn trung bình hút 70 W: 70 W × 24 giờ × 1,2 (PUE) ≈ 2.000 Wh, tức khoảng 2 kWh mỗi ngày.
Bước 5 — Cộng hai phía và báo cáo. Có điện năng của cả hai bên, nhân với cường độ carbon tại nơi tiêu thụ — Mỹ cho máy chủ OpenAI, Việt Nam cho máy chủ của bạn — để ra khí thải. Với ví dụ trên (giả định cường độ carbon 300 gCO2e/kWh tại Việt Nam):
| Thành phần | Điện/ngày | Lưới điện | Carbon/ngày |
|---|---|---|---|
| Gọi LLM (EcoLogits) | 1,2 kWh | Mỹ, ~400 g/kWh | ~480 g |
| Máy chủ của bạn (CodeCarbon) | 2 kWh | Việt Nam, 300 g/kWh | 600 g |
| Tổng | 3,2 kWh | ~1,1 kg |
Một năm tương đương khoảng 400 kg CO2e. Nếu chuyển sang gpt-4o-mini, dòng đầu giảm còn 0,04 kWh và khoảng 16 g mỗi ngày — gần như toàn bộ tác động khi đó đến từ chính máy chủ của bạn.
Ba điểm đáng chú ý rút ra từ phép tính nhỏ này:
- Lựa chọn mô hình tạo khác biệt lớn nhất. Chuyển từ gpt-4o sang gpt-4o-mini giảm tác động phía nhà cung cấp khoảng 30 lần, với điều kiện mô hình nhỏ vẫn đáp ứng đủ yêu cầu.
- Phần bạn tự chạy cũng quan trọng không kém. Với mô hình nhỏ, việc để máy chủ bật suốt ngày chờ request tốn điện hơn nhiều so với chính các lần gọi LLM. Tắt máy ban đêm hoặc thu nhỏ về 0 khi không dùng có thể tạo khác biệt thực sự.
- Đây là ước tính, không phải chân lý tuyệt đối. Cần minh bạch về phần nào đã đo thực tế, phần nào chỉ ước tính và dùng công cụ nào.
 Bảng so sánh tác động giữa các phương án
Giới hạn cần biết trước khi triển khai thật
Phương pháp này có giới hạn của nó. Ta không thể tính được toàn bộ vòng đời phần cứng dùng nội bộ, và buộc phải tin vào con số mà nhà cung cấp công bố về hạ tầng của chính họ. Với phần lớn mô hình thuê ngoài, không ai bên ngoài biết chính xác kích thước mô hình hay mức tiêu thụ điện thực tế — đó là lý do EcoLogits trả về một khoảng giá trị thay vì một con số duy nhất.
Bên cạnh đó còn những câu hỏi quan trọng hơn cả con số: dữ liệu cá nhân được xử lý ra sao, và liệu có nên gửi dữ liệu RAG của công ty tới API LLM bên ngoài ngay từ đầu hay không. Với các doanh nghiệp Việt Nam đang trong giai đoạn số hóa và chịu áp lực ngày càng tăng về tuân thủ dữ liệu, đây là câu hỏi kiến trúc chứ không chỉ là câu hỏi kỹ thuật.
Năng lượng rẻ nhất là năng lượng ta quyết định không dùng, đơn giản vì ta có thể làm mọi thứ theo cách khác.
Kết luận
Ba năm trước, chỉ cần thêm hai dòng CodeCarbon là đo được tác động của mô hình. Hôm nay, khi dựa vào những mô hình thuê ngoài mà ta không bao giờ nhìn thấy, việc theo dõi dấu chân ấy khó hơn nhiều — nhưng không có nghĩa là hết lựa chọn. Các công cụ mã nguồn mở nêu trên đều miễn phí và đáng để đưa vào quy trình làm việc ngay từ bây giờ.
Trong kỷ nguyên của generative AI và agent, phần khó nhất không còn là lấy được con số, mà là quyết định làm gì với chúng — dùng chúng để xây chiến lược thông minh hơn, đạt hiệu năng cần thiết trong khi giữ tác động môi trường ở mức thấp nhất có thể.
Bài viết liên quan
Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
17 tháng 9, 2026
Công nghệ
George Hotz cảnh báo: Tương lai AI là hỗn loạn — và đó lại là kịch bản tốt nhất
02 tháng 11, 2026