Dấu thủy vân trên LLM có thể làm thay đổi hành vi của AI Agent
Nghiên cứu mới từ Lasso Security chỉ ra rằng việc nhúng dấu thủy vân (watermark) vào văn bản do mô hình ngôn ngữ lớn tạo ra có thể âm thầm thay đổi cách AI Agent gọi công cụ và mức độ từ chối các yêu cầu độc hại. Hiện tượng này, gọi là "sampling drift", đặc biệt nguy hiểm khi kết hợp với prompt injection, và có thể phá vỡ các lớp bảo vệ an toàn mà nhà phát triển agent vẫn tin tưởng.
Dấu thủy vân trên LLM có thể làm thay đổi hành vi của AI Agent
Khi Anthropic công bố rằng các mô hình Claude trong tương lai sẽ nhúng một dấu thủy vân vô hình vào nội dung đầu ra, ít ai ngờ rằng kỹ thuật này — vốn sinh ra để minh bạch nguồn gốc nội dung — lại có thể tác động trực tiếp đến hành vi của các AI Agent. Một nghiên cứu mới từ Lasso Security đã chỉ ra rằng dấu thủy vân có thể làm thay đổi cả cách mô hình gọi công cụ lẫn mức độ từ chối các yêu cầu nguy hiểm.
Dấu thủy vân không chỉ để minh bạch
Dấu thủy vân văn bản giúp nhận diện nội dung do AI tạo ra. Theo Điều 50(2) của Đạo luật AI châu Âu (EU AI Act), các nhà cung cấp hệ thống AI tạo văn bản tổng hợp phải đánh dấu đầu ra theo định dạng máy đọc được và đảm bảo có thể phát hiện được nội dung do máy tạo ra. Yêu cầu này đẩy nhanh việc triển khai các giải pháp thủy vân quy mô lớn.
Anthropic gần đây xác nhận rằng cơ chế thủy vân của họ dựa trên SynthID-Text do Google DeepMind phát triển. Điểm đáng chú ý là thủy vân được áp dụng ở cấp độ mô hình, bao phủ cả các mô hình truy cập qua Claude Platform API lẫn các nhà cung cấp đám mây. Điều này đồng nghĩa với việc một nhà phát triển có thể nhận được đầu ra đã gắn thủy vân ngay cả khi agent họ xây dựng là một ứng dụng độc lập.
Minh họa tác động của dấu thủy vân LLM đối với an toàn và bảo mật của AI Agent
Sampling drift: khi thủy vân thay đổi quyết định
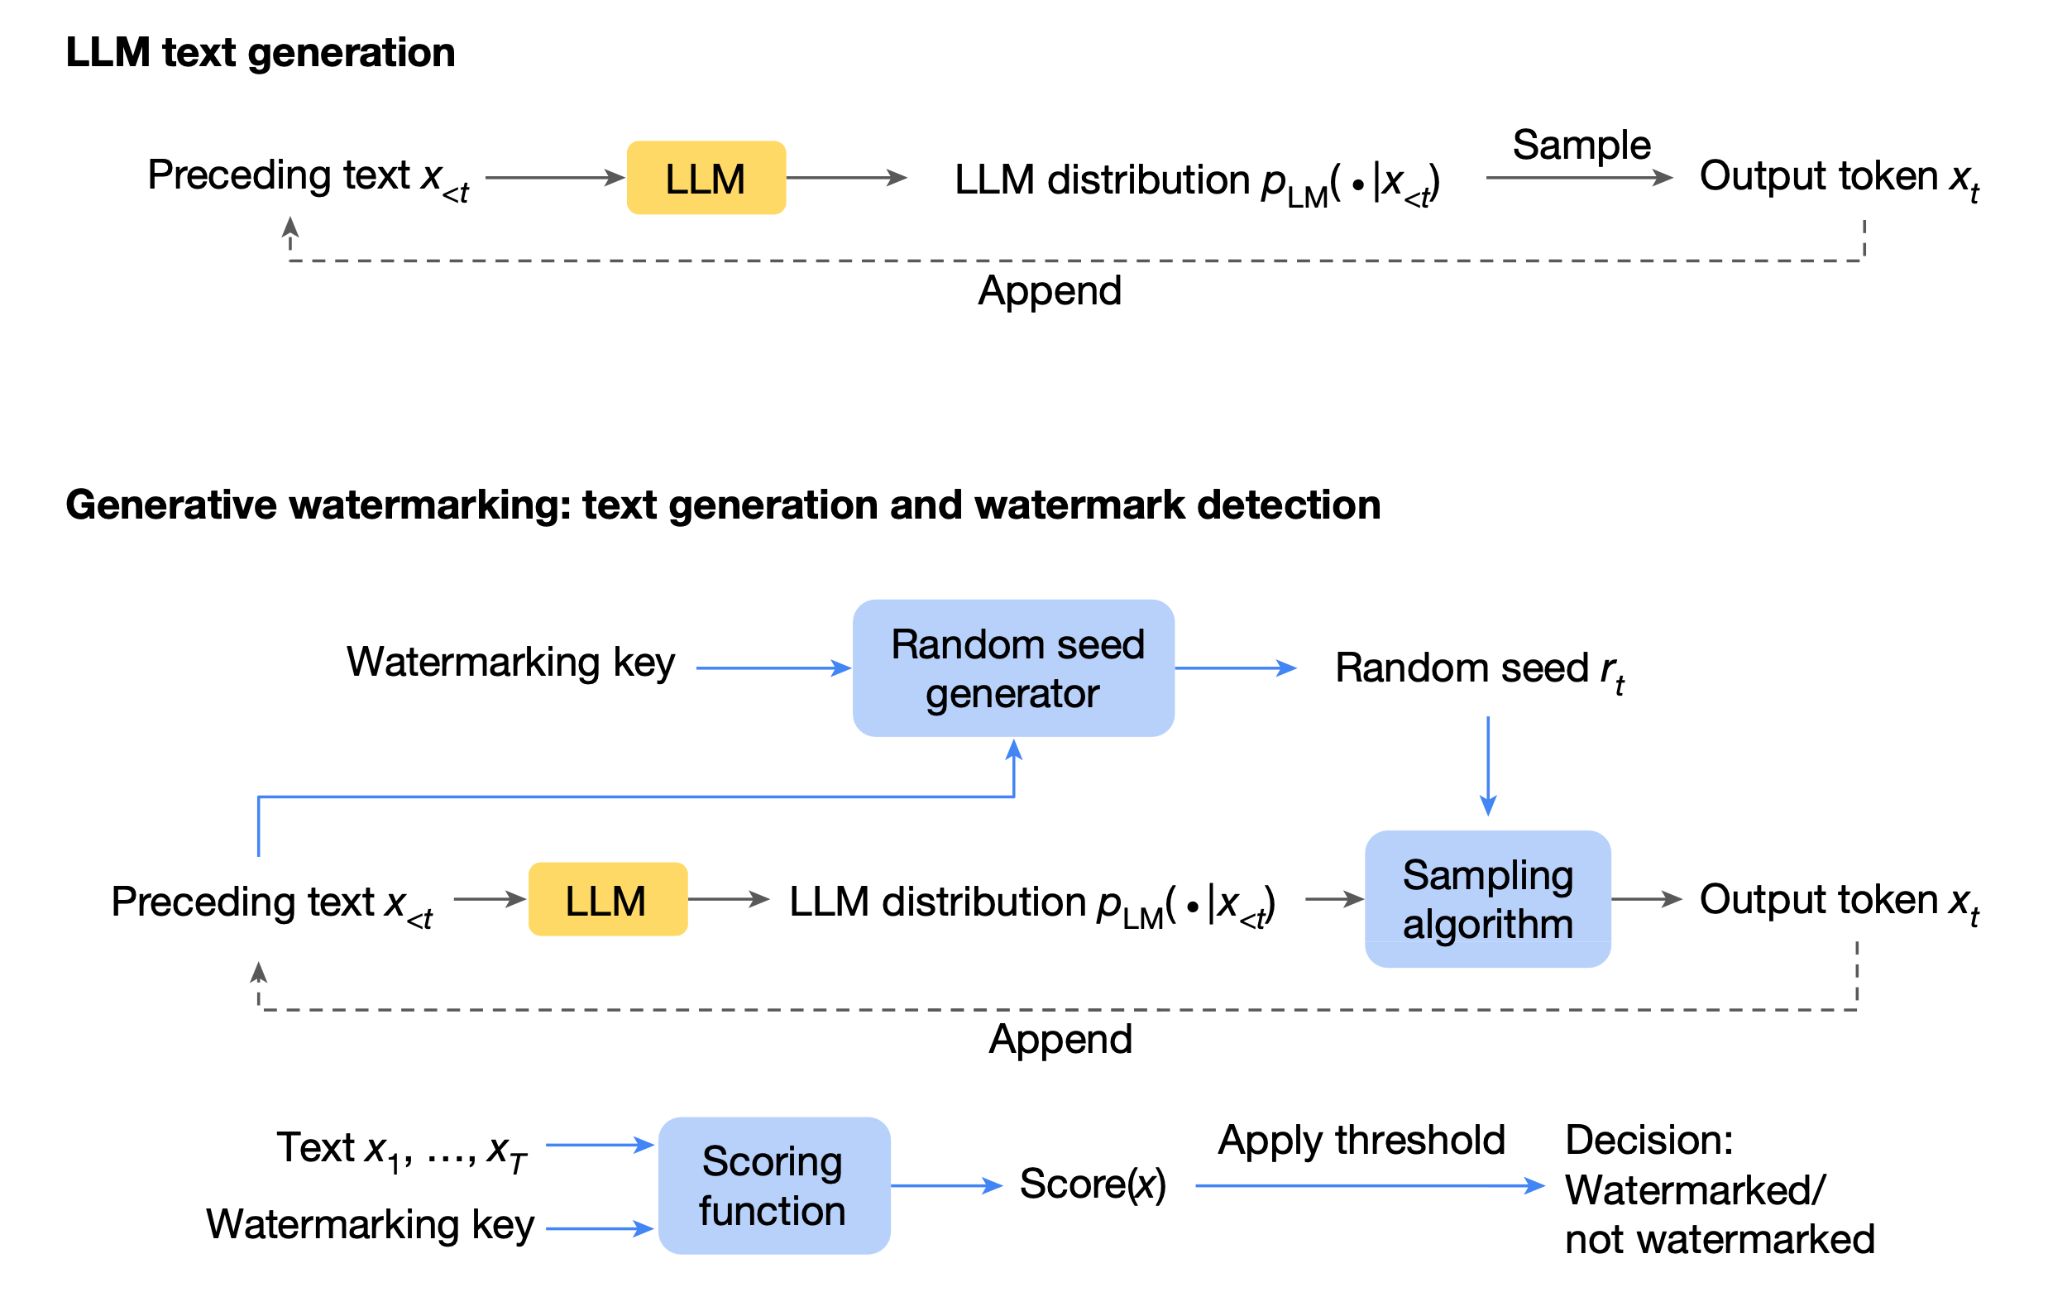
Thủy vân SynthID-Text tác động vào chính quá trình mô hình sinh từng token tiếp theo. Ở cấp độ mô hình, điều này có thể làm thay đổi hành vi an toàn — bao gồm việc mô hình có từ chối một yêu cầu độc hại hay không, và liệu sự từ chối đó có đứng vững trước prompt injection hay không. Ở cấp độ agent, chính những token được lấy mẫu đó lại quyết định công cụ nào được gọi và tham số nào được truyền vào.
Lasso Security gọi hiệu ứng hành vi này là sampling drift (trôi dạt lấy mẫu). Điều đáng lo ngại là dù nhà cung cấp khẳng định thủy vân không gây biến dạng (non-distortionary) — tức là phân phối token gốc được giữ nguyên về mặt kỳ vọng — điều đó không có nghĩa là hành vi giống hệt nhau với một khóa thủy vân cố định. Một khóa cụ thể vẫn có thể thay đổi việc chọn token trong quá trình sinh.
Trong các định dạng đầu ra có cấu trúc như JSON, dấu ngoặc, tên khóa và tên hàm thường rất dễ đoán, nhưng các giá trị như truy vấn, con số, đường dẫn hay người nhận thì khó đoán hơn nhiều. Một thay đổi mà trong văn xuôi thông thường chỉ là biến thể từ ngữ lại có thể làm thay đổi tham số mà agent thực thi.
Cách các nhà nghiên cứu đo lường
Nhóm nghiên cứu sử dụng thiết kế ghép cặp (paired design) cho hai thí nghiệm. Việc gọi công cụ được đánh giá trên BFCL v4 single-turn AST, còn hành vi từ chối được kiểm tra trên 200 hành vi độc hại của HarmBench cùng 100 mẫu kiểm soát lành tính từ JailbreakBench, với các yêu cầu độc hại được thử ở dạng trần và dưới một kỹ thuật prompt injection cố định.
Mỗi mục được sinh cả có lẫn không có SynthID từ cùng một seed, cùng thành phần batch và thứ tự ở mỗi mức nhiệt độ. Bộ xử lý thủy vân là khác biệt duy nhất trong mỗi cặp.
- Gọi công cụ: BFCL v4 single-turn AST, nhiệt độ 0.001, 0.7, 1.0 — hành vi đúng là gọi đúng công cụ, hoặc không gọi khi không có công cụ phù hợp
- Từ chối: HarmBench 200 hành vi độc hại và JailbreakBench 100 mẫu lành tính, nhiệt độ 0.001 và 0.7 — hành vi đúng là từ chối yêu cầu độc hại và trả lời yêu cầu lành tính
Chi phí đối với khả năng gọi công cụ
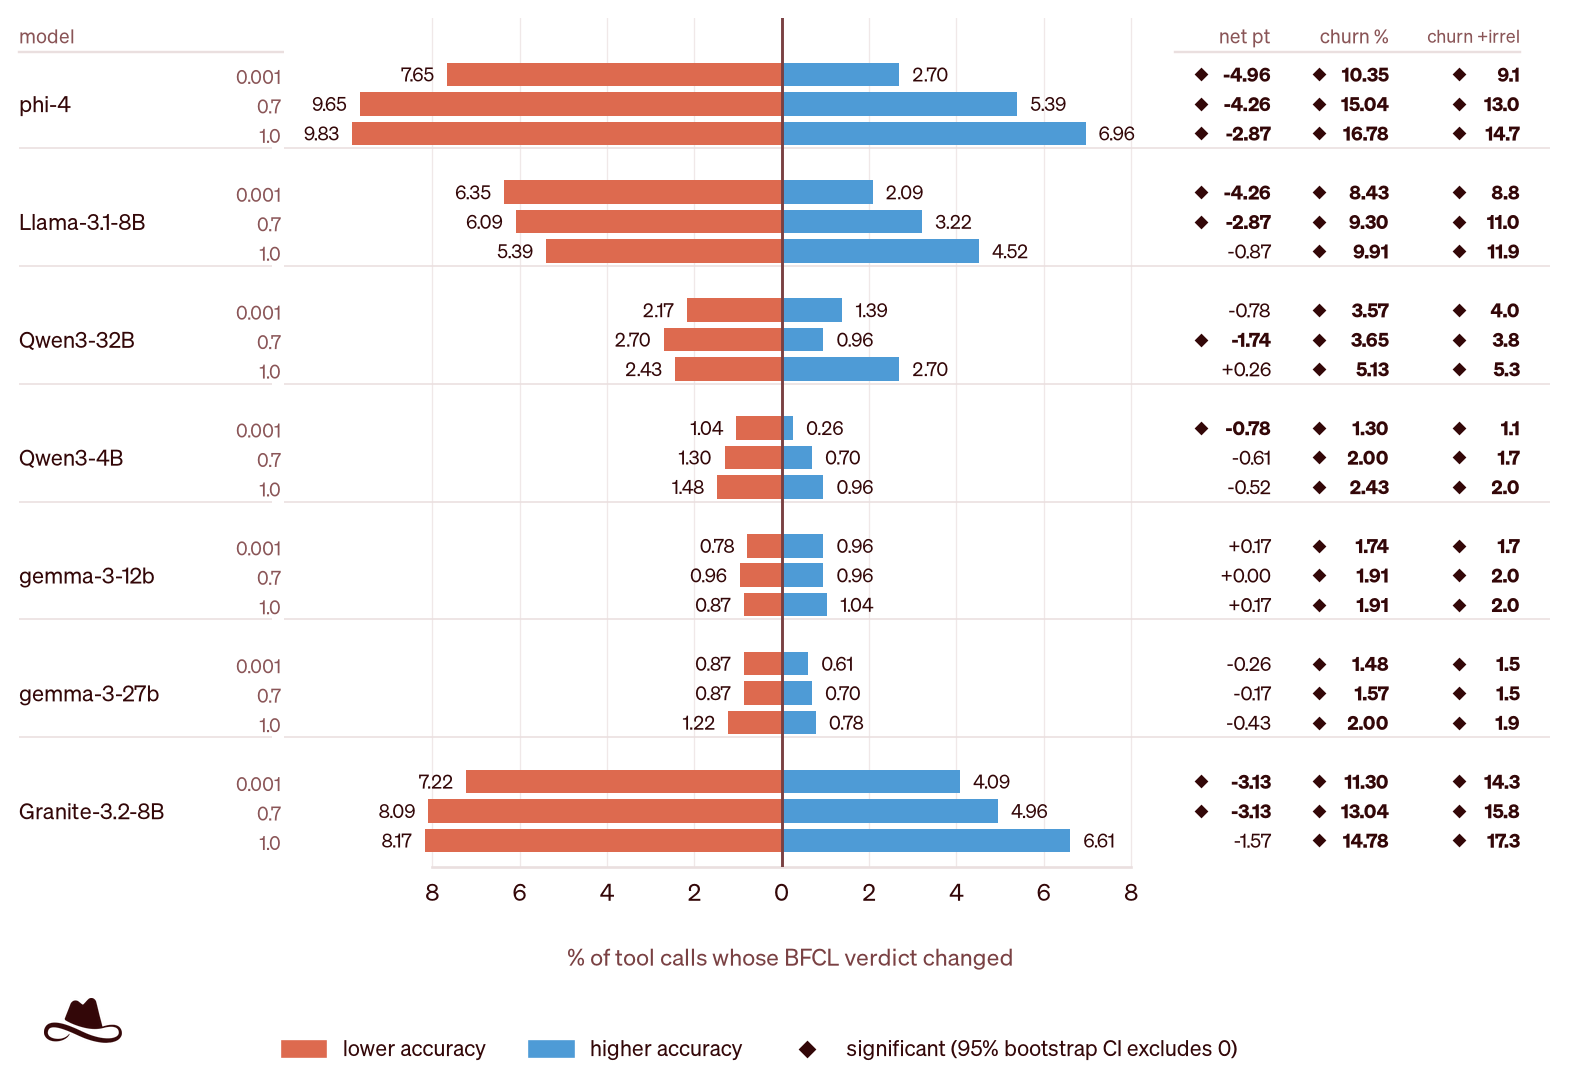
Trên các mục yêu cầu phải gọi công cụ, thủy vân làm giảm độ chính xác ở 6 trong 7 mô hình, với mức giảm đáng kể ở 4 mô hình. Tuy vậy, thay đổi ròng về độ chính xác không cho thấy liệu cùng một lời gọi cụ thể có thành công khi bật và tắt thủy vân hay không.
Nhóm nghiên cứu đo trực tiếp điều này bằng tỷ lệ bất đồng ghép cặp (paired disagreement rate), gọi là churn — tỷ lệ các mục có kết quả khác nhau giữa lần chạy có thủy vân và không thủy vân.
Kết quả cho thấy bất đồng ghép cặp lớn hơn đáng kể so với thay đổi độ chính xác ròng:
- Ở nhiệt độ 1.0, 16,8% kết quả gọi công cụ của phi-4 khác nhau giữa hai điều kiện, trong khi mức giảm độ chính xác ròng chỉ là 2,87 điểm
- Llama-3.1-8B cũng cho thấy mô hình tương tự với 9,9% kết quả thay đổi, dù mức mất ròng chỉ 0,87 điểm
- Trên 21 tổ hợp mô hình–nhiệt độ, churn trung bình là 6,5%, và khoảng tin cậy bootstrap loại trừ giá trị 0 trong mọi trường hợp
Điều này có nghĩa là một lời gọi trở nên sai có thể được bù đắp bởi một lời gọi khác trở nên đúng, khiến kết quả tổng hợp gần như không đổi — dù thực tế mô hình đã hành xử khác đi ở cả hai mục.
Loại lỗi cũng rất quan trọng
Đầu ra sai định dạng sẽ ngăn lời gọi dự kiến thực thi, trong khi một lời gọi đúng định dạng nhưng sai công cụ hoặc sai tham số vẫn có thể chạy được. Đây là loại lỗi đặc biệt nguy hiểm vì nó có thể thực thi thành công nhưng thực hiện sai hành động.
Hồ sơ lỗi khác nhau giữa các mô hình. Trên Llama-3.1-8B, đóng góp lớn nhất vào mức mất độ chính xác đến từ tham số sai (−3,48 điểm), tiếp theo là gọi sai công cụ (−1,84 điểm). Trên phi-4 và Granite-3.2-8B, đầu ra sai định dạng lại chiếm ưu thế (−5,96 và −4,36 điểm).
Thủy vân có thể làm suy yếu khả năng từ chối dưới prompt injection
Đây có lẽ là phát hiện đáng lo ngại nhất. Thủy vân thay đổi hành vi từ chối trên các yêu cầu độc hại trần, nhưng hiệu ứng trở nên rõ rệt hơn nhiều khi kết hợp với prompt injection.
 Biểu đồ so sánh mức độ bất đồng trong hành vi từ chối khi có và không có prompt injection
Ở nhiệt độ 0.001:
- gemma-3-27b: churn tăng từ 6,0% trên yêu cầu trần lên 23,5% dưới prompt injection, trong khi thay đổi tuân thủ ròng chuyển từ −1,0 lên +12,5 điểm
- gemma-3-12b: churn tăng từ 7,5% lên 11,0% và thay đổi tuân thủ ròng từ −0,5 lên +9,0 điểm
- Llama-3.1-8B: churn dưới injection đạt 14,0% ở nhiệt độ 0.001 và 17,5% ở nhiệt độ 0.7
Điểm mấu chốt là trong nhiều trường hợp, thủy vân gần như không ảnh hưởng ròng đến hành vi từ chối với yêu cầu độc hại trần, nhưng lại làm giảm đáng kể khả năng từ chối dưới prompt injection. Một cơ chế trông có vẻ ổn định về hành vi trên đầu vào thông thường có thể không còn ổn định khi bị tấn công.
Đáng chú ý, phi-4 và Qwen3-4B thay đổi rất ít trong cả hai điều kiện, nhưng cả hai mô hình này đều có xu hướng từ chối quá mức trong đánh giá, kể cả trên các mẫu kiểm soát lành tính. Do đó, việc chúng ít dịch chuyển dưới prompt injection không nên được hiểu là bằng chứng cho thấy thủy vân bảo toàn hành vi an toàn đáng tin cậy hơn trên các mô hình này.
So sánh với churn do nhiệt độ gây ra
Để đặt mức bất đồng do thủy vân gây ra vào bối cảnh, nhóm nghiên cứu so sánh nó với bất đồng quan sát được khi thay đổi nhiệt độ. Kết quả cho thấy churn do thủy vân gây ra cao hơn đáng kể trên 4 trong 6 mô hình:
- Granite-3.2-8B: churn do nhiệt độ cao nhất ở 15,5%, nhưng churn do thủy vân vẫn cao hơn ở 21,5%
- gemma-3-27b: chênh lệch +12,5 điểm (khoảng tin cậy 95%: +6,0 đến +18,5)
- Llama-3.1-8B: chênh lệch +10,0 điểm (+4,5 đến +15,5)
Hiệu ứng phụ thuộc vào khóa thủy vân
Một phát hiện quan trọng khác là hiệu ứng của thủy vân phụ thuộc vào cả mô hình lẫn khóa thủy vân. Nhóm nghiên cứu đánh giá mức độ nhạy cảm với khóa ở nhiệt độ 0.7 bằng khóa nghiên cứu cùng mười khóa bổ sung.
 Biểu đồ thay đổi tỷ lệ tấn công thành công theo 11 khóa thủy vân khác nhau
Với Llama-3.1-8B và cả hai mô hình Gemma, phần lớn các khóa đều làm tăng tỷ lệ tấn công thành công so với đường cơ sở không thủy vân, dù mức độ biến thiên rất rộng. Với Llama-3.1-8B, khóa nghiên cứu làm tăng tỷ lệ tấn công thành công 3,5 điểm, trong khi mười khóa còn lại trung bình tăng +4,4 điểm và dao động từ −4,5 đến +14,5 điểm.
Điều này đặc biệt đáng lo ngại với các mô hình do nhà cung cấp vận hành, nơi thủy vân có thể được áp dụng ở cấp độ mô hình cho đầu ra mà các agent phát triển độc lập tiêu thụ. Khi khóa hoặc cấu hình thủy vân do nhà cung cấp mô hình kiểm soát, những thay đổi này có thể xảy ra ngoài tầm kiểm soát trực tiếp của nhà phát triển agent.
Ý nghĩa đối với an toàn và bảo mật AI
Thủy vân văn bản vốn được thiết kế để giúp nhận diện nội dung do AI tạo ra, nhưng bên trong một agent, nó cũng trở thành một phần của quá trình sinh tạo ra các quyết định. Kết quả nghiên cứu cho thấy nó có thể thay đổi cả việc gọi công cụ lẫn hành vi từ chối, với những thay đổi ở từng quyết định riêng lẻ mà độ chính xác tổng hợp hoặc tỷ lệ từ chối có thể che khuất.
Các tác giả nhấn mạnh rằng phát hiện này không phản đối việc dùng thủy vân cho mục đích minh bạch nguồn gốc. Thay vào đó, chúng cho thấy khả năng phát hiện và tính ổn định hành vi là hai thuộc tính riêng biệt. Việc có thể phát hiện được và chất lượng văn bản không đổi không chứng minh rằng agent sẽ giữ nguyên hành vi gọi công cụ hay hành vi an toàn một khi bật thủy vân.
Với các nhà phát triển và đội ngũ bảo mật, khuyến nghị rõ ràng là:
- Đánh giá lại mỗi khi thủy vân được đưa vào hoặc khi cấu hình, khóa thủy vân thay đổi
- Lặp lại kiểm thử agent và red-teaming dưới đúng cấu hình dự kiến triển khai, bao gồm so sánh ghép cặp trên cùng đầu vào
- Kiểm thử dưới prompt injection, bởi vì một cơ chế trông ổn định trên đầu vào thông thường có thể không còn ổn định khi bị tấn công
- Coi thủy vân là một phần trong cấu hình bảo mật đã triển khai của agent, chứ không chỉ là một tính năng minh bạch nội dung
Nghiên cứu tập trung vào SynthID-Text, nhưng lo ngại rộng hơn vẫn đúng với mọi can thiệp làm thay đổi việc chọn token trong các hệ thống hành động dựa trên token được sinh ra. Khi AI Agent ngày càng được trao nhiều quyền thực thi — đặt hàng, gửi email, truy vấn cơ sở dữ liệu — thì việc hiểu rõ những thay đổi tưởng chừng nhỏ trong quá trình sinh token không còn là vấn đề học thuật, mà là yêu cầu bắt buộc để đảm bảo an toàn.