
Mô hình AI chơi piano jazz theo phong cách 12 nghệ sĩ
Nhóm nghiên cứu tinh chỉnh mô hình Aria trên MIDI piano để sinh nhạc theo phong cách từng nghệ sĩ jazz. Bộ phân loại nhận diện đúng nghệ sĩ dự định trong 70% trường hợp, so với 37% khi không có điều kiện phong cách.
Năm 1994, nghệ sĩ piano Dick Hyman xuất bản cuốn In the Styles of… The Great Jazz Pianists, gồm mười lăm étude (khúc luyện tập) viết theo lối chơi của từng bậc thầy, từ Scott Joplin đến Bill Evans. Ông không chép lại các bản độc tấu, mà sáng tác nhạc mới mang dấu ấn riêng: những chuỗi nốt chạy nhanh bằng cả hai tay kiểu Tatum, cách đàn tay trái như gảy đàn guitar của Garner, hay tiếng ngân và lướt phím của Peterson.
Một dự án nghiên cứu mới lấy ý tưởng đó làm bài toán cho máy học: liệu mô hình có thể không chỉ nhận ra ai đang chơi, mà còn chơi theo cách của người đó? Nhóm tác giả chọn 12 nghệ sĩ piano jazz, trong đó có Tatum, Garner, Peterson và cả Hyman.
 Bìa sách In the Styles of… của Dick Hyman
Cách mô hình học phong cách
Nhóm bắt đầu từ Aria, một mô hình transformer 16 lớp được tiền huấn luyện trên kho MIDI piano lớn. Họ tinh chỉnh nó trên các bản độc tấu của 12 nghệ sĩ trong bộ dữ liệu PiJAMA.
Vào tám lớp cuối của Aria, nhóm chèn thêm một khối cross-attention (cơ chế chú ý chéo). Khối này cho phép phần âm nhạc "chú ý" tới một embedding nhỏ đã học cho từng nghệ sĩ, gồm bốn vector mỗi người.
Một cổng (gate) đã học điều chỉnh mức ảnh hưởng của khối này, khởi đầu ở 0,1 để quá trình tinh chỉnh bắt đầu từ hành vi sẵn có của Aria. Vì embedding được chú ý ở mọi bước, phong cách không phai dần khi bản nhạc kéo dài, khác với cách dùng một đoạn lệnh mở đầu (prompt prefix).
Đo phong cách bằng bộ phân loại
Chỉ số quen thuộc để đánh giá mô hình sinh là perplexity trên nhạc kiểm thử, nhưng nó gần như không thấy được phong cách. Khi đã có các nốt trước đó, nốt tiếp theo dễ đoán bất kể ai chơi.
Vì vậy nhóm để mô hình tự do chơi và dùng một bộ phân loại nghệ sĩ để xem bản nhạc nghe giống ai. Bộ phân loại trượt dọc theo đoạn sinh, mỗi cửa sổ khoảng 300 nốt.
Kết quả: các đoạn sinh có điều kiện phong cách được gán đúng nghệ sĩ dự định trong 70% trường hợp, so với 37% khi không có điều kiện. Mức đoán ngẫu nhiên là 8%. Trong khi đó, perplexity gần như không phân biệt được hai mô hình đã tinh chỉnh.
Một bộ phân loại thứ hai, chỉ huấn luyện trên nhạc do máy sinh, sau đó nhận diện đúng bản thu thật với độ chính xác 95%.
Cùng một câu mở, mười hai cách chơi
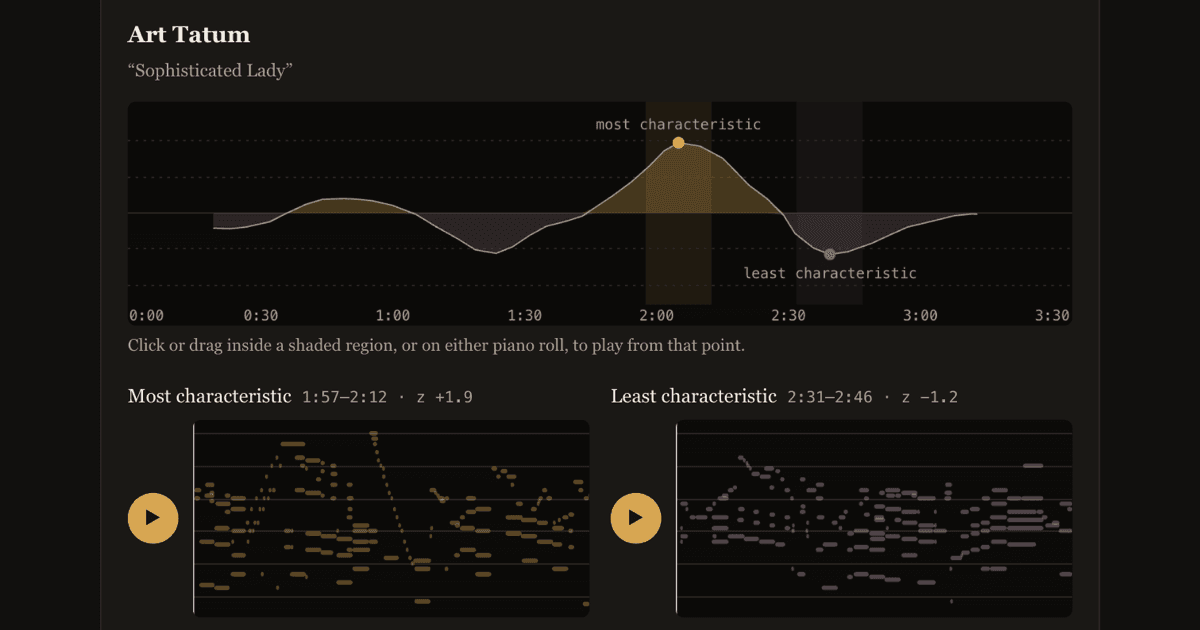
Thử nghiệm nổi bật là cho mô hình tiếp nối cùng những ô nhịp đầu của "Ain't Misbehavin'", mỗi lần với một nghệ sĩ khác nhau. Mỗi bản sinh cùng số nốt nên thời lượng khác nhau: Erroll Garner dồn vào 1 phút 26 giây, còn Cedar Walton trải ra 2 phút 45 giây. Mật độ nốt dày hay thưa cũng là một phần dấu ấn của nghệ sĩ.
Ngoài ra, mỗi nghệ sĩ còn được cho tiếp nối vài ô nhịp do chính họ chơi. Thanh dưới mỗi bản ghi lại phán đoán của bộ phân loại theo từng cửa sổ, màu vàng khi gọi đúng nghệ sĩ dự định, màu tím khi gọi nhầm.
Giới hạn của kết quả
12 nghệ sĩ được chọn vì dễ phân biệt: họ là những người mà một mô hình tiền huấn luyện phân tách rõ nhất trong 30 nghệ sĩ của PiJAMA. Ngay trong nhóm này, mức độ bắt chước chênh lệch lớn. Với Hank Jones và Dick Hyman, tỷ lệ gán đúng lên tới 96%, nhưng với Cedar Walton chỉ 29%.
Các bản được chấm điểm là mẫu chọn lọc, không phải bản sao. Với mỗi nghệ sĩ, nhóm chọn hai bản điểm cao nhất trong tám bản. Câu mở lấy từ bản thu huấn luyện, và nhóm đã kiểm tra rằng phần tiếp nối không sao chép chúng.
Toàn bộ dữ liệu là MIDI, được hiển thị trên trình duyệt bằng piano lấy mẫu. Mô hình học từ bản chép tự động các bản thu thương mại, nên sắc thái mạnh nhẹ và bàn đạp chỉ gần đúng, âm thanh thô hơn bản thu gốc.
Điểm số do bộ phân loại đưa ra, không phải người nghe. Bộ này khá mạnh, đạt 98,8% trên các bài kiểm thử, nhưng có thói quen: nhiều lần đoán nhầm trên nhạc máy sinh lại rơi vào Dick Hyman. Nhóm tác giả cho rằng một nghiên cứu thính giác với người nghe thật là bước tiếp theo hợp lý.
Góc nhìn
Với kỹ sư AI, dự án này là ví dụ rõ cho việc chọn đúng thước đo. Perplexity thấp không đồng nghĩa mô hình nắm được phong cách; chỉ khi để mô hình tự sinh rồi đánh giá bằng một bộ phân loại độc lập mới thấy khác biệt.
Cách gắn embedding của từng nghệ sĩ qua cross-attention cũng đáng tham khảo. Kỹ thuật này giữ được đặc tính điều kiện trong suốt quá trình sinh, thay vì chỉ tác động ở phần đầu như prompt. Ai làm sản phẩm sinh nội dung theo giọng điệu hoặc thương hiệu riêng có thể áp dụng hướng tương tự.
Còn với nhạc sĩ và nhà sản xuất, công cụ như vậy mở ra cách tạo bản phác thảo theo phong cách tham chiếu. Nhưng cần nhớ dữ liệu huấn luyện là bản chép từ bản thu thương mại, nên câu hỏi bản quyền và chất lượng âm thanh vẫn chưa được giải quyết.
Nguồn: almostimplemented.github.io · Quy trình biên tập
Bài viết liên quan
Công nghệ
Nghiên cứu: Phân tích "vân tay" phong cách viết của 178 mô hình AI và phát hiện các cụm bản sao
08 tháng 4, 2026
Công nghệ
Jevman: Các mô hình AI ganh đua chơi Pac-Man, mở ra chuẩn đo lường cho AI ra quyết định
08 tháng 10, 2026
Công nghệ
Mô hình AI số 1 có thực sự là số 1? Khi bảng xếp hạng chỉ là ảo giác thống kê
29 tháng 10, 2026