
Dạy mô hình thế giới chơi Pokémon: Hành trình từ JEPA đến việc chọn Squirtle
Một kỹ sư đã huấn luyện mô hình thế giới (world model) dựa trên kiến trúc JEPA của Yann LeCun để chơi Pokémon Red. Mô hình ~12,5 triệu tham số này học cách dự đoán diễn biến trò chơi trong không gian embedding và lập kế hoạch chọn Pokémon khởi đầu, với 52/100 lần thành công sau khi tinh chỉnh rollout.
Dạy mô hình thế giới chơi Pokémon: Khi AI học cách "hiểu" thế giới trong game
Một thử nghiệm thú vị đến từ cộng đồng nghiên cứu AI: huấn luyện một mô hình thế giới (world model) dựa trên kiến trúc JEPA của Yann LeCun để chơi tự động Pokémon Red. Mô hình cuối cùng chỉ khoảng 12,5 triệu tham số, đủ nhỏ để huấn luyện trên một chiếc RTX 3080 Ti tại nhà. Kết quả đáng chú ý: sau khi tinh chỉnh, mô hình chọn được Pokémon khởi đầu trong 52/100 lần thử với các hạt giống ngẫu nhiên khác nhau.
 Mô hình lập kế hoạch chuỗi nút bấm để chọn Squirtle
Mô hình thế giới là gì và tại sao lại đáng quan tâm?
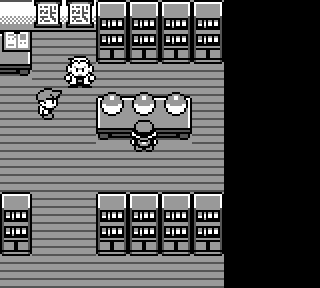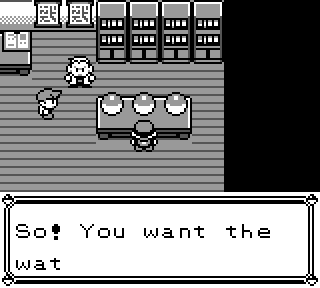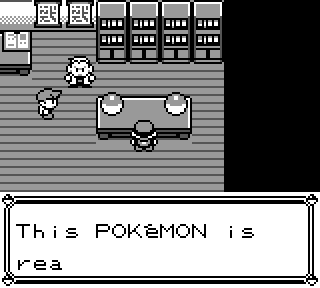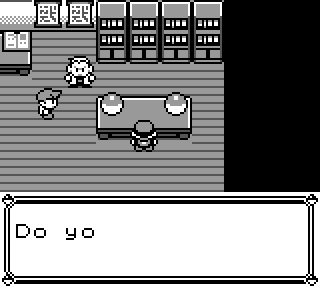
Ý tưởng cốt lõi khá trực quan: cho mô hình một trạng thái hiện tại (ví dụ ảnh chụp màn hình trong phòng thí nghiệm của Giáo sư Oak), cùng một hành động (nhấn nút trái), mô hình phải dự đoán trạng thái tiếp theo.
Mục tiêu của mô hình thế giới là học mối tương quan giữa hành động và sự thay đổi trạng thái, chứ không chỉ ghi nhớ một tình huống cụ thể.
Điểm mấu chốt là tính tổng quát hóa: mô hình không nên học rằng "nhấn trái trong phòng Oak sẽ di chuyển sang trái", mà phải hiểu "nhấn trái ở bất kỳ đâu cũng di chuyển sang trái". Kiến trúc được chọn là LeWorldModel — một biến thể JEPA có thiết kế đơn giản hơn nhiều mô hình tiền nhiệm, phù hợp để thử nghiệm cục bộ.
Khác với học tăng cường (reinforcement learning) vốn cần tín hiệu phần thưởng, mô hình thế giới ở đây được huấn luyện không cần phần thưởng — nó chỉ học động lực học của môi trường.
Dự đoán trong không gian embedding thay vì pixel
Điều thú vị là mô hình không dự đoán trực tiếp ảnh chụp màn hình tiếp theo. Thay vào đó, nó hoạt động trong không gian ẩn (latent space).
 Luồng dữ liệu qua encoder và predictor
Quy trình gồm ba bước:
- Ảnh chụp màn hình hiện tại đi qua encoder để tạo ra một vector embedding 192 chiều
- Vector này kết hợp với nút bấm được đưa vào predictor, dự đoán embedding tiếp theo
- Embedding dự đoán được so sánh với embedding thật của ảnh tiếp theo bằng hàm mất mát MSE
Một embedding là biểu diễn đã học của đầu vào dưới dạng vector số. Các giá trị không được gán nhãn thủ công — thông tin phân tán khắp các chiều, và một số chi tiết gốc có thể biến mất hoàn toàn.
Vấn đề "sụp đổ tiềm ẩn" và giải pháp SIGReg
Đây là cạm bẫy lớn nhất của kiến trúc JEPA. Vì encoder xuất hiện hai lần trong mỗi bước huấn luyện, mô hình có thể tìm ra cách "ăn gian": mã hóa mọi ảnh chụp thành cùng một vector. Khi đó predictor chỉ cần dự đoán vector đó, và hàm mất mát về 0 mà mô hình chẳng học được gì.
Hiện tượng này gọi là latent collapse (sụp đổ không gian ẩn). Giải pháp được LeWorldModel chọn là SIGReg (Sketched Isotropic Gaussian Regularization), yêu cầu phân bố embedding trong một batch phải giống phân bố Gauss đẳng hướng chuẩn — trung bình bằng 0, ma trận hiệp phương sai là ma trận đơn vị.
Nói cách khác, thay vì co cụm thành một điểm hay một đường thẳng, các embedding phải trải đều như một đám mây tròn trong không gian nhiều chiều. SIGReg kiểm tra điều này bằng cách chiếu embedding lên 1.024 hướng ngẫu nhiên và dùng phép kiểm định Epps–Pulley dựa trên hàm đặc trưng để đo mức độ lệch.
Hàm mục tiêu cuối cùng là sự kết hợp: mất mát dự đoán cộng với 0,1 lần hình phạt SIGReg.
Dữ liệu huấn luyện: 42.382 khung hình Pokémon Red
Tác giả ghi lại 42.382 khung hình xám từ trình giả lập Pokémon Red, chia thành 1.009 quỹ đạo ngắn. Một số quỹ đạo đi theo lộ trình có kịch bản đến chỗ chọn Pokémon khởi đầu, số khác thêm hành động nhiễu hoặc di chuyển ngẫu nhiên.
Việc có dữ liệu "lộn xộn" rất quan trọng. Nếu chỉ huấn luyện trên lộ trình sạch, mô hình sẽ không bao giờ học được nút B dùng để làm gì khi hộp thoại xuất hiện. Bộ lập kế hoạch sau này sẽ đề xuất đủ loại chuỗi nút bấm — kể cả những chuỗi tồi — và nó cần dự đoán cho cả những trường hợp đó.
Đáng chú ý: không có bản ghi nào cho mô hình biết quỹ đạo nào thành công. Hàm mất mát chỉ yêu cầu dự đoán điều gì xảy ra sau mỗi lần nhấn nút; mô hình không hề được thưởng vì chọn được Pokémon.
Lập kế hoạch trong thế giới đã học
Để yêu cầu chọn Pokémon khởi đầu, tác giả lấy ảnh chụp từ ba lần chọn thành công (Bulbasaur, Charmander, Squirtle), mã hóa chúng thành ba mục tiêu khả thi. Bất kỳ mục tiêu nào cũng được.
Mô hình sau đó "tưởng tượng" các chuỗi hành động mà không cần chạy trình giả lập: từ embedding đầu tiên, nó dự đoán trạng thái tiếp theo, rồi lấy dự đoán đó làm đầu vào cho bước kế tiếp. Cách này cho phép thử hàng nghìn kế hoạch mà không tốn chi phí chạy game thật.
 Tinh chỉnh mô hình trên các rollout
Để tìm chuỗi 14 nút bấm tối ưu, tác giả dùng phương pháp cross-entropy (CEM): mỗi vòng lấy mẫu 512 kế hoạch, giữ lại 64 kế hoạch có điểm số tốt nhất, rồi điều chỉnh xác suất chọn nút cho từng vị trí.
Thất bại đầu tiên và bài học về rollout
Kế hoạch đầu tiên mô hình cho là sẽ chạm tới Pokémon khởi đầu lại thất bại trong trình giả lập. Nguyên nhân: khi huấn luyện, predictor luôn bắt đầu từ embedding thật của ảnh chụp thật. Nhưng khi lập kế hoạch, dự đoán thứ hai bắt đầu từ dự đoán thứ nhất, dự đoán thứ ba bắt đầu từ dự đoán thứ hai... Sai số nhỏ tích lũy dần cho đến khi mô hình làm việc với các embedding không giống ảnh thật nữa.
Giải pháp là tinh chỉnh rollout: cho predictor luyện tập với chính sai số của mình, dùng các rollout ngắn rồi tăng dần độ dài. Encoder ảnh được giữ cố định để mục tiêu không dịch chuyển.
Kết quả thú vị: sau tinh chỉnh, dự đoán một bước thực ra tệ hơn, nhưng sai số tăng chậm hơn nhiều khi mô hình phải tự dự đoán liên tiếp. Đó chính là đánh đổi cần thiết — một kế hoạch phải trụ được qua nhiều lần nhấn nút.
Kết quả và giới hạn
Với mô hình đã tinh chỉnh, bộ lập kế hoạch tìm được chuỗi nút bấm chọn Squirtle thành công. Chạy thử 100 hạt giống ngẫu nhiên mới, 52 kế hoạch lấy được Pokémon khởi đầu — so với 0 lần của chuỗi nút ngẫu nhiên.
Đây là kết quả đáng khích lệ nhưng còn nhiều giới hạn. Tác giả vẫn chưa đánh bại được Blue (hay Gary), và nghi ngờ rằng độ khó tăng theo cấp số nhân với độ dài kế hoạch. Các bước tiếp theo tiềm năng gồm: bắt đầu từ phòng Oak, phải tự đi đến chỗ ông, vượt qua toàn bộ đoạn hội thoại, rồi mới chọn Pokémon.
Với độc giả Việt Nam quan tâm đến AI, thử nghiệm này là minh chứng sinh động cho tiềm năng của mô hình thế giới — hướng đi mà Yann LeCun cho rằng sẽ dẫn tới trí tuệ nhân tạo tổng quát, thay vì chỉ mở rộng mô hình ngôn ngữ. Và đôi khi, cách học hiệu quả nhất lại bắt đầu từ một trò chơi năm 1996.
Mã nguồn được công khai tại kho lưu trữ lePokeRed.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Meta Connect: Kính thông minh hiện diện khắp nơi, Meta quyết tâm theo đuổi tương lai
26 tháng 9, 2026