
Demoscener: Khi lập trình viên huấn luyện AI để sáng tác demo 140 ký tự
Một lập trình viên đã tinh chỉnh mô hình Qwen2.5-Code-7B để tự động hoàn thiện các Dweet — những đoạn demo JavaScript chỉ dài 140 ký tự trên Dwitter.net. Bằng cách kết hợp continued pretraining, curriculum learning theo điểm \"awesomeness\" và RLHF với chính mình làm bộ đánh giá, anh tạo ra Demoscener-7B có thể sinh ra những phần tiếp nối mang tính thẩm mỹ cao.
Demoscener: Khi lập trình viên huấn luyện AI để sáng tác demo 140 ký tự
Có những dự án phụ bắt đầu từ một câu hỏi rất nhỏ, rồi lớn dần thành một thử nghiệm nghiêm túc về trí tuệ nhân tạo. Demoscener là một ví dụ như vậy: một lập trình viên đam mê demoscene và sizecoding đã tự huấn luyện một mô hình ngôn ngữ có khả năng hoàn thiện những đoạn demo JavaScript chỉ dài 140 ký tự.
Từ demo MS-DOS đến câu hỏi về khả năng sáng tạo
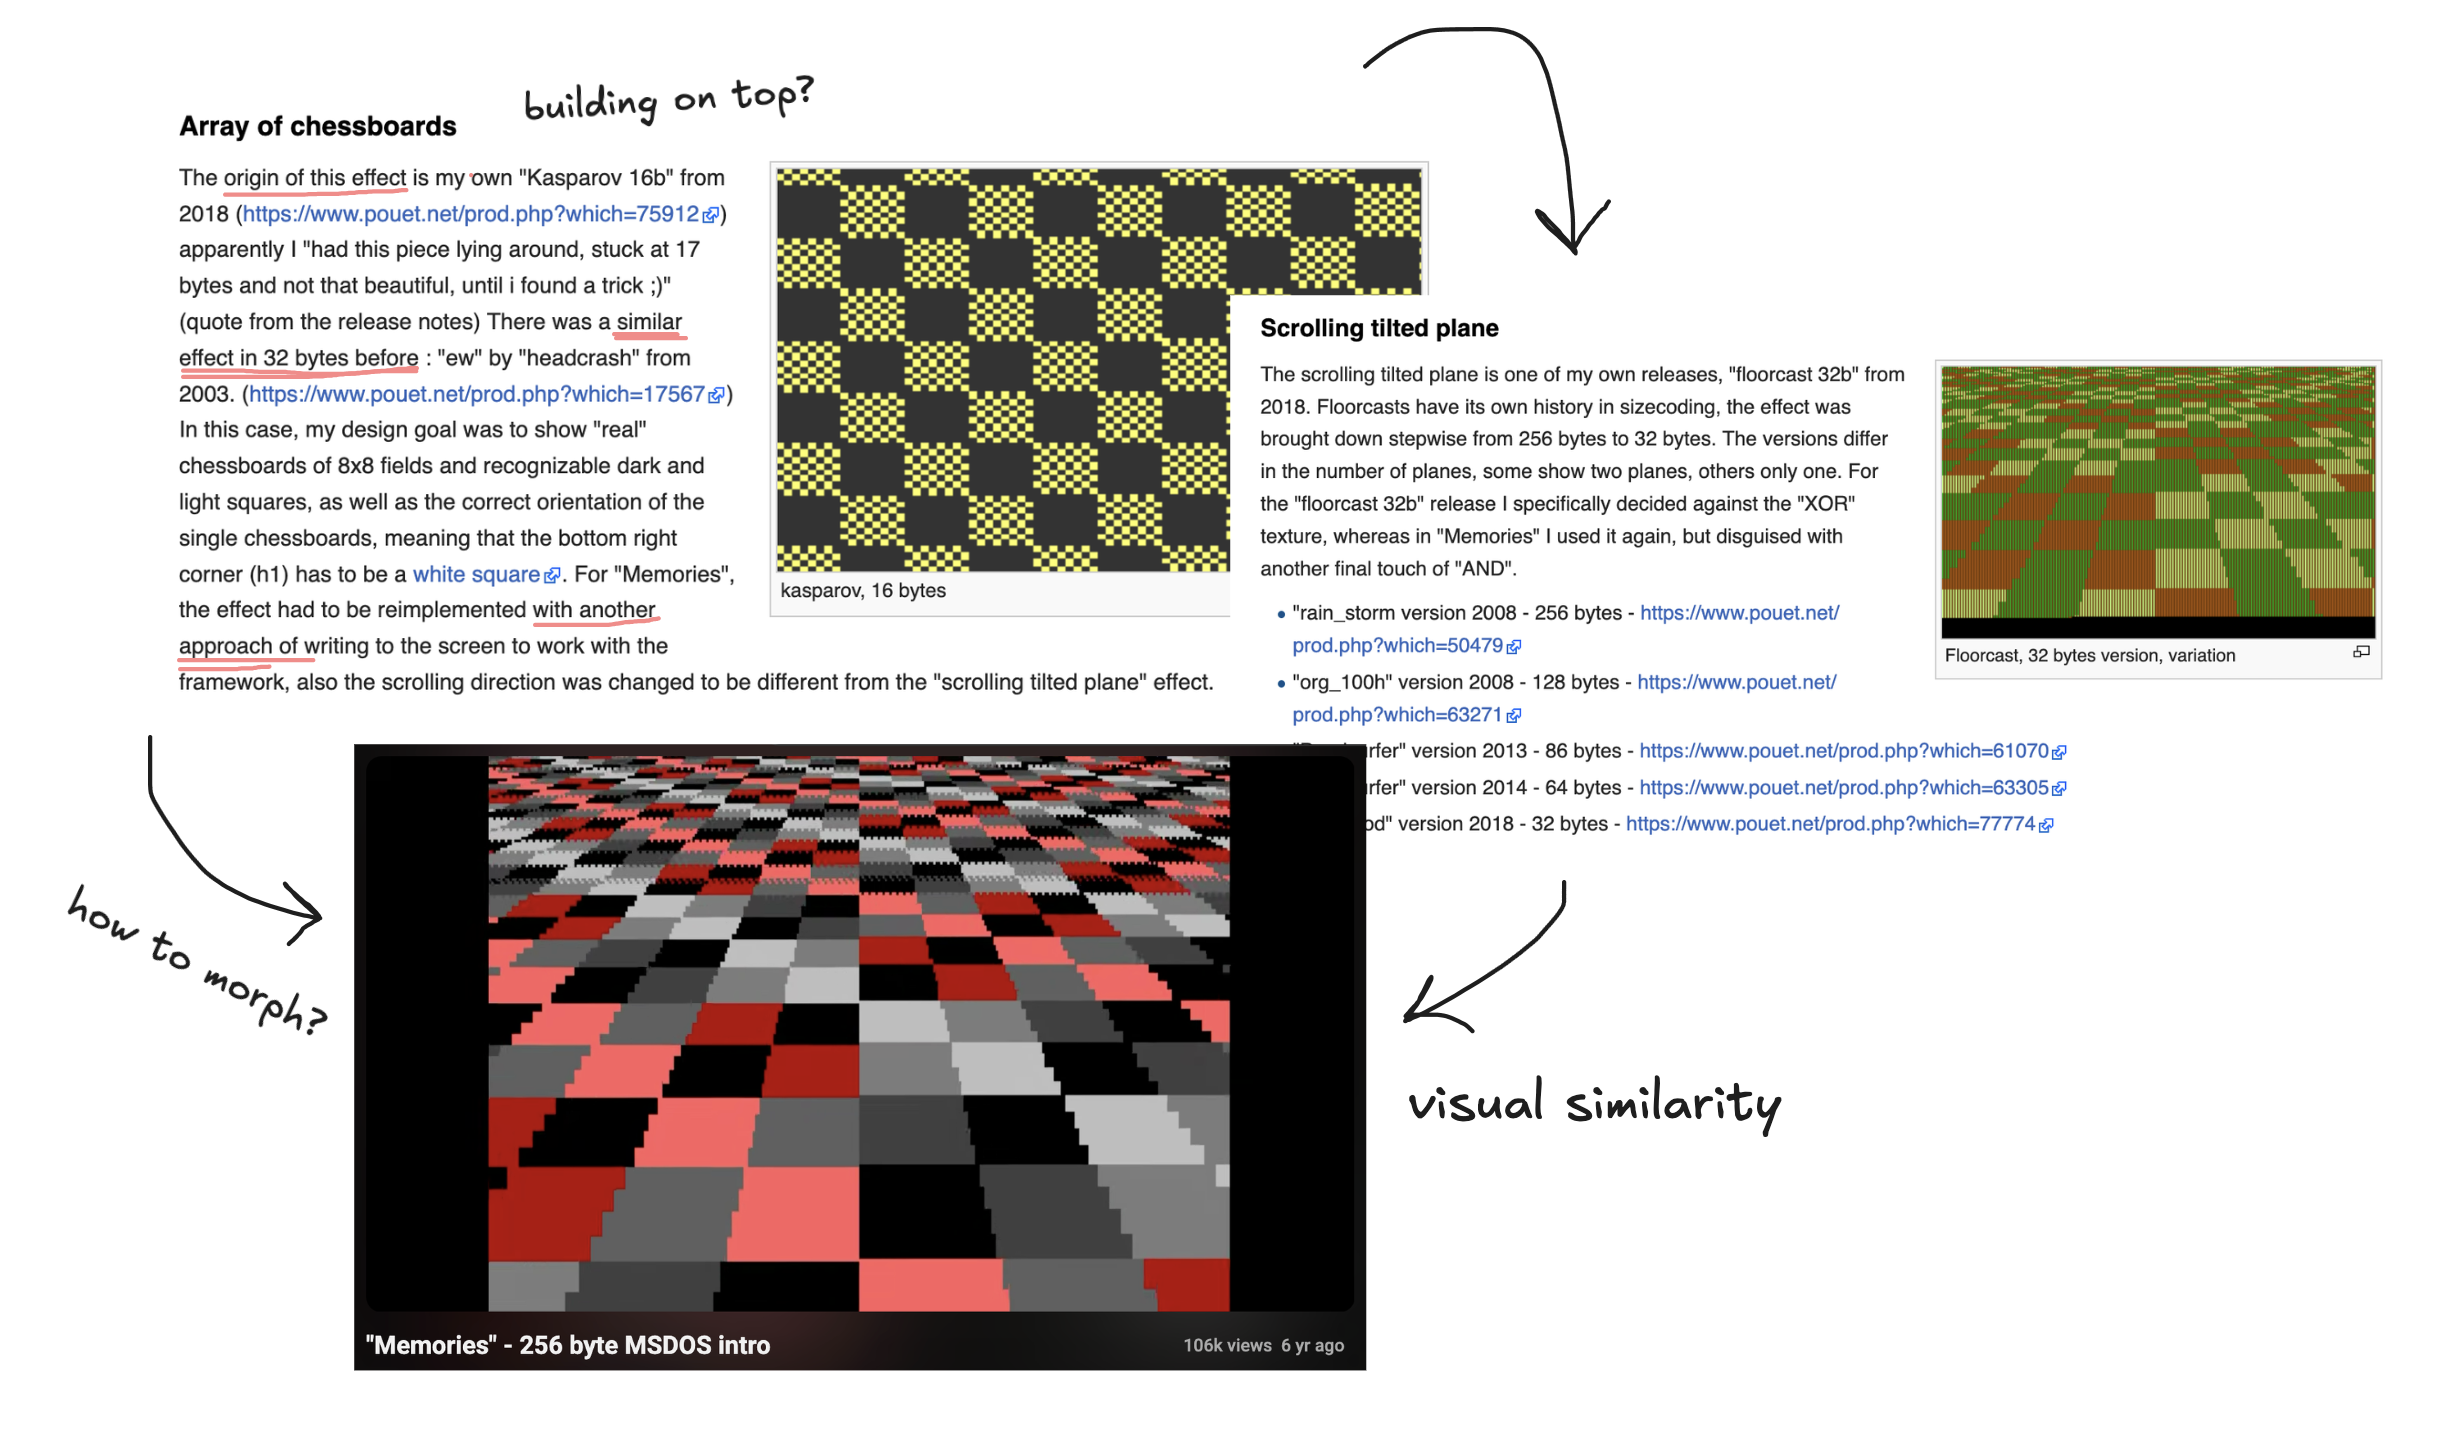
Xuất phát điểm là bản demo MS-DOS nổi tiếng "Memories" của HellMood. Khi đọc phần giải thích của tác giả, nhà phát triển này nhận ra các hiệu ứng hình ảnh trong đó đều có thể truy vết về những thử nghiệm trước đó — các cách triển khai thay thế và ý tưởng vay mượn từ những demo cũ hơn.
Điều đó gợi lên một câu hỏi thú vị: cùng một ý tưởng gốc có thể đã đi theo bao nhiêu hướng khác nhau? Anh quyết định bắt đầu từ những demo đơn giản nhất và thay đổi từng ký tự để xem cảm giác thị giác thay đổi ra sao.
Nơi lý tưởng để làm việc này là Dwitter.net — nền tảng được ví như "Twitter dành cho demo JavaScript 140 ký tự". Trùng hợp thay, Dweet được yêu thích nhất trên trang lại chia sẻ hiệu ứng bàn cờ parallax giống hệt trong "Memories".
Minh họa các hiệu ứng demo được tạo từ mã ngắn
Bài toán tổ hợp khổng lồ
Trong ngôn ngữ học, ngôn ngữ có tính productive: một vốn từ hữu hạn và bộ quy tắc ngữ pháp hữu hạn có thể tạo ra vô số cách diễn đạt. Ngôn ngữ lập trình cũng vậy.
Giả sử bạn lấy một chương trình 140 ký tự và xóa đi 30 ký tự cuối. Chỉ với bảng chữ cái 64 ký tự, đã có gần 1,5 × 10^54 chuỗi hoàn thiện khả dĩ. Hầu hết sẽ sai cú pháp hoặc tạo ra kết quả vô nghĩa — nhưng con số vẫn là thiên văn.
Không ai có thể liệt kê hết, và việc sinh thử tất cả các chuỗi là điều ngớ ngẩn. Tuy nhiên, các phần tiếp nối của một chương trình dang dở không có xác suất ngang nhau. Với một tiền tố nhất định, một số ký tự và biểu thức có khả năng xuất hiện cao hơn hẳn — đúng nguyên lý mà các mô hình ngôn ngữ tự hồi quy (autoregressive language model) đang hoạt động.
Xây dựng Demoscener
Ý tưởng là dùng một mô hình như vậy để lấy mẫu những phần tiếp nối hợp lý của các Dweet còn dang dở, rồi hình dung các hướng đi khác nhau mà chương trình có thể đã chọn. Sau đó, có thể cắt ghép các chuỗi con theo gu thẩm mỹ của riêng mình.
Bước đầu tiên — tìm dữ liệu phù hợp — hóa ra lại là trở ngại. Việc sinh Dweet tổng hợp bằng Claude Sonnet 5.5 không mang lại kết quả thẩm mỹ tốt. May mắn là Dwitter.net có API, giúp xây dựng bộ dữ liệu gồm 25.000 Dweet để huấn luyện và khoảng 1.300 để kiểm định.
Mô hình nền được chọn là Qwen2.5-Code-7B. Mô hình này ban đầu gặp khó khăn khi hoàn thiện hầu hết các Dweet, dễ hiểu bởi cú pháp của chúng rất đặc biệt: chúng tận dụng triệt để các thủ thuật code golfing và ký hiệu toán học viết tắt, khác xa mã nguồn thông thường mà một mô hình lập trình đa dụng từng thấy.
Giải pháp là continued pretraining (CPT) trên kho dữ liệu, nhằm dịch chuyển phân phối xác suất của mô hình về phía ngôn ngữ đặc thù của dweeting. Để kiểm chứng, nhà phát triển đo surprisal của từng token trước và sau huấn luyện — tức là log âm của xác suất mô hình gán cho một token dựa trên mọi thứ đứng trước nó.
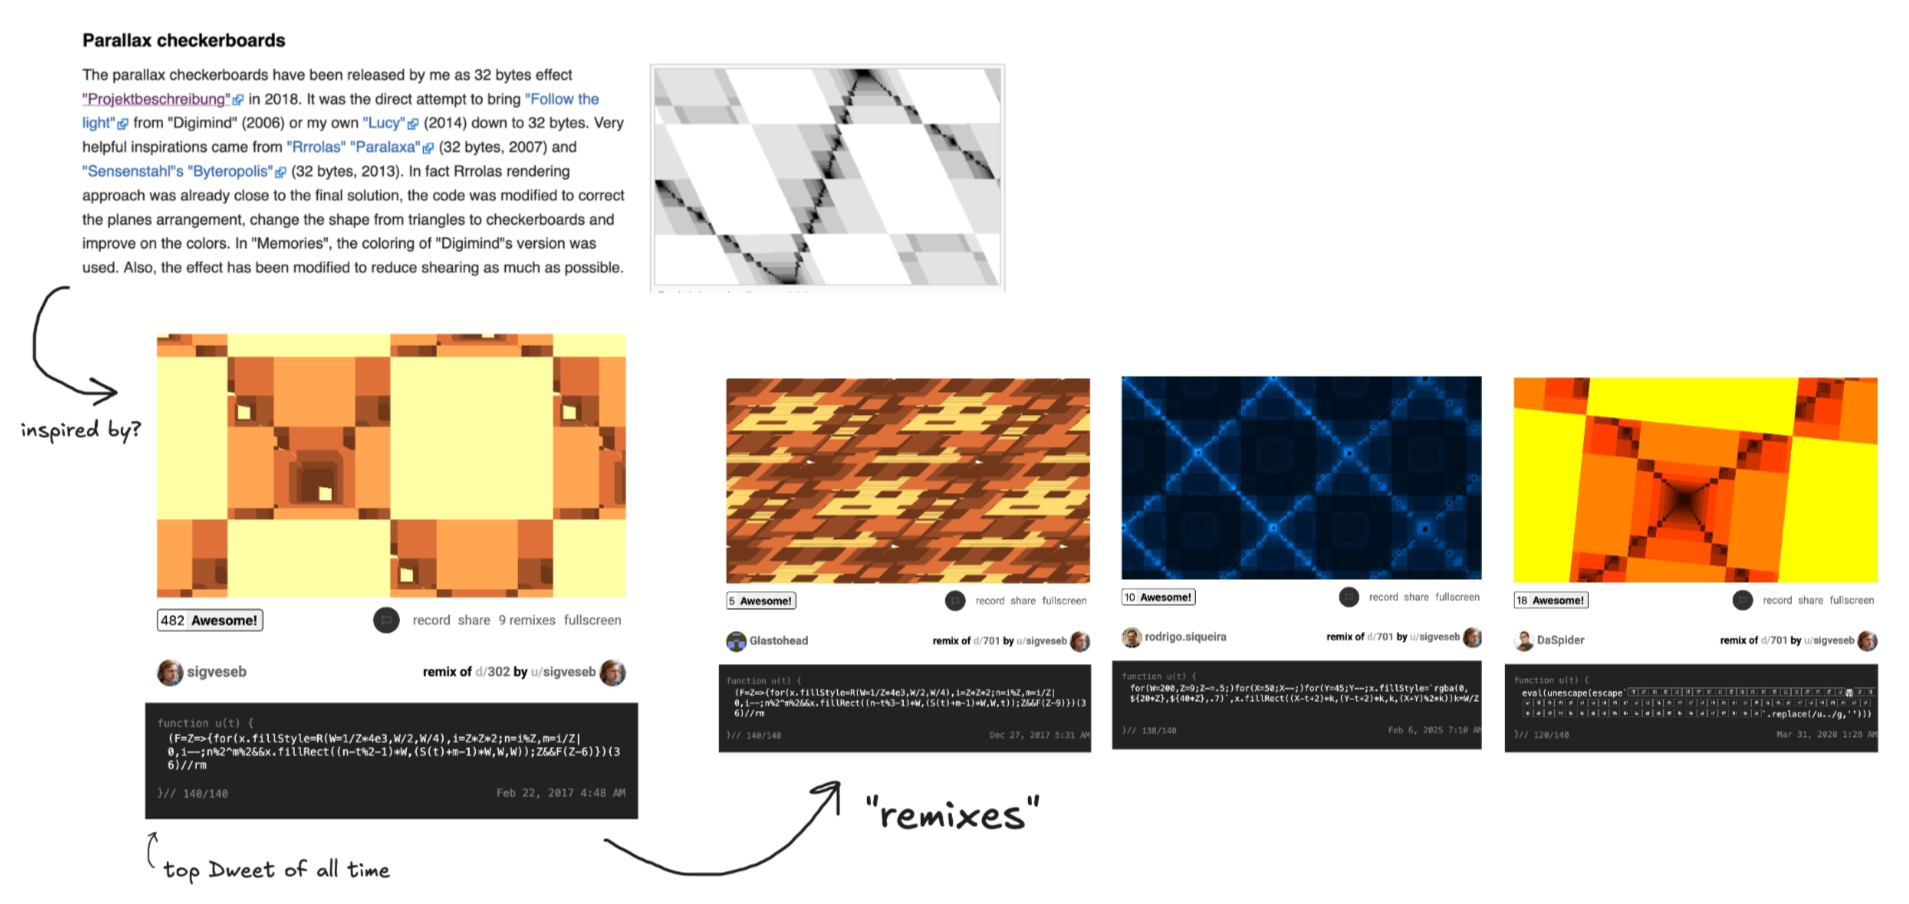 Bản đồ surprisal của token trước và sau continued pretraining
Trên 30 Dweet giữ riêng để kiểm tra, perplexity giảm từ 28,63 xuống 8,57 — mô hình đã dự đoán cấu trúc của những chương trình tí hon kỳ lạ này tốt hơn hẳn.
Curriculum learning theo điểm "awesomeness"
Các chương trình sinh ra tuy nhất quán hơn nhưng vẫn thiếu một chút "duyên". May thay, Dwitter có điểm "awesomeness" cho mỗi Dweet. Nhà phát triển dùng điểm này để xây dựng một curriculum (chương trình giảng dạy huấn luyện).
Top 5.000 Dweet theo điểm được xếp hạng, sau đó huấn luyện theo cách dần dần ưu tiên các chương trình được yêu thích hơn. Ban đầu mọi Dweet có xác suất được lấy mẫu như nhau; qua 400 bước huấn luyện, trọng số của các chương trình xếp hạng cao tăng dần, đến khi top 1.000 chiếm khoảng 67% xác suất lấy mẫu.
Kết quả là một bước đột phá: các phần tiếp nối sinh ra trở nên hấp dẫn về thị giác hơn nhiều. Đáng chú ý, cải thiện về khả năng dự đoán token còn lan sang cả những Dweet chưa từng được lấy mẫu trong quá trình huấn luyện curriculum — perplexity giảm từ 7,42 xuống 5,65.
 Phân bố trọng số lấy mẫu theo từng nhóm xếp hạng qua các bước huấn luyện
Đưa gu thẩm mỹ cá nhân vào mô hình
Bước tiến xa hơn là đưa sở thích thẩm mỹ của chính tác giả vào mô hình. Lấy cảm hứng từ bài viết của Surya về việc dùng học tăng cường (RL) để tạo tranh màu nước bằng p5js, nhà phát triển quyết định thử RLHF với thuật toán GRPO, trong đó bản thân anh đóng vai trò hàm phần thưởng.
Quy trình diễn ra như sau:
- Với mỗi Dweet dang dở, lấy mẫu một nhóm 8 phần hoàn thiện và render chúng cạnh nhau.
- Chọn phần nào đẹp nhất về thẩm mỹ; nếu không có phần nào hấp dẫn thì bỏ qua cả nhóm.
- Dùng các lựa chọn này để cập nhật policy của Demoscener.
- Lặp lại quy trình qua khoảng 9–10 vòng, mỗi vòng 500 nhóm.
Tổng cộng, tác giả đã xem thủ công khoảng 40.000 hoạt ảnh. Anh thừa nhận rằng vào khoảng hoạt ảnh thứ 10.000, mình mới bắt đầu thấy tiếc vì không dùng các mô hình VLM hay HPSv3 — nhưng đã quá muộn.
Kết quả kiểm chứng và giao diện khám phá
Sau nhiều vòng huấn luyện, câu hỏi là gu thẩm mỹ của tác giả đã "thấm" vào Demoscener đến đâu. Anh nhờ một người bạn đánh giá 400 bộ demo từ một số checkpoint (chọn ngẫu nhiên 4) mà không biết mô hình nào tạo ra bộ nào.
Kết quả cho thấy checkpoint 4 được ưa chuộng nhất, và anh dùng nó để chạy suy luận (inference) trên máy Mac của mình.
Cuối cùng là một giao diện nhỏ cho phép sinh nhiều phần tiếp nối từ cùng một tiền tố, render song song và rẽ nhánh từ bất kỳ phương án nào bắt mắt. Mỗi nhánh đại diện cho một hướng đi khả dĩ — có thể so sánh bằng mắt, chỉnh sửa bằng tay rồi tiếp tục khám phá từ đó.
 Giao diện duyệt và rẽ nhánh các phần tiếp nối demo
Có điều gì đó rất thú vị khi được lang thang qua những khả năng này. Tôi nghĩ mình sẽ dành thêm chút thời gian để làm đúng việc đó.
Ý nghĩa với cộng đồng lập trình Việt Nam
Câu chuyện của Demoscener không chỉ là một dự án phụ thú vị. Nó cho thấy mô hình ngôn ngữ nhỏ, được tinh chỉnh đúng cách trên miền dữ liệu hẹp, có thể đạt được kết quả vượt trội so với mô hình đa dụng — một bài học thiết thực cho các nhóm phát triển tại Việt Nam đang cân nhắc giữa việc dùng API lớn hay tự fine-tune mô hình mã nguồn mở.
Quy trình ba bước — continued pretraining → curriculum learning → RLHF — có thể áp dụng cho nhiều bài toán hẹp khác như sinh mã theo phong cách nội bộ, hay gợi ý hoàn thiện snippet trong một DSL đặc thù của doanh nghiệp.
Cuối cùng, dự án nhắc nhở rằng con người vẫn là thước đo thẩm mỹ. AI có thể sinh ra hàng nghìn khả năng, nhưng chính lập trình viên mới là người quyết định hướng đi nào đáng để theo đuổi.
Mô hình Demoscener-7B và bộ dữ liệu đã được công bố trên HuggingFace cho những ai muốn tự mình thử nghiệm.
Bài viết liên quan
Phần mềm
CVE-2026-98432: Lỗ hổng use-after-free trong TCP Linux nghiêm trọng nhất, kẻ tấn công từ xa có thể chiếm quyền root
31 tháng 10, 2026
Công nghệ
Tự chơi Contra NES ngay trên trình duyệt: dự án port từ hợp ngữ 6502 sang C rồi WebAssembly
31 tháng 10, 2026
Công nghệ
bootgpt: Mô hình ngôn ngữ 510 byte sống trong phân vùng khởi động, tự "mơ" log khởi động Linux
31 tháng 10, 2026