
Đừng bắt AI Agent tự quyết mọi bước: đưa mô hình quyết định vào công cụ để nhanh gấp 3 lần
Khi một AI Agent phải gọi hàng loạt công cụ nhỏ lẻ để xử lý một tác vụ lớn, mỗi lượt gọi đều tốn thêm thời gian và chi phí. Mô hình quyết định (decision model) đặt bên trong công cụ có thể đảm nhận các bước trung gian, giúp Agent chỉ cần gọi một lần. Thử nghiệm với bài toán tra cứu đơn hàng chậm giao cho thấy tốc độ nhanh hơn 2,85 lần và chi phí giảm gần 25%.
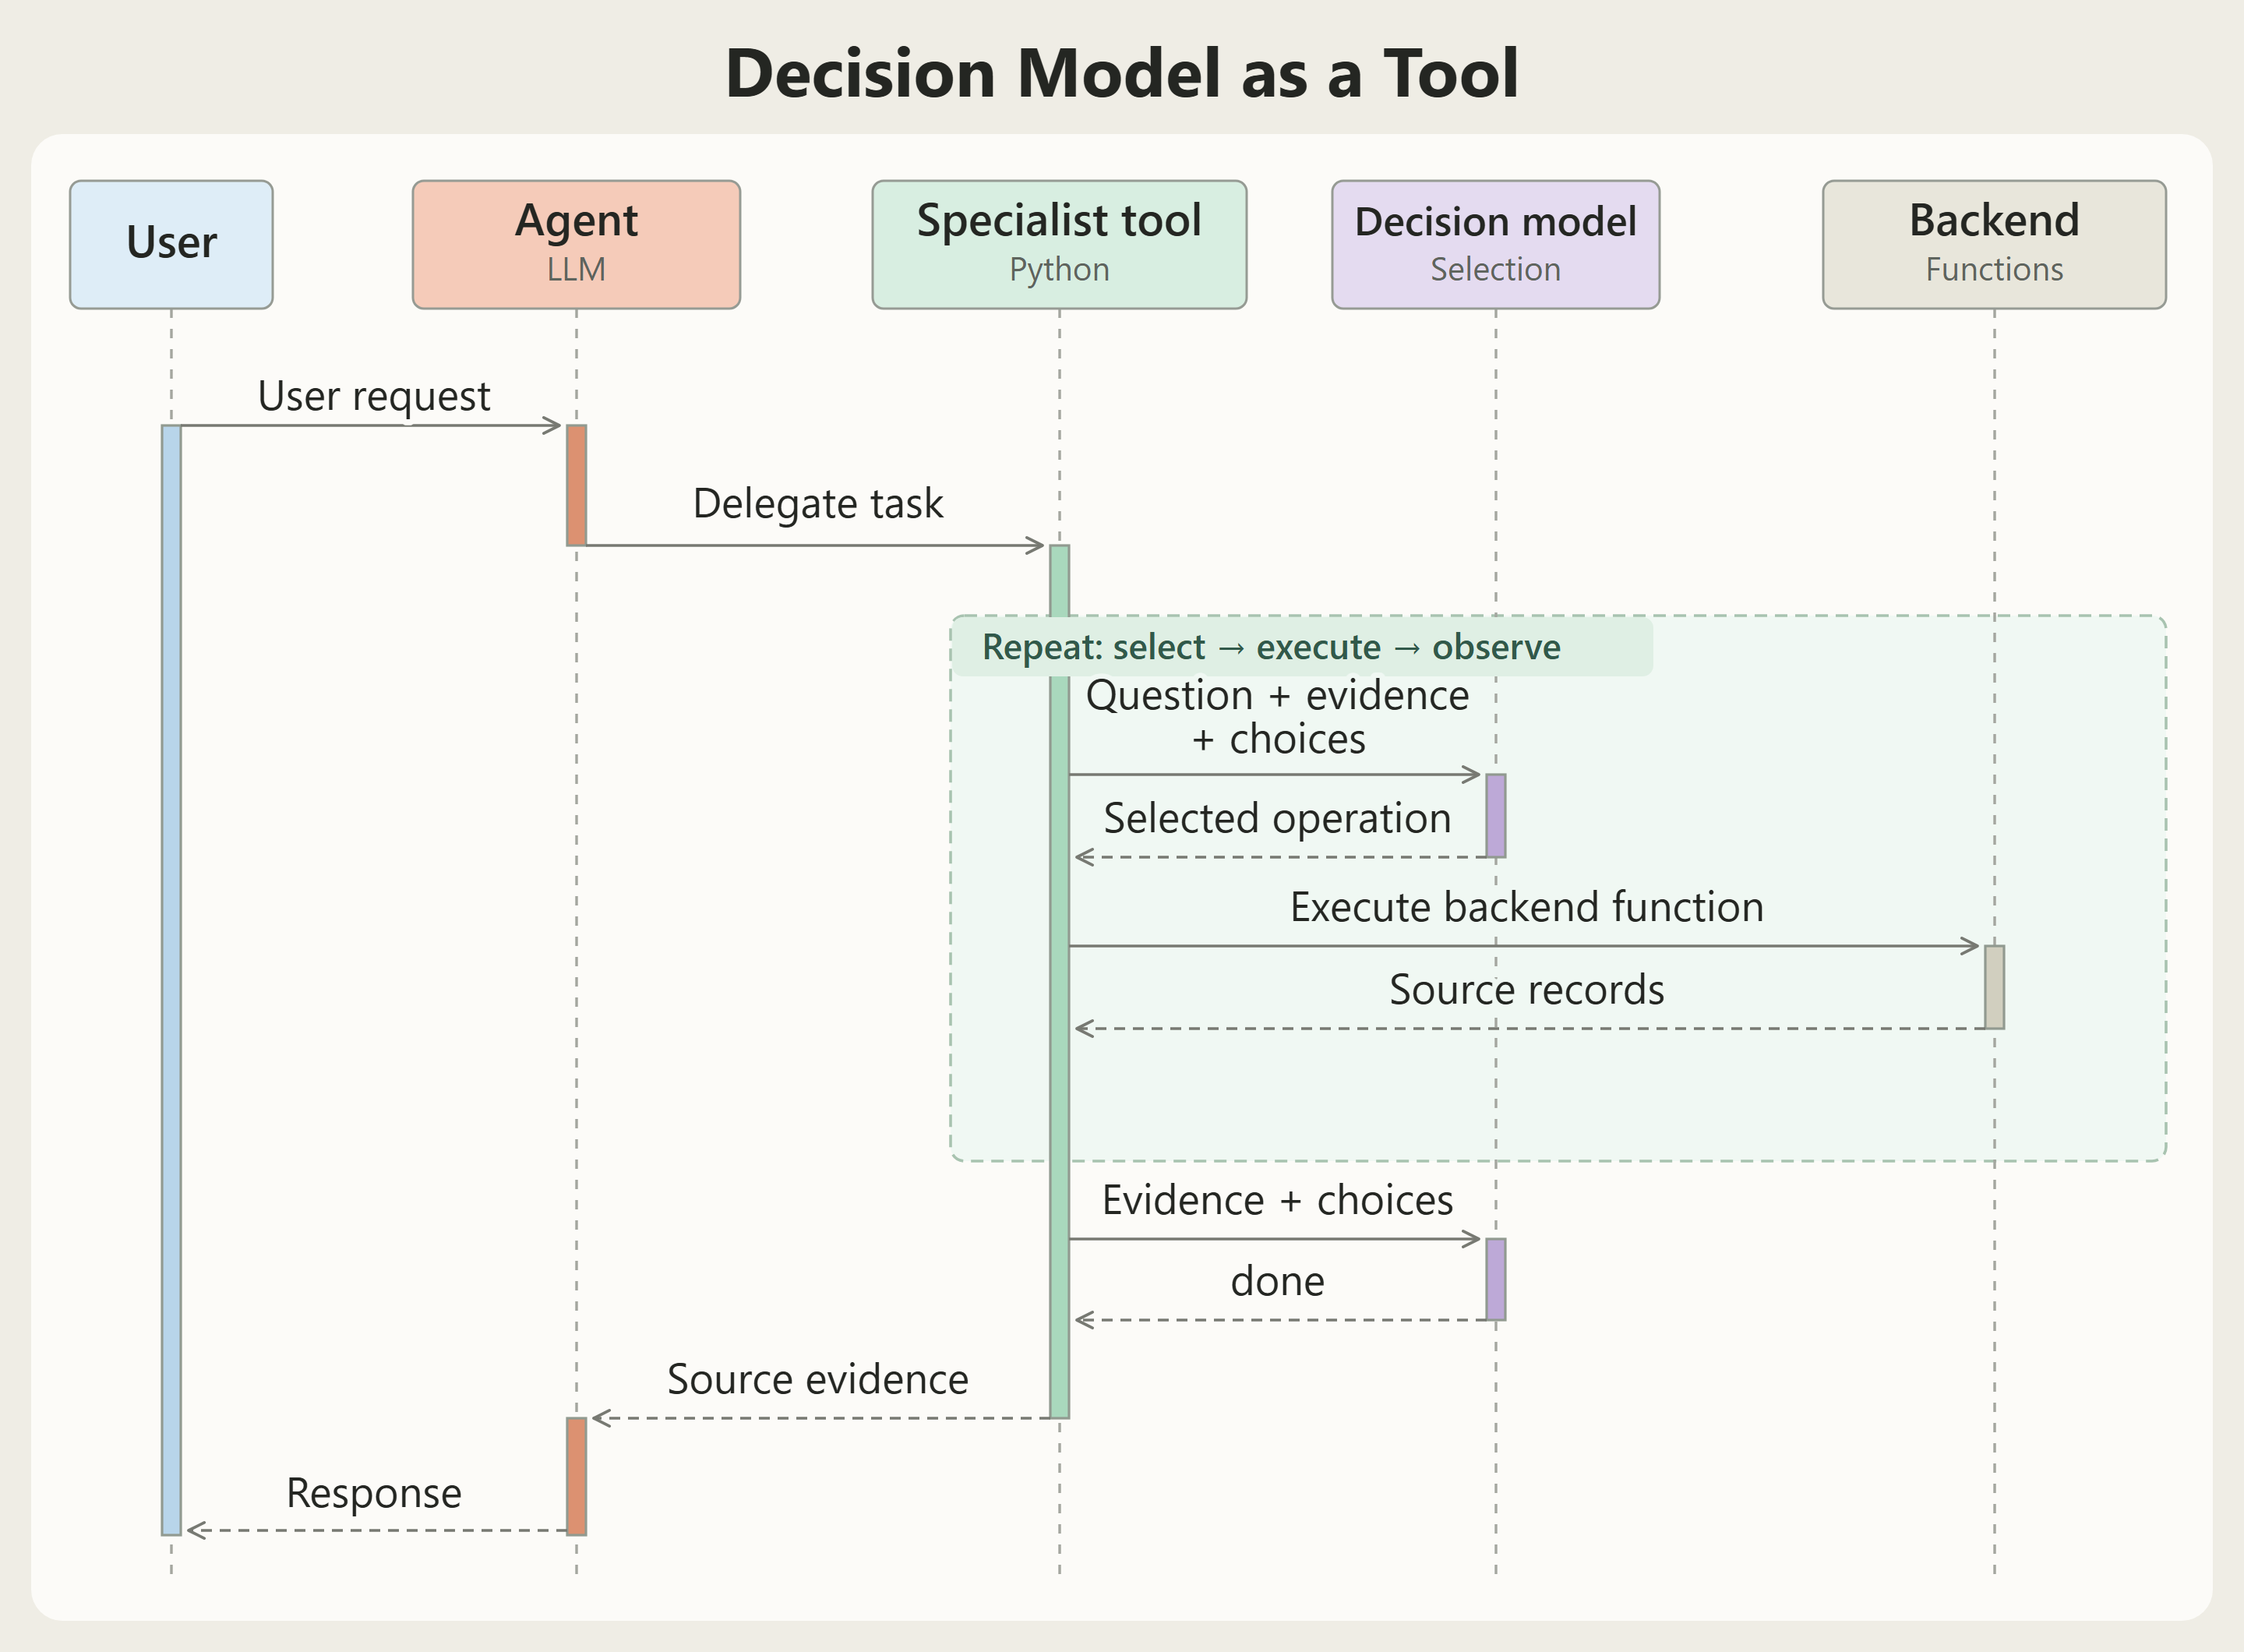
Chúng ta biến một LLM thành Agent bằng cách trang bị cho nó các công cụ (tool). Công cụ giúp Agent tra cứu dữ liệu, gọi API và thực thi hành động. Công thức quen thuộc là: Agent suy luận, công cụ thực thi.
Thông thường, mỗi công cụ chỉ đảm nhận một thao tác nhỏ. Với một tác vụ lớn hơn, Agent phải xoay vòng: gọi một công cụ, dựa trên kết quả quyết định bước tiếp theo, rồi gọi công cụ khác. Vấn đề nằm ở chỗ: nhiều quyết định trung gian ấy không hề khó. Phần lớn thời gian, Agent chỉ chọn bước hiển nhiên tiếp theo dựa trên kết quả vừa nhận được. Nhưng nó vẫn phải tự đưa ra lựa chọn đó, và mỗi vòng lặp là thêm một lần gọi LLM — kéo dài thời gian và đội chi phí.
Vậy nếu có thể giao trọn một mảng công việc chỉ qua một lần gọi công cụ thì sao? Với mô hình quyết định (decision model), điều này hoàn toàn khả thi.
Ý tưởng: để mô hình quyết định điều khiển luồng xử lý
Cách làm rất đơn giản: cho mô hình quyết định tự điều khiển luồng bên trong công cụ. Nó chọn một hành động, xem kết quả trả về, rồi quyết định bước kế tiếp. Vòng lặp này tiếp diễn cho đến khi thu thập đủ bằng chứng để trả về cho Agent.
Bởi mô hình quyết định được huấn luyện để ra quyết định nhanh và rẻ, các bước thường nhật giờ đây chỉ tốn một phần nhỏ thời gian và chi phí. Agent thực chất chỉ thực hiện một lần gọi công cụ và có thể dồn sức suy luận vào những điểm thật sự quan trọng.
Công thức mới là: Agent ủy thác công việc, công cụ quản lý các bước.
Vì mô hình quyết định được nhúng trong một công cụ mà Agent gọi, người ta gọi đây là mô hình decision-model-as-a-tool (mô hình quyết định đóng vai trò công cụ). Bài viết dưới đây sẽ cụ thể hóa mô hình này qua một nghiên cứu tình huống: xây dựng Agent hỗ trợ khách hàng, điều tra một đơn hàng chậm giao và tìm cách đáp ứng hạn giao hàng của khách.
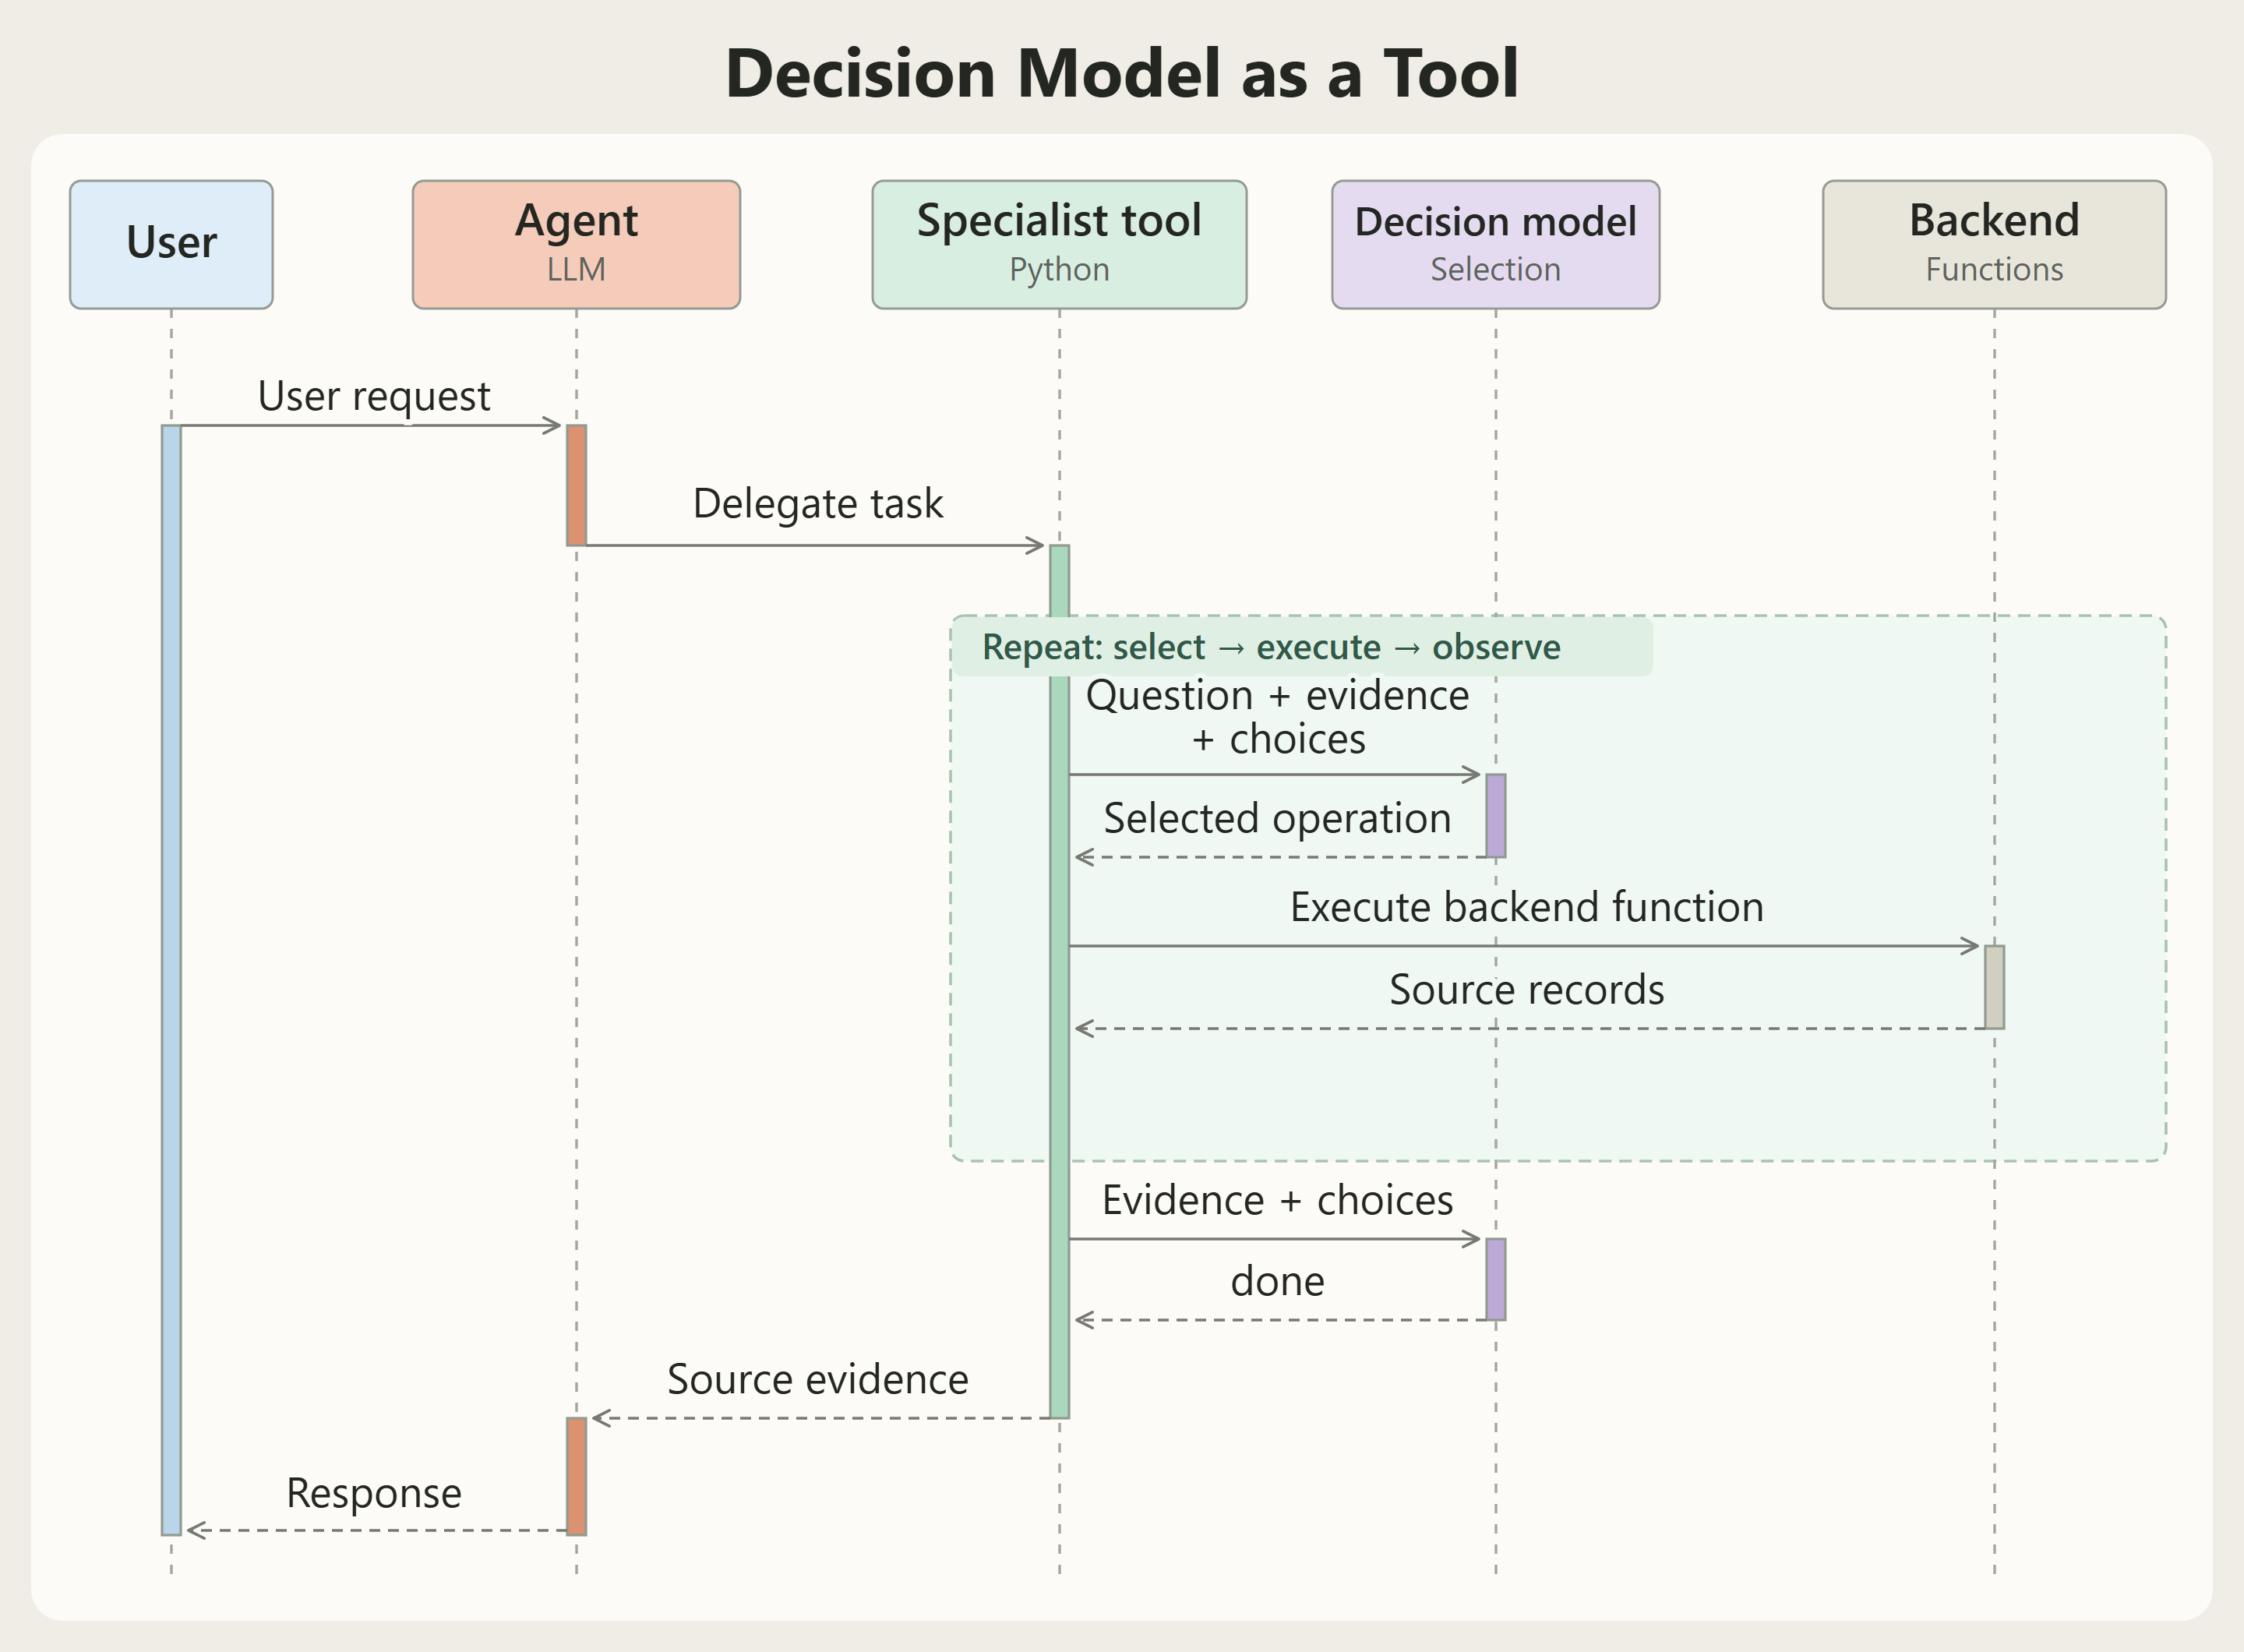 Mô hình mô hình quyết định đóng vai trò công cụ trong hệ thống AI Agent
Bài toán đặt ra
Giả sử khách hàng gửi yêu cầu: "Đơn hàng ORD-1042 của tôi vẫn chưa được gửi đi, và tôi cần nhận hàng trước thứ Sáu ngày 23/10. Bạn có thể tìm hiểu chuyện gì đang xảy ra và liệu có cách nào giao kịp không?"
Có hai điều cần làm rõ: vì sao đơn hàng bị chậm, và liệu có phương án giao hàng nào khác đáp ứng được hạn chót. Agent phải điều tra và đề xuất bước tiếp theo.
Trong tình huống này, ta có sáu hàm Python đại diện cho các thao tác mà Agent hỗ trợ có thể truy cập:
- get_order_details(): trạng thái đơn hàng, mặt hàng, điểm đến, kho và mã vận đơn
- get_tracking_events(): sự kiện vận chuyển và dự báo giao hàng
- get_fulfillment_notes(): ghi chú từ kho có thể giải thích nguyên nhân chậm trễ
- get_alternative_inventory(): tồn kho của cùng mặt hàng tại các kho khác
- get_shipping_options(): dự báo giao hàng, phụ phí và hạn chót xuất kho
- get_fulfillment_policy(): quy định về chuyển hướng đơn hàng và miễn phụ phí vận chuyển
Nếu xây dựng Agent theo cách thông thường, ta sẽ đưa cả sáu hàm này thành công cụ cho Agent tự gọi. Cách đó dĩ nhiên chạy được, nhưng liệu Agent có nhất thiết phải quản lý từng bước điều tra?
Vì sao nên gộp thành một công cụ?
Nhìn kỹ trình tự điều tra một đơn hàng chậm giao: kiểm tra đơn hàng → đọc ghi chú kho → tìm tồn kho ở nơi khác → so sánh phương án vận chuyển → kiểm tra quy định chuyển hướng. Đơn hàng khác có thể đi theo lộ trình khác.
Nhưng giữa các lần tra cứu, Agent luôn trả lời cùng một dạng câu hỏi: "Dựa trên câu hỏi và bằng chứng thu thập được, nên tra cứu gì tiếp theo, hay đã đủ?"
Nói cách khác, quá trình điều tra thực chất là một chuỗi quyết định, mỗi lần chọn một phương án từ danh sách có sẵn dựa trên những gì đã biết. Đây chính là điều mô hình quyết định được sinh ra để làm: nhận ngữ cảnh, rồi chọn một phương án.
Nếu mô hình quyết định đảm nhận được những lựa chọn này, Agent không cần tự quyết từng bước. Agent chỉ truyền vào mã đơn hàng và câu hỏi; công cụ sẽ tự quyết định cần chạy những tra cứu nào. Nhờ vậy, Agent chỉ thấy một giao diện đơn giản và tập trung vào phần việc thật sự cần LLM: hiểu yêu cầu và viết câu trả lời.
Cách các thành phần ăn khớp với nhau
Bên trong công cụ chuyên biệt, tại mỗi điểm quyết định, Python chuẩn bị danh sách các hàm khả dụng cùng tham số tương ứng dưới dạng các phương án riêng biệt, kèm theo bằng chứng đã thu thập làm ngữ cảnh. Mô hình quyết định chọn hàm cần chạy bằng cách trả về một mã hành động. Python gọi hàm đó và bổ sung kết quả vào kho bằng chứng, rồi yêu cầu quyết định tiếp theo.
Hai phương án dừng là done (đã đủ bằng chứng) và blocked (các thao tác hiện có không thể giải quyết câu hỏi) cũng được đưa vào danh sách lựa chọn. Toàn bộ vòng lặp nằm gọn trong một lần gọi công cụ thông thường do OpenAI Agents SDK quản lý, được đặt tên là order_specialist().
Điểm mấu chốt cần lưu ý: Agent không có quyền truy cập trực tiếp vào các hàm backend. Nó chỉ thấy một công cụ duy nhất là order_specialist(), và có thể gọi công cụ này với mã đơn hàng cùng câu hỏi. Khi công cụ trả về, Agent dùng bằng chứng thu thập được để trả lời khách hàng.
Xây dựng vòng lặp điều tra
Khi Agent gọi order_specialist(), ta chạy vòng lặp sau:
while True:
    actions = available_actions(order_id, evidence)
    choice, _ = await choose_decision(
        http, question, evidence, actions
    )
    if choice in {"done", "blocked"}:
        return {
            "question": question,
            "status": choice,
            "evidence": list(evidence),
        }
    function, arguments = actions[choice]
    result = function(**arguments)
    evidence.append({
        "name": function.__name__,
        "arguments": arguments,
        "result": result,
    })
Đầu tiên, ta chuẩn bị các hành động khả dụng, rồi yêu cầu mô hình quyết định chọn một hành động dựa trên câu hỏi và bằng chứng đã có. Mỗi mã hành động ánh xạ tới một hàm Python cùng tham số, nên actions[choice] cung cấp đủ mọi thứ để thực hiện tra cứu đã chọn.
Sau khi thực thi, kết quả được thêm vào bằng chứng và vòng lặp tiếp tục — nghĩa là quyết định tiếp theo có quyền truy cập vào những gì vừa học được.
Hàm trợ giúp available_actions() chuẩn bị các tra cứu dựa trên thông tin hiện có. Ban đầu chỉ biết mã đơn hàng, nên có thể đề xuất tra cứu chi tiết đơn hàng, ghi chú kho và quy định. Khi chi tiết đơn hàng lộ ra mã mặt hàng, tra cứu tồn kho trở nên khả dụng. Tra cứu vận chuyển xuất hiện khi đã có mã kho và điểm đến. Các tra cứu trùng lặp đã hoàn thành sẽ bị loại bỏ — danh sách lựa chọn thay đổi theo lượng bằng chứng tích lũy.
Để mô hình quyết định lựa chọn
Với các hành động khả dụng đã chuẩn bị, ta đưa chúng ra trước mô hình quyết định. Mỗi hành động được chuyển thành mô tả gồm tên hàm, tham số và docstring:
choices = {
    key: (
        f"{function.__name__}({json.dumps(arguments)}): "
        f"{function.__doc__}"
    )
    for key, (function, arguments) in actions.items()
}
Hai phương án dừng cũng được thêm vào, rồi gói yêu cầu gửi tới endpoint của mô hình:
body = {
    "model": "Decision-1",
    "state": {
        "question": question,
        "as_of": AS_OF,
        "evidence": evidence,
    },
    "questions": {
        "action": {
            "type": "choice",
            "instructions": (
                "Choose the next useful operation for this "
                "delegated question: " + question +
                " Use the observed records and collect missing evidence. "
                "Choose done when the evidence answers the question, "
                "or blocked if no available operation can obtain "
                "a needed fact."
            ),
            "criteria": choices,
        }
    },
}
Trường state giữ ngữ cảnh cho quyết định, bao gồm cả mốc thời gian hiện tại AS_OF vì câu hỏi liên quan tới hạn giao hàng. Phản hồi trả về mã hành động đã chọn, sau đó Python thực thi hàm tương ứng hoặc trả về bằng chứng nếu mô hình chọn phương án dừng.
Ngoài Azure, có thể truy cập mô hình quyết định qua OpenRouter với các lựa chọn như openai/gpt-6-luna-decisions hay typesafe/jev-1.14 — chỉ cần đổi mã mô hình, phần còn lại giữ nguyên.
Giao công cụ cho Agent
Tiếp theo, ta đưa công cụ này cho Agent LLM. Hàm order_specialist() được công bố bằng decorator @function_tool của OpenAI Agents SDK. Agent cung cấp order_id và question; docstring giải thích công cụ làm gì và các tham số mang ý nghĩa gì.
Tham số context do SDK cung cấp (không phải LLM), mang theo một dictionary Python để lưu bằng chứng và các quyết định trong quá trình điều tra. Với LLM vận hành Agent, ta dùng GPT-6-Luna trên Azure ở mức suy luận trung bình.
Chỉ dẫn cho Agent nhấn mạnh: trả lời dựa trên dữ liệu trả về, coi ngày giao hàng là dự báo, và mô tả các hành động chưa thực hiện như đề xuất. Agent được cấu hình chỉ với một công cụ duy nhất — mô hình quyết định bên trong công cụ lo toàn bộ việc điều tra.
Kết quả thử nghiệm
Trong lần chạy thử, Agent hoàn thành điều tra: giải thích nguyên nhân đơn hàng chậm và xác định được phương án giao hàng tiềm năng. Luna chỉ gọi order_specialist() một lần. Bên trong công cụ, Decision-1 chọn năm thao tác backend trước khi chọn done:
get_order_details("ORD-1042")
get_fulfillment_notes("ORD-1042")
get_alternative_inventory("LAMP-01")
get_shipping_options("WEST", "CH-8000")
get_shipping_options("REMOTE", "CH-8000")
done
Toàn bộ lần chạy mất 8,9 giây.
Để so sánh, một Agent khác được cấu hình truy cập trực tiếp vào cả sáu hàm backend, giữ nguyên mọi thứ khác (model Luna, chỉ dẫn, thiết lập) và gọi công cụ song song bị tắt. Agent này cũng hoàn thành điều tra và đưa ra cùng khuyến nghị cốt lõi, nhưng phải gọi Luna sáu lần và mất 25,4 giây.
Kết quả: thiết lập mô hình quyết định đóng vai trò công cụ nhanh hơn 2,85 lần, với chi phí gọi mô hình thấp hơn 24,7%.
Kết luận
Phần lớn công cụ của Agent chỉ bọc một thao tác, và thường thì đó là lựa chọn đúng. Nhưng khi Agent cứ lặp đi lặp lại vài thao tác giống nhau, đã đến lúc tự hỏi liệu nó có cần nằm trong vòng lặp đó hay không.
Trong ví dụ trên, việc chuyển các lựa chọn thường nhật vào bên trong công cụ giúp lần chạy nhanh gần gấp ba và rẻ hơn khoảng một phần tư, trong khi Agent vẫn đi đến cùng khuyến nghị. Bài học rút ra rất rõ: Agent không nhất thiết phải tự quyết mọi bước — một số quyết định có thể sống ngay trong công cụ của nó.
Với các đội ngũ phát triển sản phẩm AI tại Việt Nam, nơi chi phí gọi LLM và độ trễ phản hồi là bài toán thường trực, mô hình này là một hướng tối ưu đáng cân nhắc — đặc biệt với các tác vụ có quy trình ổn định như tra cứu đơn hàng, chăm sóc khách hàng hay xử lý hồ sơ nội bộ.
Bài viết liên quan
Công nghệ
NHS cảnh báo rủi ro dữ liệu bệnh nhân sau khi nhà cung cấp website phá sản
30 tháng 10, 2026
Phần mềm
Phát hiện backdoor trong tiện ích chính thức Claude Code cho VS Code trên Cursor Marketplace
30 tháng 10, 2026
Công nghệ
Anthropic nộp hồ sơ IPO: Lời mời gọi đầu tư vào 'phép màu' của Thung lũng Silicon
30 tháng 10, 2026