
EEG và bẫy đánh giá: Khi mô hình học thuộc lòng người thay vì học tín hiệu
Một nghiên cứu trên dữ liệu EEG cho thấy cách chia tập train/test ảnh hưởng lớn đến kết quả đánh giá mô hình máy học. Khi cửa sổ tín hiệu của cùng một người xuất hiện ở cả hai tập, độ chính xác tăng vọt nhưng không phản ánh khả năng tổng quát hóa thực sự. Với SVM RBF, khoảng cách giữa hai cách đánh giá lên tới 0,263 điểm.
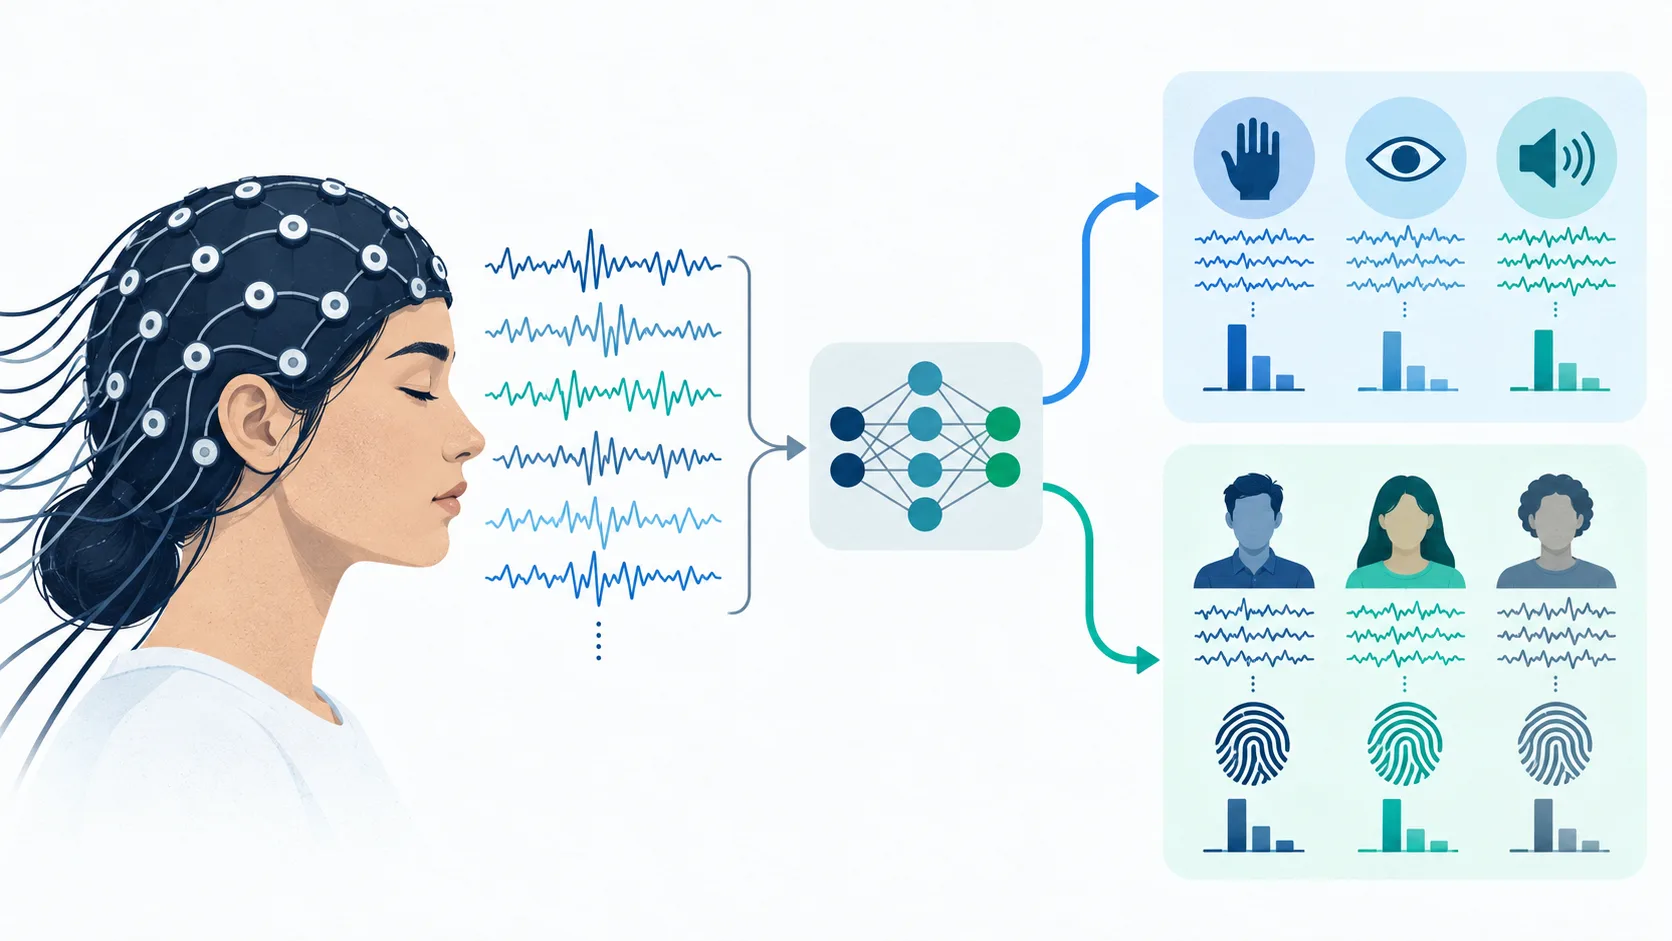
EEG và bẫy đánh giá: Khi mô hình học thuộc lòng người thay vì học tín hiệu
Trong các bài toán máy học dựa trên dữ liệu điện não đồ (EEG), cách chia tập huấn luyện và kiểm thử có thể quyết định mô hình "giỏi" hay "dở" hơn cả bản thân thuật toán. Một nghiên cứu mới trên bộ dữ liệu PhysioNet cho thấy khi các cửa sổ tín hiệu của cùng một người xuất hiện ở cả hai tập, độ chính xác tăng rõ rệt nhưng đó chỉ là sự quen thuộc với từng cá nhân, không phải khả năng tổng quát hóa. Với SVM nhân RBF, khoảng cách này lên tới 0,263 điểm balanced accuracy.
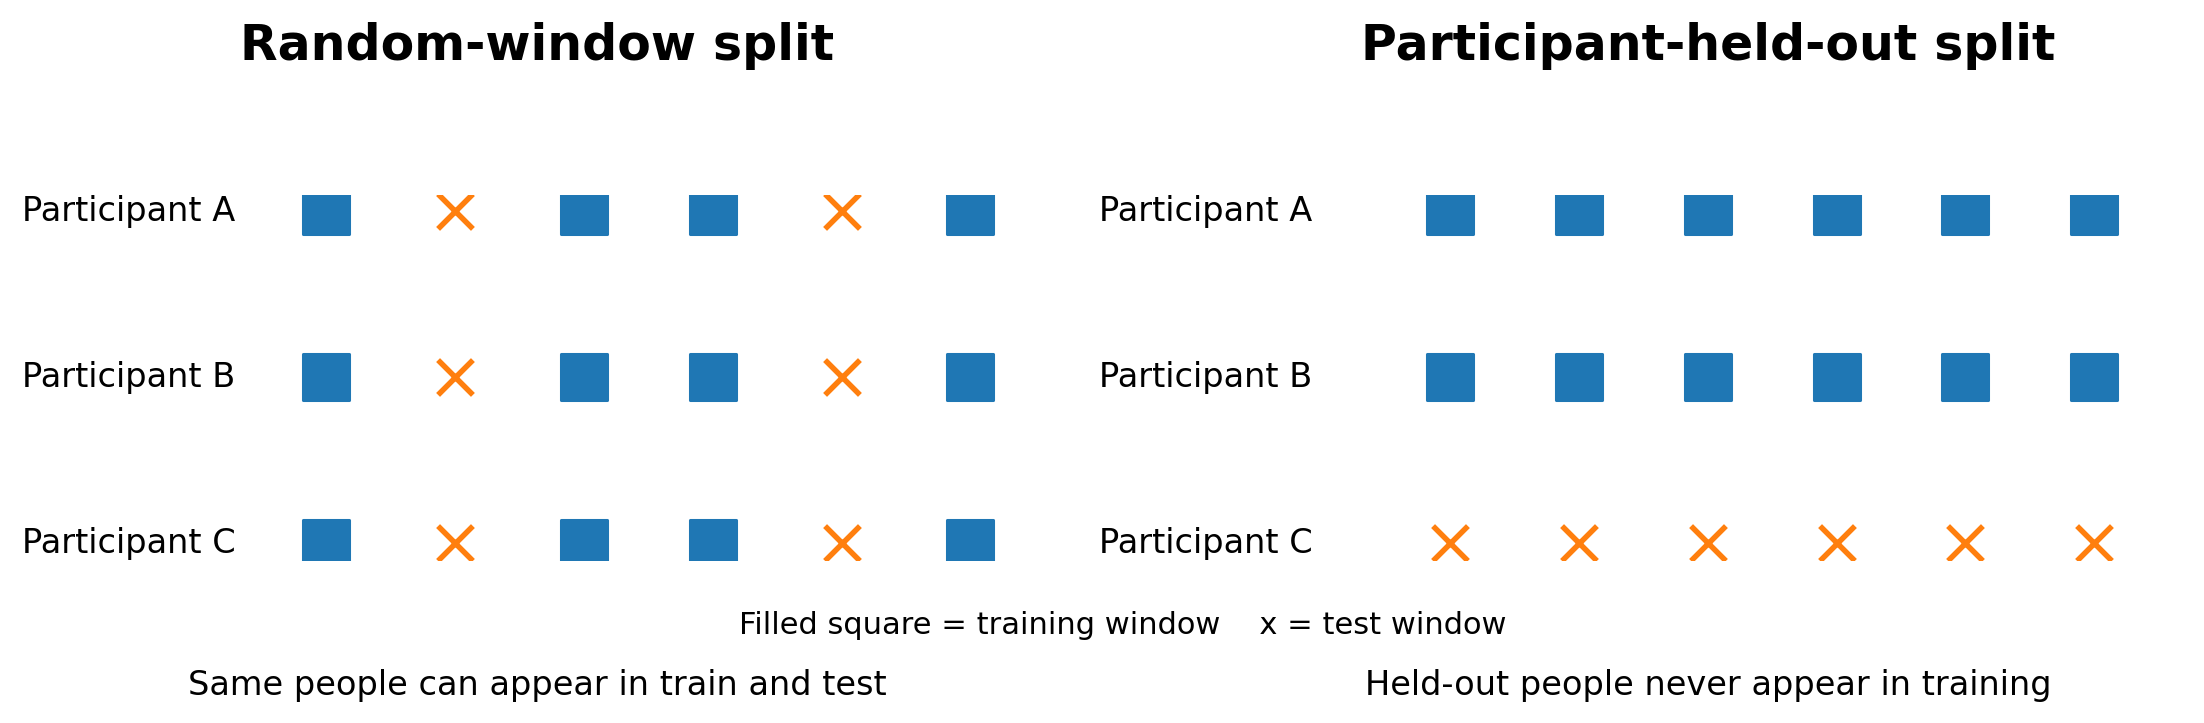 Minh họa đánh giá mô hình EEG
Vấn đề: cửa sổ tín hiệu không phải là con người
Dữ liệu EEG thường có rất nhiều mẫu nhưng chỉ đến từ một số ít người tham gia. Một bản ghi dài có thể được cắt thành hàng nghìn cửa sổ nhỏ, rồi chia ngẫu nhiên thành tập train và test. Cách làm này tạo cảm giác về một tập dữ liệu lớn, nhưng thực chất lại kiểm tra mô hình trên chính những người mà nó đã từng "nhìn thấy".
Điều này đặc biệt nguy hiểm vì tín hiệu EEG mang đậm dấu ấn cá nhân: đặc điểm giải phẫu, vị trí đặt điện cực, đặc tính phiên đo và cả các nhiễu tồn dư đều khác nhau giữa mỗi người. Khi mô hình học được những dấu vết này, nó có thể đạt điểm cao mà không hề học được đặc trưng sinh lý thực sự của nhiệm vụ.
Vấn đề không chỉ giới hạn ở EEG. Bất kỳ bài toán máy học nào xây dựng từ dữ liệu đo lặp lại — cảm biến đeo, giám sát y tế, dữ liệu hành vi — đều có thể gặp bẫy tương tự.
Thiết lập thí nghiệm: đơn giản để cô lập biến số
Nhóm nghiên cứu sử dụng bộ dữ liệu EEG During Mental Arithmetic Tasks (EEGMAT) của PhysioNet, gồm 36 bản ghi EEG ở hai trạng thái: nghỉ ngơi và làm phép tính nhẩm.
Quy trình xử lý:
- Sử dụng 19 kênh điện cực theo hệ 10/20, bỏ kênh tham chiếu tai và kênh ECG
- Lọc thông dải 1–40 Hz, cắt thành các cửa sổ 4 giây không chồng lấn
- Tổng cộng thu được 2.134 cửa sổ: 1.594 cửa sổ nền và 540 cửa sổ làm phép tính
- Tính mật độ phổ công suất bằng phương pháp Welch, lấy công suất tương đối ở bốn dải theta, alpha, beta và low gamma
- Kết quả: 76 đặc trưng cho mỗi cửa sổ (19 kênh × 4 dải)
Nhóm chủ động chọn các đặc trưng phổ cổ điển, dễ hiểu thay vì tìm kiếm dấu ấn sinh học mới, để có thể tách bạch ảnh hưởng của phương pháp đánh giá.
Ba mô hình được so sánh: hồi quy logistic có trọng số lớp, SVM nhân RBF và rừng ngẫu nhiên 300 cây. Hai giao thức đánh giá được áp dụng song song:
- Chia ngẫu nhiên theo cửa sổ: 10 lần chia 80/20 phân tầng, cho phép cùng một người góp mặt ở cả hai tập
- Giữ riêng người tham gia (GroupKFold 6 fold): toàn bộ cửa sổ của người thuộc tập test không xuất hiện trong tập train
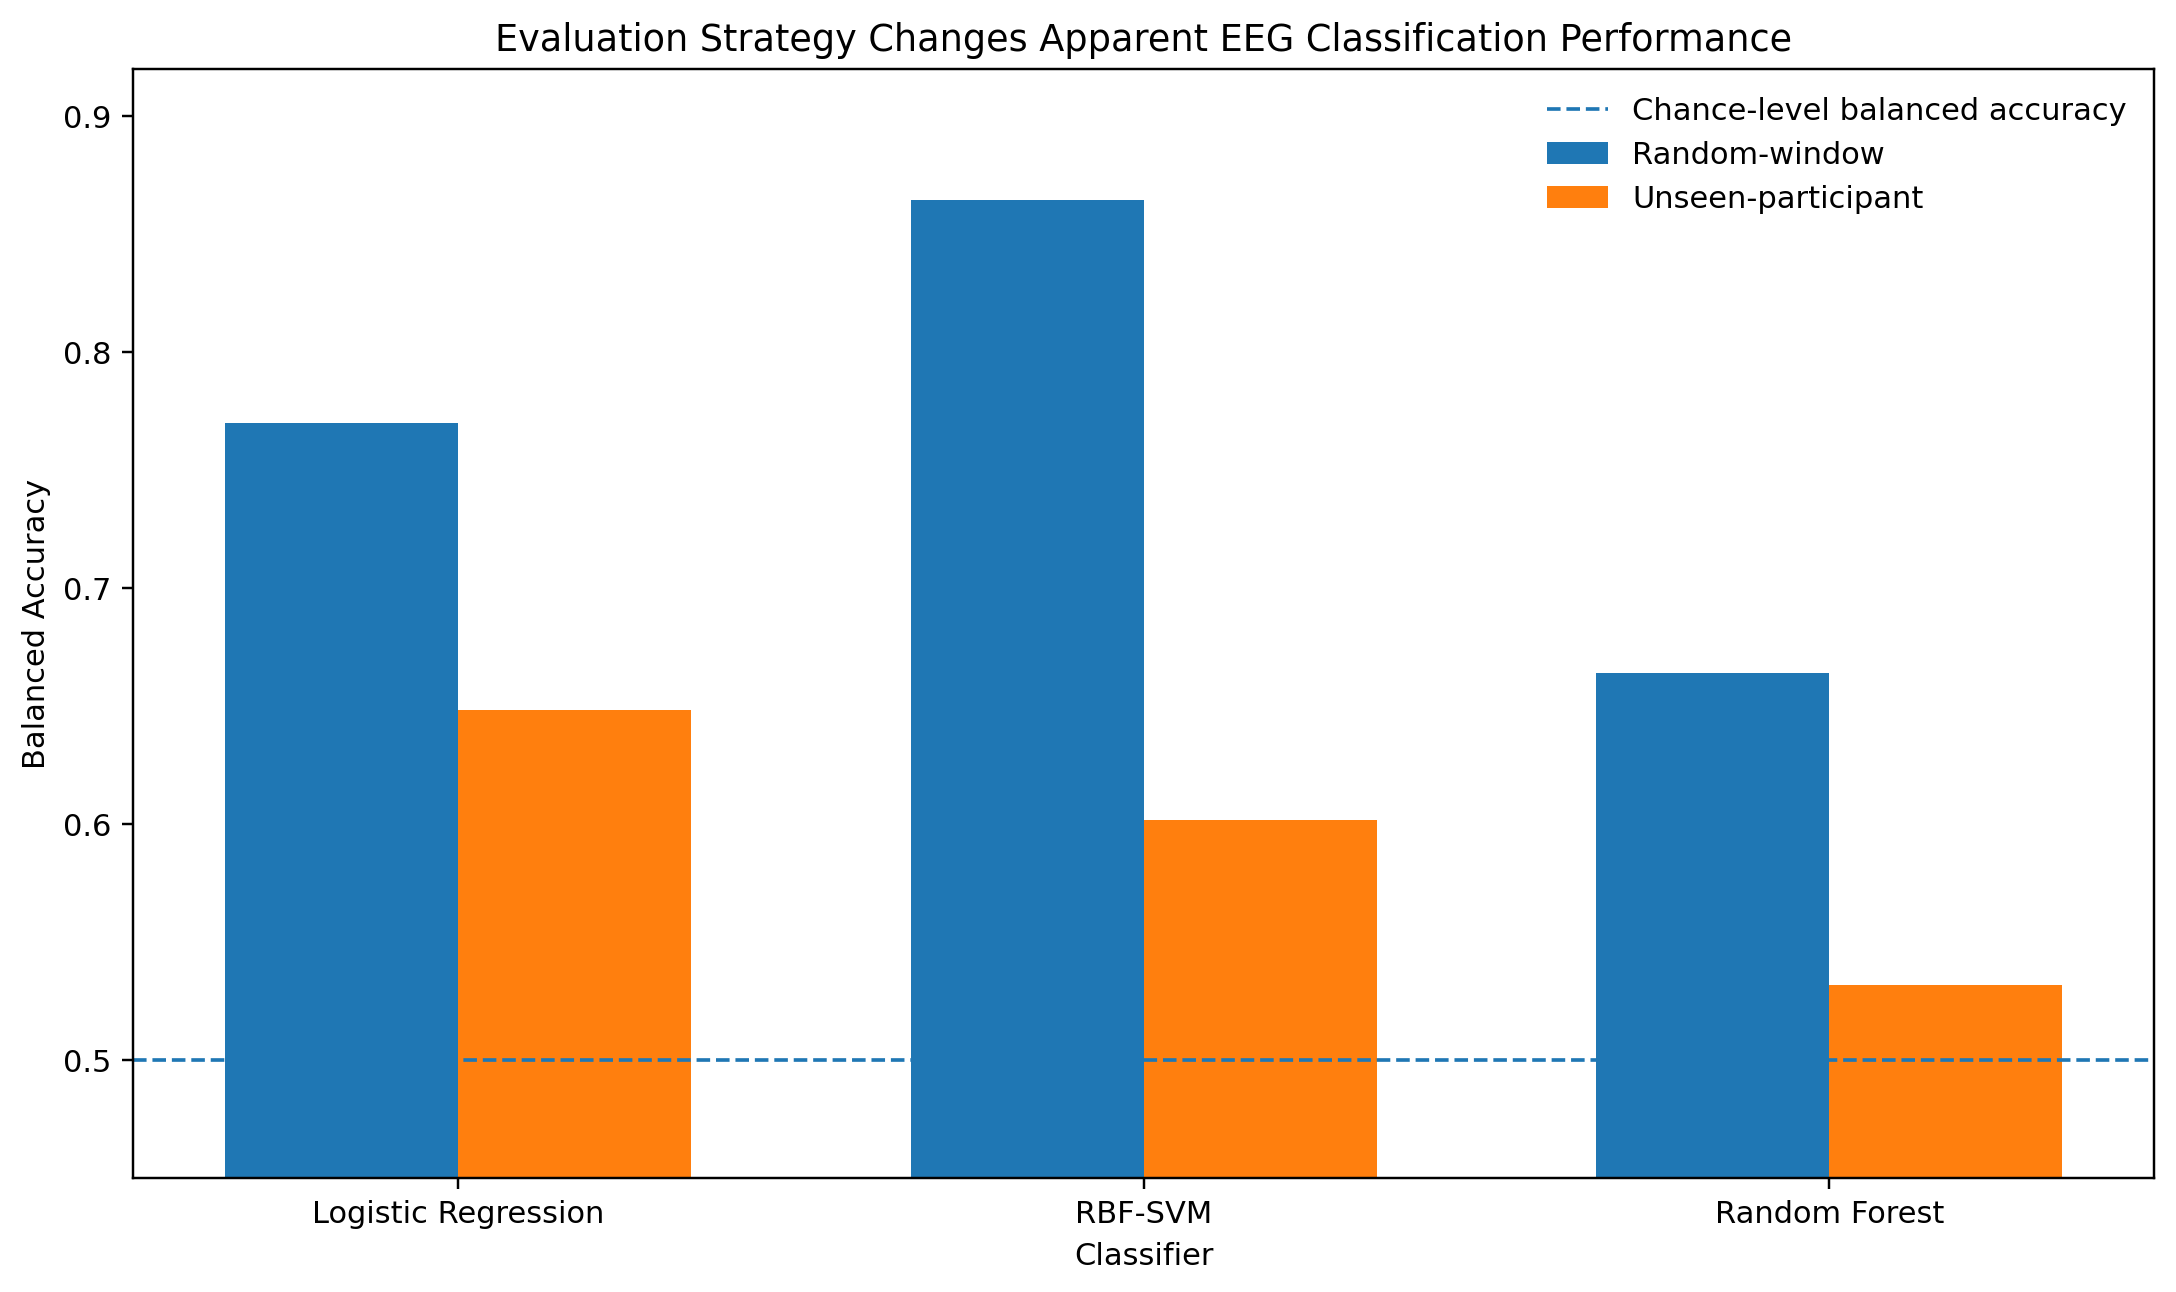 So sánh hai giao thức đánh giá
Kết quả: khoảng cách hiệu năng rất lớn
Cả ba mô hình đều giảm hiệu năng khi phải dự đoán trên người hoàn toàn mới:
- Hồi quy logistic: từ 0,770 xuống 0,648 balanced accuracy
- Rừng ngẫu nhiên: từ 0,664 xuống 0,532
- SVM nhân RBF: từ 0,864 xuống 0,602 — chênh lệch lên tới 0,263 điểm
Chỉ số ROC-AUC cũng cho xu hướng tương tự, khi lần lượt giảm từ 0,849 xuống 0,699; từ 0,932 xuống 0,671 và từ 0,909 xuống 0,691. Điều đáng chú ý là khoảng cách xuất hiện ở cả mô hình tuyến tính, mô hình kernel phi tuyến lẫn mô hình dạng cây, nên khó có thể quy cho sự bất thường của một thuật toán riêng lẻ.
Kiểm chứng: mô hình nhận diện được từng người
Để kiểm tra xem dữ liệu có thực sự chứa thông tin nhận dạng cá nhân hay không, nhóm nghiên cứu đổi hẳn mục tiêu: thay vì phân loại trạng thái, mô hình phải đoán cửa sổ thuộc về ai trong 36 người.
Kết quả gây bất ngờ: độ chính xác 95,6%, trong khi mức ngẫu nhiên chỉ là 2,8%. Sau khi cân bằng số cửa sổ giữa hai điều kiện cho từng người (15 nền và 15 phép tính, tổng 1.080 cửa sổ), độ chính xác vẫn đạt 94,0% — gấp 33,8 lần mức ngẫu nhiên, và độ chính xác top-3 lên tới 99,5%.
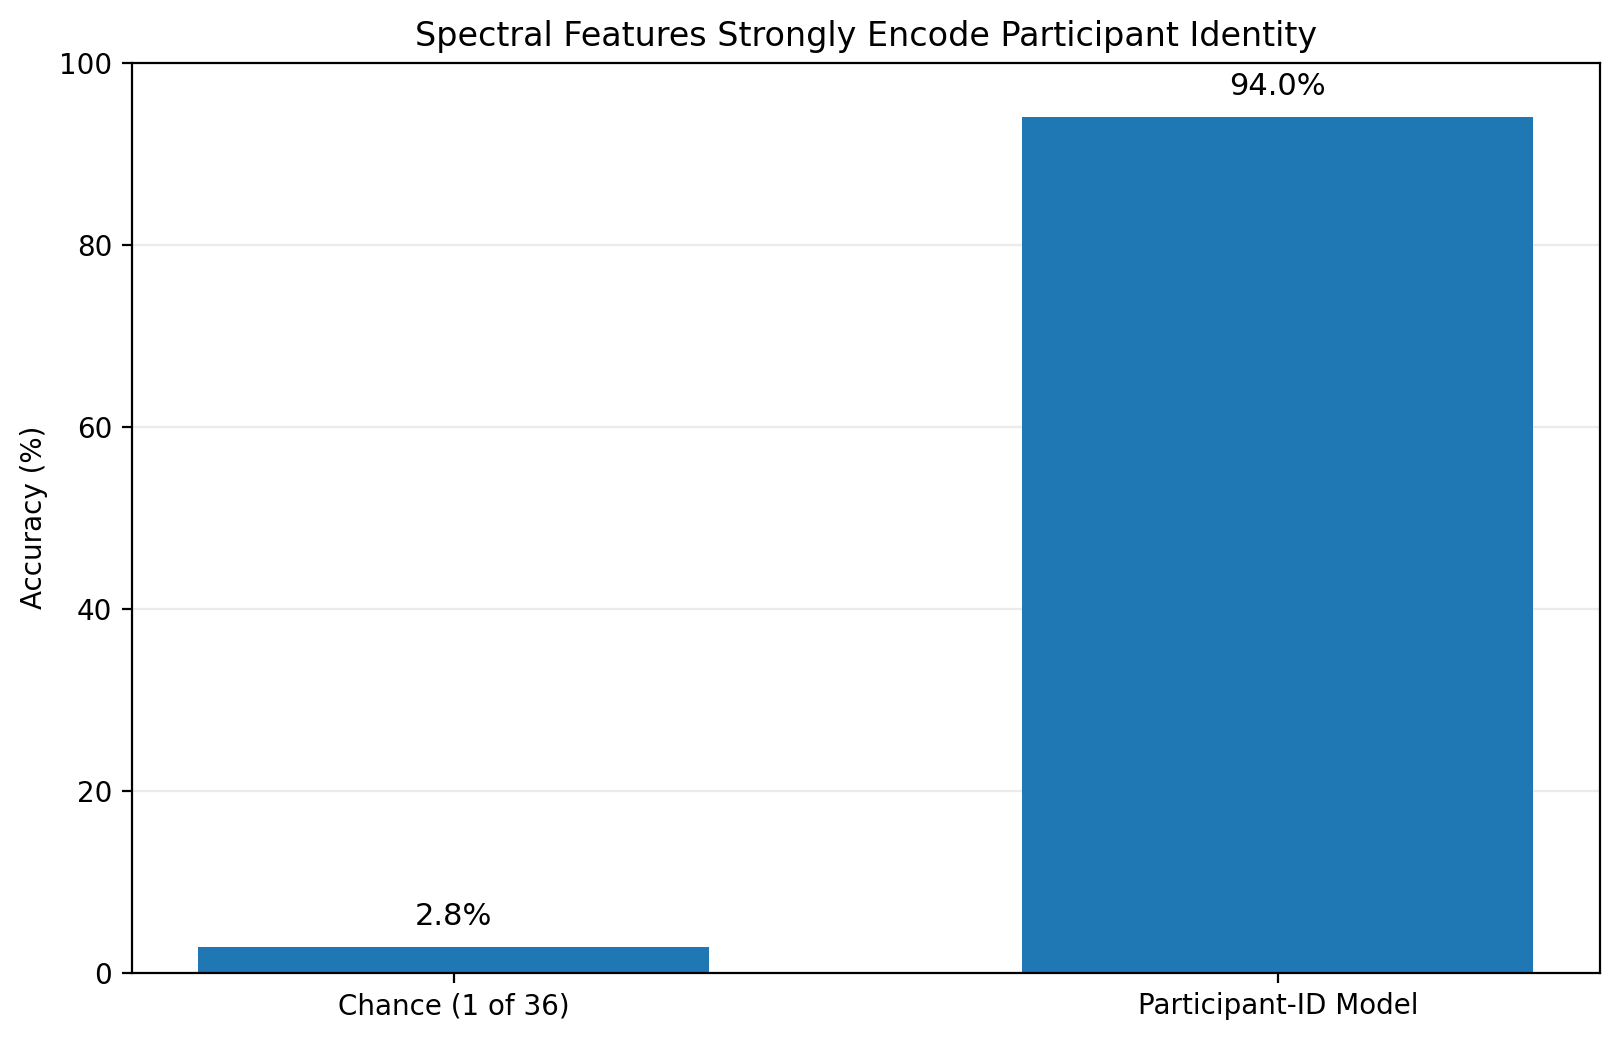 Độ chính xác nhận dạng người tham gia
Kết quả này không chứng minh mô hình phân loại nhiệm vụ dùng danh tính người làm quy tắc quyết định, nhưng cho thấy biểu diễn đặc trưng chứa rất nhiều thông tin riêng của từng cá nhân — đủ để khiến đánh giá kiểu chia ngẫu nhiên trở nên lạc quan quá mức.
Loại trừ ảnh hưởng của mất cân bằng dữ liệu
Tập dữ liệu gốc vốn mất cân bằng (1.594 cửa sổ nền so với 540 cửa sổ phép tính). Nhóm nghiên cứu lặp lại thí nghiệm trên tập con cân bằng 1.080 cửa sổ và vẫn thu được khoảng cách tương tự: 0,120 với hồi quy logistic, 0,194 với SVM RBF và 0,167 với rừng ngẫu nhiên. Như vậy mất cân bằng lớp không phải nguyên nhân duy nhất của chênh lệch.
Mô hình giỏi trung bình chưa chắc giỏi với mọi người
Khi phân tích riêng từng người trong giao thức giữ riêng người tham gia, hồi quy logistic đạt balanced accuracy trung bình 0,649, trung vị 0,644 và độ lệch chuẩn 0,143. Khoảng tin cậy 95% của giá trị trung bình là 0,602–0,695 sau 10.000 lần bootstrap.
Đáng chú ý hơn, hiệu năng từng cá nhân dao động từ 0,289 đến 0,956, và 5 trong số 36 người có kết quả dưới ngưỡng ngẫu nhiên 0,50. Một con số trung bình đẹp không phản ánh được sự khác biệt lớn giữa các đối tượng — điều rất quan trọng nếu ứng dụng vào thực tế lâm sàng hay thiết bị đeo.
Bài học: tập test phải khớp với tuyên bố tổng quát hóa
Kết luận mạnh nhất của nghiên cứu mang tính phương pháp luận: cách thiết kế đánh giá thay đổi đáng kể hiệu năng biểu kiến của mô hình EEG. Cùng một biểu diễn đặc trưng, cùng một nhiệm vụ, nhưng kết quả khác nhau tùy theo việc có cho phép người tham gia xuất hiện ở cả hai tập hay không.
Nguyên tắc đơn giản: cách chia dữ liệu phải khớp với tuyên bố về khả năng tổng quát hóa. Nếu muốn khẳng định mô hình hoạt động trên người mới, thì người đó không được xuất hiện trong tập huấn luyện.
Điều này áp dụng cho mọi bước học máy, không chỉ việc chia tập: chuẩn hóa dữ liệu, chọn đặc trưng, giảm chiều và tinh chỉnh siêu tham số đều phải tuân thủ cùng ranh giới đó. Việc chia theo cửa sổ chỉ hợp lý khi câu hỏi nghiên cứu đúng là về các đoạn mới từ những người đã được quan sát.
Giới hạn của nghiên cứu
Nhóm tác giả thừa nhận đây là một phép thử có chủ đích, không phải tuyên bố phổ quát về máy học EEG: chỉ một bộ dữ liệu công khai với 36 người, một biểu diễn phổ thủ công. Các mạng học sâu, đặc trưng kết nối, mô hình trên dạng sóng thô hay bộ dữ liệu lớn hơn có thể cho khoảng cách khác.
Hai giao thức chính cũng dùng cấu trúc lấy mẫu khác nhau (10 lần chia ngẫu nhiên so với 6 fold theo nhóm người), nên chênh lệch chỉ mang tính mô tả chứ không phải ước lượng nhân quả chính thức về rò rỉ dữ liệu. Nghiên cứu cũng chưa xác định được thông tin cá nhân đến từ kênh hay dải tần nào — một hướng mở cho các thí nghiệm tiếp theo.
Ý nghĩa với cộng đồng làm AI y tế và thiết bị đeo
Với các nhóm nghiên cứu và startup công nghệ y tế tại Việt Nam đang phát triển thiết bị đeo, ứng dụng theo dõi sức khỏe hay mô hình chẩn đoán từ tín hiệu sinh học, bài học này rất thiết thực. Dữ liệu từ một người dùng thường được ghi lặp lại qua nhiều phiên, tạo ra hàng nghìn mẫu — nhưng nếu chia ngẫu nhiên, mô hình dễ "học thuộc" đặc điểm của chính người đó.
Con số quan trọng nhất trong một mô hình EEG có thể không phải độ chính xác, mà là định nghĩa của tập kiểm thử. Toàn bộ phân tích được thực hiện bằng Python với MNE, NumPy, pandas, SciPy, matplotlib và scikit-learn, với mã nguồn đi kèm để tái lập kết quả.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Tai nghe có dây của Bose: Đơn giản nhưng đầy bất ngờ với chống ồn chủ động
17 tháng 10, 2026