
Bao nhiêu kênh EEG là đủ? Bài học từ việc cắt giảm 58% cảm biến
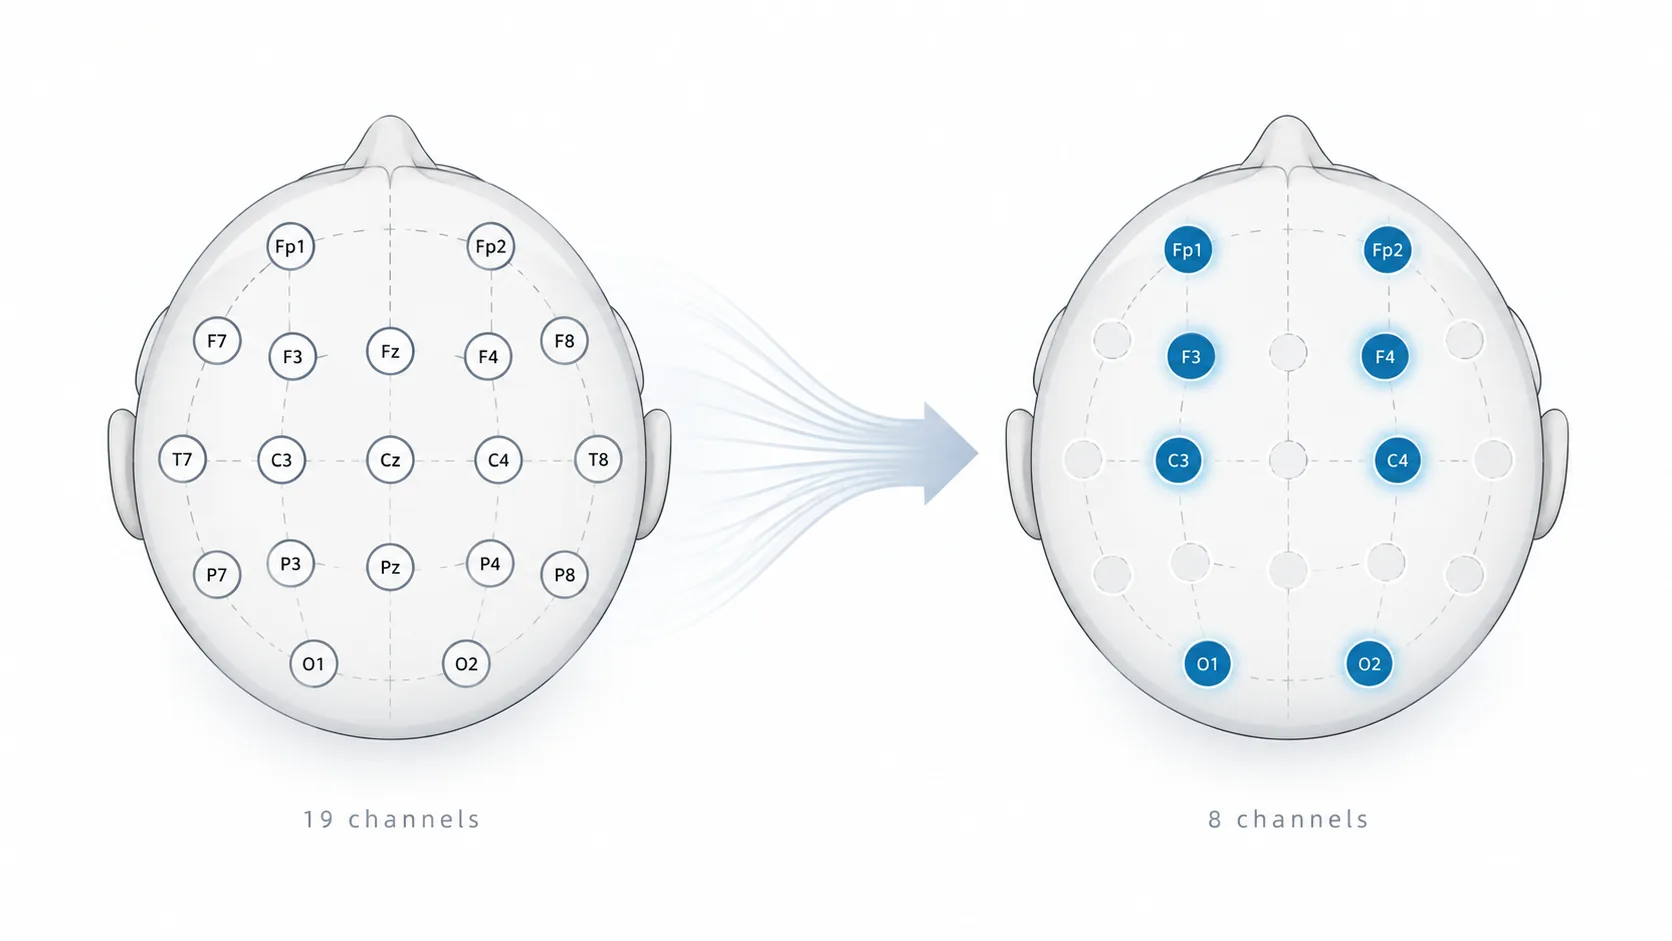
Một nghiên cứu trên bộ dữ liệu EEG 19 kênh cho thấy có thể giảm xuống còn 8 kênh mà vẫn giữ phần lớn độ chính xác phân loại. Đáng chú ý hơn, các kênh được xếp hạng \"quan trọng\" lại không vượt trội so với các kênh chọn ngẫu nhiên khi kiểm thử trên người tham gia chưa từng thấy — một bài học quan trọng về sự khác biệt giữa mức độ quan trọng của đặc trưng và khả năng tổng quát hóa.
Bao nhiêu kênh EEG là đủ? Bài học từ việc cắt giảm 58% cảm biến
Trong các hệ thống dựa trên cảm biến, một giả định quen thuộc thường được đặt lên bàn trước tiên: nếu có nhiều phép đo hơn thì nên dùng hết. Nhưng giả định này đặc biệt tốn kém với EEG — mỗi kênh thêm vào là thêm một điện cực, thêm một luồng tín hiệu, thêm độ phức tạp khi thiết lập và thêm một khối đặc trưng phải xử lý lúc suy luận.
 Minh họa hệ thống thu nhận tín hiệu EEG
Một phân tích mới trên bộ dữ liệu EEG công khai đã đặt câu hỏi rất thực tế: liệu có cần đủ 19 kênh điện cực trên da đầu để phân loại giữa trạng thái nghỉ và trạng thái tính nhẩm ở những người chưa từng xuất hiện trong tập huấn luyện hay không?
Cắt giảm cảm biến mà không đánh mất độ chính xác
Nhóm nghiên cứu lần lượt rút gọn biểu diễn 19 kênh ban đầu xuống còn 12, 8, 4, 2 và 1 kênh, trong khi giữ nguyên toàn bộ quy trình tiền xử lý, đặc trưng phổ, các họ mô hình và cách đánh giá theo kiểu giữ riêng người tham gia.
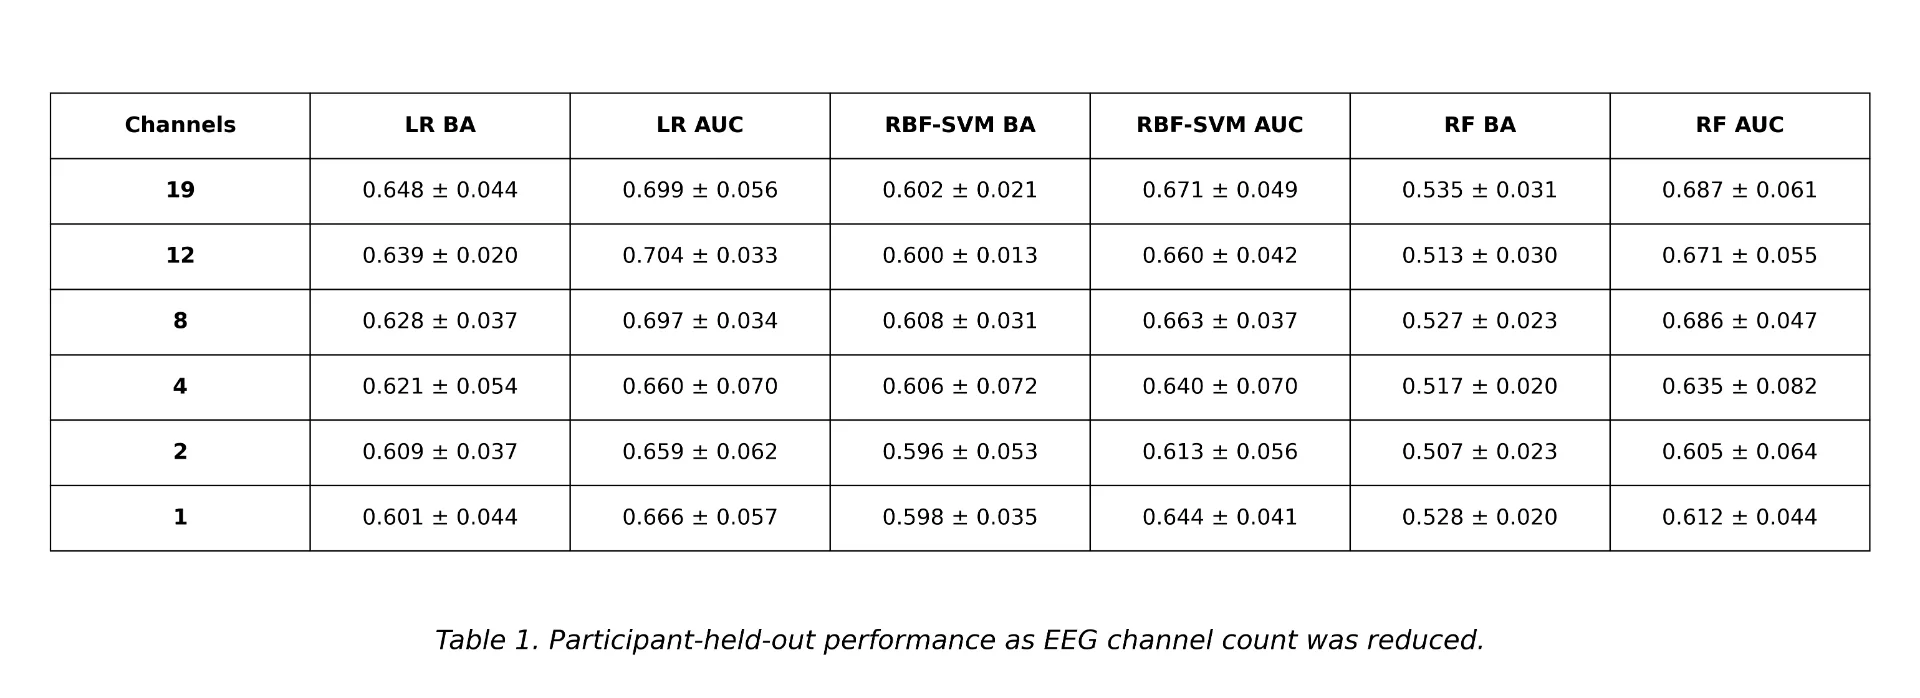
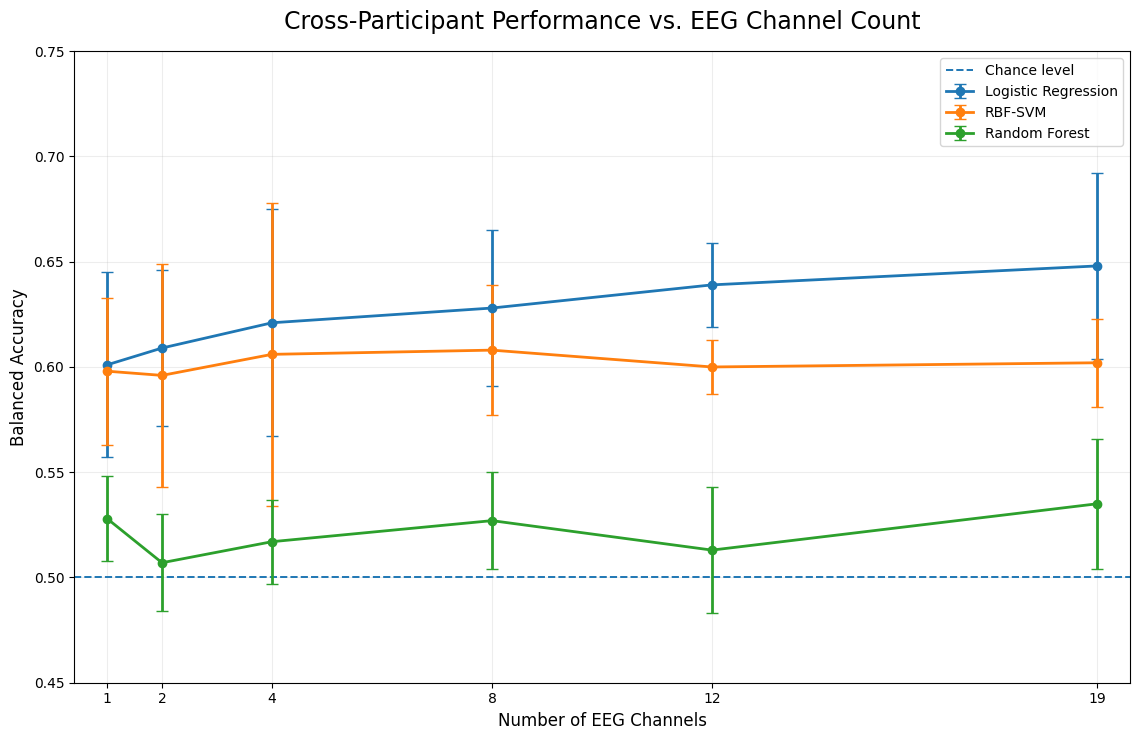
Kết quả đầu tiên khá đơn giản: giảm mạnh số kênh chỉ làm thay đổi tương đối nhỏ hiệu năng trên những người tham gia chưa từng thấy.
- Hồi quy logistic giảm từ 0,648 xuống 0,628 độ chính xác cân bằng khi đi từ 19 kênh xuống 8 kênh — chênh lệch chỉ 0,020. Chỉ số AUC gần như đứng yên, từ 0,699 xuống 0,697.
- SVM với kernel RBF thậm chí không cho thấy quan hệ đơn điệu: 0,602 độ chính xác cân bằng với 19 kênh và 0,608 với 8 kênh.
- Random forest vẫn gần mức ngẫu nhiên về độ chính xác cân bằng, nhưng AUC ở 8 kênh là 0,686, gần như trùng khớp với 0,687 ở 19 kênh.
Tám kênh chỉ chiếm 42% bộ cảm biến ban đầu, tương đương mức cắt giảm 58% số điện cực. Kết quả này không khẳng định 8 là con số tối ưu phổ quát, nhưng cho thấy với bộ dữ liệu và cách biểu diễn phổ này, không nhất thiết phải dùng mọi kênh sẵn có để giữ phần lớn hiệu năng quan sát được.
Bộ dữ liệu và cách trích xuất đặc trưng
Phân tích sử dụng bộ dữ liệu EEG During Mental Arithmetic Tasks (EEGMAT) từ PhysioNet, gồm 36 người tham gia, mỗi người có một bản ghi nền và một bản ghi trong lúc thực hiện nhiệm vụ tính nhẩm liên tục — tổng cộng 72 tệp EDF.
Mười chín kênh EEG trên da đầu được giữ lại: Fp1, Fp2, F3, F4, F7, F8, T3, T4, C3, C4, T5, T6, P3, P4, O1, O2, Fz, Cz và Pz. Tín hiệu được lọc trong dải 1–40 Hz và chia thành các cửa sổ 4 giây không chồng lấn.
Mật độ phổ công suất được ước lượng bằng phương pháp Welch. Với mỗi kênh và mỗi cửa sổ, công suất tương đối được tính trên bốn dải: theta (4–8 Hz), alpha (8–13 Hz), beta (13–30 Hz) và low gamma (30–40 Hz). Mỗi kênh đóng góp 4 đặc trưng, tạo ra 19 × 4 = 76 đặc trưng mỗi cửa sổ.
Ma trận đặc trưng cuối cùng gồm 2.134 cửa sổ: 1.594 cửa sổ nền và 540 cửa sổ tính nhẩm. Cách biểu diễn gọn và dễ diễn giải này được giữ cố định xuyên suốt thí nghiệm để mọi thay đổi hiệu năng đều quy được về số lượng cảm biến và cách chọn kênh.
Đánh giá theo kiểu giữ riêng người tham gia
Dữ liệu EEG dạng cửa sổ có rất nhiều quan sát nhưng chỉ vài chục đối tượng. Chia ngẫu nhiên có thể khiến các cửa sổ của cùng một người rơi vào cả tập huấn luyện lẫn tập kiểm thử — điều không được phép nếu mục tiêu là ước lượng hiệu năng trên cá nhân mới.
Vì vậy, toàn bộ đánh giá sử dụng GroupKFold với 6 fold, lấy ID người tham gia làm tham số nhóm. Mỗi vòng kiểm thử dùng 6 người làm dữ liệu test, và không cửa sổ nào của họ được dùng cho huấn luyện, chuẩn hóa hay chọn kênh.
Ba họ mô hình được xét đến: hồi quy logistic có trọng số lớp, SVM kernel RBF, và random forest 300 cây có trọng số lớp. Chỉ số chính là độ chính xác cân bằng nhằm xử lý mất cân bằng số cửa sổ giữa hai điều kiện; ROC-AUC được dùng làm chỉ số xếp hạng bổ sung.
 Sơ đồ quy trình đánh giá mô hình theo nhóm người tham gia
Xếp hạng kênh mà không rò rỉ dữ liệu
Việc chọn kênh đặt ra một vấn đề riêng cho quy trình kiểm định: nếu chọn kênh dựa trên toàn bộ người tham gia trước khi chạy cross-validation, chính những người bị giữ lại sẽ ảnh hưởng đến tập đặc trưng được chọn, khiến kết quả không còn phản ánh hiệu năng trên người thực sự chưa từng thấy.
Do đó, việc chọn kênh được thực hiện riêng cho từng fold huấn luyện. Với mỗi người và mỗi đặc trưng phổ, giá trị trung bình ở điều kiện nền được trừ khỏi giá trị trung bình ở điều kiện tính nhẩm. Mức chênh lệch này được chuẩn hóa theo độ lệch chuẩn của nó, rồi lấy trung bình bốn điểm số dải tần để tạo thành một điểm số duy nhất cho mỗi điện cực. Quy trình này tránh để những người có nhiều cửa sổ nền chi phối việc chọn kênh chỉ vì số lượng cửa sổ lớn hơn.
Kết quả gây bất ngờ từ nhóm kênh đối chứng ngẫu nhiên
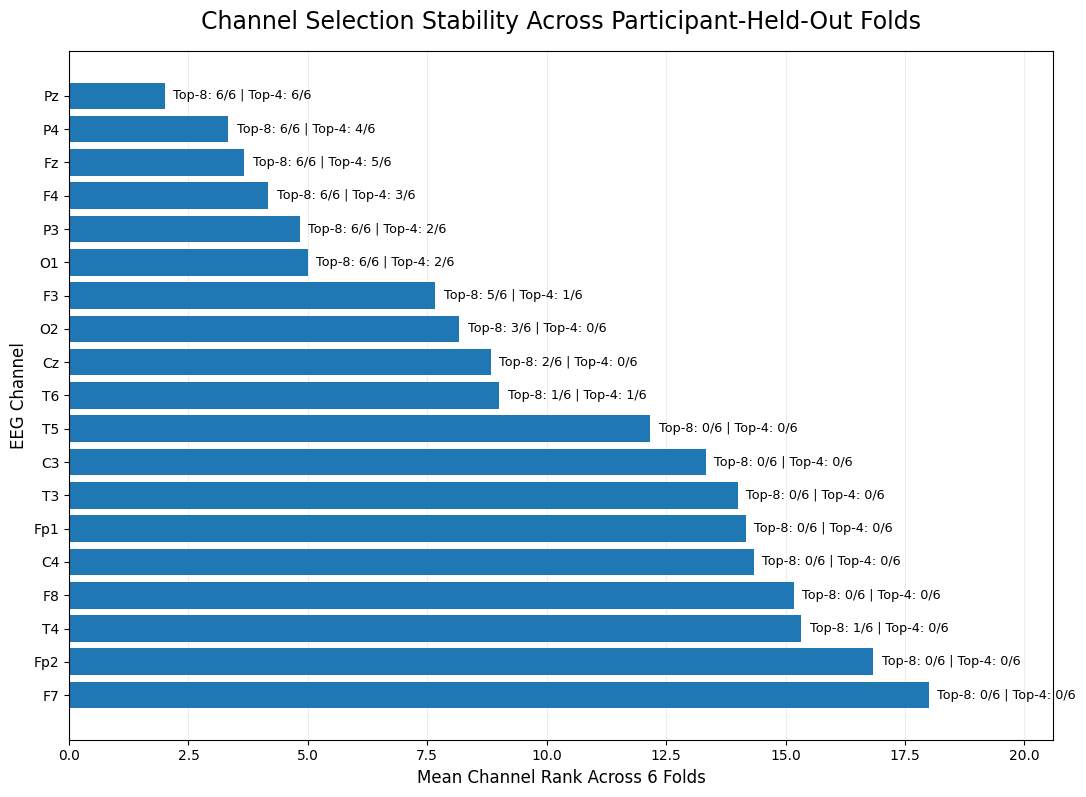
Xếp hạng kênh trên tập huấn luyện cho thấy tính ổn định đáng kể. Pz có thứ hạng trung bình 2,00 và nằm trong top 4 ở cả sáu fold. P4, Fz, F4, P3 và O1 cũng góp mặt trong top 8 ở mọi fold.
Thoạt nhìn, điều này gợi ý rằng một nhóm nhỏ điện cực mang phần lớn thông tin hữu ích. Nhưng kết luận đó cần một nhóm đối chứng: một thứ hạng ổn định chỉ có giá trị nếu các kênh nó chọn thực sự tổng quát hóa tốt hơn các lựa chọn hợp lý khác.
Nhóm nghiên cứu bổ sung baseline chọn kênh ngẫu nhiên với hồi quy logistic. Ở mỗi fold, các tập kênh ngẫu nhiên cùng kích thước được lấy mẫu và đánh giá trên đúng những người huấn luyện và kiểm thử như trên. Kết quả: độ chính xác cân bằng trung bình là 0,644 với 8 kênh, 0,635 với 4 kênh, 0,629 với 2 kênh và 0,616 với 1 kênh — cao hơn một chút so với các tập kênh được xếp hạng, ở mọi mức số kênh được thử.
Một phân tích thứ hai lấy 200 tập ngẫu nhiên mỗi fold để đo vị trí phân vị của tập kênh được xếp hạng trong phân phối ngẫu nhiên của từng fold. Nếu phương pháp xếp hạng thực sự tìm ra các tập kênh mạnh bất thường, kết quả xếp hạng phải nằm vượt xa phân vị 50. Điều đó đã không xảy ra.
 Phân vị của tập kênh được xếp hạng so với baseline ngẫu nhiên
Các tập kênh được xếp hạng trên tập huấn luyện không vượt trội so với baseline chọn kênh ngẫu nhiên.
Kết quả này thay đổi cách diễn giải biểu đồ độ ổn định kênh. Pz, P4, Fz, F4, P3 và O1 liên tục được thống kê mức ảnh hưởng cấp người tham gia ưu ái, nhưng sự nhất quán đó không chuyển hóa thành lợi thế tổng quát hóa đo được trên người chưa từng thấy.
Mức độ quan trọng và tính hữu dụng dự báo là hai chuyện khác nhau
Điểm mấu chốt không phải là một số điện cực nào đó vô dụng. Điều có thể kết luận là mức độ quan trọng của đặc trưng và tính hữu dụng dự báo là hai giá trị khác nhau.
Một đặc trưng có thể có mức quan trọng cao, với chênh lệch lớn và nhất quán giữa hai điều kiện, nhưng vẫn cung cấp rất ít thông tin bổ sung vì có nhiều đặc trưng khác tương quan mạnh với nó. Ngược lại, một đặc trưng có ảnh hưởng biên tương đối nhỏ lại có thể trở nên hữu ích nhờ tương tác với các đặc trưng còn lại.
Một cách lý giải cho đường cong hiệu năng khá phẳng là tính dư thừa. Thông tin về đặc tính phổ của điều kiện ghi có thể phân tán ở nhiều vị trí khác nhau trên da đầu, nên tồn tại nhiều tập kênh có thể tạo ra ranh giới quyết định tương đương. Cách lý giải này khớp với kết quả chọn kênh ngẫu nhiên, dù thí nghiệm hiện tại chưa xác định được cơ chế sinh lý đằng sau hiện tượng.
Cũng có thể phương pháp xếp hạng không tương thích với thuật toán học. Điểm số xếp hạng kênh đánh giá tính nhất quán chênh lệch điều kiện của từng đặc trưng một cách độc lập rồi cộng dồn theo điện cực, trong khi hồi quy logistic và SVM RBF tối ưu ranh giới quyết định theo cách đa biến.
Hàm ý cho học máy dựa trên cảm biến
Kết quả về số kênh và kết quả về xếp hạng kênh dẫn đến hai kết luận kỹ thuật khác nhau.
Thứ nhất, biểu diễn đủ 19 kênh là không cần thiết để giữ phần lớn hiệu năng quan sát được. Điều này khiến việc giảm cảm biến trở nên đáng thử nghiệm mỗi khi việc thu nhận tín hiệu có chi phí thực tế. Ít điện cực hơn đồng nghĩa thiết lập đơn giản hơn, ít nguy cơ tiếp xúc kém, thông lượng dữ liệu thấp hơn và ít đặc trưng phải xử lý hơn.
Thứ hai, xác định chính xác kênh nào nên giữ lại khó hơn nhiều so với việc quyết định rằng có thể bỏ bớt kênh. Cách xếp hạng trong nghiên cứu này dễ diễn giải và ổn định, nhưng lại không thắng được các tập kênh ngẫu nhiên. Vì vậy, một nghiên cứu triển khai thực tế nên đánh giá trực tiếp các phương án bố trí điện cực ứng viên thay vì mặc định rằng bảng xếp hạng mức độ quan trọng tự động định nghĩa cấu hình phần cứng tốt nhất.
Bài học này vượt ra ngoài EEG. Cảm biến đeo, hệ thống giám sát công nghiệp, pipeline đa phương thức hay mô hình dạng bảng nhiều chiều đều đối mặt cùng một câu hỏi: đầu vào nào thực sự cần thiết cho nhóm người dùng mục tiêu? Câu trả lời phải đến từ kiểm định ngoài mẫu theo đúng cách chia dữ liệu khi triển khai, chứ không chỉ từ điểm số quan trọng.
Giới hạn của nghiên cứu
Đây là một phép đánh giá học máy có trọng tâm, không phải một phát biểu phổ quát về thiết kế cảm biến EEG. Bộ dữ liệu chỉ có 36 người tham gia và một nhiệm vụ duy nhất (nền so với tính nhẩm). Kết quả có thể thay đổi với dân số, nhiệm vụ, hệ thống ghi, quy trình tiền xử lý hoặc cách biểu diễn đặc trưng khác.
Cách biểu diễn phổ được cố ý giữ đơn giản với bốn đặc trưng công suất dải tương đối mỗi kênh, nên kết luận chỉ áp dụng cho họ đặc trưng này chứ không cho mạng học sâu trên dạng sóng thô, đặc trưng kết nối, bộ lọc không gian hay biểu diễn trong không gian nguồn.
Sáu fold ngoài chỉ cung cấp sáu ước lượng cho mỗi cấu hình, nên những chênh lệch nhỏ như 0,608 so với 0,602 không nên được xem là bằng chứng rằng một mức số kênh vượt trội về bản chất. Mô hình chính là việc không có sự sụp đổ hiệu năng lớn giữa 19 và 8 kênh.
Cuối cùng, phương pháp xếp hạng theo mức ảnh hưởng đánh giá từng kênh độc lập trước khi cộng dồn điểm số. Nó không tối ưu rõ ràng các tổ hợp kênh bổ trợ lẫn nhau hay phạt các kênh dư thừa. Các phương pháp chọn đặc trưng đa biến như chọn tiến từng bước lồng nhau hoặc chọn nhúng có điều chuẩn có thể cho kết quả khác, miễn là mọi bước chọn vẫn bị giới hạn trong tập người tham gia huấn luyện.
Kết luận
Loại bỏ 11 trong 19 cảm biến khỏi biểu diễn EEG đã cắt khoảng 58% số cảm biến nhưng vẫn giữ phần lớn hiệu năng phân loại trên cả ba họ mô hình. Cụ thể, hồi quy logistic giảm từ 0,648 xuống 0,628 độ chính xác cân bằng, SVM RBF tăng từ 0,602 lên 0,608, và random forest giảm từ 0,535 xuống 0,527.
Kết quả thú vị hơn đến sau bước chọn kênh: nhiều kênh có thứ hạng ổn định trên tập huấn luyện, nhưng tập kênh được chọn lại không tốt hơn các tập chọn ngẫu nhiên trên người tham gia mới. Điều này tách bạch hai câu hỏi liên quan nhưng khác nhau: đặc trưng có quan trọng trên tập huấn luyện không, và việc chọn đặc trưng đó có cải thiện khả năng tổng quát hóa không.
Với các ứng dụng học máy dùng nhiều cảm biến, bài học vì thế vượt ra ngoài việc giảm đầu vào: việc chọn cảm biến, chọn đặc trưng và đánh giá mô hình cần được kiểm thử trên chính nhóm đối tượng mục tiêu của ứng dụng. Một thứ hạng ổn định có thể mô tả hiện tượng, nhưng không dự báo được hiệu năng.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
Wine chính thức được chuyển sang OpenBSD: bước tiến lớn cho người dùng hệ điều hành bảo mật cao
19 tháng 10, 2026