Google ra mắt Quicksort vector hóa đầu tiên, nhanh gấp 10 lần chuẩn C++
Google vừa công bố mã nguồn mở thuật toán sắp xếp vector hóa đầu tiên có thể chạy trên nhiều kiến trúc CPU khác nhau, đạt tốc độ lên tới 1 GB/s và nhanh gấp 9-19 lần so với std::sort truyền thống. Đây là bước tiến quan trọng cho các cơ sở dữ liệu dạng cột và xử lý dữ liệu lớn.
Google ra mắt Quicksort vector hóa đầu tiên, nhanh gấp 10 lần chuẩn C++
Google vừa công bố mã nguồn mở cho một thuật toán sắp xếp có thể xử lý mảng số nhanh gấp khoảng 10 lần so với std::sort của C++, đồng thời vượt qua cả những thuật toán tối ưu riêng cho từng kiến trúc CPU. Điểm đặc biệt là nó vẫn đảm bảo tính di động (portable) trên mọi kiến trúc CPU hiện đại.
 Minh họa siêu máy tính và xử lý hiệu năng cao.jpeg)
Bối cảnh: Sắp xếp là bài toán then chốt của cơ sở dữ liệu
Xu hướng gần đây trong ngành cơ sở dữ liệu là chuyển sang cơ sở dữ liệu dạng cột (columnar database), nơi tất cả giá trị của một cột được lưu liền nhau thay vì lưu từng bản ghi hoàn chỉnh. Cách lưu trữ này giúp việc lọc và sắp xếp — hai thao tác cốt lõi của truy vấn SQL — trở nên nhanh hơn đáng kể.
Vấn đề đặt ra là: sắp xếp đã được nghiên cứu hàng chục năm, làm sao có thể đạt được tốc độ nhanh gấp 10 lần? Câu trả lời nằm ở tập lệnh SIMD/vector.
SIMD — chìa khóa của tốc độ
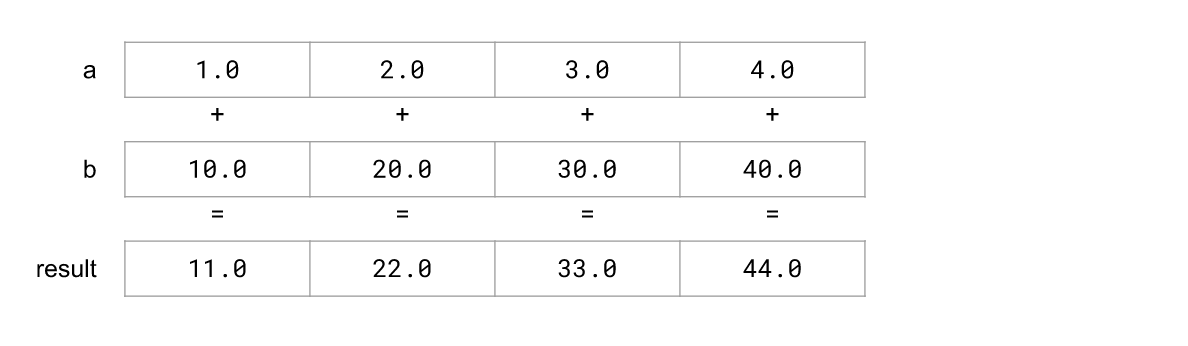
SIMD (Single Instruction, Multiple Data) cho phép thực hiện một phép toán trên nhiều phần tử độc lập cùng lúc. Ví dụ, với tập lệnh AVX-512, CPU có thể xử lý 16 số float32 trong một lệnh duy nhất, hoặc 4 số trên Arm NEON.
Tuy nhiên, SIMD vốn chỉ xử lý các phần tử độc lập, trong khi sắp xếp lại yêu cầu sắp xếp lại vị trí các phần tử liền kề. Đây chính là thách thức kỹ thuật mà nhóm nghiên cứu của Google đã giải quyết.
Kỹ thuật "compress-store" và bài toán di động
Ý tưởng cốt lõi như sau: nếu có cách sắp xếp nhanh một mảng 256 phần tử, thì Quicksort cho mảng lớn hơn sẽ chia mảng thành hai phần — các phần tử nhỏ hơn pivot (giá trị trục) và các phần tử còn lại — rồi đệ quy cho đến khi mảng con đủ nhỏ để dùng phương pháp đặc biệt.
Phần tốn thời gian CPU nhất là bước phân hoạch (partitioning). Các tập lệnh hiện đại như Arm SVE, RISC-V V, x86 AVX-512 đều có lệnh compress-store: khi nhận vào một mảng giá trị đúng/sai (phần tử có nhỏ hơn pivot hay không), lệnh này chỉ ghi các phần tử "đúng" ra vùng nhớ liên tiếp. Sau đó phủ định mảng đúng/sai và áp dụng lại để ghi các phần tử còn lại vào phân hoạch kia.
Điểm đột phá của Google là làm được điều này trên cả những tập lệnh không có compress-store, chẳng hạn AVX2, bằng cách mô phỏng lệnh này thông qua các lệnh permute.
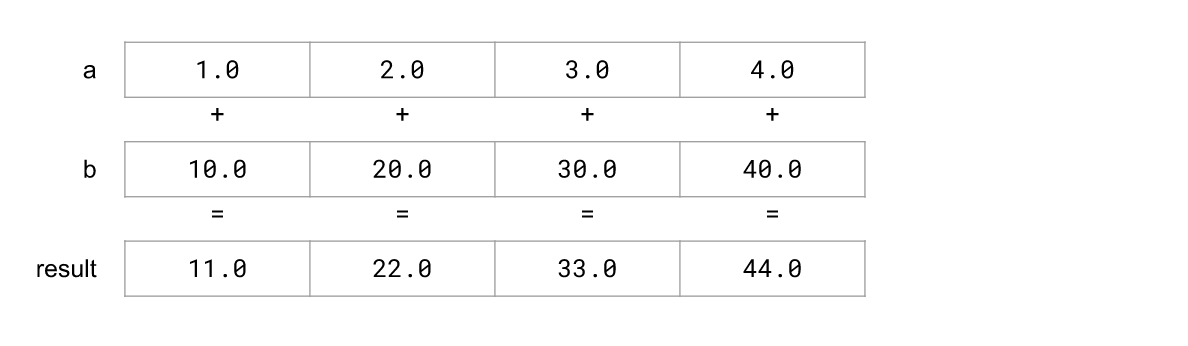 Minh họa xử lý vector và tập lệnh SIMD
Hiệu năng thực tế: ấn tượng trên cả Intel lẫn Apple
Nhờ sử dụng thư viện Highway với các hàm SIMD di động, nhóm nghiên cứu không phải viết lại khoảng 3.000 dòng C++ cho từng nền tảng. Highway sẽ tự động kiểm tra CPU đang hỗ trợ tập lệnh nào và chọn phương án tối ưu nhất.
Kết quả đo đạc rất đáng chú ý với 1 triệu số:
- Apple M1 (Arm NEON): đạt tốc độ 499/471/466 MB/s cho số 32/64/128-bit
- Intel Skylake 3 GHz (AVX-512): đạt 1123/1119/1120 MB/s
- AVX2: đạt 798 MB/s, trong khi thuật toán tối ưu AVX2 trước đây chỉ đạt 699 MB/s
- Thư viện chuẩn C++ (std::sort): chỉ đạt 58/128/117 MB/s
Như vậy, tùy loại số, thuật toán mới nhanh hơn 9 đến 19 lần so với chuẩn. Đáng chú ý, AVX-512 cho tốc độ nhanh hơn AVX2 từ 1,4 đến 1,6 lần mà không tốn thêm công sức lập trình.
Ý nghĩa đối với ngành công nghệ
Trước đây, sắp xếp luôn được coi là thao tác tốn kém. Việc có thể sắp xếp ở tốc độ 1 GB/s trên một lõi CPU đơn mở ra nhiều khả năng mới cho các ứng dụng xử lý dữ liệu lớn, phân tích log, truy vấn cơ sở dữ liệu và cả các pipeline học máy.
Mã nguồn được phát hành dưới giấy phép Apache 2.0 và có sẵn trên GitHub. Bài báo khoa học kèm theo cung cấp giải thích chi tiết cùng đánh giá đầy đủ về triển khai, bao gồm cả trường hợp đặc biệt cho mảng 256 phần tử.
Đối với cộng đồng lập trình viên Việt Nam — đặc biệt những ai đang làm việc với backend, cơ sở dữ liệu hoặc tối ưu hiệu năng hệ thống — đây là cơ hội tốt để tìm hiểu sâu về SIMD và cách tận dụng sức mạnh phần cứng hiện đại trong các dự án thực tế.