Grace Blackwell cần bộ lập lịch mới: tăng 27% GPU khả dụng trên cùng số rack
Hệ thống NVL72 của NVIDIA gộp 72 GPU trong một rack vào chung một NVLink fabric, nhưng lợi ích chỉ được phát huy nếu việc xếp đặt workload thực sự giữ được tính cục bộ theo rack. Phân tích từ SkyPilot cho thấy các slice 16 node kèm 2 node dự phòng mỗi rack giúp tăng 27% dung lượng GPU khả dụng so với slice 18 node, và việc lập lịch theo topology có thể cải thiện hiệu suất huấn luyện tới 14,4%.
Grace Blackwell cần bộ lập lịch mới: tăng 27% GPU khả dụng trên cùng số rack
Không phải mọi kết nối tốc độ cao đều giống nhau, và dùng sai loại kết nối có thể gây tốn kém. Chạy cùng một job huấn luyện phân tán trên InfiniBand thay vì NVLink có thể làm giảm 43% hiệu năng. Hệ thống NVL72 của NVIDIA mở rộng NVLink ra toàn bộ rack, nhưng để tận dụng được, các đội vận hành cần một bộ lập lịch hiểu rõ topology phần cứng — và biết chừa chỗ dự phòng.
 Minh họa hệ thống GPU và kết nối tốc độ cao
Vì sao huấn luyện quy mô lớn là bài toán giao tiếp
Các job huấn luyện tiên tiến chạy trên hàng nghìn GPU và phải trả lời hai câu hỏi: chia mô hình thế nào để chạy được, và với ngân sách tính toán hiện có, chạy được bao nhiêu bản sao của mô hình đã chia để tối đa hóa thông lượng.
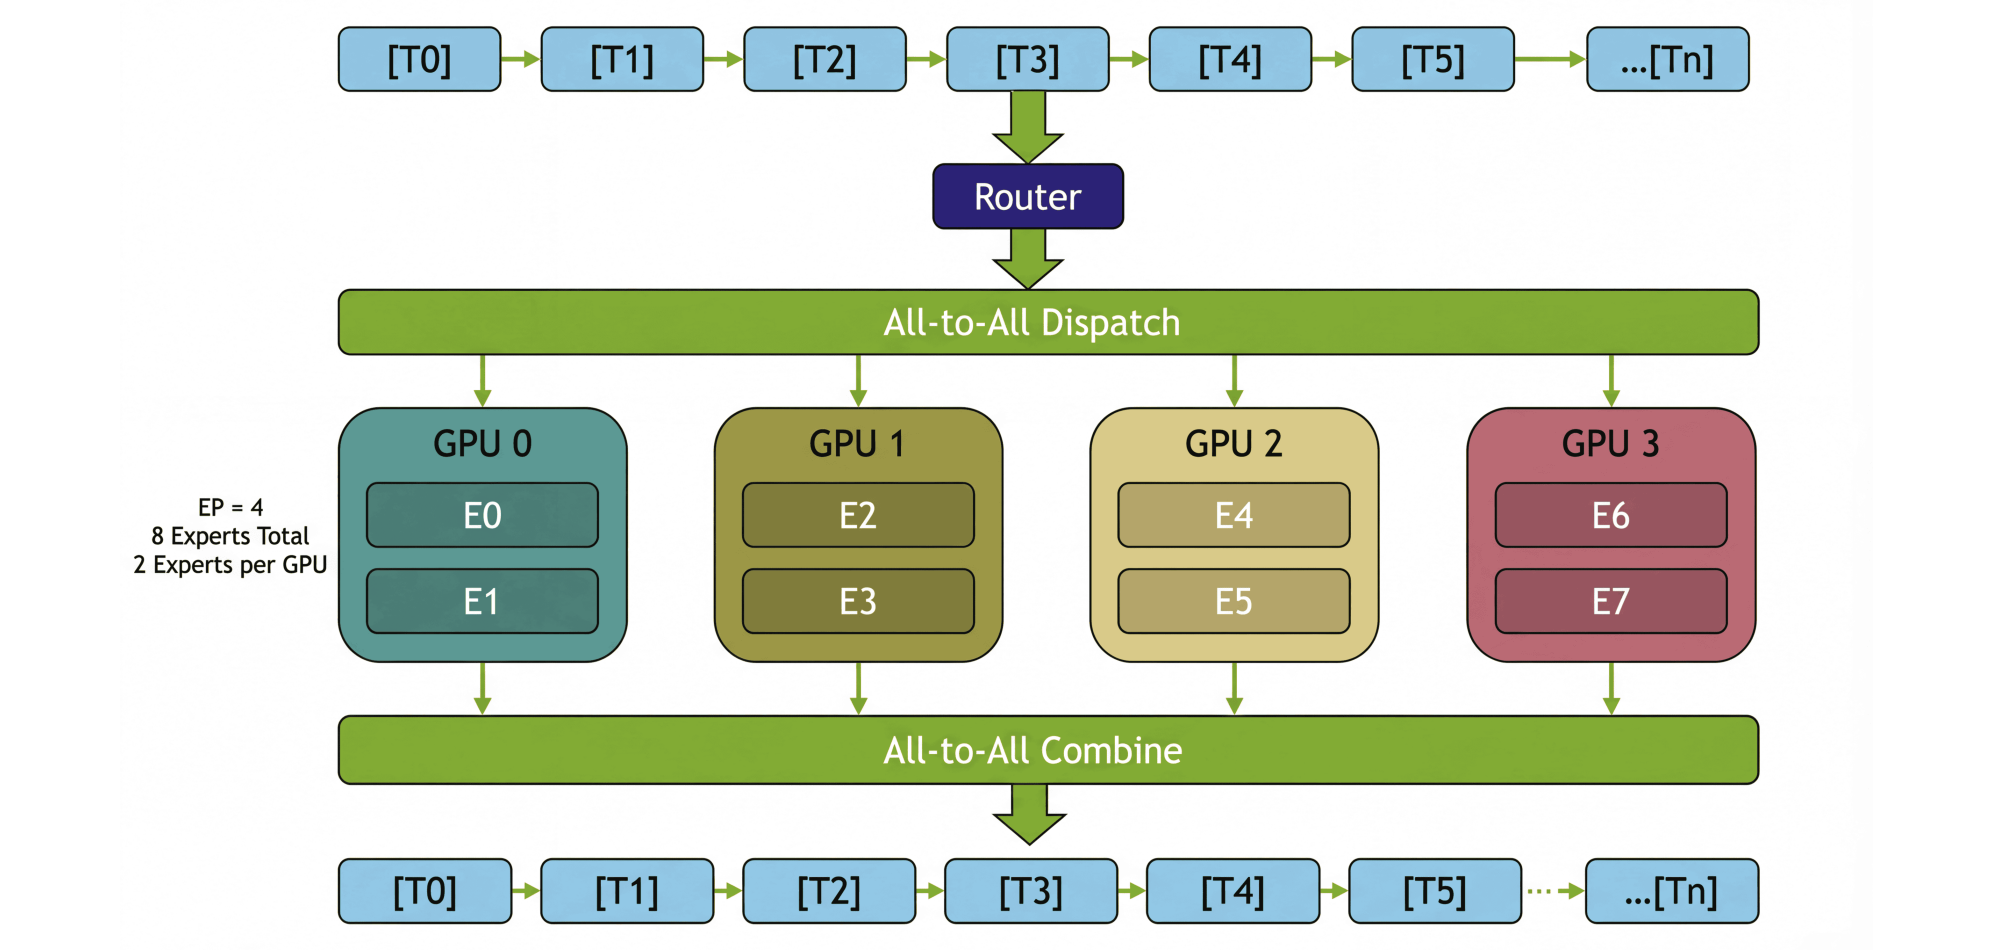
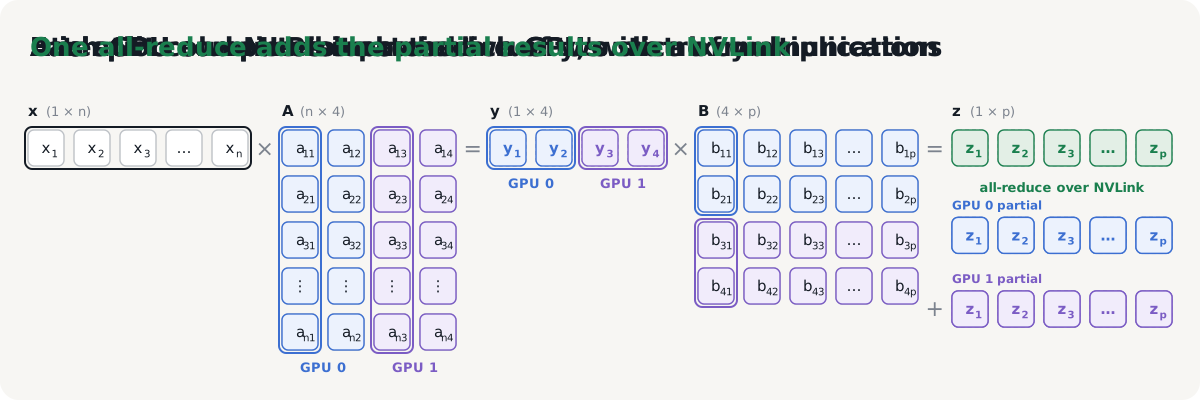
Câu trả lời thường là sự kết hợp của Tensor Parallelism (TP) — chia ma trận trọng số của mỗi lớp ra các GPU, Expert Parallelism (EP) — đặt các expert của lớp MoE trên các GPU khác nhau, Pipeline Parallelism (PP) — chia mô hình theo từng lớp, và Data Parallelism (DP) — số bản sao chạy song song trên các tập dữ liệu khác nhau.
Trong các chiến lược này, phép all-reduce của tensor parallelism và all-to-all của expert parallelism nằm trên đường tới hạn trong quá trình huấn luyện, nên việc giữ chúng trên NVLink là quan trọng nhất. Hugging Face từng đo được mức giảm 43% thông lượng huấn luyện khi chuyển khỏi NVLink sang InfiniBand.
Với expert parallelism, một mô hình MoE dùng 64-way EP sẽ trải expert của mỗi lớp trên 64 GPU. Trên server 8 GPU tiêu chuẩn, lưu lượng all-to-all buộc phải đi qua InfiniBand — nơi giao tiếp chưa tối ưu có thể ngốn tới 60% thời gian huấn luyện. Trên NVL72, cả 64 GPU nằm trong cùng một miền NVLink, gần như xóa bỏ nút thắt này.
Suy luận cũng cần mạng liên node tốc độ cao
Các kỹ thuật song song hóa không chỉ dành cho huấn luyện. Chia trọng số mô hình ra nhiều GPU giúp giải phóng bộ nhớ cho KV cache, từ đó phục vụ được nhiều request đồng thời hơn hoặc hỗ trợ cửa sổ ngữ cảnh lớn hơn.
Trong một benchmark vLLM, chia mô hình tensor-parallel trên hai GPU giúp tăng 13,9 lần số block KV cache và đem lại thông lượng cao hơn 3,9 lần. Trên server 8 GPU thông thường, một nhóm expert-parallel tối đa chỉ 8 GPU trước khi phải giao tiếp qua InfiniBand, nơi băng thông mỗi GPU giảm tới 18 lần. NVL72 gỡ bỏ giới hạn này bằng cách giữ cả 72 GPU trong một rack trên NVLink: khi phục vụ DeepSeek-R1 ở tốc độ tương tác, GB200 NVL72 với 32-way EP đạt thông lượng mỗi GPU cao hơn tới 4,4 lần so với server B200 8 GPU.
Rack trở thành "server" mới
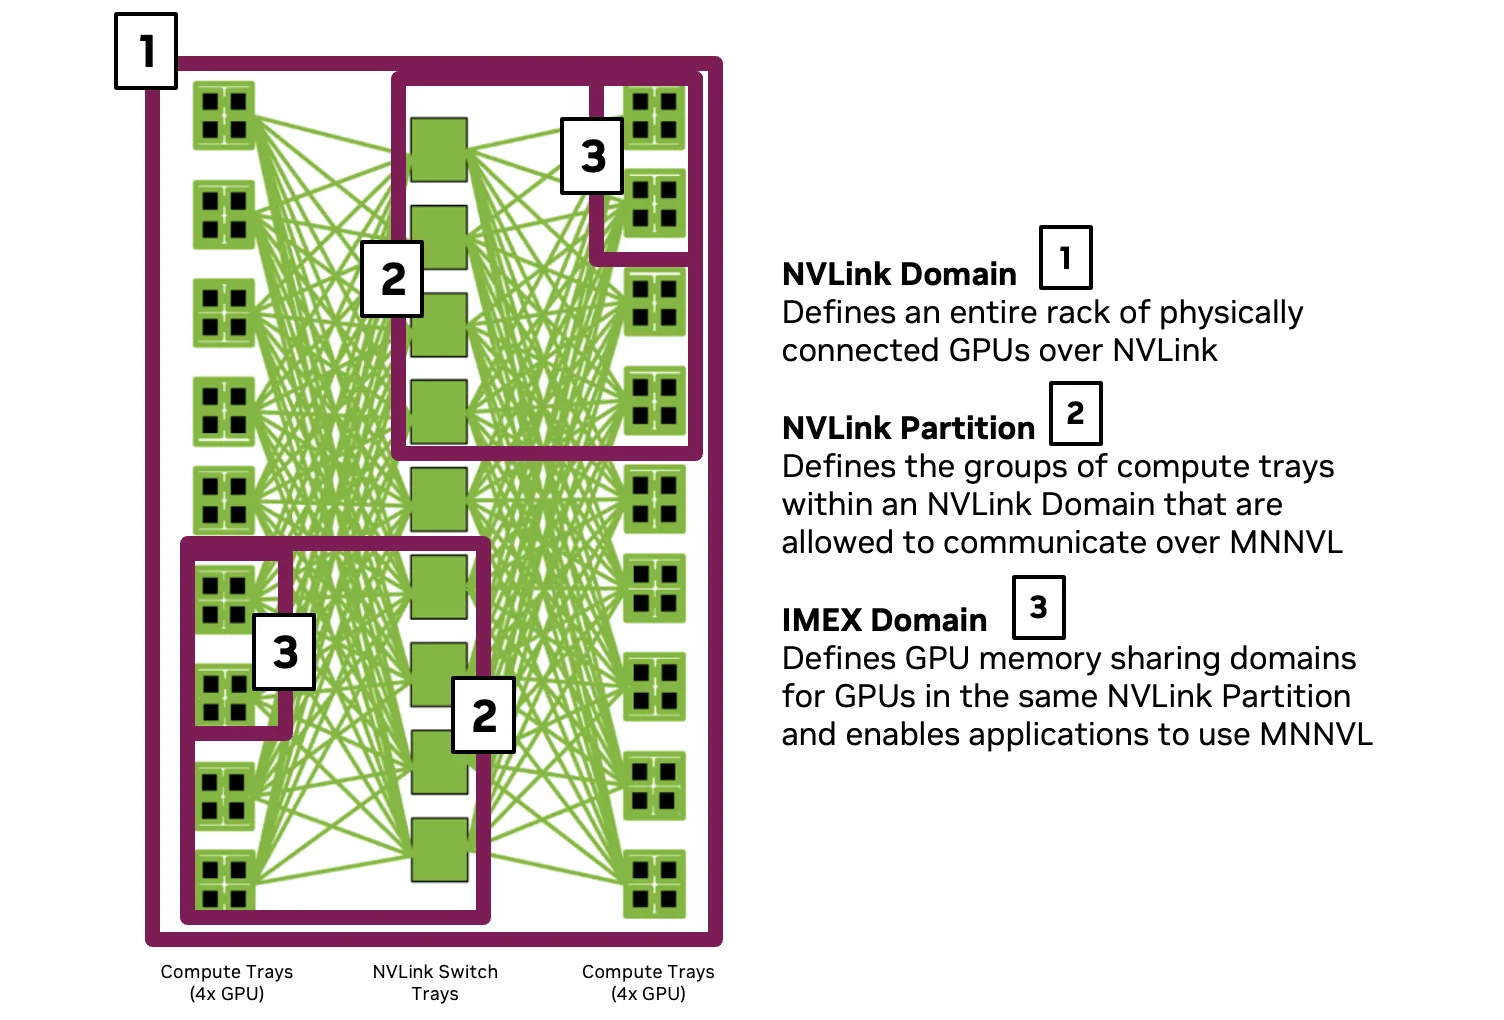
NVL72 mở rộng NVLink từ một node ra toàn rack, biến cả rack thành một bộ tăng tốc khổng lồ với bộ nhớ chia sẻ. Mỗi GPU có 18 cổng NVLink, mỗi cổng đạt 100 GB/s song hướng, tổng cộng 1,8 TB/s cho mỗi GPU. Mỗi cổng ánh xạ tới một trong 18 chip NVSwitch tạo nên backplane của rack. Vì mỗi NVSwitch nhận 72 đường NVLink — một từ mỗi GPU — tổng băng thông nội bộ trong rack lên tới 130 TB/s.
Topology này đảm bảo fabric hoàn toàn không chặn (non-blocking): bất kỳ GPU nào trong rack cũng có thể truyền dữ liệu tới GPU khác với độ trễ đồng nhất và băng thông tối đa, rất lý tưởng cho các workload AI phân tán quy mô lớn.
 Sơ đồ phân cấp NVLink trong một rack NVL72
Đôi khi ít hơn lại tốt hơn: chừa node dự phòng để tăng độ tin cậy
Với NVL72, rất dễ bị cám dỗ cấp trọn rack 18 node cho workload nhằm tối đa hóa mức sử dụng cụm. Nhưng trên thực tế, các đội vận hành lại thu được nhiều dung lượng khả dụng hơn nếu chừa vài node dự phòng trong mỗi rack.
GPU không đáng tin cậy tuyệt đối. Trên siêu cụm quy mô gigawatt của mình, Meta đo được thời gian trung bình giữa các lần gián đoạn (MTBI) khoảng 490 ngày cho mỗi node 4 GPU, sau khi đã đầu tư đáng kể công sức cải thiện độ tin cậy. Với NVL72, rack 72 GPU trở thành đơn vị tính toán nguyên tử, khiến phạm vi ảnh hưởng của lỗi tăng 18 lần so với các node 4 GPU.
Theo phép tính đó, một rack sẽ bị gián đoạn khoảng mỗi 27 ngày. Trên cụm 128 rack, điều này đồng nghĩa gần như mỗi 5 giờ lại có một rack không dùng được cho các job chiếm trọn rack.
Chừa hai node mỗi rack làm dự phòng sẽ thay đổi cục diện: khi một node hỏng, node dự phòng trong cùng rack thay thế, nên một lỗi đơn lẻ không còn khiến cả rack ngừng hoạt động. Cái giá là hai node mỗi rack nằm không khi mọi thứ bình thường.
NVIDIA đã mô hình hóa tác động của các kích thước slice khác nhau tới dung lượng khả dụng trên cụm 128 rack (2.304 node). Ở mức không khả dụng khoảng 2% — con số SkyPilot đo được trên các cụm NVL72 production mà họ quản lý — slice 16 node cho dung lượng khả dụng cao hơn 27% so với slice 18 node (2.037 so với 1.602 node). Slice 16 node cũng nhỉnh hơn slice 9 node 4%, dù hai slice 9 node lấp đầy một rack vừa khít. So với slice 8 node, slice 16 node cho mỗi job gấp đôi số GPU trong một miền NVLink mà chỉ mất chưa tới 1% dung lượng khả dụng cho tới khi tỷ lệ không khả dụng vượt khoảng 3,3%.
Con số 64 GPU cũng là lũy thừa của 2, phù hợp với cách các nhóm song song hóa thường được thiết lập.
Bộ lập lịch hiện đại giữ job trên NVLink như thế nào
Chọn đúng kích thước slice mới chỉ là bước đầu. Câu hỏi lớn hơn là làm sao đảm bảo mỗi slice của một job huấn luyện nhiều node thực sự rơi vào một rack duy nhất.
Các bộ lập lịch ngây thơ chia job nhiều node ra nhiều rack, buộc các worker giao tiếp qua InfiniBand (400 Gb/s mỗi chiều) thay vì NVLink (1,8 TB/s song hướng). Bộ lập lịch Topology-Aware Scheduler (TAS) của SkyPilot đảm bảo các worker nằm cùng rack. Với workload nhiều rack, TAS chia job thành các slice 16 node và đặt mỗi slice trên một rack riêng với hai node dự phòng. Khi GPU Manager phát hiện lỗi phần cứng, Frontier Trainer có thể hoán đổi nóng node hỏng với một node khỏe mạnh trong khi các node còn lại tiếp tục chạy không gián đoạn.
Để định lượng tác động, nhóm GR00T của NVIDIA đã so sánh hai chính sách lập lịch trong quá trình tiền huấn luyện GR00T N1.7 trên 512 GPU GB300 trải trên 128 node. Lần chạy dùng bộ lập lịch ngây thơ đặt node trên số rack bất kỳ; lần chạy thứ hai dùng chính sách theo rack và theo slice, đặt job vừa đúng trên 8 rack. Kết quả: thông lượng tăng 14,4%, mỗi vòng lặp giảm từ 1,59 giây xuống 1,39 giây.
Trên một cụm 10.000 GPU, mức tăng tốc tương tự tiết kiệm khoảng 16,7 nghìn USD mỗi giờ huấn luyện — tức khoảng 400 nghìn USD mỗi ngày, chỉ nhờ những quyết định lập lịch tốt hơn.
 Minh họa lập lịch theo topology và slice trong cụm GPU
Phân mảnh — rào cản với các job quy mô rack
Trong thực tế, các cụm lớn thường được chia sẻ: các workload không đồng nhất như tiền huấn luyện, rollout RL và batch inference cùng tranh chấp tài nguyên. TAS có thể xếp các workload gọn trong cùng rack khi lập lịch, nhưng job kết thúc ở các thời điểm khác nhau, để lại các node trống rải rác khắp các rack.
Đây chính là phân mảnh (fragmentation): cụm có đủ GPU trống để chạy một job quy mô rack, nhưng vì chúng nằm rải rác nên job không thể được xếp lịch.
Tính năng Automatic Defragmentation (Auto Defrag) của SkyPilot giải quyết vấn đề này. Khi một job bị chặn vì topology chứ không phải vì thiếu dung lượng, Auto Defrag tìm tập workload ít bị ảnh hưởng nhất để tạm dừng, giải phóng trọn một rack, rồi lập lịch lại các workload đó trên rack khác. Job bị chặn sau đó có thể được xếp lịch.
Auto Defrag chỉ tạm dừng những workload khởi động lại an toàn, chẳng hạn job được quản lý và phục hồi từ checkpoint. Các môi trường phát triển tương tác được để nguyên, trừ khi quản trị viên chủ động bật.
Phần cứng tốt chưa đủ — lợi thế của NVL72 chỉ thành hiện thực khi bộ lập lịch hiểu topology, chống chịu lỗi và biết tái cân bằng động khi các job đến rồi đi.
Kết luận
Các workload AI quy mô lớn mặc định là phân tán, và những mẫu giao tiếp ngốn băng thông nhất của chúng nằm ngay trên đường tới hạn. Các hệ thống quy mô rack như NVL72 giải quyết nút thắt này ở tầng phần cứng, nhưng phần cứng một mình không đảm bảo tốc độ. Chúng cần lập lịch nhận biết rack, khả năng chống chịu lỗi phần cứng và tái cân bằng động. Với các đội đang vận hành cụm NVL72 tại Việt Nam hoặc thuê GPU qua cloud, đây là bài học trực tiếp: cấu hình rack và chính sách lập lịch ảnh hưởng tới hóa đơn GPU nhiều không kém gì việc chọn đúng loại chip.