Gravity: Công cụ truy vấn nhanh gấp 3 lần ClickHouse nhờ biên dịch JIT
pgrust v0.4-beta ra mắt engine truy vấn Gravity, đạt tốc độ nhanh gấp 3 lần ClickHouse trên ClickBench trong khi vẫn hỗ trợ đầy đủ cú pháp SQL và hệ kiểu của Postgres. Nhóm phát triển xây dựng pipeline biên dịch đa tầng từ kế hoạch Postgres xuống assembly, với mục tiêu đạt 80% hiệu năng của mã Rust viết tay tối ưu.
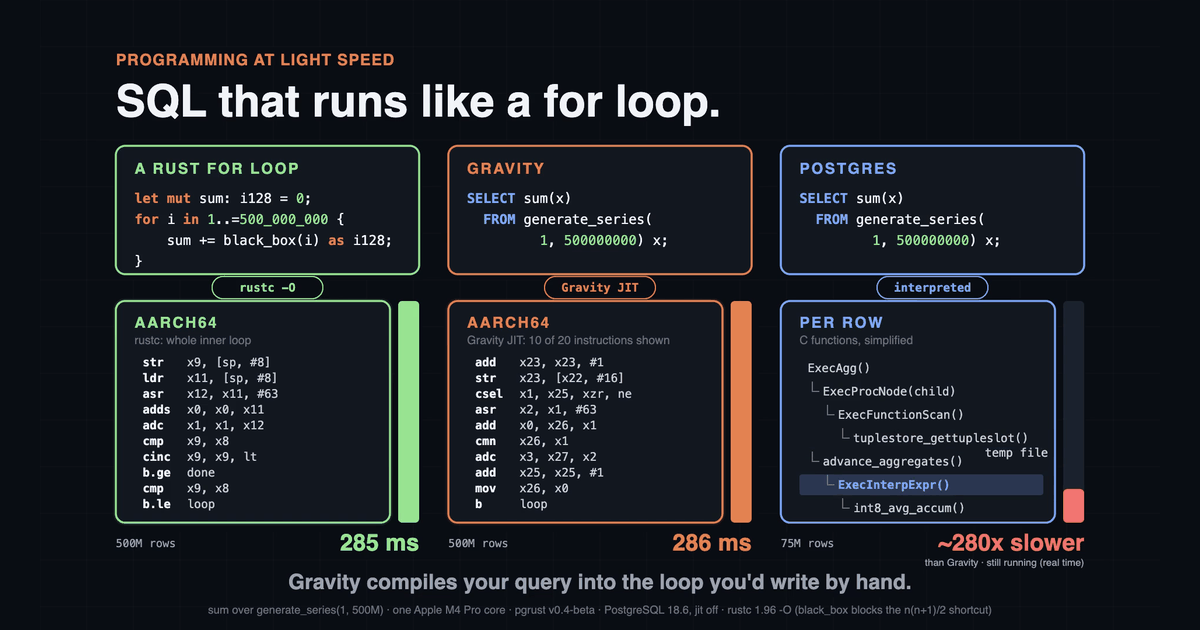
Gravity: Khi cơ sở dữ liệu được lập trình ở "tốc độ ánh sáng"
Với bản phát hành pgrust v0.4-beta, engine truy vấn mới mang tên Gravity đã đạt tốc độ nhanh gấp 3 lần ClickHouse trên ClickBench — chính là bộ benchmark do đội ngũ ClickHouse tạo ra để chứng minh sản phẩm của họ nhanh đến mức nào. Điều đáng chú ý hơn: Gravity đạt được tốc độ đó trong khi vẫn hỗ trợ trọn vẹn cú pháp SQL và hệ kiểu của Postgres.
Từ copy-and-patch đến một trình biên dịch thực thụ
Trong các bài viết trước, nhóm phát triển đã trình bày cách dùng kỹ thuật batching, operator fusion và SIMD để giúp pgrust nhanh hơn Postgres hàng trăm lần với các truy vấn phân tích. Họ cũng giới thiệu một trình biên dịch copy-and-patch JIT có khả năng biên dịch stencil chỉ trong 5 microsecond.
Tuy nhiên, copy-and-patch chỉ là điểm khởi đầu. Việc ghép các template đã biên dịch sẵn lại với nhau có giới hạn: thiếu một biểu diễn trung gian (IR) thực sự và thiếu cấp phát thanh ghi trên toàn vòng lặp, khiến hiệu năng bị bỏ phí đáng kể so với các trình biên dịch tối ưu như rustc hay Clang. Vì vậy, với v0.4, nhóm quyết định xây dựng một trình biên dịch truy vấn có khả năng sinh mã máy tối ưu cho bất kỳ câu SQL nào — và Gravity ra đời từ đó.
Tư duy ngược: bắt đầu từ giới hạn vật lý
Thông thường, khi tối ưu phần mềm, kỹ sư làm việc từ dưới lên: chạy benchmark, xem flamegraph, tìm điểm nóng rồi cải thiện 15–20%. Vấn đề là cách này không cho biết trần hiệu năng nằm ở đâu — có thể chỉ còn cách 20%, mà cũng có thể còn cách tới 100 lần.
Nhóm pgrust lật ngược câu hỏi: một cơ sở dữ liệu thực sự có thể nhanh đến mức nào? Thay vì tăng tốc dần engine hiện có, họ xuất phát từ giới hạn tốc độ vật lý của phần cứng và định dạng tệp rồi đi ngược lại — cách làm mà họ gọi vui là "lập trình ở tốc độ ánh sáng".
Để hình dung "tốc độ ánh sáng" trông ra sao, họ để Claude viết các chương trình Rust độc lập, tối ưu mạnh, chạy trực tiếp trên các crate lưu trữ dạng cột cho một tập truy vấn phân tích. Những chương trình này bỏ qua toàn bộ executor SQL, chỉ chạy các vòng lặp Rust đa luồng dùng SIMD trên định dạng lưu trữ trên đĩa. Kết quả: nhanh hơn khoảng 4 lần so với các cơ sở dữ liệu phân tích như ClickHouse trên mọi bài test. Từ đó, nhóm rút ra các kỹ thuật tối ưu để đưa vào Gravity.
Mục tiêu của Gravity trở nên đơn giản: với mọi câu SQL, biên dịch JIT mã máy tại thời điểm chạy sao cho đạt trong khoảng 20% so với mã Rust viết tay.
Kiến trúc của Gravity
Triết lý thiết kế chính là tạo ra độ linh hoạt tối đa cho đầu ra sinh ra. Nếu việc thay đổi Gravity để phát ra bất kỳ tối ưu mức thấp nào trở nên dễ dàng, việc thu hẹp khoảng cách với "tốc độ ánh sáng" cũng dễ hơn nhiều.
Thay vì hard-code các mẫu thực thi hay ghép stencil cố định, Gravity được tổ chức thành pipeline biên dịch đa tầng, hạ dần từ kế hoạch Postgres cấp cao xuống assembly thô:
Truy vấn SQL
-> Kế hoạch Postgres
-> Đồ thị pipeline
-> Lisp IR
-> Assembly
Xét ví dụ truy vấn:
SELECT UserID, extract(minute FROM EventTime) AS m, MIN(URL), COUNT(*)
FROM hits
WHERE URL LIKE '%google%'
GROUP BY UserID, m
ORDER BY COUNT(*) DESC
LIMIT 10;
Tầng 1 — Kế hoạch Postgres. Gravity không thay thế parser hay query planner của Postgres. Khi truy vấn đến, planner của pgrust phân tích thống kê bảng và tạo kế hoạch chuẩn gồm Limit, Sort, HashAggregate và Seq Scan.
Tầng 2 — Đồ thị pipeline. Kế hoạch được chuyển thành đồ thị pipeline — một dạng biểu diễn trung gian mô tả dòng dữ liệu qua quá trình thực thi. Mỗi pipeline thể hiện cách một dòng dữ liệu được biến đổi và xử lý. Truy vấn trên chia thành ba pipeline: lọc và gộp nhóm vào bảng băm, lấy top 10 nhóm qua heap, rồi gửi kết quả ra ngoài.
Tầng 3 — Lisp IR. Mỗi pipeline được biên dịch thành một hàm duy nhất trong IR kiểu assembly dựa trên Lisp. Vì IR có tính tổng quát, Gravity có thể hợp nhất (fuse) bước quét, lọc, chiếu và gộp nhóm vào bất kỳ cấu trúc vòng lặp nào mong muốn. Ví dụ, biểu thức extract(minute FROM EventTime) được dịch thành chuỗi phép nhân chia số nguyên và dịch bit thay vì gọi hàm.
Tầng 4 — Assembly. Các backend cho từng kiến trúc đích biên dịch IR thành assembly. Đoạn mã AArch64 sinh ra cho thấy các phép so sánh, nạp, dịch bit và nhân được sắp xếp tối ưu cho từng dòng dữ liệu.
Đối phó với "fast path" mong manh
Một thách thức lớn là các đường tối ưu rất dễ bị vô hiệu hóa. Chỉ cần một thay đổi nhỏ — như điều kiện URL LIKE '%google%' thay thế, hay GROUP BY trên một cột bọc trong kiểu DOMAIN của Postgres — một bộ nhận diện mẫu cứng nhắc sẽ bỏ lỡ fast path và âm thầm rơi về mã chậm.
Để chống lại điều này, nhóm lập một danh mục mọi tối ưu rồi viết một fuzzer kiểm tra từng tối ưu trên nhiều dạng truy vấn khác nhau: nhiều kiểu dữ liệu (int2, int4, int8, numeric, text, domain), nhiều kiểu group by… để xác nhận tối ưu thực sự kích hoạt ở nhiều truy vấn chứ không chỉ một. Quá trình kiểm thử này thậm chí còn phát hiện lỗi thực trong chính Postgres.
Gravity hiện nay đứng ở đâu
Thiết kế Lisp IR dựa trên mã Rust viết tay trước, rồi dạy Gravity sinh IR được inline, late materialization và tối ưu thanh ghi, đã đưa nhóm rất gần mục tiêu. Trên nhiều truy vấn phân tích, Gravity biên dịch JIT trong dưới 1 mili giây và thực thi trong khoảng 10–20% so với mã Rust viết tay.
Khi cô lập riêng engine truy vấn — chạy cùng một binary pgrust trên cùng một bảng dạng cột, bật và tắt Gravity so với executor dòng kiểu Volcano:
- Nhanh hơn 102 lần khi chạy lạnh (cold)
- Nhanh hơn 499 lần khi chạy nóng (hot)
- Nhanh gấp 3 lần ClickHouse trên một số truy vấn, vẫn giữ đầy đủ cú pháp và hệ kiểu Postgres
Đối với người dùng chuyển từ Postgres: trên máy c6a.4xlarge của ClickBench, điểm tổng hợp của pgrust v0.4-beta tốt hơn PostgreSQL 17 hơn 1.000 lần, và 1.365 lần với các lần chạy lạnh.
Ý nghĩa với cộng đồng kỹ thuật Việt Nam
Với các đội ngũ đang vận hành hệ thống phân tích dữ liệu lớn, những kết quả này đáng để theo dõi. Một engine hỗ trợ trọn vẹn cú pháp Postgres nhưng nhanh hơn ClickHouse hàng lần đồng nghĩa có thể giữ nguyên mã SQL hiện hữu mà vẫn tăng mạnh hiệu năng — giảm nhu cầu di trú sang hệ thống mới hoặc mở rộng cụm phần cứng tốn kém.
Cách tiếp cận "bắt đầu từ giới hạn vật lý rồi đi ngược lại" cũng là bài học thiết kế đáng giá cho bất kỳ ai làm việc với hệ thống hiệu năng cao: biết được trần hiệu năng giúp đánh giá đúng mức độ tối ưu còn có thể đạt được.
Mã nguồn Lisp IR, backend TPDE và lowerer có thể xem tại github.com/malisper/pgrust.