
H-Nets và bài học cay đắng: Bước đột phá mới giúp mô hình AI học trực tiếp từ dữ liệu thô
Cartesia AI công bố kết quả ấn tượng của Hierarchical Networks (H-Nets) — kiến trúc học trực tiếp từ byte thay vì phụ thuộc vào tokenizer thủ công. H-Net đạt hiệu quả tính toán cao hơn 1,28-2 lần so với Transformer dùng BPE, và đặc biệt vượt trội trên code với mức tiết kiệm lên tới 5 lần, mở ra hướng đi mới cho AI đa phương thức.
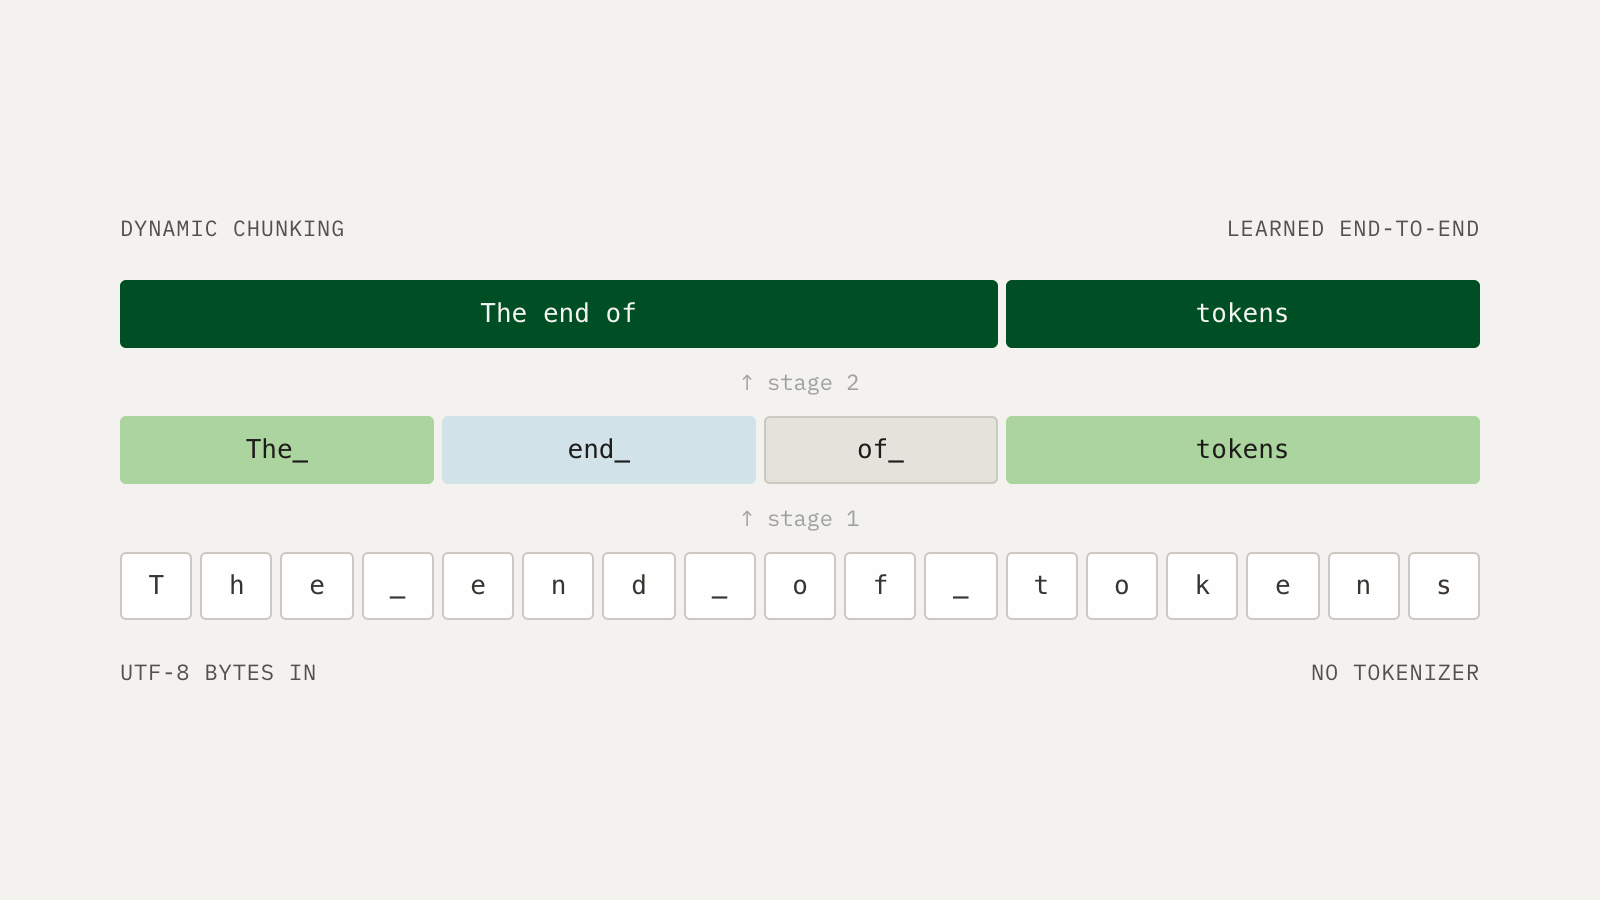
H-Nets và bài học cay đắng: Khi AI học trực tiếp từ byte thay vì token
Trong nhiều năm, các mô hình ngôn ngữ lớn (LLM) vẫn phụ thuộc vào tokenizer — một bước tiền xử lý do con người thiết kế thủ công để chia văn bản thành các đơn vị nhỏ hơn. Cartesia AI vừa công bố kết quả nghiên cứu về Hierarchical Networks (H-Nets), một kiến trúc mạng nơ-ron có khả năng học trực tiếp từ dữ liệu thô (byte) và tự động phân đoạn dữ liệu bên trong mô hình.
Kết quả cho thấy H-Net không chỉ thay thế tokenizer hiệu quả mà còn vượt trội về hiệu suất tính toán — đặc biệt trên các lĩnh vực khó phân tách như lập trình, sinh học và âm thanh.
Bài học cay đắng và giới hạn của tokenizer
Từ bài tiểu luận có ảnh hưởng của Richard Sutton năm 2019, khái niệm "bài học cay đắng" (bitter lesson) đã định hình phần lớn tiến bộ hiện đại của AI. Triết lý này cho rằng các phương pháp tổng quát, tận dụng sức mạnh tính toán và học theo quy mô, ít phụ thuộc vào thiết kế thủ công của con người, sẽ luôn thắng thế về lâu dài.
"Nếu chúng ta thậm chí không thể học ngôn ngữ tốt từ ký tự và byte, thì lấy đâu ra tư cách để tiến tới biên giới tiếp theo?"
Các mô hình ngôn ngữ hiện nay — dù thành công rực rỡ — vẫn dựa vào Byte Pair Encoding (BPE), một thuật toán gộp các cặp byte xuất hiện thường xuyên nhất thành token. Với Llama-3, mỗi token trung bình chứa khoảng 4,57 byte. Tuy nhiên, đây là bước nén cố định, được thiết kế bởi con người chứ không được học từ dữ liệu — đi ngược lại tinh thần của bài học cay đắng.
H-Net hoạt động như thế nào?
H-Net thay thế tokenizer tĩnh bằng quá trình phân đoạn động (dynamic chunking) diễn ra ngay bên trong mô hình. Kiến trúc gồm năm thành phần chính:
- Encoder: đọc dữ liệu đầu vào dạng byte
- Chunker (học được): nén các byte thành các khối (chunk) có ý nghĩa
- Main network: xử lý trên các khối thô — tương tự vai trò của token
- Dechunker: giải nén các khối trở lại độ phân giải gốc
- Decoder: hoàn tất quá trình xử lý biểu diễn kết hợp
Điểm khác biệt then chốt là H-Net có thể lồng ghép đệ quy nhiều tầng phân đoạn — ký tự thành từ, từ thành cụm, cụm thành khái niệm. Toàn bộ quá trình này diễn ra end-to-end, không cần bước tiền xử lý ngoại tuyến.
Hiệu quả tính toán vượt trội
Nhóm nghiên cứu đã xây dựng một thang quy mô (scaling ladder) chuẩn cho Transformer dùng BPE, sau đó thay thế từng bậc bằng H-Net tương đương. Kết quả:
- Tiết kiệm 22% tính toán trên dữ liệu kiểm định khi so sánh H-Net với Transformer BPE được huấn luyện trên cùng phân phối dữ liệu
- Gấp đôi hiệu quả trên các bộ đánh giá downstream như Paloma và OLMES
- H-Net nhất quán đạt loss thấp hơn ở mọi kích thước mô hình
Đáng chú ý nhất là kết quả trên code. H-Net đạt hệ số tiết kiệm tính toán từ 1,49 lần (Markdown) đến 2,40 lần (Go), trung vị 2,04 lần trên 15 ngôn ngữ lập trình trong tập huấn luyện. Với 10 ngôn ngữ nằm ngoài phân phối — như OCaml, Prolog, Lean, Fortran — con số này tăng vọt lên trung vị 3,10 lần, thậm chí 5,37 lần với Prolog.
"Khả năng mô hình hóa ngôn ngữ không chỉ phụ thuộc vào tính toán và tham số, mà còn vào việc học đúng ý nghĩa từ dữ liệu."
Lý do được nhóm nghiên cứu đưa ra: code có cấu trúc rất linh động, với khoảng trắng, ký hiệu, cú pháp và tên biến gần như tạo thành từ vựng vô hạn. Các token cố định định trước khó nắm bắt được đầy đủ ngữ nghĩa, trong khi H-Net học cách phân đoạn theo ngữ cảnh.
H-Net quy mô lớn: 1.000 tỷ token thay vì 11.000 tỷ
Nhóm nghiên cứu tiếp tục mở rộng H-Net hai tầng lên quy mô lớn hơn và so sánh với SmolLM3 (mô hình 3B tham số của Hugging Face có công thức huấn luyện được công khai đầy đủ).
Kết quả thực sự ấn tượng: H-Net đạt điểm trung bình cuối cùng của SmolLM3 chỉ sau khoảng 1.000 tỷ token, trong khi mô hình gốc cần tới khoảng 11.000 tỷ token. Vì hai mô hình có mức tiêu thụ tính toán trên mỗi byte tương đương, tiết kiệm về dữ liệu đồng nghĩa với tiết kiệm về FLOPs huấn luyện.
Về cấu hình, H-Net dùng 3,67 tỷ tham số (so với 3,08 tỷ của baseline), với khoảng 43% FLOPs dành cho các tầng encoder/decoder bên ngoài — thay vì chỉ 8% cho embedding và LM head ở mô hình truyền thống.
Hành vi mới: Token hóa trong ngữ cảnh
Một trong những phát hiện thú vị nhất là khả năng token hóa trong ngữ cảnh (in-context tokenization). Ranh giới phân đoạn của H-Net không dựa trên mẫu cố định mà dựa trên ngữ cảnh:
- Khái niệm mới: khi gặp từ lạ, H-Net tách thành nhiều khối; khi từ đó lặp lại nhiều lần, nó dần học cách gộp lại
- Định dạng lặp lại: với các cụm từ có quy luật, H-Net tạo ra các khối lớn để tiết kiệm tính toán
- Mẫu lặp: H-Net tự phát hiện các motif ẩn như chuỗi ký tự hay chữ số lặp lại trong dữ liệu
Khác với BPE luôn dùng ký tự xuống dòng làm ranh giới, H-Net chấp nhận các khối đa dạng gồm khoảng trắng, tab và xuống dòng — phù hợp hơn với cấu trúc thực tế của code.
Vượt xa ngôn ngữ: DNA và âm thanh
Tham vọng lớn nhất của H-Net nằm ở khả năng áp dụng cho mọi loại dữ liệu, không chỉ byte. Nhóm nghiên cứu gọi đây là hướng tiếp cận "atomic models" — xây dựng mô hình nền tảng đa phương thức từ các đơn vị nguyên thủy của từng lĩnh vực.
Với DNA, H-Net đạt mức tiết kiệm tính toán 6-7 lần so với Transformer thông thường trên cả ba bộ dữ liệu di truyền. Với âm thanh — lĩnh vực trọng tâm của Cartesia — việc mô hình không thể tự động trừu tượng hóa âm thanh thô thành âm vị và từ chính là nút thắt lớn cho các mô hình speech-to-speech đa phương thức.
Ý nghĩa đối với cộng đồng AI Việt Nam
Đối với các nhóm nghiên cứu và startup AI tại Việt Nam, hướng tiếp cận này đáng chú ý ở hai điểm:
- Tiết kiệm chi phí huấn luyện: hiệu quả tính toán cao hơn đồng nghĩa với việc có thể đạt kết quả tương đương với ngân sách nhỏ hơn đáng kể — yếu tố quan trọng với các đội ngũ có nguồn lực hạn chế
- Tiếng Việt và ngôn ngữ ít tài nguyên: H-Net học phân đoạn trực tiếp từ dữ liệu, không phụ thuộc vào phân phối tần suất của tokenizer. Điều này hứa hẹn cải thiện hiệu suất trên các ngôn ngữ có cấu trúc byte phức tạp như tiếng Việt, nơi tokenizer BPE thường nén kém hiệu quả hơn tiếng Anh
Tuy nhiên, nhóm nghiên cứu cũng thẳng thắn thừa nhận những hạn chế về phương pháp luận. Việc so sánh công bằng giữa mô hình BPE và H-Net là bài toán phức tạp: hai kiến trúc nén các miền dữ liệu theo hướng ngược nhau (BPE nén code ít hơn tiếng Anh, trong khi H-Net nén code nhiều hơn), nên không thể đồng thời khớp cả về dữ liệu lẫn tính toán. Đây vẫn là vấn đề nghiên cứu mở.
Dù vậy, kết quả hiện tại cho thấy H-Nets là một kiến trúc nền tảng thực sự phù hợp với bài học cay đắng — học ý nghĩa trực tiếp từ dữ liệu thô, cải thiện đáng kể hiệu quả và khả năng mở rộng. Trong phần tiếp theo của loạt bài, Cartesia hứa hẹn sẽ đi sâu hơn vào lý do tại sao H-Net lại hiệu quả đến vậy trong mô hình hóa ngôn ngữ.

