Hàng chục nghìn GPU Nvidia nằm không trong siêu cụm Prometheus của Meta, chờ sẵn một sự cố xảy ra
Meta tiết lộ hơn 11% GPU trong siêu cụm Prometheus ở New Albany, Ohio đang hỏng hoặc để dự phòng chờ thay thế. Hãng đã giảm số lần gián đoạn huấn luyện AI xuống 99% nhờ chiến lược GPU dự phòng, khả năng phục hồi song song và cơ chế checkpoint phân tán.
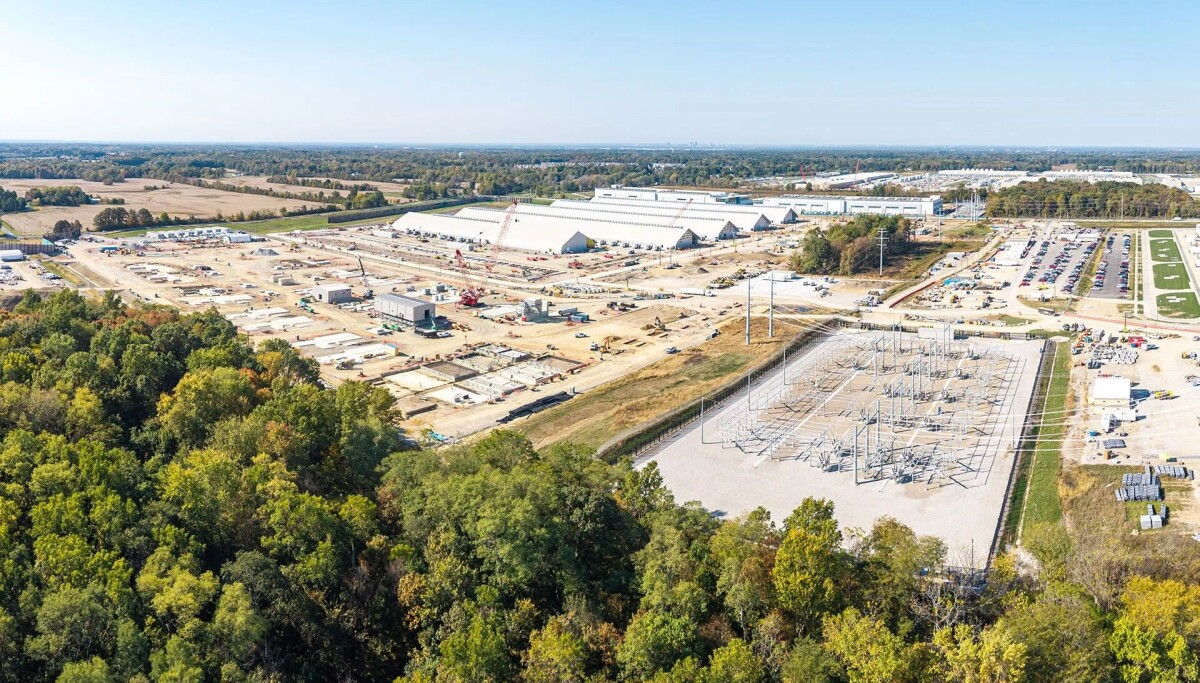
Meta vừa hé lộ những con số đáng chú ý về siêu cụm Prometheus tại New Albany, Ohio: hơn 11% số GPU trong cụm này đang hỏng hoặc nằm không, chờ sẵn để thay thế khi một GPU khác gặp sự cố. Đây là một trong nhiều biện pháp mà "gã khổng lồ" mạng xã hội áp dụng nhằm duy trì các phiên huấn luyện AI khổng lồ của mình.
Prometheus là một trong những triển khai hạ tầng tính toán lớn nhất của Meta từ trước đến nay. Cụm này sử dụng hệ thống rack Nvidia Grace Blackwell và sắp tới là Vera Rubin, với mục tiêu mở rộng lên công suất 1 gigawatt cùng khoảng một triệu bộ tăng tốc.
Càng nhiều chip, càng nhiều vấn đề
Với bất kỳ ai từng vận hành cụm máy tính quy mô lớn, dù cho huấn luyện mô hình ngôn ngữ lớn hay tính toán hiệu năng cao truyền thống, quy luật đều rõ ràng: nhiều chip đồng nghĩa với nhiều sự cố hơn.
- Trong một node tám GPU, xác suất một GPU hỏng là tương đối thấp.
- Trong một cụm 100.000 GPU, sự cố là điều không thể tránh khỏi.
Meta đang xây dựng hệ thống lớn gấp 10 lần con số đó, với các phiên huấn luyện phân tán trải rộng trên nhiều trung tâm dữ liệu. Việc giữ toàn bộ hệ thống hoạt động đủ lâu để tiến tới điểm kiểm lưu (checkpoint) tiếp theo trở thành một bài toán hóc búa.
GPU nhàn rỗi là cái giá của sự liên tục
Khi Meta bắt đầu giai đoạn đầu tiên của Prometheus, hãng ghi nhận khoảng 1.000 lần gián đoạn mỗi ngày trên mỗi 8.000 GPU. Cần lưu ý rằng gián đoạn không hẳn là GPU hỏng, mà chỉ là một thành phần nào đó gặp sự cố, bị lỗi hoặc quá thời gian chờ, buộc phiên huấn luyện phải dừng lại và quay về checkpoint tốt nhất gần nhất.
Chỉ trong vòng một năm, Meta tuyên bố đã giảm số lần gián đoạn xuống 99%, còn khoảng 11 lần mỗi ngày trên mỗi 8.000 GPU.
Một trong những cách làm đó là giữ một phần GPU của Prometheus ở trạng thái dự phòng. Cụm hiện dùng kết hợp hệ thống GB200 và GB300, mỗi hệ thống có 72 GPU trong một miền NVLink. Tuy nhiên, chỉ 64 GPU được đưa vào sử dụng tại bất kỳ thời điểm nào, 8 GPU còn lại đóng vai trò "dự phòng nóng".
Lý do rất thực tế: chỉ một GPU hỏng cũng có thể làm sập cả một rack và ngắt phiên huấn luyện. Giờ đây, khi một GPU gặp lỗi, một GPU dự phòng sẽ lập tức thay thế, giúp Meta không phải loại bỏ toàn bộ rack khỏi cụm hoặc chờ kỹ thuật viên thay linh kiện.
Khả năng phục hồi song song
Để giảm thiểu tác động hơn nữa, Meta tận dụng đặc điểm của các tác vụ huấn luyện quy mô lớn vốn thường dùng song song dữ liệu (data parallelism), tức nhiều bản sao của mô hình cùng tồn tại trong cụm.
"Khi một lỗi có thể cô lập trong một bản sao mô hình song song dữ liệu, chúng tôi giảm tác động của sự cố phần cứng bằng cách cho phép bản sao lỗi tạm rút khỏi hệ thống, trong khi phần cụm còn lại lặp lại bước đó và tiếp tục huấn luyện", Meta giải thích. "Phân đoạn bị ảnh hưởng chỉ cần khởi động lại trên các host dự phòng sẵn có và đồng bộ lại, biến một lần dừng toàn hệ thống thành một sự sụt giảm tạm thời nhỏ về thông lượng tổng."
Nói cách khác, các phiên huấn luyện của Meta chỉ bị gián đoạn khi lỗi vượt ra ngoài phạm vi song song dữ liệu. Khi đó, hãng đã triển khai một cơ chế checkpoint toàn diện, có thể hình dung như tính năng tự động lưu hay lịch sử phiên bản, để không phải bắt đầu lại từ đầu.
"Kiến trúc checkpoint phân tán của chúng tôi lưu bất đồng bộ trạng thái mô hình, bao gồm gradient và dữ liệu optimizer, xuống hệ thống lưu trữ nhiều tầng", công ty cho biết.
Nỗi đau từ NVLink
Meta thừa nhận một trong những thách thức khó khăn nhất là làm cho các "kết cấu" NVLink dùng để nối 72 GPU hoạt động như một bộ tăng tốc khổng lồ duy nhất. Các hệ thống dùng H100 và H200 trước đây chỉ có 8 GPU mỗi miền NVLink, nghĩa là liên kết ngắn hơn nhiều và ít hơn đáng kể. Thế hệ Blackwell của Nvidia đã mở rộng con số này lên gấp chín lần.
"Với hơn 600.000 kết nối NVLink, ngay cả sự suy giảm tín hiệu ở mức nhỏ cũng kích hoạt các chu kỳ phục hồi NVLink thường xuyên", Meta viết.
Để khắc phục, Meta phải triển khai một hệ thống đo từ xa liên tục và thực hiện các bài kiểm tra chẩn đoán L11 nhằm phát hiện các liên kết yếu trước khi đưa hệ thống vào vận hành.
Nguồn điện là một thách thức khác. Việc tăng giảm đột ngột hàng chục nghìn GPU cho một phiên huấn luyện có thể tạo ra những đợt tăng vọt công suất tiêu thụ, gọi là quá độ (transient), đủ sức làm quá tải thiết bị cấp nguồn.
Kết quả đạt được
Theo Meta, nhờ tập trung vào độ ổn định và độ tin cậy của cụm, hãng đã đạt mức "goodput" hơn 85% (thông lượng hữu ích) cho quá trình tiền huấn luyện và hơn 90% cho học tăng cường trên mô hình mới nhất Muse Wonder.
Tham vọng của Meta không dừng lại ở đây. Trên con đường tiến tới một triệu GPU, hãng đặt mục tiêu giảm tỷ lệ gián đoạn xuống chỉ còn hai lần mỗi ngày trên mỗi 8.000 GPU, tương đương khoảng 100.000 giờ GPU giữa hai lần gián đoạn.
Câu chuyện của Prometheus phần nào phản ánh cuộc đua hạ tầng AI khốc liệt hiện nay, nơi thành công không chỉ đến từ việc sở hữu nhiều chip mạnh nhất, mà còn từ khả năng kỹ thuật để giữ hàng triệu linh kiện cùng vận hành ổn định. Với các doanh nghiệp và nhà phát triển Việt Nam đang quan tâm đến hạ tầng AI, bài học về dự phòng, giám sát và thiết kế hệ thống chịu lỗi này cũng rất đáng tham khảo khi xây dựng cụm tính toán quy mô lớn.