Inception ra mắt Mercury 3: Mô hình AI khuếch tán đạt tốc độ 1.000 token/giây
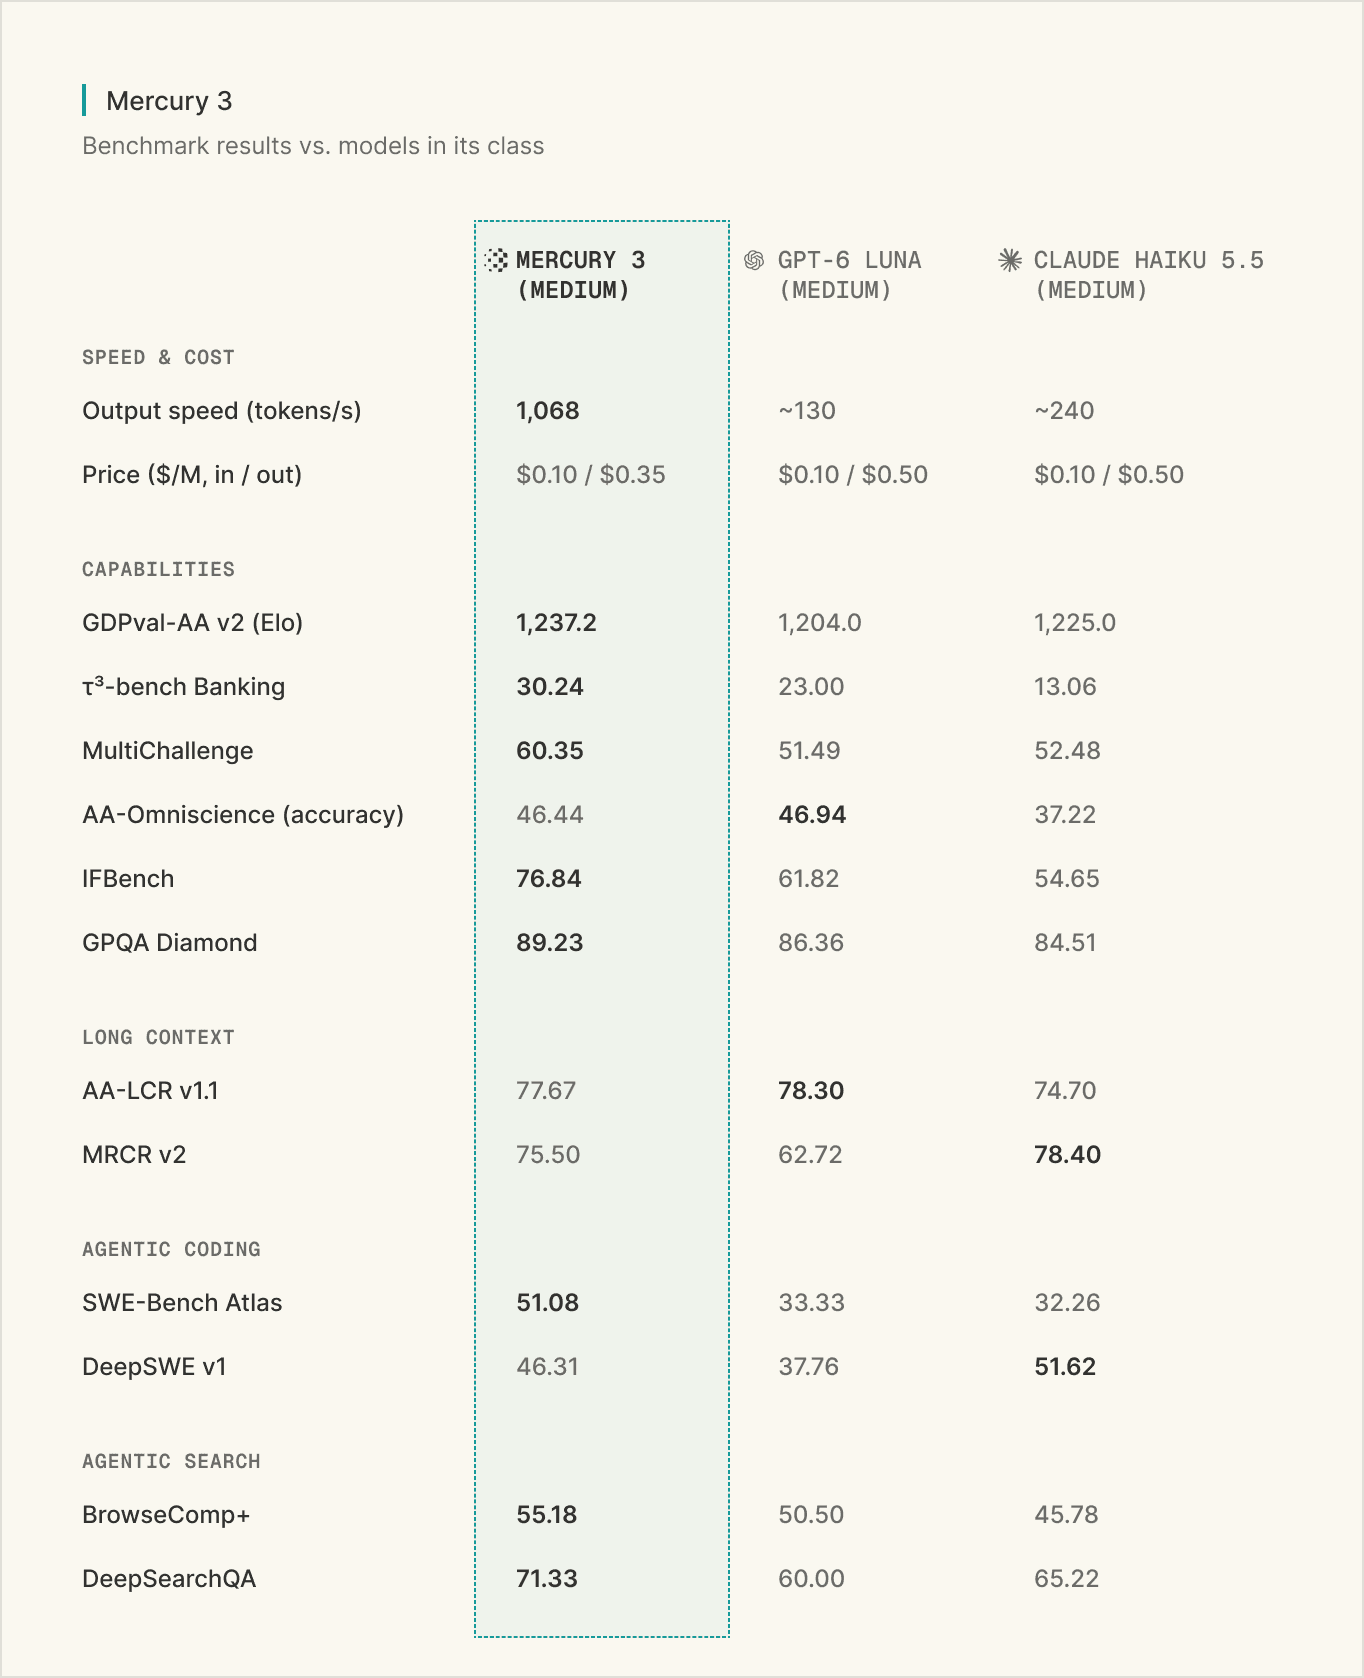
Inception vừa công bố Mercury 3, mô hình ngôn ngữ lớn dựa trên kỹ thuật khuếch tán (diffusion) mạnh nhất từ trước đến nay. Mercury 3 vượt qua GPT-6 Luna và Claude Haiku 5.5 trên nhiều bài kiểm tra, đồng thời chạy nhanh gấp 4–8 lần với tốc độ hơn 1.000 token mỗi giây. Đây là bằng chứng cho thấy kỹ thuật khuếch tán văn bản có thể mở rộng quy mô để cạnh tranh với các mô hình tự hồi quy.
Inception ra mắt Mercury 3: Mô hình AI khuếch tán đạt tốc độ 1.000 token/giây
 Logo Mercury 3 của Inception
Inception vừa chính thức giới thiệu Mercury 3, được họ mô tả là mô hình ngôn ngữ lớn dựa trên kỹ thuật khuếch tán (diffusion) mạnh nhất từng được phát hành. Trên hàng loạt bài đánh giá chuẩn, Mercury 3 được cho là vượt qua GPT-6 Luna và Claude Haiku 5.5, trong khi chạy nhanh gấp 4–8 lần với tốc độ vượt 1.000 token mỗi giây.
Điểm đáng chú ý nhất: Mercury 3 chứng minh rằng kỹ thuật khuếch tán văn bản có thể mở rộng quy mô. Mô hình này lớn hơn Mercury 1 hơn 40 lần và thông minh hơn hẳn, nhưng vẫn giữ nguyên tốc độ.
Thông số nổi bật của Mercury 3
- Chất lượng: Ngang bằng hoặc tốt hơn các mô hình tối ưu tốc độ hàng đầu như GPT-6 Luna và Claude Haiku 5.5.
- Tốc độ: Đạt 1.068 token mỗi giây trên GPU NVIDIA.
- Ngữ cảnh: 1 triệu token, tăng mạnh so với 260K của Mercury 2.5.
- Giá: 0,20 USD cho mỗi triệu token đầu vào và 0,70 USD cho mỗi triệu token đầu ra.
- Ưu đãi ra mắt: Giảm 50%, còn 0,10 USD cho mỗi triệu token đầu vào và 0,35 USD cho mỗi triệu token đầu ra. Token được lưu trong bộ nhớ đệm (cache) được giảm 90% so với giá đầu vào.
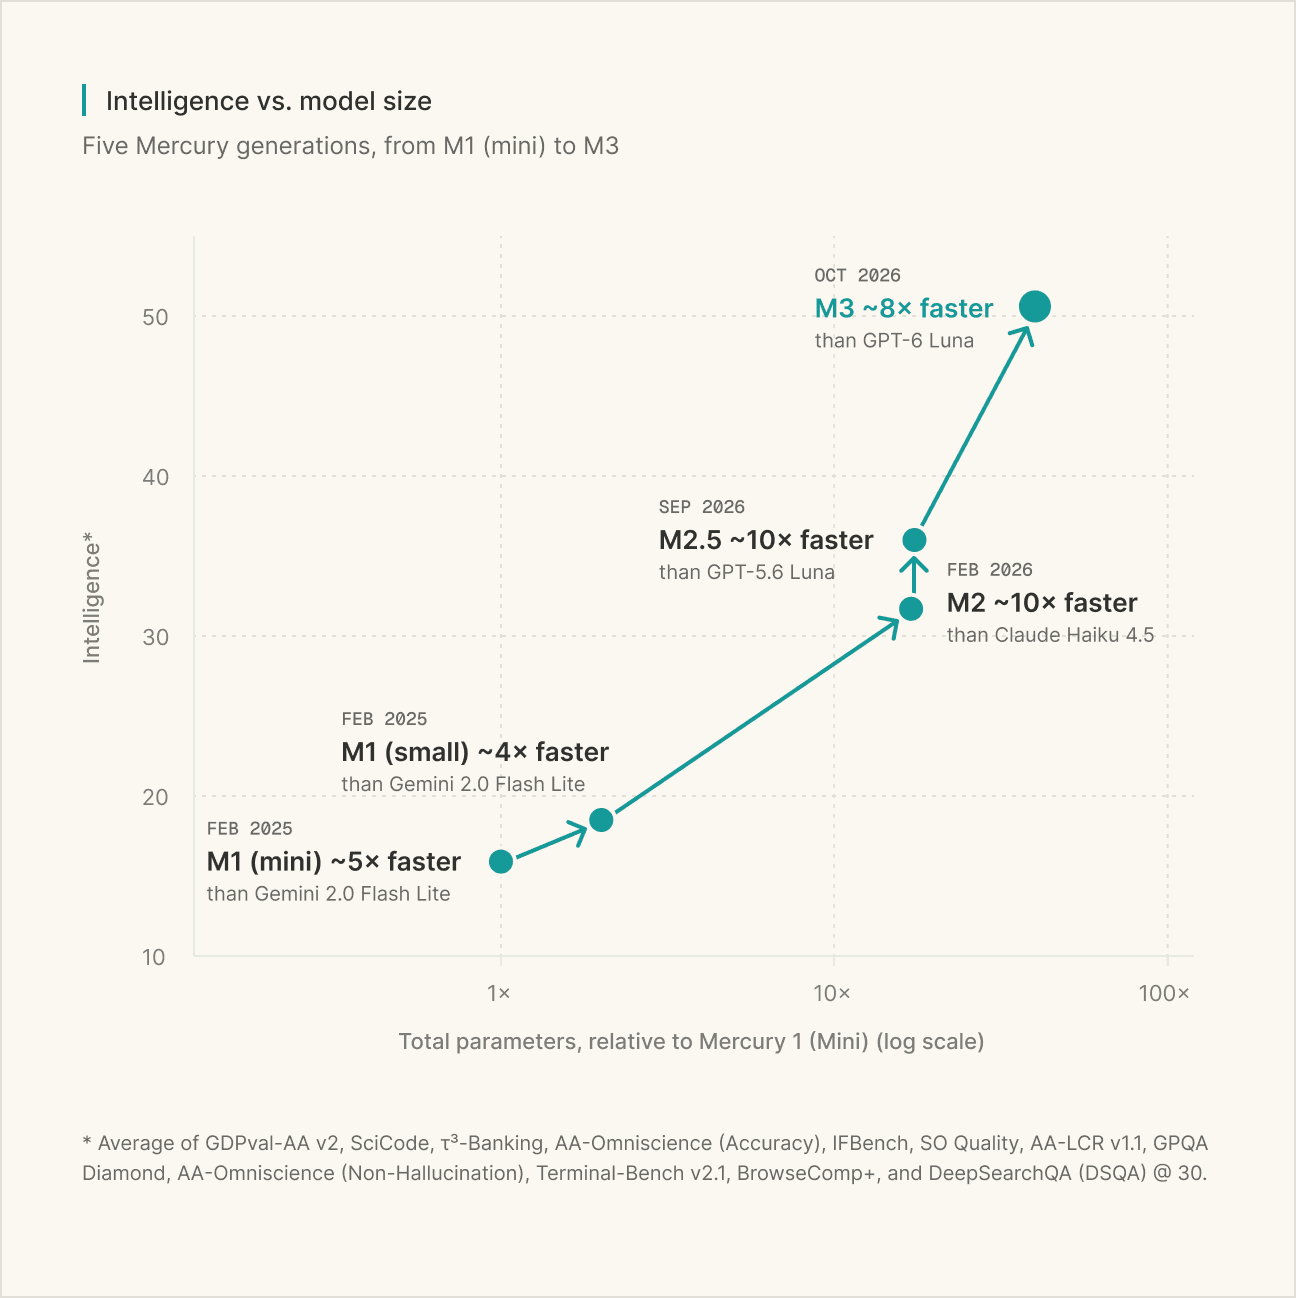 Biểu đồ hiệu năng và tốc độ của Mercury 3
Khi Mercury 1 ra mắt, đây là bằng chứng đầu tiên cho thấy các mô hình khuếch tán có thể được xây dựng cho ứng dụng thương mại. Câu hỏi còn bỏ ngỏ trong cộng đồng AI là liệu mô hình khuếch tán có thể mở rộng để cạnh tranh với các mô hình tự hồi quy (autoregressive) trong các tình huống phức tạp hay không.
Mercury 3 đưa ra câu trả lời khẳng định. Inception đã tăng quy mô tổng số tham số của Mercury hơn 40 lần, và chỉ số thông minh trên nhiều bài kiểm tra chuẩn đã tăng gấp 3 lần từ Mercury 1 (bản mini) lên Mercury 3. Điều này cho thấy các quy luật mở rộng (scaling laws) vốn thúc đẩy tiến bộ ở mô hình tự hồi quy cũng đúng với kỹ thuật khuếch tán.
Ứng dụng thực tế: Tác nhân AI, giáo dục và hỗ trợ khách hàng
Các đối tác dùng thử sớm đã triển khai Mercury 3 cho những ứng dụng nhạy cảm với độ trễ như tác nhân điều khiển trình duyệt, giáo dục tương tác, tác nhân tìm kiếm thời gian thực và hỗ trợ khách hàng.
Tác nhân AI phải chờ mô hình ở mỗi bước, nên những độ trễ nhỏ sẽ cộng dồn rất nhanh. Mercury giữ cho mỗi lượt xử lý diễn ra nhanh, dù tác nhân đang điều hướng website, nghiên cứu nhiều nguồn hay phân tích log và truy vết sự cố. Nhờ vậy, tác nhân hoàn thành công việc sớm hơn và có thời gian thử thêm nhiều hướng tiếp cận trước khi trả lời.
Trong thử nghiệm với bộ khung tác nhân web đang dùng trong môi trường thực tế của Inception, Mercury 3 hoàn thành 50% trong số 50 tác vụ điều hướng Mind2Web trực tiếp, cao hơn đáng kể so với GPT-6.1-Sol. Đáng chú ý, mô hình đạt kết quả này với cùng lượng token và cùng số bước tác nhân như một mô hình hàng đầu, nhưng chi phí trên mỗi token chỉ bằng một phần nhỏ.
"Mercury 3 cho phép chúng tôi mang đến phản hồi tức thì cho từng học viên mà không phải đánh đổi khả năng suy luận. Gợi ý, đáp án được chấm và định nghĩa giờ trả về chỉ trong khoảng một giây, với chất lượng ngang bằng hoặc tốt hơn các mô hình chúng tôi dùng trước đây."
— Michael Tong, đồng sáng lập kiêm CTO của General Learning (tức RevisionDojo)
Với các ứng dụng tìm kiếm, độ trễ vài giây đã đủ khiến người dùng cảm thấy chậm chạp. Mercury 3 đủ nhanh để xử lý hàng chục tài liệu mà vẫn trả lời ngay khi người dùng còn đang tập trung.
Trên kính thông minh, một câu trả lời mất năm giây bị coi là hỏng. Trong các bài kiểm tra API Sense của Octen, khâu tìm kiếm chỉ mất khoảng 80ms, còn việc sinh văn bản của mô hình mới là nút thắt cổ chai. Mercury 3 mang lại sự cân bằng tốt nhất giữa tốc độ và chất lượng trong số các mô hình nhanh được thử nghiệm, với thời gian sinh trung vị 0,9 giây và thời gian phản hồi đầu-cuối trung vị 2,2 giây.
Danh mục sản phẩm mở rộng cho AI thời gian thực
Mercury 3 là mô hình chủ lực trong danh mục sản phẩm ngày càng mở rộng của Inception nhằm phục vụ AI thời gian thực.
- Mercury Voice: Được tùy chỉnh cho yêu cầu độ trễ cực thấp của các ứng dụng giọng nói, tập trung giảm thời gian tới token trả lời đầu tiên (TTFAT) chứ không chỉ độ trễ đầu-cuối. Sản phẩm đã được dùng để vận hành tác nhân tại Audivi AI, Altur và OpenCall.
- Mercury Decide: Mô hình ra quyết định dành cho phân loại khối lượng lớn, vượt qua Jev trên các bài kiểm tra như JevBench và LegalBench.
Mercury 3 hiện có sẵn trên nền tảng Inception API, đồng thời thông qua OpenRouter, Baseten và Vercel. Mô hình tương thích với API của OpenAI, nên có thể tích hợp thẳng vào hệ thống hiện có mà không cần viết lại mã nguồn. Các bản triển khai doanh nghiệp hỗ trợ dung lượng riêng, tự động mở rộng (autoscaling), kiểm soát tuân thủ và cấu hình thời gian lưu trữ dữ liệu.
Ý nghĩa với thị trường AI
Sự ra mắt của Mercury 3 đánh dấu một bước tiến quan trọng trong cuộc đua giữa hai hướng tiếp cận: mô hình tự hồi quy truyền thống và mô hình khuếch tán. Nếu kỹ thuật khuếch tán thực sự mở rộng được quy mô như Inception tuyên bố, các nhà phát triển sẽ có thêm lựa chọn với tốc độ vượt trội và chi phí thấp hơn — yếu tố đặc biệt quan trọng với các ứng dụng AI thời gian thực như trợ lý giọng nói, tác nhân tự động và giáo dục trực tuyến.
 Minh họa mô hình khuếch tán văn bản
Với cộng đồng phát triển tại Việt Nam, việc Mercury 3 tương thích API OpenAI và có mặt trên các nền tảng như Vercel hay OpenRouter đồng nghĩa với việc có thể thử nghiệm và tích hợp tương đối nhanh vào các sản phẩm hiện có, từ chatbot hỗ trợ khách hàng đến công cụ tìm kiếm nội bộ, mà không phải đại tu toàn bộ hệ thống.