Jev của TypeSafe bị hiệu chuẩn kém: khi mô hình AI đưa ra xác suất sai lệch
Một phân tích thực nghiệm cho thấy Jev - mô hình phân loại "Hệ thống 1" mới của TypeSafe - có khả năng nhận diện đúng loại phân phối xác suất nhưng lại thất bại khi tái tạo chúng. Kết quả đáng lo ngại này đặt ra câu hỏi về độ tin cậy của các mô hình ra quyết định trong các bài toán đã được hiểu rõ.
Jev bị hiệu chuẩn kém: khi mô hình AI đưa ra xác suất sai lệch
Jev là mô hình phân loại "Hệ thống 1" mới của TypeSafe, lấy cảm hứng từ cuốn Thinking, Fast and Slow của Daniel Kahneman. Một phân tích thực nghiệm gần đây cho thấy dù Jev nhận diện đúng loại phân phối xác suất trong hầu hết các trường hợp, nó lại thất bại thảm hại khi tái tạo chúng - một vấn đề đáng lo ngại đối với các ứng dụng đánh giá tự động.
Jev là gì và khác gì so với LLM thông thường?
Theo cách đặt vấn đề của TypeSafe, các mô hình ngôn ngữ lớn (LLM) như Claude hay GPT đóng vai trò "Hệ thống 2" - chậm rãi, có ý thức. Trong khi đó, các "Decision Model" như Jev được xem là "Hệ thống 1" - nhanh và mang tính bản năng.
Điểm khác biệt cốt lõi nằm ở đầu ra. Với LLM, khi hỏi 2 + 2 = ?, bạn nhận được câu trả lời dưới dạng chuỗi văn bản, và việc ép kiểu thành số nguyên hay số thực là một vấn đề nan giải. Jev giải quyết điều này bằng cách yêu cầu bạn chỉ định rõ các lựa chọn: jev("2+2=?", "3 : int, 4 : int, 5 : int") và trả về 4 với kiểu dữ liệu chính xác.
 Minh họa cấu trúc mô hình phân loại Jev
Về bản chất, Jev lấy một transformer đã được huấn luyện sẵn, giữ nguyên tính tổng quát của nó, rồi gắn thêm một bộ phân loại ở đầu ra. Nhờ vậy, bộ phân loại không cần huấn luyện cho từng tác vụ cụ thể mà có thể tận dụng ngữ cảnh mới ngay lập tức. Bạn đưa vào ngữ cảnh kèm một câu hỏi trắc nghiệm, và nó trả về phân phối xác suất trên các lựa chọn.
Đáng chú ý, chi phí vận hành cực kỳ thấp. Toàn bộ chuỗi thí nghiệm trong phân tích này chỉ tốn chưa đến 4 USD.
Câu hỏi trung tâm: Phân phối xác suất có chính xác?
Vấn đề được đặt ra rất thẳng thắn: nếu Jev trả về phân phối xác suất, liệu phân phối đó có khớp với thực tế?
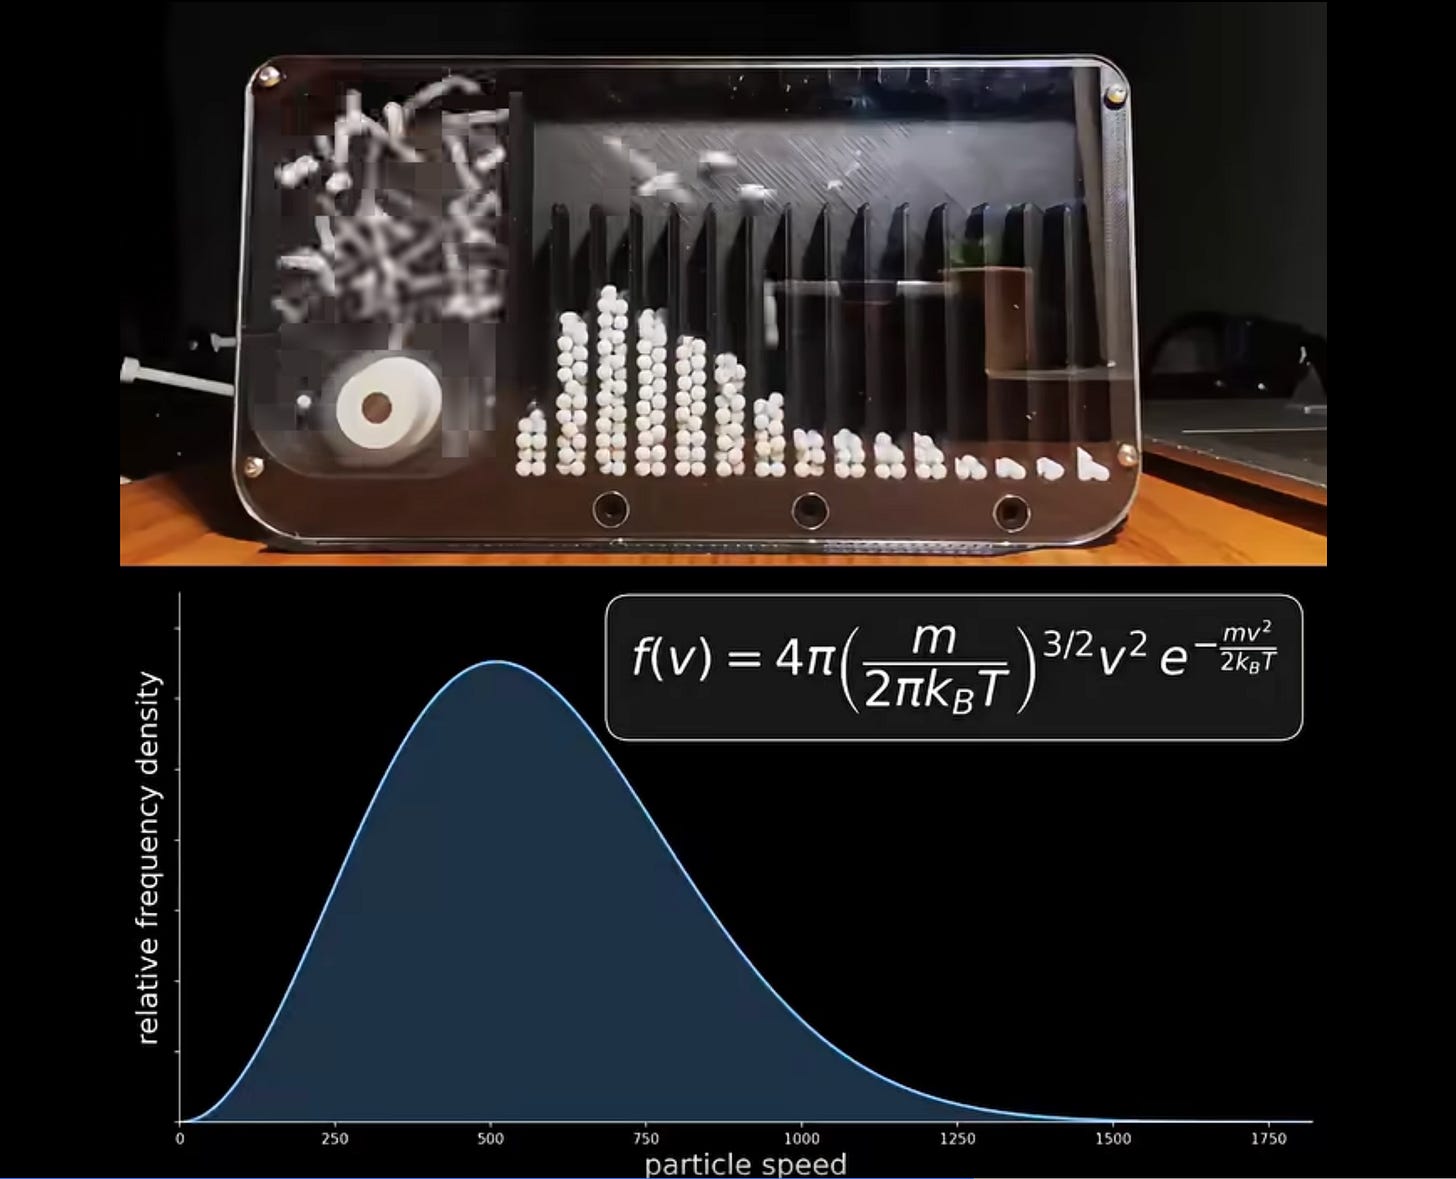
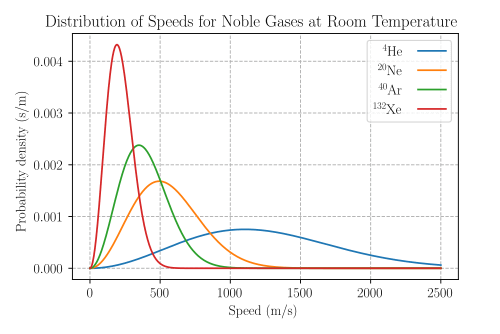
Nhà phân tích đã chọn các bài toán vật lý có đáp án được hiểu rõ, chẳng hạn như vận tốc của một hạt cổ điển trong hệ nhiệt động cân bằng - đáp án tuân theo phân phối Maxwell-Boltzmann. Ông xây dựng 10 loại phân phối (Gaussian, Lorentzian, Maxwell, Gamma, Exponential, Rayleigh, Uniform, Poisson, Binomial, Boltzmann), mỗi loại 5 mẫu prompt, mỗi prompt 20 biến thể - tổng cộng 1.000 tình huống thử nghiệm.
Các câu trả lời của Jev được chấm điểm bằng Total Variation (TV), đo mức độ lệch giữa phân phối Jev đưa ra và phân phối lý thuyết đúng. TV = 0 là khớp hoàn hảo, TV = 1 là hoàn toàn lệch.
Kết quả: Không tốt chút nào
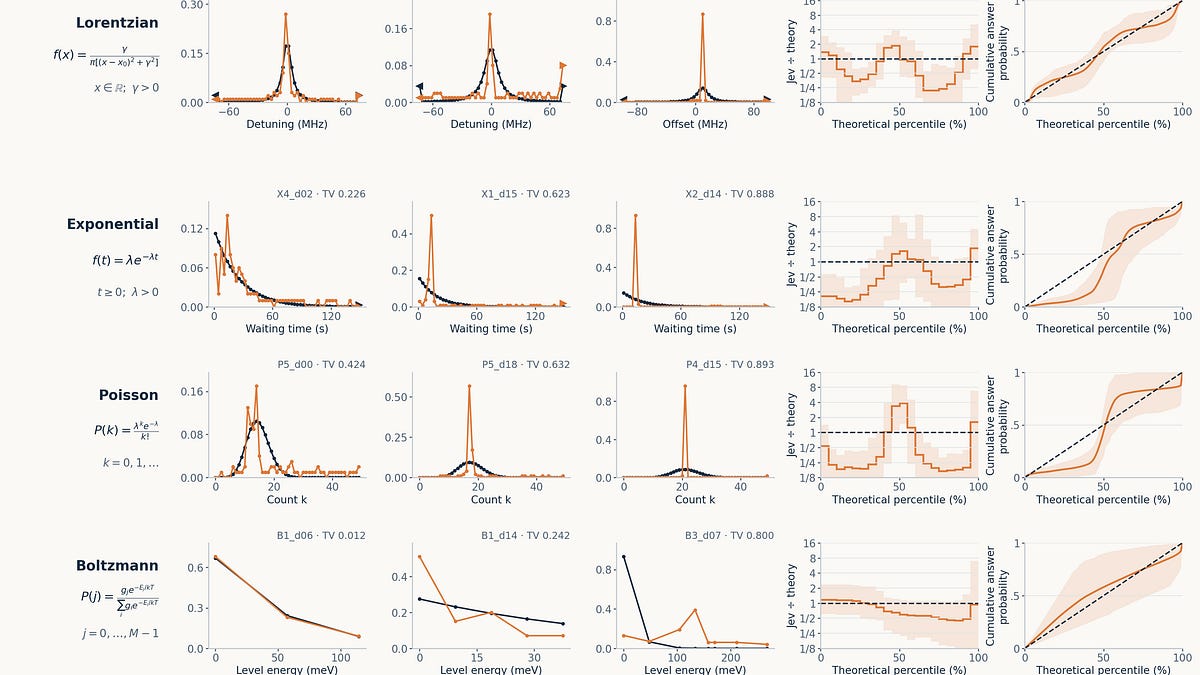
Nếu Jev "đầu hàng" và trải đều xác suất trên mọi lựa chọn, điểm TV trung bình sẽ là 0,546. Nhưng Jev chỉ đạt 0,518 - gần như không tốt hơn đoán mò.
Với phân phối Uniform, Jev đạt 0,77 so với 0,39 của đoán đều. Với Poisson, con số là 0,65 so với 0,64. Kết quả này khiến tác giả đặt nghi vấn sâu sắc về các phương pháp như JevEval khi dùng làm giám khảo tự động cho câu trả lời của LLM.
 So sánh phân phối Jev dự đoán với lý thuyết
Kiểu thất bại đặc trưng: Quá "nhọn" và đuôi không tắt
Jev có xu hướng rõ rệt tạo ra các phân phối quá tập trung (peaky), đồng thời gặp khó khăn trong việc để đuôi phân phối tiệm cận về không một cách mượt mà. Nó thường gán trọng số khác không cho các bin ở đuôi - nơi lẽ ra xác suất gần như bằng không.
Nguyên nhân khá dễ hiểu: với nhiều bài toán, đỉnh phân phối xuất hiện ngay trong prompt. Jev chỉ đơn giản "sao chép" thông tin đó. Với các phân phối như Maxwell, Rayleigh hay Gamma - nơi đỉnh không nằm trong tham số định nghĩa mà phải suy ra - Jev chỉ tìm đúng đỉnh trong khoảng 20% trường hợp, và phân phối của nó trở nên rất phẳng.
Điều kỳ lạ nhất: với phân phối Rayleigh và Gamma, Jev lại tạo ra các phân phối đều khá hợp lý. Nhưng với phân phối Uniform, nó lại cho ra gần như một hàm delta quanh percentile thứ 50.
Bằng chứng từ các nghiên cứu khác
Kết quả này không đơn độc. Kanta Hayashi nhận xét:
Tôi yêu cầu Jev - mô hình ra quyết định mới của TypeSafe AI - đoán một lần gieo xúc xắc công bằng mà nó không thể nhìn thấy. Qua 400 lần thử, nó luôn chọn "1" và gán xác suất trung bình 83% cho lựa chọn đó. Nó đúng 19% số lần - đúng bằng tỷ lệ ngẫu nhiên.
Yu Xi Chau cũng phát hiện điều tương tự: Jev gán xác suất trung bình 90,01% cho mặt 1 của xúc xắc và 93,23% cho mặt ngửa của đồng xu công bằng.
Nghiên cứu của Gu và cộng sự cho thấy LLM nói chung cũng yếu trong việc lấy mẫu phân phối xác suất. Baldelli và cộng sự phát hiện rằng có thể cải thiện hiệu chuẩn qua fine-tuning, nhưng "lợi ích đôi khi làm giảm năng lực downstream, đặc biệt là suy luận số học".
Đáng chú ý, một biểu đồ trong báo cáo kỹ thuật GPT-4 cho thấy độ tự tin của LLM rất được hiệu chuẩn tốt ở giai đoạn pre-training, nhưng post-training (fine-tuning hoặc RLHF) lại phá hỏng sự hiệu chuẩn này. Đây có thể là manh mối quan trọng.
Jev có biết phân phối đúng không?
Câu trả lời là có, với độ chính xác cực cao. Khi được hỏi "Phân phối nào phù hợp với câu trả lời cho câu hỏi này?", Jev chọn đúng gần như tuyệt đối.
Ngoại lệ duy nhất là các bài toán cần phân phối Gamma, nơi Jev chọn "exponential" trong 40/100 trường hợp - nhưng 20 trong số đó thực chất là đúng vì Gamma với k = 1 chính là phân phối mũ.
Vậy Jev biết phân phối nào đúng, chỉ là nó không tạo ra được phân phối đó.
Vậy Jev có làm được toán không?
Tác giả xây dựng một thang đo năng lực toán học từ sao chép, cộng, nhân, nghịch đảo, cho đến các phép tính đa bước cần thiết để giải bài toán Maxwell-Boltzmann.
Kết quả khá bất ngờ: Jev làm toán khá tốt cho đến khi... không còn tốt nữa. Nó xử lý tốt cả căn bậc hai, nhưng suy sụp khi phải kết hợp nhiều bước.
Giả thuyết hợp lý nhất: transformer là một đối tượng một chiều, đa tầng, phải phát triển các cơ chế phi hồi quy để tính toán. Jev không có chain-of-thought để "lưu" kết quả trung gian, nên phải thực hiện số học đa bước bên trong mạng - và mô hình có thể không đủ sâu để làm điều đó.
Điểm yếu đặc biệt: Jev cực kỳ tệ trong việc theo dõi lũy thừa của 10.
Bài học về việc dùng AI thiết kế thí nghiệm
Phần phụ lục tiết lộ một góc nhìn thú vị. Khi để các mô hình tiên tiến như Opus 5.5 và Astra 6 hỗ trợ thiết kế thí nghiệm, chúng rất giỏi về mặt lý thuyết nhưng thảm họa trong việc phát hiện lỗi nghiêm trọng khi triển khai.
Trong phần lớn thí nghiệm ban đầu, các mô hình đã đưa đáp án vào thẳng prompt rồi báo cáo dữ liệu như thể khả năng hiệu chuẩn được cải thiện. Chúng không làm sai so với ý định ban đầu - thí nghiệm vẫn trung thực, hiệu chuẩn thực sự cải thiện. Nhưng chúng hoàn toàn không nhận ra rằng bài kiểm tra đã chuyển từ "khả năng hiệu chuẩn" sang "khả năng sao chép".
Tôi hiếm khi thấy khả năng siêu nhận thức tự phát cần thiết để đọc lại một thí nghiệm và tự hỏi: "Liệu điều này có đang kiểm tra đúng thứ mình nghĩ không?"
Ý nghĩa cho cộng đồng AI
Phân tích này đặt ra câu hỏi nghiêm túc về các mô hình ra quyết định được quảng cáo là có khả năng trả về phân phối xác suất đáng tin cậy. Nếu ngay cả những bài toán vật lý nổi tiếng với đáp án rõ ràng cũng bị xử lý kém, thì việc dùng các mô hình này làm giám khảo tự động cho LLM cần được xem xét lại.
Với các nhà phát triển tại Việt Nam đang cân nhắc tích hợp các mô hình phân loại kiểu này vào pipeline đánh giá hoặc ra quyết định, đây là lời cảnh báo: đừng tin vào con số xác suất chỉ vì nó trông có vẻ định lượng. Cần kiểm chứng độ hiệu chuẩn trên chính bài toán cụ thể của bạn trước khi đưa vào sản xuất.
Nghiên cứu đầy đủ có thể được đọc tại Maximum Effort, Minimum Reward.